再看神经量子态:强化学习视角下的训练优化
再来一次:从强化学习视角重新审视神经量子态#
Juan Agustín Duque1,2,∗ Sergio García-Heredia2,∗ Vinicius Hernandes3 Eliška Greplová3 Thomas Spriggs3,† Aaron Courville1,4,† Anna Dawid2,†
1Mila Quebec AI Institute, Université de Montréal, Montréal, Canada
2Applied Quantum Algorithms ⟨aQa$\mathbb{L}$⟩, LIACS & LION, Leiden University, Leiden, Netherlands 3QuTech and Kavli Institute of Nanoscience, Delft University of Technology, Delft, Netherlands
4CIFAR AI Chair juanduquevan@gmail.com ∗共同第一作者。 †共同指导。
摘要#
神经量子态(NQS)提供了近似量子多体波函数的灵活且可扩展的框架。在 NQS 参数化中,自回归模型尤其具有吸引力,因为它们能够从 Born 分布中实现精确且独立的采样,避免了马尔可夫链方法中的自相关和混合问题。然而,它们的优化仍然相对未被充分探索:Adam 是一种可扩展的方法,但忽略了函数空间几何,而随机重构虽然原理上严谨,但在大模型中成本高昂且数值不稳定。为了解决这一差距,我们展示了变分能量最小化可以看作是 Born 分布上的优势策略梯度问题,从而为 NQS 训练提出了信任域优化。我们引入了近端波函数优化(PWO),这是一种原理严谨的信任域算法,它裁剪幅值通道中的概率比变化和相位通道中的相位增量。PWO 避免了显式矩阵求逆,在多次更新中重复使用样本,并将一阶优化的可扩展性与理论保证相结合。在伊辛和受挫的 $J_{1} {-} J_{2}$ 一维和二维自旋系统中,PWO 相对于 Adam、minSR 和 SPRING 提高了稳定性和实际时间收敛。最后,我们微调了一个 1.5B 参数的 RWKV-7 模型,展示了在规模上比先前工作高出三个数量级的 NQS 优化。
1 引言#
量子物理致力于预测和理解多个相互作用的量子粒子的行为。然而,要精确确定N个量子比特系统的基态(最低能量态),通常需要对一个$2^{N} \times 2^{N}$的哈密顿量矩阵进行对角化,这使得精确方法在规模扩大时迅速变得不可行。变分方法通过优化参数化的波函数拟设来近似基态,从而应对这种指数级复杂度。神经量子态(NQS)[Carleo and Troyer, 2017, Lange et al., 2024]在此基础上进一步发展,利用神经网络作为具有表现力的波函数表示,能够捕捉复杂的关联[Nomura and Imada, 2021]和高纠缠度[Gauvin-Ndiaye et al., 2025],并扩展到传统方法难以处理的高维系统[Pescia et al., 2024]。
NQS 的实际成功不仅依赖于表现力,还取决于从变分分布中采样和进行优化的能力。最先进的 NQS 方法 [Wu et al., 2024] 主要依赖马尔可夫链蒙特卡洛(MCMC)来估计能量和梯度,这在困难状态下会引入自相关、慢混合和不可靠的探索 [Wolff, 1990, Del Debbio et al., 2004]。自回归 NQS 通过分解 Born 分布并实现精确、独立的采样,消除了这一采样瓶颈 [Sharir et al., 2020, Hibat-Allah et al., 2020, Moss et al., 2025]。因此,它们为变分优化提供了一个简洁的环境:样本可以直接从当前波函数中抽取,训练动态不再受马尔可夫链限制的干扰。尽管有这些优势,它们的应用仍然有限,因为稳定的优化是训练精确自回归模型的核心瓶颈。
现有的优化方法面临着尖锐的权衡。一阶优化器如 Adam [Kingma and Ba, 2014] 计算效率高,并能自然地扩展到大型神经网络,但它们忽略了变分波函数的几何结构,在 NQS 应用中可能会不稳定或不精确地收敛 [Pfau et al., 2020, Liu et al., 2025]。随机重配置(SR)及其可扩展变体如 minSR [Chen and Heyl, 2024] 在几何上更具原则性,因为它们近似了波函数空间中的自然梯度下降。然而,它们需要求解大型且通常病态的线性系统,其成本对于大型网络或大样本方案来说变得过高。因此,自回归 NQS 解决了一个重要的采样问题,但对大型自回归波函数模型进行稳定的一阶优化仍然是一个核心障碍,近期有研究尝试用迁移学习来应对 [Merali et al., 2026]。
贡献。 这一差距表明 NQS 中缺失了一个优化原则。在这项工作中,我们观察到,在特定假设下,NQS 中的变分目标在数学上等价于强化学习(RL)中的策略梯度目标。尽管这种联系在早期工作中就已隐含存在 [Carleo and Troyer, 2017],但尚未被形式化或用于设计现代优化器。在这项工作中,我们展示了 RL 风格的信任域优化能够提升 NQS 训练的可扩展性和稳定性。我们的贡献如下:
- 我们正式建立了变分能量最小化与策略梯度 RL 之间的联系,表明 NQS 梯度在 Born 分布上具有优势加权形式。
- 我们引入了近端波函数优化(PWO),一种受近端策略优化(PPO)[Schulman et al., 2017] 启发的 NQS 训练算法,并证明了 PWO 代理满足信任域改进界,从而允许样本复用。
- 我们展示了在标准基准测试(1D、2D Ising 和 $J_{1} {-} J_{2}$)上,与 Adam 和 minSR 相比,PWO 能够提升自回归 NQS 的稳定性和收敛速度。
- 最后,我们通过在 1D Ising 模型上微调一个 15 亿参数的 RWKV-7 LLM [Peng et al., 2025],展示了 PWO 的可扩展性。
2 背景#
2.1 强化学习#
强化学习(RL)是一种机器学习范式,智能体通过与环境的交互来学习做出决策。在每个时间步 $t$,智能体观察到一个状态 $s_{t}$,选择一个动作 $a_{t}$,然后从转移函数 $P ( \cdot | s_{t} , a_{t} )$ 中接收到一个奖励 $r_{t + 1}$ 和一个新状态 $s_{t + 1}$。智能体的目标是学习一个策略,以最大化随时间累积的期望回报。令 $\pi_{\pmb{\theta}}$ 表示一个由 $\theta$ 参数化的策略。形式上,回报定义在轨迹 $\tau : = ( s_{0} , a_{0} , r_{1} , s_{1} , a_{1} , r_{2} , \dots )$ 上,该轨迹是智能体-环境交互产生的一系列状态、动作和奖励。遵循 Agarwal 等人 [2021] 的符号,在 $\pi_{\theta}$ 下轨迹 $\tau$ 的概率为
$$ \mathcal{P}_{\boldsymbol{\theta}} (\tau) = \mu (s_{0}) \pi_{\boldsymbol{\theta}} (a_{0} | s_{0}) P (s_{1} | s_{0}, a_{0}) \pi_{\boldsymbol{\theta}} (a_{1} | s_{1}) P (s_{2} | s_{1}, a_{1}) \dots ,\tag{1} $$其中 $\mu ( s_{0} )$ 表示状态的初始分布。RL 的目标是找到一个策略,最大化期望折扣回报,这由策略 $\pi_{\theta}$ 的状态值函数和动作值函数来刻画:
$$ V^{\pi_{\boldsymbol{\theta}}} (s) := \mathbb{E}_{\pi_{\boldsymbol{\theta}}} \left[ \sum_{t = 0}^{\infty} \gamma^{t} r_{t} \bigg | s_{0} = s \right], \quad Q^{\pi_{\boldsymbol{\theta}}} (s, a) := \mathbb{E}_{\pi_{\boldsymbol{\theta}}} \left[ \sum_{t = 0}^{\infty} \gamma^{t} r_{t} \bigg | s_{0} = s, a_{0} = a \right],\tag{2} $$。在策略优化中,智能体通过使用策略梯度估计器 [Williams, 1992] 进行梯度上升来最大化其期望回报,该估计器的形式为:
$$ \nabla_{\boldsymbol{\theta}} V^{\pi_{\boldsymbol{\theta}}} (\mu) = \mathbb{E}_{\tau \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ \sum_{t = 0}^{\infty} \gamma^{t} A^{\pi_{\boldsymbol{\theta}}} (s_{t}, a_{t}) \nabla_{\boldsymbol{\theta}} \log \pi_{\boldsymbol{\theta}} (a_{t} | s_{t}) \right].\tag{3} $$这里 $A^{\pi_{\theta}} ( s , a ) : = Q^{\pi_{\theta}} ( s , a ) - V^{\pi_{\theta}} ( s )$ 表示在状态 $s$ 下采取动作 $a$ 的优势,即相对于策略平均值在状态 $s$ 下采取动作 $a$ 的期望回报。
2.2 神经量子态#
理论量子多体物理学的关键任务之一是近似具有许多相互作用粒子的系统的基态波函数。对于一个由 $N$ 个自旋 $1/2$ 粒子组成的系统,一个构型是一个二元向量 $\mathbf{s} \in \{\pm 1 \}^{N}$,波函数可以看作一个希尔伯特空间 $\dot{\mathcal{H}}$ (见附录A)中的复向量 $| \psi \rangle$,该空间由所有 $2^{N}$ 个构型索引。等价地,它定义了一个函数 $\mathbf{s} \mapsto \boldsymbol \psi ( \mathbf{s} )$,其中 $\psi ( \mathbf{s} ) \in \mathbb{C}$ 是分配给构型 s 的振幅:
$$ | \psi \rangle = \sum_{\mathbf{s} \in \{\pm 1 \}^{N}} \psi (\mathbf{s}) | \mathbf{s} \rangle ,\tag{4} $$这里我们使用了狄拉克括号记号(见附录 $\mathbf{A} $)。该向量的指数级大小使得对于大的 $N$,显式表示难以处理。神经量子态通过用神经网络 $f_{\theta}$ 参数化振幅函数来解决这个问题,使得 $f_{\pmb \theta} ( \mathbf{s} )$ 为 $\psi ( \mathbf{s} ) $ 提供一个紧凑的近似 [Carleo and Troyer, 2017, Dawid et al., 2025]。在实际应用中,NQS 模型输出复振幅的对数,
$$ f_{\pmb{\theta}} (\mathbf{s}) = \log \psi_{\pmb{\theta}} (\mathbf{s}) = \log | \psi_{\pmb{\theta}} (\mathbf{s}) | + i \arg \psi_{\pmb{\theta}} (\mathbf{s}),\tag{5} $$它将波函数分解为对数模和相位,通常由独立的网络(通道)处理。这种表示在数值上很方便,因为振幅可以跨越许多数量级。根据玻恩规则,归一化波函数在构型上诱导出一个概率分布,$P_{\pmb{\theta}} ( \mathbf{s} ) \propto \left| \psi_{\pmb{\theta}} ( \mathbf{s} ) \right| ^{2}$。在这项工作中,我们专注于自回归 $\mathrm{NQS}$,它显式地分解 $P_{\theta}$,并能够从玻恩分布中进行精确的独立采样。
2.3 寻找基态#
哈密顿量 $\hat{H}$ 是量子系统的能量算符:它对相互作用、外场和决定哪些波函数具有低能或高能的动能项进行编码。NQS 框架的一个流行应用是寻找量子系统的基态。给定用哈密顿量 $\hat{H}$ 描述的物理系统,基态是对应于最低本征值 $E_{0}$ 的本征态 $| \psi_{0} \rangle$。这可以表述为一个最小化问题:
$$ E_{0} \leq E [ \psi ] = \frac{\langle \psi | \hat{H} | \psi \rangle}{\langle \psi | \psi \rangle}, \quad \forall | \psi \rangle \in \mathcal{H},\tag{6} $$当且仅当 |ψ⟩ 属于基态本征空间时等式成立——这被称为变分原理。以基态的该变分表述为起点,所谓的变分方法定义了一个参数化族 $| \overline{{\psi}}_{\pmb{\theta}} \rangle$,并通过求解下式来近似基态:
$$ \boldsymbol{\theta}^{*} = \underset{\boldsymbol{\theta}} {\operatorname{argmin}} E [ \psi_{\boldsymbol{\theta}} ] = \underset{\boldsymbol{\theta}} {\operatorname{argmin}} \frac{\langle \psi_{\boldsymbol{\theta}} | \hat{H} | \psi_{\boldsymbol{\theta}} \rangle}{\langle \psi_{\boldsymbol{\theta}} | \psi_{\boldsymbol{\theta}} \rangle}.\tag{7} $$在 NQS 的情况下,这个函数族由神经网络给出,如前所述。
2.4 变分蒙特卡罗#
为了高效计算式(7)的一个最小值,NQS 使用蒙特卡洛估计。这种方法被称为变分蒙特卡洛。特别地,能量可以写成:
$$ E [ \psi_{\pmb{\theta}} ] = \frac{\langle \psi_{\pmb{\theta}} | \hat{H} | \psi_{\pmb{\theta}} \rangle}{\langle \psi_{\pmb{\theta}} | \psi_{\pmb{\theta}} \rangle} = \sum_{\mathbf{s}} \mathcal{P}_{\pmb{\theta}} (\mathbf{s}) E_{\pmb{\theta}}^{\mathrm{loc}} (\mathbf{s}) = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} \big [ E_{\pmb{\theta}}^{\mathrm{loc}} (\mathbf{s}) \big ],\tag{8} $$其中我们定义
$$ \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) = \frac{| \psi_{\boldsymbol{\theta}} (\mathbf{s}) | ^{2}}{\sum_{\mathbf{s}^{\prime}} | \psi_{\boldsymbol{\theta}} (\mathbf{s}^{\prime}) | ^{2}}, \quad E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) := \sum_{\mathbf{s}^{\prime}} \frac{\psi_{\boldsymbol{\theta}} (\mathbf{s}^{\prime})}{\psi_{\boldsymbol{\theta}} (\mathbf{s})} \left\langle \mathbf{s} | \hat{H} | \mathbf{s}^{\prime} \right\rangle .\tag{9} $$通过这种表述,NQS 通过从参数化分布 $\mathcal{P}_{\theta}$ 中采样一组自旋构型 $\{\mathbf{s}_{i} \}_{i = 1}^{M}$,并计算 $E_{\theta}^{\mathrm{loc}} ( \mathbf{s}_{i} )$ 的样本均值来估计损失函数:
$$ L (\pmb{\theta}) \approx \bar{E}_{\pmb{\theta}}^{\mathrm{loc}} \equiv \frac{1}{M} \sum_{i = 1}^{M} E_{\pmb{\theta}}^{\mathrm{loc}} (\mathbf{s}_{i}).\tag{10} $$
state 输入: 哈密顿量 $\hat{H}$, NQS $\psi_{\theta}$, 批次大小 $M$, 内部轮次 $K$, 幅度裁剪 $\epsilon$, 相位裁剪 $\delta$
state 初始化 $\theta$
while 未收敛 do
  $\theta_{\text{old}} \leftarrow \theta$
  采样 $\{\mathbf{s}_i\}_{i=1}^M \sim \mathcal{P}_{\theta_{\text{old}}}$
  缓存 $\{\mathbf{s}_i\}_{i=1}^M$ 的参考对数概率 $\log \mathcal{P}_{\theta_{\text{old}}}(\mathbf{s}_i)$
  缓存相位 $\arg \psi_{\theta_{\text{old}}}(\mathbf{s}_i)$
  缓存归一化优势 $A_{\theta_{\text{old}}}^{\text{R}}(\mathbf{s}_i)$, $A_{\theta_{\text{old}}}^{\text{I}}(\mathbf{s}_i)$
  for $k = 1, \ldots, K$ do
    计算 $\{\mathbf{s}_i\}_{i=1}^M$ 的当前 $\log \mathcal{P}_{\theta}(\mathbf{s}_i)$, $\arg \psi_{\theta}(\mathbf{s}_i)$
    $r_i \leftarrow \exp(\log \mathcal{P}_{\theta}(\mathbf{s}_i) - \log \mathcal{P}_{\theta_{\text{old}}}(\mathbf{s}_i))$
    $\phi_i \leftarrow 2 \cdot \operatorname{atan2}(\sin\Delta\arg, \cos\Delta\arg)$
    $\ell_i^R \leftarrow \max(r_i A_{\text{old}}^{\text{R}}, \operatorname{clip}(r_i, 1-\epsilon, 1+\epsilon) A_{\text{old}}^{\text{R}})$
    $\ell_i^I \leftarrow \operatorname{sg}(r_i) \cdot \max(\phi_i A_{\text{old}}^{\text{I}}, \operatorname{clip}(\phi_i, -\delta, \delta) A_{\text{old}}^{\text{I}})$
    $\theta \leftarrow \theta - \eta \nabla_{\theta} \frac{1}{M} \sum_{i=1}^{M} (\ell_i^R + \ell_i^I)$
  endfor
endwhile
return $\theta$
通过对式 (8) 求导(见附录 B.2),可以证明其关于 θ 的梯度可以表示为关于 $\mathcal{P}_{\pmb{\theta}}$ 的期望值,并使用 MCMC 采样或自回归模型的直接采样进行估计:
$$ \partial_{\theta_{i}} L (\pmb{\theta}) = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} \big [ 2 \operatorname{Re} \big \{\big (E_{\pmb{\theta}}^{\mathrm{loc}} (\mathbf{s}) - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} [ E_{\pmb{\theta}}^{\mathrm{loc}} (\mathbf{s}) ] \big) O_{i} (\mathbf{s})^{*} \big \} \big ],\tag{11} $$对于 $i = 1 , \ldots , P$,其中 $O_{i} ( \mathbf{s} ) = \partial_{\theta_{i}}$ log ψθ 被称为得分函数。
2.5 随机重配置#
随机梯度下降(SGD)[Robbins and Monro, 1951] 在许多场景下是一种简单有效的优化方法。然而,在 VMC 的背景下,由于参数空间的复杂几何结构,它可能面临收敛缓慢和不稳定的问题。关键在于,参数 θ 的微小变化并不一定对应量子态 $| \psi_{\pmb{\theta}} \rangle$ 的微小变化。
随机重配置(SR)[Sorella, 1998] 将自然梯度下降 [Amari, 1998] 推广到 VMC,它对梯度 $\nabla_{\pmb{\theta}} L ( \pmb{\theta} )$ 进行预处理,以确保一次训练迭代中的 $| \psi_{\pmb{\theta}} \rangle$ 与下一次迭代之间的距离很小。该距离由两个状态之间的不保真度给出,并由 Fubini-Study 度量近似到二阶:
$$ S_{ij} = \mathrm{Re} \left\{\mathrm{Cov}_{\mathbf{s} \sim \mathcal{P}_{\theta}} \left[ O_{i}^{*} (\mathbf{s}), O_{j} (\mathbf{s}) \right] \right\}, \qquad i, j = 1, \ldots , P,\tag{12} $$它编码了当前参数配置下希尔伯特空间的局部几何结构。在数学上,SR 以下列方式修改更新规则:
$$ \boldsymbol{\theta} \leftarrow \boldsymbol{\theta} - \eta \mathbf{S}^{- 1} \nabla_{\boldsymbol{\theta}} L (\boldsymbol{\theta}),\tag{13} $$其中 $\eta \in \mathbb R$ 是学习率。我们在附录 C.1 中讨论了 SR 的高计算成本及其最近的改进,从而激励使用一阶优化方法。
3 近端波函数优化#
在此,我们介绍一种训练 NQS 的新优化过程。我们首先将当前的 NQS 优化范式与 RL 中的策略梯度更新建立等价关系,然后以此为基础,将近端策略优化应用于 NQS。
命题 3.1(变分能量最小化的策略梯度形式)。假设哈密顿量是 stoquastic 的,即其在所选计算基下的矩阵表示具有非正的非对角元素。那么我们可以假设 $f_{\pmb \theta} = \log \psi_{\pmb \theta} = \log | \bar{\psi}_{\pmb \theta} |$,并且变分能量的梯度可以写成策略梯度形式:
$$ \boldsymbol{\nabla}_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ \left(E_{\boldsymbol{\theta}}^{\text{loc}} (\mathbf{s}) - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ E_{\boldsymbol{\theta}}^{\text{loc}} (\mathbf{s}) \right]\right) \boldsymbol{\nabla}_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \right].\tag{14} $$具体而言,变分能量最小化等价于对构型进行优势策略梯度更新。证明见附录B.1。
| 强化学习 | 变分蒙特卡洛 | ||
| 策略 | $\pi_{\theta}(a \mid s)$ | Born分布 | $\mathcal{P}_{\theta}(\mathbf{s}) \propto |\psi_{\theta}(\mathbf{s})|^{2}$ |
| 优势 | $A^{\pi_{\theta}}(s_{t}, a_{t})$ | 中心化局域能量 | $\Delta E(\mathbf{s}) = E_{\theta}^{\text{loc}}(\mathbf{s}) - E[\psi_{\theta}]$ |
| 策略梯度 | $A^{\pi_{\theta}}\nabla_{\theta}\log \pi_{\theta}$ | VMC力 | $2\operatorname{Re}[\Delta E(\mathbf{s})\nabla_{\theta}\log \psi_{\theta}^{*}(\mathbf{s})]$ |
| KL信任区域 | $D_{\text{KL}}(\pi_{\theta_{\text{old}}} \| \pi_{\theta})$ | 不保真度 | $\mathcal{I}(\psi_{\theta}, \psi_{\theta+\delta\theta})$ |
| Fisher矩阵 | $\mathbf{F}$ | Fubini–Study度量 | $\mathbf{S}$ |
表1:NQS中RL策略梯度方法与VMC方法之间的对应关系。
这一命题通过关联式(11)和式(14),在NQS与RL框架之间建立了直接联系(另见表1),从而启发了我们的算法——近端波函数优化(PWO)。关键观察在于:SR梯度是求解近似约束优化问题的结果,该问题旨在最小化期望能量,同时将不保真度的变化限制在某个小量δ以内。RL文献中早已研究了类似问题,但称之为信任区域优化[Kakade and Langford, 2002, Schulman et al., 2015, 2017]。其核心思想与SR相似:最大化期望奖励,同时将总变分距离的变化限制在某个小量δ以内。
近端策略优化(PPO)[Schulman et al., 2017]引入了一种简单的启发式方法,通过约束更新使更新后的策略与旧策略保持接近,经验上展现出单调改进的效果。将其应用于NQS时,PPO会最小化以下代理损失:
$$ L_{\mathrm{mod}}^{\mathrm{clip}} (\pmb{\theta}) = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}_{\mathrm{old}}}} \left[ \max \left(r_{\pmb{\theta}} (\mathbf{s}) A_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{R}} (\mathbf{s}), \mathrm{clip} (r_{\pmb{\theta}} (\mathbf{s}), 1 - \epsilon , 1 + \epsilon) A_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{R}} (\mathbf{s})\right) \right],\tag{15} $$其中,$r_{\pmb{\theta}} = \mathcal{P}_{\pmb{\theta}} / \mathcal{P}_{\pmb{\theta}_{\mathrm{old}}}$是更新后分布与旧分布之间的重要性采样比率,$\epsilon$是裁剪幅度,$\max$来自求解最小化问题,而
$$ A_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{R}} (\mathbf{s}) := \mathrm{Re} \left\{E_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{loc}} (\mathbf{s}) \right\} - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}_{\mathrm{old}}}} \left[ \mathrm{Re} \left\{E_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{loc}} (\mathbf{s}) \right\} \right],\tag{16} $$是优势估计的等价形式,表示构型s的局域能量相对于当前NQS下期望能量的差值。在RL中,裁剪确保了策略更新的保守性,从而在优化过程中保持稳定性。
虽然PPO天然适用于振幅通道,但它本身并不能涵盖完整的VMC梯度。如附录B.3所示,变分梯度还包含一个虚部,用于控制波函数相位的演化。因此,我们引入了第二个近端目标函数,通过直接约束当前模型与参考模型之间的包裹相位增量来控制相位更新。具体地,设 $\phi_{\theta}(\mathbf{s})$ 表示包裹相位差(见附录B.4),我们最小化裁剪后的相位代理损失:
$$ L_{\mathrm{arg}}^{\mathrm{clip}} (\pmb{\theta}) = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}_{\mathrm{old}}}} \left[ \mathrm{sg} \big (r_{\pmb{\theta}} (\mathbf{s}) \big) \max \big (\phi_{\pmb{\theta}} (\mathbf{s}) A_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{I}} (\mathbf{s}), \mathrm{clip} \big (\phi_{\pmb{\theta}} (\mathbf{s}), - \delta , \delta \big) A_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{I}} (\mathbf{s}) \big) \right],\tag{17} $$其中 $\operatorname{sg}( \cdot )$ 表示停止梯度算子(见定理B.5),而
$$ A_{\boldsymbol{\theta}_{\text{old}}}^{\mathrm{I}} (\mathbf{s}) := \operatorname{Im} \left\{E_{\boldsymbol{\theta}_{\text{old}}}^{\text{loc}} (\mathbf{s}) \right\} - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}_{\text{old}}}} \left[ \operatorname{Im} \left\{E_{\boldsymbol{\theta}_{\text{old}}}^{\text{loc}} (\mathbf{s}) \right\} \right].\tag{18} $$局部能量的虚部的期望为零,因此保留中心化仅是为了镜像强化学习中的优势。方程 (17) 是相位类比于 PPO 的版本:它并非裁剪概率比,而是裁剪相位增量本身,在仍然遵循 VMC 梯度虚部的同时,防止波函数发生突变。使用相位增量而非相位之比,可确保在内策略(on-policy)时,即重要性采样比率 $r_{\theta}$ 为 1(无样本复用)时,组合损失函数(方程 (15) + (17))的梯度与原始梯度(方程 (11))一致。
PWO 将幅值和相位损失结合成一个高效的(见附录 C.2)一阶优化过程。对于幅值通道,命题 3.1 表明,当相位固定时,变分能量最小化表现为对构型进行优势加权策略梯度更新,这自然引出了基于重要性比率的 PPO 风格裁剪替代函数。对于相位通道,附录 B.6 表明,VMC 梯度的虚部可通过一个约束相位增量的替代函数进行保守优化。实践中,PWO 在从参考 Born 分布 $\gamma_{\theta_{\mathrm{old}}}$ 采样的固定批次构型上执行 $\mathbf{\bar{\Sigma}}_{K}$ 次内部更新,裁剪幅值的概率比变化和相位的包裹相位增量。由于同一批次在多个内部步骤中重复使用,相位目标函数包含分离的重要性权重,以纠正参考采样分布与当前采样分布之间的不匹配(见定理 B.5)。算法 1 总结了这一过程。
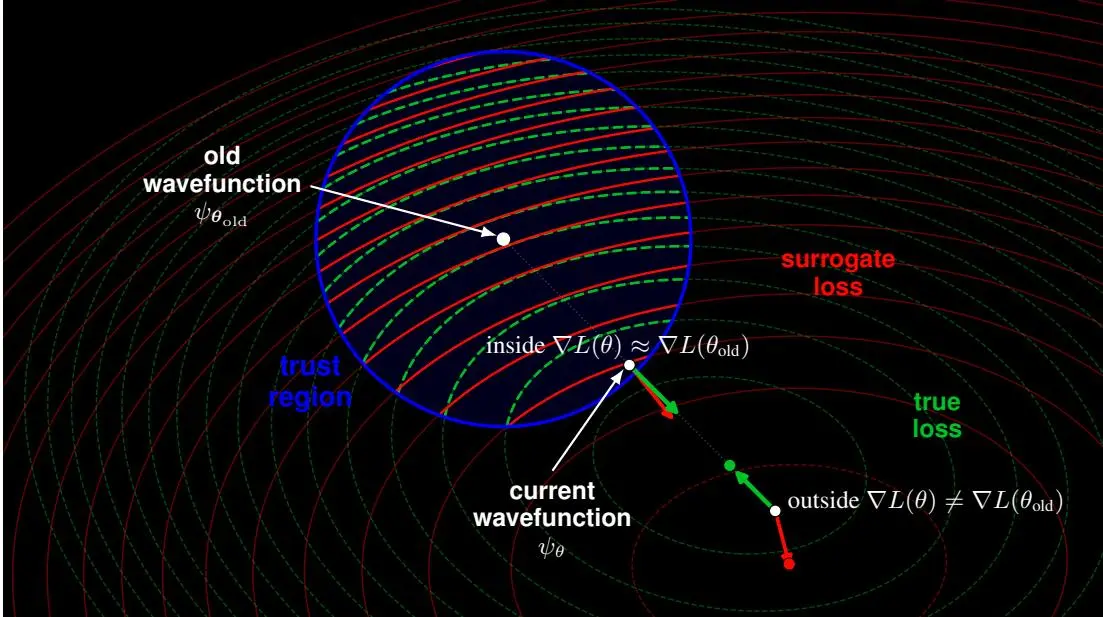
图1:PWO 的信任区域直觉。在信任区域内,替代函数曲面提供可靠的局部改进方向;在信任区域外,替代函数曲面与真实曲面可能存在显著差异。
4 理论分析#
PWO 的理论依据与策略优化中的单调改进分析类似。在 CPI [Kakade and Langford, 2002] 和 TRPO [Schulman et al., 2015] 中,真实回报的变化由一个在参考策略下的替代目标函数加上一个远离该策略的惩罚项来控制。PWO 遵循相同原理,只是将回报替换为负变分能量,概率比控制幅值通道,相位增量控制相位通道。图 1 说明了这一原理:信任区域通过使优化过程足够接近参考波函数 $\psi_{\pmb{\theta}_{\mathrm{old}}}$,从而使得在旧样本上评估的替代损失函数仍是当前能量曲面的可控近似,进而实现样本复用。定理 4.1 表明,这种近端构造保留了精确的局部 VMC 方向。
定理 4.1 (PWO 的一阶一致性). 令 $| \psi_{\pmb{\theta}} \rangle$ 在 $\pmb{\theta}_{\mathrm{old}}$ 处可微,并假设共同支撑集。对于 $\epsilon , \delta > 0$
$$ \left. \nabla_{\boldsymbol{\theta}} \left(L_{\mathrm{mod}}^{\mathrm{clip}} (\boldsymbol{\theta}) + L_{\mathrm{arg}}^{\mathrm{clip}} (\boldsymbol{\theta})\right) \right| _{\boldsymbol{\theta} = \boldsymbol{\theta}_{\mathrm{old}}} = \left. \nabla_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] \right| _{\boldsymbol{\theta} = \boldsymbol{\theta}_{\mathrm{old}}}.\tag{19} $$证明见附录 B.6。
因此,PWO 的第一次内部更新完全匹配 VMC 梯度;替代函数仅在复用样本时控制该方向的跟随程度。对于有限更新,仅局部一致性是不够的。令 $r_{\theta} = \mathcal{P}_{\theta} / \mathcal{P}_{\theta_{\mathrm{old}}}$,αθ 为包裹相位增量,并定义
$$ \mathcal{A}_{\boldsymbol{\theta}_{\mathrm{old}}} (\boldsymbol{\theta}) := 2 \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}_{\mathrm{old}}}} \left[ \sqrt{r_{\boldsymbol{\theta}}} \left(\cos \alpha_{\boldsymbol{\theta}} A_{\boldsymbol{\theta}_{\mathrm{old}}}^{\mathrm{R}} + \sin \alpha_{\boldsymbol{\theta}} A_{\boldsymbol{\theta}_{\mathrm{old}}}^{\mathrm{I}}\right) \right],\tag{20} $$定理 4.2 (不保真度能量界). 令 $| \psi_{\pmb{\theta}_{\mathrm{old}}} \rangle$ 和 $| \psi_{\pmb{\theta}} \rangle$ 是具有共同支撑集的归一化波函数。则
$$ E [ \psi_{\pmb{\theta}} ] - E [ \psi_{\pmb{\theta}_{\mathrm{old}}} ] \leq \mathcal{A}_{\pmb{\theta}_{\mathrm{old}}} (\pmb{\theta}) + 2 \bigg \| \hat{H} - E [ \psi_{\pmb{\theta}_{\mathrm{old}}} ] \mathbb{1} \bigg \| _{\infty} \left(1 - \sqrt{1 - \mathcal{I} (\psi_{\pmb{\theta}_{\mathrm{old}}} , \psi_{\pmb{\theta}})}\right).\tag{21} $$证明见附录B.4。
该界限与裁剪无关,且对任意有限更新均成立。截断 PWO 保证则需额外要求:实际更新不仅在采样批次上(该方法仅鼓励而非保证此条件,见附录B.7),而是在全局范围内满足振幅和相位信任域。
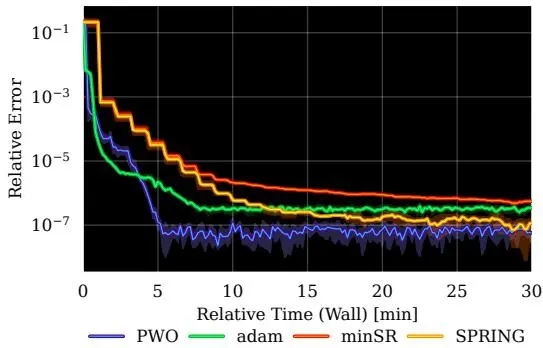
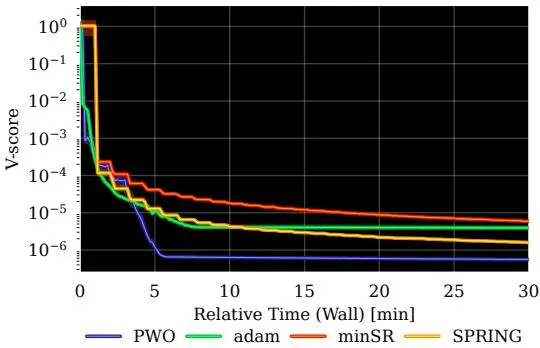
图2:在横场伊辛模型上,PWO、Adam、minSR 和 SPRING 在10个随机种子上的比较。所有方法均使用1024个样本在单个 NVIDIA L40S GPU 上运行。
推论4.3(截断PWO改进保证)。假设定理4.2的条件成立,且中心化局部能量有界,并对所有s满足全局约束 $r_{\pmb{\theta}} ( \mathbf{s} ) \in [ 1 - \epsilon , 1 + \epsilon ]$ 和 $| \alpha_{\pmb \theta} ( \mathbf{s} ) | \leq \delta$,其中 $0 \leq \epsilon \leq 1$,$0 \le \delta \le \pi$。则存在 $C_{\theta_{\mathrm{old}}} < \infty$,使得
$$ E [ \psi_{\boldsymbol{\theta}} ] - E [ \psi_{\boldsymbol{\theta}_{\mathrm{old}}} ] \leq L_{\mathrm{mod}}^{\mathrm{clip}} (\boldsymbol{\theta}) + L_{\mathrm{arg}}^{\mathrm{clip}} (\boldsymbol{\theta}) + 2 C_{\boldsymbol{\theta}_{\mathrm{old}}} \left(1 - \frac{1 + \sqrt{1 - \epsilon^{2}}}{2} \cos^{2} \left(\frac{\delta}{2}\right)\right).\tag{22} $$证明见附录B.7。
最后一项为信任域惩罚项。当 $\epsilon , \delta \to 0$ 时该项消失,随着任一裁剪范围放宽而增大。因此,若最小化截断替代函数直至式(22)右侧为负,则更新后的波函数保证具有更低能量。综上,这些结果表明 PWO 遵循精确的局部 VMC 方向,而有限更新误差一般由保真度控制,在全局裁剪下则由显式的振幅和相位信任域控制。
5 实验#
5.1 自旋链基准测试#
我们评估了 PWO 在三种不同自旋系统上应用于150万参数自回归 NQS 的表现。每个系统由具有周期边界条件的 $N = 12$ 个格点的一维自旋-1/2链组成,因此格点索引按模 N 理解。设 $\hat{\sigma}_{i}^{\alpha} , \alpha \in \{x , y , z \}$ 表示格点 i 上的泡利算符,$\hat{\mathbf{S}}_{i} = 1 / 2 ( \hat{\sigma}_{i}^{x} , \hat{\sigma}_{i}^{y} , \hat{\sigma}_{i}^{z} )$。对每个哈密顿量,我们最小化变分能量 $E [ \psi_{\pmb{\theta}} ]$,并报告相对于精确基态能量 ${\cal E}_{0}$ 的相对误差 $\epsilon_{\mathrm{rel}} = ( E [ \tilde{\psi}_{\pmb \theta} ] - \bar{E_{0}} ) / E_{0}$,这些较小的系统均可计算该量。我们还报告了 V 分数 [Wu 等, 2024],这是一种基于能量方差的尺度不变收敛指标,对于精确本征态该值为零。所选的两个哈密顿量难度递增,因为底层物理需要更复杂的函数来表示。所有优化器使用相同的 NQS 架构和相同数量的蒙特卡洛样本,因此性能差异反映的是优化效果而非模型容量。关于超参数搜索和所用架构的详细信息,见附录 D.1 和 D.2。
横场伊辛模型
$$ \hat{H}_{\mathrm{Ising}} = - J \sum_{i = 1}^{N} \hat{\sigma}_{i}^{z} \hat{\sigma}_{i + 1}^{z} - h \sum_{i = 1}^{N} \hat{\sigma}_{i}^{x}.\tag{23} $$这里,$J = 1$ 是铁磁耦合强度,$h = 1$ 是横场强度。该哈密顿量是一个标准的无符号问题基准:对角相互作用项倾向于对齐的自旋构型,而横场通过翻转单个自旋引入量子涨落。因此,命题3.1严格成立。
海森堡 $J_{1} {-} J_{2}$ 链
$$ \hat{H}_{J_{1} - J_{2}} = J_{1} \sum_{i = 1}^{N} \hat{\mathbf{S}}_{i} \cdot \hat{\mathbf{S}}_{i + 1} + J_{2} \sum_{i = 1}^{N} \hat{\mathbf{S}}_{i} \cdot \hat{\mathbf{S}}_{i + 2}, \qquad J_{1} > 0, J_{2} > 0.\tag{24} $$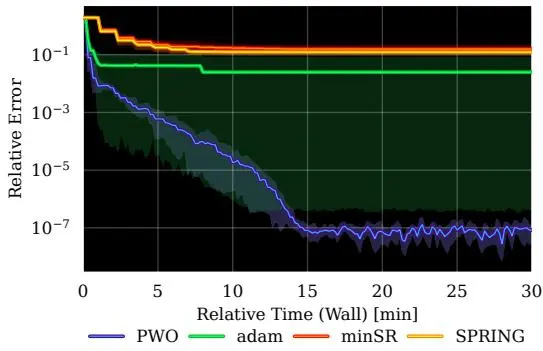
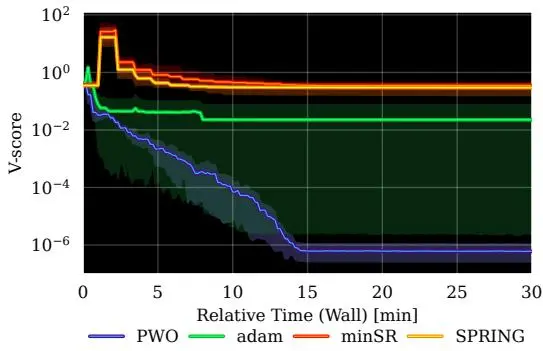
图3:PWO、Adam、minSR 与 SPRING 在 Heisenberg $J_{1} {-} J_{2}$ 链上10个随机种子的对比。MinSR 对该哈密顿量极不稳定,10次运行中有6次产生 NaN。所有方法均在单个 NVIDIA L40S GPU 上使用1024个样本运行。
我们设定 $J_{1} = 1$ 和 $J_{2} = 0.5$,即 $J_{2} / J_{1} = 0.5$。在此比值下,次近邻相互作用最大程度地破坏了近邻反铁磁耦合,将系统置于 Majumdar–Ghosh 点。该点处具有复杂符号结构的高度纠缠基态,使得变分优化和蒙特卡洛采样都极具挑战性 [Sorella, 1998]。与 $\hat{H}_{\mathrm{Ising}}$ 不同,哈密顿量 $\hat{H}_{J_{1} - J_{2}}$ 在计算基上需要非平凡的符号结构;我们采用复值参数化,使 PWO 能够通过其相位通道学习这一结构。该设置旨在评估裁剪相位代理(式 (17))是否仍是一种实用的启发式方法。我们在附录 E.1 中对 $J_{1} = 0.25$ 和 $J_{2} = 0$(即所谓的 Heisenberg 链)进行了类似研究。
所有结果均基于10个随机种子计算得出。由于多次运行都达到了高精度误差,数值不稳定性可能产生极端离群值。因此,均值和标准差汇总在此情形下并不适用,因为单次不稳定运行可能会扭曲中心估计和不确定性带。我们遵循 Agarwal 等人 [2022] 的做法,改为报告四分位统计量:在每个评估时刻,曲线显示四分位均值(IQM),即舍弃最低和最高四分位数后,对中间50%的种子取平均。阴影区域表示四分位距,即第25百分位数到第75百分位数。这既提供了稳健的中心估计,又展示了运行间的变异性。所有单个种子的曲线图见附录 E.1 至 E.3。我们在附录 C.4 中讨论了我们方法的局限性。
5.2 收敛性与稳定性结果#
图2显示,在一维伊辛模型上,PWO 是四种优化器中收敛最快的,约在5分钟内达到相对误差 $10^{-7}$,而 minSR 需要约30分钟才能达到相同精度。V 分数也呈现相同趋势:PWO 迅速抑制能量波动,表明近端目标函数不仅改进了能量估计,还驱动状态向本征态收敛。Adam 和 SPRING 也稳步进展,但需要更多挂钟时间才能达到相同精度。MinSR 在该较简单的哈密顿量上表现稳定,但其每步计算成本使其在挂钟时间上显著更慢。
在图3的 $J_{1} {-} J_{2}$ 哈密顿量上,PWO 在大约15分钟内达到相对误差 $10^{-7}$,同时 V 分数持续降低,表明学习到的状态在能量和方差上都趋于收敛。相比之下,Adam 由于离群值,在比 PWO 高出数个数量级处出现平台。此外,与伊辛模型相比,PWO 与 minSR 及 SPRING 的对比更为显著:minSR 数值不稳定,10次运行中有6次产生 NaN;两者在30分钟后仍停留在 $10^{-1}$ 的相对误差。尽管使用了曲率启发式的更新,这些方法仍难以取得进展,并表现出数值不稳定性。这是本文核心论点最有力的实验证据:一种 PPO 风格的近端目标函数可以保留一阶优化的低挂钟时间成本,同时提供在困难量子哈密顿量上训练表达能力强的 NQS 所需的稳定性。附录 E.1 中关于 Heisenberg 链的实验也得出了相同结论。我们还为更清晰和更易观察,在附录 E.1 中绘制了未经聚合或过滤的所有单个种子曲线。
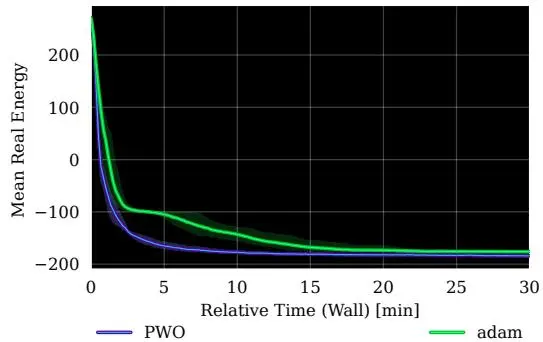
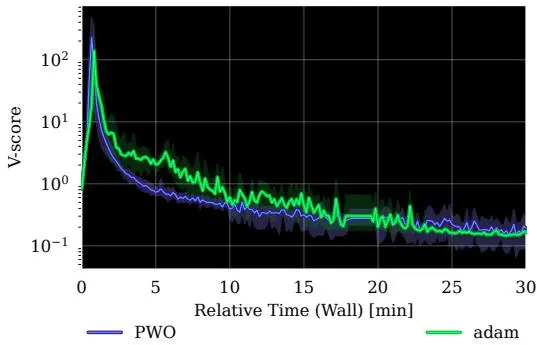
图4:$10 \times 10$ 晶格上的二维受挫 $J_{1} {-} J_{2}$ Heisenberg 模型。左图:平均真实能量。右图:V 分数。PWO 在相同挂钟时间预算内比 Adam 更快达到更低能量,并保持更低的基于方差的误差信号。
5.3 方晶格上的二维 $J_{1} {-} J_{2}$ 模型#
我们接下来测试 PWO 在一维链之外是否仍然有效,研究对象是受挫方晶格 $J_{1} {-} J_{2}$ Heisenberg 模型,采用周期性边界条件,系统尺寸为 $10 \times 10$。我们使用带有二维 RoPE 的复值块自回归 Transformer,并强制施加零磁化扇区。由于在此尺寸下精确对角化不可行,我们通过平均真实能量和 V 分数来比较优化器。如图4所示,PWO 比 Adam 更快地降低能量,并在相同挂钟时间预算内达到更低的能量区间。V 分数也呈现相同趋势,表明近端目标函数在该受挫二维基准上也能提升稳定性。单个种子的运行结果见附录 E.1。
5.4 可扩展性实验#
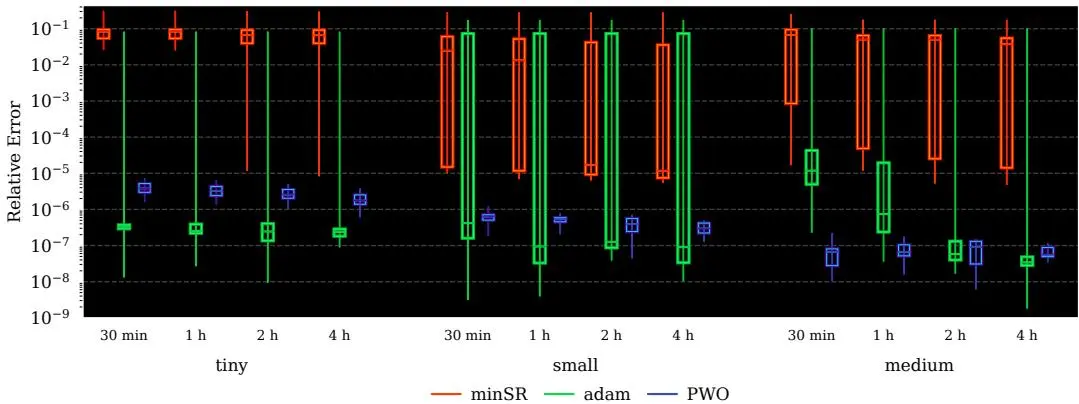
图5:不同模型规模和优化方法下的挂钟时间扩展性对比。箱线图显示种子间的四分位均值相对误差,箱子表示四分位距,线段表示最小值和最大值。结果按模型规模和挂钟时间分组,并在单个 NVIDIA A100 GPU 上运行。
图5比较了PWO、Adam和minSR在Heisenberg $J_{1} {-} J_{2}$ 链上(详见附录D.7)随着NQS模型规模增大时的扩展行为。PWO在所有NQS规模下均表现出稳定性和单调的能量改进,并在前30分钟内接近最终能量。相比之下,minSR既不稳定,也从未达到有竞争力的能量值。Adam在极小网络上的表现最佳,但在中小规模NQS中稳定性和效率下降,而PWO在此类情况下既更快又更可靠。特别地,对于中等NQS,要达到与PWO相当的能量尺度,Adam需要大约4倍的时间。在附录C.2中,我们展示了PWO比其它优化器收敛更快,因为它单位时间内执行的优化步骤更多。虽然Adam在4小时的长时间训练后能达到更低的能量,但观察到的扩展趋势表明,这一优势在更大的网络上可能会减弱。在附录E.2中,我们对样本数和系统规模进行了额外的扩展实验。
5.5 大型语言模型的NQS微调#
图6:1.5B参数RWKV7LLM在一维Ising模型上的微调曲线。
图6展示了1.5B参数RWKV-7模型在横向场Ising链上的微调结果。与Adam相比,PWO实现了更低的最终相对误差和V分数,同时在完整挂钟预算内保持了稳定的训练。这一改进并非旨在说明LLM或大型网络[Moss et al., 2026]是一维哈密顿量的正确归纳偏置;而是表明,当ansatz的规模超越现有NQS文献[Rende et al., 2025]三个数量级以上时,近端目标函数依然有效。
6 相关工作#
强化学习与基态搜索。基态搜索已通过Feynman-Kac表示[Barr et al., 2020]被视为最优控制问题,并且通过将stoquastic哈密顿量视为奖励函数,已为格点模型开发了RL框架[Gispen and Lamacraft, 2022]。最近的元学习方法[Jae et al., 2025]利用RL来优化量子态学习过程本身。然而,这些工作要么通过理论重新表述问题,要么通过优化学习过程来应用RL。我们则直接将RL作为主要的优化框架,并将其应用于NQS ansatz。
重要性采样与信赖域。此前已在非自回归NQS优化中探索过样本复用和近端目标函数。Yang等人[2020]引入了重要性采样梯度优化(ISGO),该方法通过使用当前波函数与参考波函数之间的概率比对局部能量进行加权,从而在多个梯度更新中复用马尔可夫链样本。在此基础上,Chen等人[2022]引入了一种受PPO启发的相位变化余弦惩罚。我们的工作在命题3.1中形式化了与RL的类比,直接在虚梯度上使用不同的裁剪目标函数而非惩罚项,并使策略-梯度对应关系精确,从而首次实现了十亿参数模型的稳定训练。
7 结论#
我们提出了近端波函数优化(PWO),一种可扩展的一阶优化器,用于神经量子态(NQS),其源于变分蒙特卡洛与强化学习(RL)之间的显式联系。在固定相位stoquastic设定下,我们证明了变分能量最小化可以写成关于Born分布的优势策略梯度目标函数,其中自旋构型充当动作,中心化的局域能量充当优势函数。这将NQS优化重新表述为一个信赖域策略优化问题,启发了一种PPO风格的算法,该算法在振幅通道中对概率比变化进行裁剪,并通过一个裁剪的相位增量替代函数自然地扩展到复波函数。在自旋链基准测试中,PWO在挂钟收敛速度和稳定性上优于Adam、minSR和SPRING,在优化最脆弱的阻挫区域取得了最大提升。最后,通过将1.5B参数的RWKV-7模型作为自回归NQS进行微调,我们将NQS训练带入现代大规模序列建模的领域。更广泛地,我们的研究结果架起了RL和NQS社区之间的桥梁,促进了进一步的相互启发。通过解锁大型自回归NQS,PWO为研究仅凭规模这一“苦涩教训”的精神是否能克服量子多体模拟中的当前障碍打开了大门。
可复现性声明#
复现我们实验的代码可在 https://github.com/jduquevan/ hyperscalenqs 获取。完整的实验细节,包括超参数搜索、模型架构、优化器设置、样本预算和扩展配置,见附录D。
致谢#
本工作得到了荷兰科学研究组织(NWO/OCW)的支持,作为Quantum Limits(项目编号SUMMIT.1.1016)的一部分。本出版物也是项目“最优数字-模拟量子电路”(文件编号NGF.1582.22.026)的一部分,该项目属于研究计划NGF Quantum Delta NL 2022,由荷兰研究委员会(NWO)和荷兰国家增长基金计划Quantum Delta NL(部分)资助。Juan Agustín Duque获得蒙特利尔大学St-Pierre-Larochelle奖学金以及Aaron Courville的系统泛化表示CIFAR AI主席的支持。
参考文献#
Alekh Agarwal, Nan Jiang, Sham Kakade, and Wen Sun. Reinforcement Learning: Theory and Algorithms. Draft/Preprint, 2021. URL https://rltheorybook.github.io/.
Rishabh Agarwal, Max Schwarzer, Pablo Samuel Castro, Aaron Courville, and Marc G. Bellemare. Deep reinforcement learning at the edge of the statistical precipice. arXiv preprint arXiv:2108.13264, 2022. doi: 10.48550/arXiv.2108.13264. URL https://arxiv.org/abs/ 2108.13264.
Shun-ichi Amari. Natural gradient works efficiently in learning. Neural Computation, 10(2): 251–276, 1998. doi: 10.1162/089976698300017746. URL https://doi.org/10.1162/ 089976698300017746.
Ariel Barr, Willem Gispen, and Austen Lamacraft. Quantum ground states from reinforcement learning. In Proceedings of the First Mathematical and Scientific Machine Learning Conference, volume 107 of Proceedings of Machine Learning Research, pages 635–653, 2020. URL https: //proceedings.mlr.press/v107/barr20a.html.
Giuseppe Carleo and Matthias Troyer. Solving the quantum many-body problem with artificial neural networks. Science, 355(6325):602–606, 2017. doi: 10.1126/science.aag2302. URL https://doi.org/10.1126/science.aag2302.
Ao Chen and Markus Heyl. Empowering deep neural quantum states through efficient optimization. Nature Physics, 20(9):1476–1481, 2024. doi: 10.1038/s41567-024-02566-1. URL https: //doi.org/10.1038/s41567-024-02566-1.
Hongwei Chen, Douglas Gerard Hendry, Phillip E. Weinberg, and Adrian Feiguin. Systematic improvement of neural network quantum states using Lanczos. In Advances in Neural Information Processing Systems, 2022. URL https://openreview.net/forum?id=qZUHvvtbzy.
Kenny Choo, Antonio Mezzacapo, and Giuseppe Carleo. Fermionic neural-network states for ab-initio electronic structure. Nature Communications, 11(1):2368, 2020. doi: 10.1038/ s41467-020-15724-9. URL https://doi.org/10.1038/s41467-020-15724-9.
Anna Dawid, Julian Arnold, Borja Requena, Alexander Gresch, Marcin Płodzien, Kaelan Donatella,´ Kim A. Nicoli, Paolo Stornati, Rouven Koch, Miriam Büttner, Robert Okuła, Gorka Muñoz Gil, Rodrigo A. Vargas-Hernández, Alba Cervera-Lierta, Juan Carrasquilla, Vedran Dunjko, Marylou Gabrié, Patrick Huembeli, Evert van Nieuwenburg, Filippo Vicentini, Lei Wang, Sebastian J. Wetzel, Giuseppe Carleo, Eliška Greplová, Roman Krems, Florian Marquardt, Michał Tomza, Maciej Lewenstein, and Alexandre Dauphin. Machine Learning in Quantum Sciences. Cambridge University Press, 2025. ISBN 9781009504935. doi: 10.1017/9781009504942. URL https: //doi.org/10.1017/9781009504942.
Luigi Del Debbio, Gian Mario Manca, and Ettore Vicari. Critical slowing down of topological modes. Physics Letters B, 594(3–4):315–323, 2004. doi: 10.1016/j.physletb.2004.05.038. URL https://doi.org/10.1016/j.physletb.2004.05.038.
Mehdi Drissi, James W. T. Keeble, Javier Rozalén Sarmiento, and Arnau Rios. Second-order optimization strategies for neural network quantum states. Philosophical Transactions of the Royal Society A, 382(2275):20240057, 2024. doi: 10.1098/rsta.2024.0057. URL https://doi.org/ 10.1098/rsta.2024.0057.
Chloé Gauvin-Ndiaye, Joseph Tindall, Javier Robledo Moreno, and Antoine Georges. Mott transition and volume law entanglement with neural quantum states. Physical Review Letters, 134(7): 076502, 2025. doi: 10.1103/PhysRevLett.134.076502. URL https://doi.org/10.1103/ PhysRevLett.134.076502.
Willem Gispen and Austen Lamacraft. Ground states of quantum many body lattice models via reinforcement learning. In Proceedings of the 2nd Mathematical and Scientific Machine Learning Conference, volume 145 of Proceedings of Machine Learning Research, pages 369–385, 2022. URL https://proceedings.mlr.press/v145/gispen22a.html.
Gil Goldshlager, Nilin Abrahamsen, and Lin Lin. A Kaczmarz-inspired approach to accelerate the optimization of neural network wavefunctions. Journal of Computational Physics, 516: 113351, 2024. doi: 10.1016/j.jcp.2024.113351. URL https://doi.org/10.1016/j.jcp. 2024.113351.
Jan Hermann, Zeno Schätzle, and Frank Noé. Deep-neural-network solution of the electronic Schrödinger equation. Nature Chemistry, 12(10):891–897, 2020. doi: 10.1038/s41557-020-0544-y. URL https://doi.org/10.1038/s41557-020-0544-y.
Mohamed Hibat-Allah, Martin Ganahl, Lauren E. Hayward, Roger G. Melko, and Juan Carrasquilla. Recurrent neural network wave functions. Physical Review Research, 2(2):023358, 2020. doi: 10.1103/PhysRevResearch.2.023358. URL https://doi.org/10.1103/PhysRevResearch. 2.023358.
Roger A. Horn and Charles R. Johnson. Matrix Analysis. Cambridge University Press, Cambridge, 2 edition, 2012. ISBN 9780521839402. doi: 10.1017/CBO9780511810817. URL https: //doi.org/10.1017/CBO9780511810817.
Jeongwoo Jae, Jeonghoon Hong, Jinho Choo, and Yeong-Dae Kwon. Reinforcement learning to learn quantum states for Heisenberg scaling accuracy. Advanced Quantum Technologies, 8(10), 2025. doi: 10.1002/qute.202500206. URL https://doi.org/10.1002/qute.202500206.
Sham Kakade and John Langford. Approximately optimal approximate reinforcement learning. In Proceedings of the Nineteenth International Conference on Machine Learning, pages 267–274, 2002. URL https://dl.acm.org/doi/10.5555/645531.656005.
Diederik P. Kingma and Jimmy Ba. Adam: A method for stochastic optimization. arXiv preprint arXiv:1412.6980, 2014. doi: 10.48550/arXiv.1412.6980. URL https://arxiv.org/abs/1412. 6980.
Hannah Lange, Anka Van de Walle, Atiye Abedinnia, and Annabelle Bohrdt. From architectures to applications: A review of neural quantum states. arXiv preprint arXiv:2402.09402, 2024. doi: 10.48550/arXiv.2402.09402. URL https://arxiv.org/abs/2402.09402.
Jing Liu, Ying Tang, and Pan Zhang. Efficient optimization of variational autoregressive networks with natural gradient. Physical Review E, 111(2):025304, 2025. doi: 10.1103/PhysRevE.111.025304. URL https://doi.org/10.1103/PhysRevE.111.025304.
James Martens and Roger Grosse. Optimizing neural networks with Kronecker-factored approximate curvature. In Proceedings of the 32nd International Conference on Machine Learning, pages 2408–2417, 2015. URL https://proceedings.mlr.press/v37/martens15.html.
Ejaaz Merali, Mohamed Hibat-Allah, Mohammad Kohandel, Richard T. Scalettar, and Ehsan Khatami. Parallel scan recurrent neural quantum states for scalable variational monte carlo, 2026. URL https://arxiv.org/abs/2605.13807.
M. Schuyler Moss, Roeland Wiersema, Mohamed Hibat-Allah, Juan Carrasquilla, and Roger G. Melko. Leveraging recurrence in neural network wavefunctions for large-scale simulations of Heisenberg antiferromagnets on the square lattice. Physical Review B, 112(13):134450, 2025. ISSN 2469-9950. doi: 10.1103/6ccd-wzhz.
M. Schuyler Moss, Alev Orfi, Christopher Roth, Anirvan M. Sengupta, Antoine Georges, Dries Sels, Anna Dawid, and Agnes Valenti. Double descent: When do neural quantum states generalize? Physical Review E, 113(4):045303, 2026. ISSN 2470-0045. doi: 10.1103/cwmj-fxr4. URL https://link.aps.org/doi/10.1103/cwmj-fxr4.
Yusuke Nomura and Masatoshi Imada. Dirac-type nodal spin liquid revealed by refined quantum many-body solver using neural-network wave function, correlation ratio, and level spectroscopy. Physical Review X, 11(3):031034, 2021. doi: 10.1103/PhysRevX.11.031034. URL https: //doi.org/10.1103/PhysRevX.11.031034.
Jannes Nys, Gabriel Pescia, Alessandro Sinibaldi, and Giuseppe Carleo. Ab-initio variational wave functions for the time-dependent many-electron Schrödinger equation. Nature Communications, 15(1):9404, 2024. doi: 10.1038/s41467-024-53672-w. URL https://doi.org/10.1038/ s41467-024-53672-w.
Bo Peng, Ruichong Zhang, Daniel Goldstein, Eric Alcaide, Xingjian Du, Haowen Hou, Jiaju Lin, Jiaxing Liu, Janna Lu, William Merrill, Guangyu Song, Kaifeng Tan, Saiteja Utpala, Nathan Wilce, Johan S. Wind, Tianyi Wu, Daniel Wuttke, and Christian Zhou-Zheng. RWKV-7 “goose” with expressive dynamic state evolution. arXiv preprint arXiv:2503.14456, 2025. doi: 10.48550/arXiv. 2503.14456. URL https://arxiv.org/abs/2503.14456.
Gabriel Pescia, Jannes Nys, Jane Kim, Alessandro Lovato, and Giuseppe Carleo. Message-passing neural quantum states for the homogeneous electron gas. Physical Review B, 110(3):035108, 2024. doi: 10.1103/PhysRevB.110.035108. URL https://doi.org/10.1103/PhysRevB.110. 035108.
David Pfau, James S. Spencer, Alexander G. D. G. Matthews, and W. M. C. Foulkes. Ab initio solution of the many-electron Schrödinger equation with deep neural networks. Physical Review Research, 2(3):033429, 2020. doi: 10.1103/PhysRevResearch.2.033429. URL https://doi. org/10.1103/PhysRevResearch.2.033429.
Yi Ren and Donald Goldfarb. Efficient subsampled Gauss-Newton and natural gradient methods for training neural networks. arXiv preprint arXiv:1906.02353, 2019. doi: 10.48550/arXiv.1906.02353. URL https://arxiv.org/abs/1906.02353.
Riccardo Rende, Luciano Loris Viteritti, Lorenzo Bardone, Federico Becca, and Sebastian Goldt. A simple linear algebra identity to optimize large-scale neural network quantum states. Communications Physics, 7(1):260, 2024. doi: 10.1038/s42005-024-01732-4. URL https: //doi.org/10.1038/s42005-024-01732-4.
Riccardo Rende, Luciano Loris Viteritti, Federico Becca, Antonello Scardicchio, Alessandro Laio, and Giuseppe Carleo. Foundation neural-networks quantum states as a unified ansatz for multiple hamiltonians. Nature Communications, 16(1):7213, 2025. doi: 10.1038/s41467-025-62098-x.
Herbert Robbins and Sutton Monro. A stochastic approximation method. The Annals of Mathematical Statistics, 22(3):400–407, 1951. doi: 10.1214/aoms/1177729586. URL https://doi.org/10. 1214/aoms/1177729586
Bidipta Sarkar, Mattie Fellows, Juan Agustin Duque, Alistair Letcher, Antonio León Villares, Anya Sims, Clarisse Wibault, Dmitry Samsonov, Dylan Cope, Jarek Liesen, Kang Li, Lukas Seier, Theo Wolf, Uljad Berdica, Valentin Mohl, Alexander David Goldie, Aaron Courville, Karin Sevegnani, Shimon Whiteson, and Jakob Nicolaus Foerster. Evolution strategies at the hyperscale. arXiv preprint arXiv:2511.16652, 2026. doi: 10.48550/arXiv.2511.16652. URL https://arxiv.org/abs/2511.16652.
John Schulman, Sergey Levine, Philipp Moritz, Michael I. Jordan, and Pieter Abbeel. Trust region policy optimization. arXiv preprint arXiv:1502.05477, 2015. doi: 10.48550/arXiv.1502.05477. URL https://arxiv.org/abs/1502.05477.
John Schulman, Filip Wolski, Prafulla Dhariwal, Alec Radford, and Oleg Klimov. Proximal policy optimization algorithms. arXiv preprint arXiv:1707.06347, 2017. doi: 10.48550/arXiv.1707.06347. URL https://arxiv.org/abs/1707.06347.
Kristof T. Schütt, Huziel E. Sauceda, Pieter-Jan Kindermans, Alexandre Tkatchenko, and Klaus-Robert Müller. Schnet—a deep learning architecture for molecules and materials. The Journal of Chemical Physics, 148(24):241722, 2018. doi: 10.1063/1.5019779. URL https://doi.org/10. 1063/1.5019779.
Or Sharir, Yoav Levine, Noam Wies, Giuseppe Carleo, and Amnon Shashua. Deep autoregressive models for the efficient variational simulation of many-body quantum systems. Physical Review Letters, 124(2):020503, 2020. doi: 10.1103/PhysRevLett.124.020503. URL https://doi.org/ 10.1103/PhysRevLett.124.020503.
Ahmedeo Shokry, Alessandro Santini, and Filippo Vicentini. When less is more: Approximating the quantum geometric tensor with block structures. arXiv preprint arXiv:2510.08430, 2025. doi: 10.48550/arXiv.2510.08430. URL https://arxiv.org/abs/2510.08430.
Leslie N. Smith and Nicholay Topin. Super-convergence: Very fast training of neural networks using large learning rates. arXiv preprint arXiv:1708.07120, 2018. doi: 10.48550/arXiv.1708.07120. URL https://arxiv.org/abs/1708.07120.
Sandro Sorella. Green function Monte Carlo with stochastic reconfiguration. Physical Review Letters, 80(20):4558–4561, 1998. doi: 10.1103/PhysRevLett.80.4558. URL https://doi.org/ 10.1103/PhysRevLett.80.4558.
Ingrid von Glehn, James S. Spencer, and David Pfau. A self-attention ansatz for ab-initio quantum chemistry. In International Conference on Learning Representations, 2023. URL https:// openreview.net/forum?id=xveTeHVlF7j.
Jia-Qi Wang, Rong-Qiang He, and Zhong-Yi Lu. Generalized Lanczos method for systematic optimization of neural-network quantum states. Physical Review B, 113(8):085120, 2026. doi: 10.1103/PhysRevB.113.085120. URL https://doi.org/10.1103/PhysRevB.113.085120.
Ronald J. Williams. Simple statistical gradient-following algorithms for connectionist reinforcement learning. Machine Learning, 8(3–4):229–256, 1992. doi: 10.1007/BF00992696. URL https: //doi.org/10.1007/BF00992696.
Ulli Wolff. Critical slowing down. Nuclear Physics B - Proceedings Supplements, 17:93–102, 1990. doi: 10.1016/0920-5632(90)90224-I. URL https://doi.org/10.1016/0920-5632(90) 90224-I.
Dian Wu, Riccardo Rossi, Filippo Vicentini, Nikita Astrakhantsev, Federico Becca, Xiaodong Cao, Juan Carrasquilla, Francesco Ferrari, Antoine Georges, Mohamed Hibat-Allah, Masatoshi Imada, Andreas M. Läuchli, Guglielmo Mazzola, Antonio Mezzacapo, Andrew Millis, Javier Robledo Moreno, Titus Neupert, Yusuke Nomura, Jannes Nys, Olivier Parcollet, Rico Pohle, Imelda Romero, Michael Schmid, J. Maxwell Silvester, Sandro Sorella, Luca F. Tocchio, Lei Wang, Steven R. White, Alexander Wietek, Qi Yang, Yiqi Yang, Shiwei Zhang, and Giuseppe Carleo. Variational benchmarks for quantum many-body problems. Science, 386(6719):296–301, 2024. doi: 10.1126/science.adg9774. URL https://doi.org/10.1126/science.adg9774.
Li Yang, Zhaoqi Leng, Guangyuan Yu, Ankit Patel, Wen-Jun Hu, and Han Pu. Deep learningenhanced variational Monte Carlo method for quantum many-body physics. Physical Review Research, 2(1):012039, 2020. doi: 10.1103/PhysRevResearch.2.012039. URL https://doi. org/10.1103/PhysRevResearch.2.012039.
Appendix#
B.1 Proof of Proposition 3.1 . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . B.2 Variational Gradient Derivation . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . . B.3 Variational Gradient Decomposition. 19 B.4 Exact Complex-Amplitude Decomposition. 19 B.5 Amplitude and Phase Trust Regions Control Infidelity. 21 B.6 PWO Surrogate Upper Bound and First-Order Consistency. 21 B.7 Clipped PWO Improvement Certificate. 23 C.1 Numerical Cost of Stochastic Reconfiguration and Improvements. 25 C.2 Relative Speed of PWO per Iteration. 25 C.3 Why RWKV? 26 C.4 Limitations of PWO. 26 D.1 Hyperparameter search. 27 D.2 Neural Quantum State Architecture. 27 D.3 Ising Model. 28 D.4 Heisenberg Chain. 28 D.5 Heisenberg $J_{1} - J_{2}$ Chain. 29 D.6 Two-dimensional $J_{1} - J_{2}$ square-lattice experiment. 29 D.7 Scaling Experiment. 30 D.8 RWKV-7 on Ising Model. 31 E.1 Individual Seed Plots for All Hamiltonias. 32 E.2 Scaling Samples and System Sizes. 33 E.3 Individual Seed Plots for RWKV7 Fine-tuning. 34
狄拉克符号#
本附录将自包含地介绍本文使用的狄拉克括号记号。
希尔伯特空间。量子态存在于一个称为希尔伯特空间的复向量空间 $\mathcal{H}$ 中,该空间配备了内积。对于由N个自旋-1/2粒子组成的系统,希尔伯特空间为 $\mathcal{H} = \dot{(} \mathbb{C}^{2} )^{\otimes N}$,其维度为 $2^{N}$。一个自然的正交归一基是计算(自旋)基,其元素 |s⟩ 由二进制自旋构型 $\mathbf{s} \in \{\pm 1 \}^{N}$ 索引。
右矢。量子态写作右矢 $| \psi \rangle$,它仅仅是 $\mathcal{H}$ 中的一个列向量。任何态都可以在计算基下展开:
$$ | \psi \rangle = \sum_{\mathbf{s} \in \{\pm 1 \}^{N}} \psi (\mathbf{s}) | \mathbf{s} \rangle ,\tag{25} $$其中每个系数 $\psi ( \mathbf{s} ) \in \mathbb{C}$ 是构型 s 的振幅。因此,向量 $| \psi \rangle$ 完全由映射 $\mathbf{s} \mapsto \boldsymbol \psi ( \mathbf{s} )$ 确定,NQS使用神经网络对其进行参数化。
左矢与内积。左矢 ⟨ψ| 是 |ψ⟩ 的共轭转置(厄米共轭):
$$ \langle \psi | = | \psi \rangle^{\dagger}.\tag{26} $$两个态的内积写作 $\langle \phi | \psi \rangle$,其值为复数 $\sum_{\mathbf{s}} \phi ( \mathbf{s} )^{*} \psi ( \mathbf{\hat{s}} )$。当 $\phi = \psi$ 时,得到范数平方 $\begin{array} {r} {\langle \psi | \psi \rangle = \sum_{\mathbf{s}} | \psi ( \mathbf{s} ) | ^{2} \geq 0} \end{array}$,等号仅当为零向量时成立。基态是正交归一的:
$$ \langle \mathbf{s} | \mathbf{s}^{\prime} \rangle = \delta_{\mathbf{s}, \mathbf{s}^{\prime}},\tag{27} $$其中 $\delta_{\mathbf{s} , \mathbf{s}^{\prime}}$ 是克罗内克δ函数。
完备性关系。基态构成完备集,这意味着单位算符1可以分解为:
$$ \sum_{\mathbf{s}} | \mathbf{s} \rangle \langle \mathbf{s} | = \mathbb{1}.\tag{28} $$在推导中(例如附录B.2)会反复使用此式来插入基展开,将抽象的算符方程转化为自旋构型上的求和。
算符与矩阵元。量子算符 $\hat{A}$ 是一个线性映射 $\mathcal{H} \to \mathcal{H}$,在计算基下表示为 $2^{N} \times 2^{N}$ 矩阵。位于行s和列s′的矩阵元为:
$$ \langle \mathbf{s} | \hat{A} | \mathbf{s}^{\prime} \rangle = \langle \mathbf{s} | (\hat{A} | \mathbf{s}^{\prime} \rangle) = (\mathbf{A})_{\mathbf{s}, \mathbf{s}^{\prime}}.\tag{29} $$若 $\hat{A} = \hat{A}^{\dagger}$,则算符是厄米的(或自伴的),这意味着其特征值为实数。哈密顿量 Hˆ 总是厄米的,因为能量是实数值可观测物理量。
期望值。可观测物理量 $\hat{A}$ 在态 $| \psi \rangle$ 中的期望值为:
$$ \langle \hat{A} \rangle_{\psi} := \frac{\langle \psi | \hat{A} | \psi \rangle}{\langle \psi | \psi \rangle}.\tag{30} $$对于哈密顿量,这给出了NQS最小化的变分能量 $E [ \psi ] = \left. \psi | \hat{H} | \psi \right. / \left. \psi | \psi \right.$。当 |ψ⟩ 归一化时 $( \langle \psi | \psi \rangle = 1 )$,分母可省略。
汇总表#
| 狄拉克符号 | 线性代数等价 | 本文中的含义 |
| $|\psi\rangle$ | $\mathbb{C}^{2^N}$ 中的列向量 | 量子态/波函数 |
| $\langle\psi|$ | 共轭行向量 | 对偶/伴随态 |
| $\langle\phi|\psi\rangle$ | $\phi^\dagger\psi$ (点积) | 内积;两个态的重叠 |
| $\langle\psi|\psi\rangle$ | $\| \psi \| ^2$ | 范数平方;归一化态为1 |
| $|s\rangle$ | 标准基向量 $e_s$ | 自旋构型基态 |
| $\langle s|\hat{H}|s'\rangle$ | $(\mathbf{H})_{s,s'}$ 矩阵元 | 哈密顿量矩阵元 |
| $\langle\psi|\hat{H}|\psi\rangle$ | $\psi^\dagger\mathbf{H}\psi$ (二次型) | (未归一化)变分能量 |
| $\sum_s |s\rangle \langle s|$ | $\mathbb{1}_{2^N}$ (单位矩阵) | 完备性/单位分解 |
命题3.1 (变分能量最小化的策略梯度形式)。假设哈密顿量是stoquastic的,即在所选计算基下的矩阵表示中非对角元素非正。那么我们可以设 $f_{\pmb \theta} = \log \psi_{\pmb \theta} = \log | \bar{\psi}_{\pmb \theta} |$ ,且变分能量的梯度可以写成策略梯度形式
$$ \nabla_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \big [ \big (E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} [ E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) ] \big) \nabla_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \big ].\tag{14} $$特别地,变分能量最小化等价于对构型进行优势策略梯度更新。证明见附录B.1。
证明。我们遵循策略梯度定理的证明策略 [Agarwal et al., 2021],将标准NQS/VMC梯度估计器与概率分布自回归参数化时的REINFORCE型更新联系起来。
求导可得
$$ \nabla_{\pmb{\theta}} E [ \psi_{\pmb{\theta}} ] = \nabla_{\pmb{\theta}} \sum_{\mathbf{s}} \mathcal{P}_{\pmb{\theta}} (\mathbf{s}) E_{\pmb{\theta}}^{\mathrm{loc}} (\mathbf{s})\tag{31} $$$$ = \sum_{\mathbf{s}} \nabla_{\boldsymbol{\theta}} \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) + \sum_{\mathbf{s}} \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \nabla_{\boldsymbol{\theta}} E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s})\tag{32} $$$$ = \sum_{\mathbf{s}} \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) E_{\boldsymbol{\theta}}^{\text{loc}} (\mathbf{s}) \nabla_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) + \sum_{\mathbf{s}} \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \nabla_{\boldsymbol{\theta}} E_{\boldsymbol{\theta}}^{\text{loc}} (\mathbf{s})\tag{33} $$$$ = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \big [ E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) \nabla_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \big ] + \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \big [ \nabla_{\boldsymbol{\theta}} E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) \big ].\tag{34} $$现在分析第二项。定义对数导数可观测量
$$ \mathbf{O} (\mathbf{s}) := \nabla_{\boldsymbol{\theta}} \log \psi_{\boldsymbol{\theta}} (\mathbf{s}), $$则
$$ \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \big [ \nabla_{\boldsymbol{\theta}} E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) \big ] = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \Bigg [ \nabla_{\boldsymbol{\theta}} \sum_{\mathbf{s}^{\prime}} \frac{\psi_{\boldsymbol{\theta}} (\mathbf{s}^{\prime})}{\psi_{\boldsymbol{\theta}} (\mathbf{s})} \left< \mathbf{s} | \hat{H} | \mathbf{s}^{\prime} \right> \Bigg ]\tag{35} $$$$ = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ \sum_{\mathbf{s}^{\prime}} \langle \mathbf{s} | \hat{H} | \mathbf{s}^{\prime} \rangle \frac{(\psi_{\boldsymbol{\theta}} (\mathbf{s}) \nabla_{\boldsymbol{\theta}} \psi_{\boldsymbol{\theta}} (\mathbf{s}^{\prime}) - \nabla_{\boldsymbol{\theta}} \psi_{\boldsymbol{\theta}} (\mathbf{s}) \psi_{\boldsymbol{\theta}} (\mathbf{s}^{\prime}))}{\psi_{\boldsymbol{\theta}} (\mathbf{s})^{2}} \right]\tag{36} $$$$ = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ \sum_{\mathbf{s}^{\prime}} \langle \mathbf{s} | \hat{H} | \mathbf{s}^{\prime} \rangle \frac{\psi_{\boldsymbol{\theta}} (\mathbf{s}^{\prime})}{\psi_{\boldsymbol{\theta}} (\mathbf{s})} (\mathbf{O} (\mathbf{s}^{\prime}) - \mathbf{O} (\mathbf{s})) \right]\tag{37} $$$$ = \sum_{\mathbf{s}} \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \sum_{\mathbf{s}^{\prime}} \hat{H}_{\mathbf{s}, \mathbf{s}^{\prime}} \frac{\psi_{\boldsymbol{\theta}} (\mathbf{s}^{\prime})}{\psi_{\boldsymbol{\theta}} (\mathbf{s})} (\mathbf{O} (\mathbf{s}^{\prime}) - \mathbf{O} (\mathbf{s})),\tag{38} $$其中 ${\hat{H}}_{\mathbf{s} , \mathbf{s}^{\prime}} = \langle \mathbf{s} | {\hat{H}} | \mathbf{s}^{\prime} \rangle$ ,可得双重和形式
$$ \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \big [ \nabla_{\boldsymbol{\theta}} E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) \big ] = \frac{1}{Z_{\boldsymbol{\theta}}} \sum_{\mathbf{s}, \mathbf{s}^{\prime}} \psi_{\boldsymbol{\theta}} (\mathbf{s}) \psi_{\boldsymbol{\theta}} (\mathbf{s}^{\prime}) \hat{H}_{\mathbf{s}, \mathbf{s}^{\prime}} (\mathbf{O} (\mathbf{s}^{\prime}) - \mathbf{O} (\mathbf{s})).\tag{39} $$至此,唯一遗留的问题是(39)中的第二项是否为零。当哈密顿量在所选基下是stoquastic时,该情形成立。此时其矩阵元为实数,且埃尔米特性意味着 $\hat{H}_{\mathbf{s} , \mathbf{s}^{\prime}} = \hat{H}_{\mathbf{s}^{\prime} , \mathbf{s}}$ 。此外,根据Perron-Frobenius定理 [Horn and Johnson, 2012],stoquastic哈密顿量基态波函数的所有分量都是实数且严格为正,因此 $\psi_{\pmb{\theta}} ( \mathbf{s} ) = | \psi_{\pmb{\theta}} ( \mathbf{s} )$ 且对数导数可观测量 $\mathbf{O} ( \mathbf{s} )$ 为实值。
在此假设下,(39)中的因子 $\psi_{\pmb \theta} ( \mathbf{s} ) \psi_{\pmb \theta} ( \mathbf{s}^{\prime} ) \hat{H}_{\mathbf{s} , \mathbf{s}^{\prime}}$ 在交换s和$\mathbf{s}^{\prime} {\mathrm{.}}$ 时对称,而差值 $\mathbf{O} ( \mathbf{s}^{\prime} ) - \mathbf{O} ( \mathbf{\bar{s}} )$ 是反对称的。因此,双重和中的每一项与交换s和$\mathbf{s}^{\prime}$ 得到的项相互抵消,整个和为零。故,
$$ \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \big [ \nabla_{\boldsymbol{\theta}} E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) \big ] = 0.\tag{40} $$代回(34)得到纯得分函数(策略梯度)估计器:
$$ \nabla_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ E_{\boldsymbol{\theta}}^{\text{loc}} (\mathbf{s}) \nabla_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \right].\tag{41} $$此外,对于任何不依赖于s的常数c,
$$ \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} [ c \nabla_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) ] = c \sum_{\mathbf{s}} \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \nabla_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s})\tag{42} $$$$ = c \sum_{\mathbf{s}} \nabla_{\boldsymbol{\theta}} \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s})\tag{43} $$$$ = c \nabla_{\boldsymbol{\theta}} \sum_{\mathbf{s}} \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s})\tag{44} $$$$ = c \nabla_{\theta} 1 = 0.\tag{45} $$因此我们可以减去任意常数基线而不引入偏差 [Agarwal et al., 2021]。选取全局能量 $\begin{array} {r} {\dot{E [ \psi_{\pmb \theta} ]} = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb \theta}} [ E_{\pmb \theta}^{\mathrm{loc}} ( \mathbf{s} ) ]} \end{array}$ 作为基线,得到形式
$$ \nabla_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \big [ \big (E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} [ E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) ] \big) \nabla_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \big ],\tag{46} $$这类似于REINFORCE估计器的优势形式 [Agarwal et al., 2021]。## B.2 变分梯度推导
本节中,我们展示如何从式(8)推导出式(11)中著名的VMC梯度 [Carleo and Troyer, 2017]。我们从能量的通用表达式出发,该表达式适用于任意(不一定是归一化的)态 $|\psi_{\boldsymbol{\theta}}\rangle$:
$$ E [ \psi_{\boldsymbol{\theta}} ] = \frac{\langle \psi_{\boldsymbol{\theta}} | \hat{H} | \psi_{\boldsymbol{\theta}} \rangle}{\langle \psi_{\boldsymbol{\theta}} | \psi_{\boldsymbol{\theta}} \rangle}.\tag{47} $$利用商法则和 $\hat{H}$ 的厄米性对 $\theta_{k}$ 求导可得:
$$ \partial_{\theta_{k}} E [ \psi_{\boldsymbol{\theta}} ] = \frac{2 \operatorname{Re} \left\{\left(\partial_{\theta_{k}} \langle \psi_{\boldsymbol{\theta}} |\right) \hat{H} | \psi_{\boldsymbol{\theta}} \rangle \right\}}{\langle \psi_{\boldsymbol{\theta}} | \psi_{\boldsymbol{\theta}} \rangle} - E [ \psi_{\boldsymbol{\theta}} ] \frac{2 \operatorname{Re} \left\{\left(\partial_{\theta_{k}} \langle \psi_{\boldsymbol{\theta}} |\right) | \psi_{\boldsymbol{\theta}} \rangle \right\}}{\langle \psi_{\boldsymbol{\theta}} | \psi_{\boldsymbol{\theta}} \rangle}.\tag{48} $$由于最终结果与范数无关,我们选择方便的归一化条件 $\langle \psi_{\pmb \theta} | \psi_{\pmb \theta} \rangle = 1$,从而将表达式简化为:
$$ \partial_{\theta_{k}} E [ \psi_{\boldsymbol{\theta}} ] = 2 \operatorname{Re} \left\{\left(\partial_{\theta_{k}} \langle \psi_{\boldsymbol{\theta}} |\right) (\hat{H} - E [ \psi_{\boldsymbol{\theta}} ]) | \psi_{\boldsymbol{\theta}} \rangle \right\}.\tag{49} $$我们两次插入完备性关系 $\begin{array} {r} {\sum_{\mathbf{s}} | \mathbf{s} \rangle \langle \mathbf{s} | = \mathbb{I}} \end{array}$ 并使用 $\mathcal{P}_{\pmb{\theta}} ( \mathbf{s} ) = | \psi_{\pmb{\theta}} ( \mathbf{s} ) | ^{2}$ 得到:
$$ \left(\partial_{\theta_{k}} \langle \psi_{\pmb{\theta}} |\right) \big (\hat{H} - E [ \psi_{\pmb{\theta}} ] \big) | \psi_{\pmb{\theta}} \rangle = \sum_{\mathbf{s}} (\partial_{\theta_{k}} \langle \psi_{\pmb{\theta}} |) | \mathbf{s} \rangle \langle \mathbf{s} | \big (\hat{H} - E [ \psi_{\pmb{\theta}} ] \big) | \psi_{\pmb{\theta}} \rangle\tag{50} $$$$ = \sum_{\mathbf{s}} \partial_{\theta_{k}} \psi_{\boldsymbol{\theta}}^{*} (\mathbf{s}) \left(\sum_{\mathbf{s}^{\prime}} \langle \mathbf{s} | \hat{H} | \mathbf{s}^{\prime} \rangle \langle \mathbf{s}^{\prime} | \psi_{\boldsymbol{\theta}} \rangle - E [ \psi_{\boldsymbol{\theta}} ] \psi_{\boldsymbol{\theta}} (\mathbf{s})\right)\tag{51} $$$$ = \sum_{\mathbf{s}} \psi_{\boldsymbol{\theta}}^{*} (\mathbf{s}) O_{k}^{*} (\mathbf{s}) \left(\sum_{\mathbf{s}^{\prime}} \hat{H}_{\mathbf{s}, \mathbf{s}^{\prime}} \psi_{\boldsymbol{\theta}} (\mathbf{s}^{\prime}) - E [ \psi_{\boldsymbol{\theta}} ] \psi_{\boldsymbol{\theta}} (\mathbf{s})\right)\tag{52} $$$$ = \sum_{\mathbf{s}} | \psi_{\boldsymbol{\theta}} (\mathbf{s}) | ^{2} O_{k}^{*} (\mathbf{s}) \left(E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) - E [ \psi_{\boldsymbol{\theta}} ]\right)\tag{53} $$$$ = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \Big [ O_{k}^{*} (\mathbf{s}) \Big (E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} [ E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) ] \Big) \Big ],\tag{54} $$(55)
其中最后一步我们利用了 $E [ \psi_{\pmb \theta} ] = \mathbb{E}_{{\mathbf s} \sim \mathcal{P}_{\pmb \theta}} [ E_{\pmb \theta}^{\mathrm{loc}} ( {\mathbf s} ) ]$。因此,
$$ \partial_{\theta_{k}} E [ \psi_{\boldsymbol{\theta}} ] = 2 \operatorname{Re} \left\{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \Big [ O_{k}^{*} (\mathbf{s}) \Big (E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} [ E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) ] \Big) \Big ] \right\}.\tag{56} $$## B.3 变分梯度分解
为开发实用算法,可将VMC梯度分解为概率分量和相位分量,具体如下。从标准VMC/NQS梯度估计器出发,可写出
$$ \nabla_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] = 2 \mathrm{Re} \left\{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \big [ \big (E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} [ E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) ] \big) \mathbf{O} (\mathbf{s})^{*} \big ] \right\}.\tag{57} $$回忆∗表示复共轭,且
$$ E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) = \operatorname{Re} \left\{E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) \right\} + i \cdot \operatorname{Im} \left\{E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) \right\}, \quad \mathbf{O} (\mathbf{s}) = \operatorname{Re} \left\{\mathbf{O} (\mathbf{s}) \right\} + i \cdot \operatorname{Im} \left\{\mathbf{O} (\mathbf{s}) \right\}.\tag{58} $$为方便起见,记$E_{R} : = \operatorname{Re} {\left\{E_{\pmb{\theta}}^{\mathrm{loc}} ( \mathbf{s} ) \right\}}$和$E_{I} : = \operatorname{Im} {\big \{} E_{\theta}^{\mathrm{loc}} ( \mathbf{s} ) {\big \}}$(对$\mathbf{O} ( \mathbf{s} )$类似)。现在可写出
$$ \nabla_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] = 2 \mathrm{Re} \left\{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \big [ \big ((E_{R} - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} [ E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) ]) + i E_{I} \big) (O_{R} - i O_{I}) \big ] \right\}\tag{59} $$$$ = 2 \mathrm{Re} \{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\theta}} [ (E_{R} - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\theta}} [ E_{\pmb{\theta}}^{\mathrm{loc}} (\mathbf{s}) ]) O_{R}\tag{60} $$$$
- i (E_{R} - \mathbb{E}{\mathbf{s} \sim \mathcal{P}{\boldsymbol{\theta}}} [ E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) ]) O_{I} + i E_{I} O_{R} + E_{I} O_{I} ] }\tag{61} $$
这精确展示了当分别参数化振幅的实部和虚部时,应如何更新模型。此外,我们可以从第二项(对应参数化的虚部)减去常数基线c以降低方差:
$$ 2 \operatorname{Re} \left\{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\theta}} [ E_{I} (O_{I} - c) ] \right\} = 2 \operatorname{Re} \left\{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\theta}} [ E_{I} O_{I} ] \right\} - 2 \operatorname{Re} \left\{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\theta}} [ E_{I} c ] \right\}\tag{63} $$$$ = 2 \mathrm{Re} \left\{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\theta}} [ E_{I} O_{I} ] \right\} - 2 c \mathrm{Re} \left\{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\theta}} [ E_{I} ] \right\}\tag{64} $$$$ = 2 \mathrm{Re} \{\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\theta}} [ E_{I} O_{I} ] \},\tag{65} $$其中第65行来源于厄米算符下期望值的实性。因此与之前一样,我们可以减去基线以降低方差。
为寻找方差最小化常数,考虑梯度的虚部贡献的单样本估计器
$$ g_{I} (\mathbf{s}; c) := 2 E_{I} (\mathbf{s}) (O_{I} (\mathbf{s}) - c).\tag{66} $$由于$\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} [ E_{I} ( \mathbf{s} ) ] = 0$,减去任意常数c保持估计无偏:
$$ \mathbb{E} [ g_{I} (\mathbf{s}; c) ] = 2 \mathbb{E} [ E_{I} (\mathbf{s}) O_{I} (\mathbf{s}) ].\tag{67} $$因此,最优常数是使$\mathbb{V} ( g_{I} ( \mathbf{s} ; c ) )$最小化的常数,等价于最小化其二阶矩:
$$ \underset{c} {\operatorname{argmin}} \mathbb{E} \Big [ E_{I} (\mathbf{s})^{2} (O_{I} (\mathbf{s}) - c)^{2} \Big ].\tag{68} $$对c求导并令导数为零得
$$ 0 = \frac{\partial}{\partial c} \mathbb{E} \left[ E_{I} (\mathbf{s})^{2} (O_{I} (\mathbf{s}) - c)^{2} \right]\tag{69} $$$$ = - 2 \mathbb{E} \left[ E_{I} (\mathbf{s})^{2} (O_{I} (\mathbf{s}) - c) \right],\tag{70} $$因此方差最小化基线为
$$ c^{\star} = \frac{\mathbb{E} \left[ E_{I} (\mathbf{s})^{2} O_{I} (\mathbf{s}) \right]}{\mathbb{E} \left[ E_{I} (\mathbf{s})^{2} \right]}.\tag{71} $$若$O_{I} ( \mathbf{s} )$为向量值,此公式逐坐标应用。我们在实践中尝试使用该最小化器,但其实现需要额外的前向和反向传播,导致其速度显著慢于原始梯度表达式。## B.4 精确复振幅分解
现在推导两个归一化复波函数之间能量差的精确分解。设 $| \psi_{\pmb{\theta}} \rangle$ 为参考态,$| \psi_{\pmb{\theta}^{\prime}} \rangle$ 为候选态。选择 $| \psi_{\pmb{\theta}^{\prime}} \rangle$ 的整体相位使得
$$ \langle \psi_{\pmb{\theta}} | \psi_{\pmb{\theta}^{\prime}} \rangle = | \langle \psi_{\pmb{\theta}} | \psi_{\pmb{\theta}^{\prime}} \rangle | = \sqrt{1 - \mathcal{I} (\psi_{\pmb{\theta}} , \psi_{\pmb{\theta}^{\prime}})}.\tag{72} $$定义
$$ r_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) := \frac{\mathcal{P}_{\boldsymbol{\theta}^{\prime}} (\mathbf{s})}{\mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s})}, \qquad z_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) := \frac{\psi_{\boldsymbol{\theta}^{\prime}} (\mathbf{s})}{\psi_{\boldsymbol{\theta}} (\mathbf{s})}.\tag{73} $$写作
$$ z_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) = \sqrt{r_{\boldsymbol{\theta}^{\prime} ; \boldsymbol{\theta}} (\mathbf{s})} e^{i \alpha_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s})}, $$我们取环绕相位差
$$ \alpha_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) = \operatorname{atan}_{2} \left(\sin \left(\arg \psi_{\boldsymbol{\theta}^{\prime}} (\mathbf{s}) - \arg \psi_{\boldsymbol{\theta}} (\mathbf{s})\right), \cos \left(\arg \psi_{\boldsymbol{\theta}^{\prime}} (\mathbf{s}) - \arg \psi_{\boldsymbol{\theta}} (\mathbf{s})\right)\right).\tag{74} $$为后续使用,定义PWO相位增量
$$ \phi_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) := 2 \alpha_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}).\tag{75} $$因子2的出现是因为式(62)中的VMC相位梯度包含 $2 A_{\theta}^{\mathrm{I}} \nabla \arg \psi_{\theta}$。
定理B.1 (精确复振幅分解)。设
$$ \hat{K}_{\boldsymbol{\theta}} := \hat{H} - E [ \psi_{\boldsymbol{\theta}} ] \mathbb{1}, \qquad | \eta \rangle := | \psi_{\boldsymbol{\theta}^{\prime}} \rangle - | \psi_{\boldsymbol{\theta}} \rangle , $$并设
$$ \Delta E_{\boldsymbol{\theta}}^{\mathrm{loc}} := E_{\boldsymbol{\theta}}^{\mathrm{loc}} - E [ \psi_{\boldsymbol{\theta}} ] = A_{\boldsymbol{\theta}}^{\mathrm{R}} + i A_{\boldsymbol{\theta}}^{\mathrm{I}}. $$则
$$ E [ \psi_{\pmb{\theta}^{\prime}} ] - E [ \psi_{\pmb{\theta}} ] = 2 \mathrm{Re} \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} \left[ z_{\pmb{\theta}^{\prime}; \pmb{\theta}} (\mathbf{s})^{*} \Delta E_{\pmb{\theta}}^{\mathrm{loc}} (\mathbf{s}) \right] + \langle \eta | \hat{K}_{\pmb{\theta}} | \eta \rangle .\tag{76} $$因此,
$$ E [ \psi_{\pmb{\theta}^{\prime}} ] - E [ \psi_{\pmb{\theta}} ] \leq 2 \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} \left[ \sqrt{r} \cos \alpha A_{\pmb{\theta}}^{\mathrm{R}} \right] + 2 \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} \left[ \sqrt{r} \sin \alpha A_{\pmb{\theta}}^{\mathrm{I}} \right]\tag{77} $$$$
- 2 \Big | \hat{H} - E [ \psi_{\pmb{\theta}} ] \mathbb{1} \Big | {\infty} \left(1 - \sqrt{1 - \mathcal{I} (\psi{\pmb{\theta}} , \psi_{\pmb{\theta}^{\prime}})}\right),\tag{78} $$
其中,为清晰起见,我们省略了 $r$ 和 $\alpha$ 上的 $( \pmb \theta^{\prime} ; \pmb \theta )$ 下标。
证明。由于 $\langle \psi_{\pmb \theta} | \hat{K}_{\pmb \theta} | \psi_{\pmb \theta} \rangle = 0$,在参考态附近展开得
$$ \begin{array}{r l} & E [ \psi_{\boldsymbol{\theta}^{\prime}} ] - E [ \psi_{\boldsymbol{\theta}} ] = \langle \psi_{\boldsymbol{\theta}^{\prime}} | \hat{K}_{\boldsymbol{\theta}} | \psi_{\boldsymbol{\theta}^{\prime}} \rangle \\ & \qquad = 2 \operatorname{Re} \langle \eta | \hat{K}_{\boldsymbol{\theta}} | \psi_{\boldsymbol{\theta}} \rangle + \langle \eta | \hat{K}_{\boldsymbol{\theta}} | \eta \rangle . \end{array}\tag{79} $$(80)
此外,$\eta ( \mathbf{s} ) = ( z_{\theta^{\prime} ; \theta} ( \mathbf{s} ) - 1 ) \psi_{\theta} ( \mathbf{s} )$,且
$$ \langle \mathbf{s} | \hat{K}_{\boldsymbol{\theta}} | \psi_{\boldsymbol{\theta}} \rangle = \psi_{\boldsymbol{\theta}} (\mathbf{s}) \Delta E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}). $$因此,
$$ \begin{array}{r l} & {\langle \eta | \hat{K}_{\boldsymbol{\theta}} | \psi_{\boldsymbol{\theta}} \rangle = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ (z_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s})^{*} - 1) \Delta E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) \right]} \\ & {\qquad = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ z_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s})^{*} \Delta E_{\boldsymbol{\theta}}^{\mathrm{loc}} (\mathbf{s}) \right],} \end{array}\tag{81} $$(82)
因为 $\begin{array} {r} {\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} [ \Delta E_{\pmb{\theta}}^{\mathrm{loc}} ( \mathbf{s} ) ] = 0} \end{array}$。残差满足
$$ \langle \eta | \hat{K}_{\boldsymbol{\theta}} | \eta \rangle \leq \left| \langle \eta | \hat{K}_{\boldsymbol{\theta}} | \eta \rangle \right| \leq \left\| \hat{K}_{\boldsymbol{\theta}} \right\| _{\infty} \| \eta \| ^{2}.\tag{83} $$根据式(72)的相位约定,
$$ \left\| \eta \right\| ^{2} = 2 - 2 \operatorname{Re} \left\langle \psi_{\boldsymbol{\theta}} | \psi_{\boldsymbol{\theta}^{\prime}} \right\rangle = 2 \left(1 - \sqrt{1 - \mathcal{I} (\psi_{\boldsymbol{\theta}} , \psi_{\boldsymbol{\theta}^{\prime}})}\right).\tag{84} $$最后,
$$ \mathrm{Re} \left[ z^{*} \Delta E_{\boldsymbol{\theta}}^{\mathrm{loc}} \right] = \sqrt{r} \left(\cos \alpha A_{\boldsymbol{\theta}}^{\mathrm{R}} + \sin \alpha A_{\boldsymbol{\theta}}^{\mathrm{I}}\right),\tag{85} $$由此得证。## B.5 振幅与相位置信域约束不保真度
上述基于保守策略迭代(CPI)的界限,取决于当前波函数与候选波函数之间的不保真度。我们现在证明,对Born分布和相位的独立置信域能够推导出这样一类不保真度置信域。
引理B.2(振幅与相位置信域蕴含不保真度置信域)。设$0 \leq \epsilon < 1$且$0 \leq \delta \leq \pi / 2$。假设不存在测度为零的事件,并且对于每个满足$\begin{array} {r} {\mathcal{P}_{\pmb{\theta}} ( \mathbf{s} ) > 0 ,} \end{array}$的构型,有
$$ 1 - \epsilon \leq r_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) \leq 1 + \epsilon ,\tag{86} $$且相位在全局相位意义下满足
$$ \left| \alpha_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) \right| \leq \delta / 2.\tag{87} $$则有
$$ \mathcal{I} (\psi_{\boldsymbol{\theta}}, \psi_{\boldsymbol{\theta}^{\prime}}) \leq 1 - \cos^{2} \left(\frac{\delta}{2}\right) \frac{1 + \sqrt{1 - \epsilon^{2}}}{2}.\tag{88} $$证明。重叠量满足
$$ \langle \psi_{\boldsymbol{\theta}^{\prime}} | \psi_{\boldsymbol{\theta}} \rangle = \sum_{\mathbf{s}} \sqrt{\mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \mathcal{P}_{\boldsymbol{\theta}^{\prime}} (\mathbf{s})} e^{i \alpha_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s})} = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ \sqrt{r_{\boldsymbol{\theta}^{\prime} ; \boldsymbol{\theta}} (\mathbf{s})} e^{i \alpha_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s})} \right].\tag{89} $$由于$| \alpha_{\pmb{\theta}^{\prime} ; \pmb{\theta}} ( \mathbf{s} ) | \leq \delta / 2 \leq \pi / 4$,可得
$$ | \langle \psi_{\boldsymbol{\theta}^{\prime}} | \psi_{\boldsymbol{\theta}} \rangle | \geq \mathrm{Re} \langle \psi_{\boldsymbol{\theta}^{\prime}} | \psi_{\boldsymbol{\theta}} \rangle\tag{90} $$$$ = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ \sqrt{r_{\boldsymbol{\theta}^{\prime} ; \boldsymbol{\theta}} (\mathbf{s})} \cos \alpha_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) \right]\tag{91} $$$$ \geq \cos \left(\frac{\delta}{2}\right) \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ \sqrt{r_{\boldsymbol{\theta}^{\prime} ; \boldsymbol{\theta}} (\mathbf{s})} \right].\tag{92} $$接下来需要给出振幅因子的下界。设$a_{0} = 1 {-} \epsilon{\mathrm{and}} b_{0} = 1 {+} \epsilon$。由于$r_{\pmb{\theta}^{\prime} ; \pmb{\theta}} ( \mathbf{s} ) \in [ a_{0} , b_{0} ]$且$\sqrt{x}$是凹函数,其图像位于区间$[ a_{0} , b_{0} ]$上弦的上方:
$$ \sqrt{r_{\boldsymbol{\theta}^{\prime} ; \boldsymbol{\theta}} (\mathbf{s})} \geq \frac{b_{0} - r_{\boldsymbol{\theta}^{\prime} ; \boldsymbol{\theta}} (\mathbf{s})}{b_{0} - a_{0}} \sqrt{a_{0}} + \frac{r_{\boldsymbol{\theta}^{\prime} ; \boldsymbol{\theta}} (\mathbf{s}) - a_{0}}{b_{0} - a_{0}} \sqrt{b_{0}}.\tag{93} $$取期望,利用期望的线性性质及
$$ \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} [ r_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) ] = \sum_{\mathbf{s}} \mathcal{P}_{\boldsymbol{\theta}^{\prime}} (\mathbf{s}) = 1,\tag{94} $$得到
$$ \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ \sqrt{r_{\boldsymbol{\theta}^{\prime} ; \boldsymbol{\theta}} (\mathbf{s})} \right] \geq \frac{b_{0} - 1}{b_{0} - a_{0}} \sqrt{a_{0}} + \frac{1 - a_{0}}{b_{0} - a_{0}} \sqrt{b_{0}} = \frac{\sqrt{1 - \epsilon} + \sqrt{1 + \epsilon}}{2}.\tag{95} $$结合式(92)与式(95),再取平方,即得式(88)。其紧凑形式源于
$$ \left(\frac{\sqrt{1 - \epsilon} + \sqrt{1 + \epsilon}}{2}\right)^{2} = \frac{1 + \sqrt{1 - \epsilon^{2}}}{2}. $$小置信域展开可由$\cos^{2} \delta = 1 - \delta^{2} + O ( \delta^{4} )$和$( 1 + \sqrt{1 - \epsilon^{2}} ) / 2 = $ $1 - \epsilon^{2} / 4 + O ( \epsilon^{4} )$得到。□## B.6 PWO替代上界与一阶一致性
现在我们将精确复振幅分解与实际PWO替代函数建立联系。精确分解包含系数 $2 \sqrt{r}$ cos α 和 $2 \sqrt{r}$ sin α,而PWO使用更简单的一阶替代r和 $r \phi = 2 r \alpha$。以下引理控制相位近似误差。
引理B.3(PWO相位系数的二次误差)。对于任意 $t \geq 0$ 和 $\alpha \in [ - \pi , \pi ]$
$$ \left| 2 t \sin \alpha - 2 t^{2} \alpha \right| \leq 4 \pi^{2} \left| t e^{i \alpha} - 1 \right| ^{2}.\tag{96} $$证明:设
$$ d (t, \alpha) := | t e^{i \alpha} - 1 | ^{2} = (t - 1)^{2} + 2 t (1 - \cos \alpha).\tag{97} $$我们考虑t的三个范围。若 $0 \leq t \leq 1 / 2$,则 $d ( t , \alpha ) \geq ( 1 - t )^{2} \geq 1 / 4$,同时
$$ | 2 t \sin \alpha - 2 t^{2} \alpha | \leq 2 t + 2 \pi t^{2} \leq 1 + \frac{\pi}{2} \leq 4 \pi^{2} d (t, \alpha).\tag{98} $$若$ t \geq 2$,则 $d ( t , \alpha ) \geq ( t - 1 )^{2} \geq t^{2} / 4$,且
$$ \left| 2 t \sin \alpha - 2 t^{2} \alpha \right| \leq 2 t + 2 \pi t^{2} \leq 4 \pi^{2} d (t, \alpha).\tag{99} $$只需考虑 $1 / 2 \leq t \leq 2$ 的情况。我们写
$$ 2 t \sin \alpha - 2 t^{2} \alpha = 2 t (\sin \alpha - \alpha) + 2 t \alpha (1 - t),\tag{100} $$并利用由泰勒展开推导出的界:在 $[ - \pi , \pi ]$ 上,| sin $\alpha - \alpha | \leq \alpha^{2} / 2$ 且 $1 - \cos \alpha \ge 2 \alpha^{2} / \pi^{2}$ 。因此
$$ d (t, \alpha) \geq (t - 1)^{2} + \frac{4 t \alpha^{2}}{\pi^{2}}.\tag{101} $$项 $t \alpha^{2}$ 被 $( \pi^{2} / 4 ) d ( t , \alpha )$ 所界。对于混合项,设 $x = | 1 - t |$ 和 $y = 2 \sqrt{t} | \alpha | / \pi$,则 $d ( t , \alpha ) \geq x^{2} + y^{2}$ 且
$$ 2 t | \alpha | | 1 - t | = \pi \sqrt{t} x y \leq \frac{\pi \sqrt{t}}{2} (x^{2} + y^{2}) \leq \frac{\pi \sqrt{2}}{2} d (t, \alpha).\tag{102} $$综合这些界得到
$$ | 2 t \sin \alpha - 2 t^{2} \alpha | \leq \left(\frac{\pi^{2}}{4} + \frac{\pi \sqrt{2}}{2}\right) d (t, \alpha) \leq 4 \pi^{2} d (t, \alpha).\tag{103} $$定义未裁剪的PWO替代函数
$$ S_{\mathrm{mod}} (\pmb{\theta}^{\prime}; \pmb{\theta}) := \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} \left[ r_{\pmb{\theta}^{\prime}; \pmb{\theta}} (\mathbf{s}) A_{\pmb{\theta}}^{\mathrm{R}} (\mathbf{s}) \right],\tag{104} $$$$ S_{\mathrm{arg}} (\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}) := \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ r_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) \phi_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) A_{\boldsymbol{\theta}}^{\mathrm{I}} (\mathbf{s}) \right].\tag{105} $$定理B.4(PWO模-相位替代上界)。假设 $A_{\theta}^{\mathrm{R}}$ 和 $A_{\theta}^{\mathrm{I}}$ 有界。则
$$ E [ \psi_{\boldsymbol{\theta}^{\prime}} ] - E [ \psi_{\boldsymbol{\theta}} ] \leq S_{\mathrm{mod}} (\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}) + S_{\mathrm{arg}} (\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}) + 2 C_{\boldsymbol{\theta}} \left(1 - \sqrt{1 - \mathcal{I} (\psi_{\boldsymbol{\theta}} , \psi_{\boldsymbol{\theta}^{\prime}})}\right),\tag{106} $$其中可取
$$ C_{\boldsymbol{\theta}} = \left\| \hat{H} - E [ \psi_{\boldsymbol{\theta}} ] \mathbb{1} \right\| _{\infty} + \left\| A_{\boldsymbol{\theta}}^{\mathrm{R}} \right\| _{\infty} + 4 \pi^{2} \left\| A_{\boldsymbol{\theta}}^{\mathrm{I}} \right\| _{\infty}.\tag{107} $$特别地,
$$ E [ \psi_{\boldsymbol{\theta}^{\prime}} ] - E [ \psi_{\boldsymbol{\theta}} ] \leq S_{\mathrm{mod}} (\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}) + S_{\mathrm{arg}} (\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}) + 2 C_{\boldsymbol{\theta}} \mathcal{I} (\psi_{\boldsymbol{\theta}}, \psi_{\boldsymbol{\theta}^{\prime}}).\tag{108} $$证明:为便于阅读,记 $r = r_{\pmb{\theta}^{\prime} ; \pmb{\theta}} , \alpha = \alpha_{\pmb{\theta}^{\prime} ; \pmb{\theta}} , \phi = 2 \alpha$ 和 $z = {\sqrt{r}} e^{i \alpha}$。由于
$$ \left| z - 1 \right| ^{2} = 1 + r - 2 \sqrt{r} \cos \alpha , $$且 $\begin{array} {r} {\mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} [ A_{\pmb{\theta}}^{\mathrm{R}} ] = 0} \end{array}$,我们有
$$ 2 \mathbb{E}_{\mathcal{P}_{\theta}} [ \sqrt{r} \cos \alpha A_{\theta}^{\mathrm{R}} ] = \mathbb{E}_{\mathcal{P}_{\theta}} [ r A_{\theta}^{\mathrm{R}} ] - \mathbb{E}_{\mathcal{P}_{\theta}} [ | z - 1 | ^{2} A_{\theta}^{\mathrm{R}} ]\tag{109} $$$$ \leq S_{\mathrm{mod}} + \left\| A_{\pmb{\theta}}^{\mathrm{R}} \right\| _{\infty} \mathbb{E}_{\mathcal{P}_{\pmb{\theta}}} [ | z - 1 | ^{2} ].\tag{110} $$对于相位项,应用引理B.3,取 $t = {\sqrt{r}}$:
$$ 2 \mathbb{E}_{\mathcal{P}_{\boldsymbol{\theta}}} [ \sqrt{r} \sin \alpha A_{\boldsymbol{\theta}}^{\mathrm{I}} ] = \mathbb{E}_{\mathcal{P}_{\boldsymbol{\theta}}} [ r \phi A_{\boldsymbol{\theta}}^{\mathrm{I}} ] + \mathbb{E}_{\mathcal{P}_{\boldsymbol{\theta}}} [ (2 \sqrt{r} \sin \alpha - 2 r \alpha) A_{\boldsymbol{\theta}}^{\mathrm{I}} ]\tag{111} $$$$ \leq S_{\mathrm{arg}} + 4 \pi^{2} \big \| A_{\pmb{\theta}}^{\mathrm{I}} \big \| _{\infty} \mathbb{E}_{\mathcal{P}_{\pmb{\theta}}} [ | z - 1 | ^{2} ].\tag{112} $$最后,
$$ \mathbb{E}_{\mathcal{P}_{\boldsymbol{\theta}}} [ | z - 1 | ^{2} ] = \left\| \psi_{\boldsymbol{\theta}^{\prime}} - \psi_{\boldsymbol{\theta}} \right\| ^{2}\tag{113} $$$$ = 2 \left(1 - \sqrt{1 - \mathcal{I} (\psi_{\boldsymbol{\theta}} , \psi_{\boldsymbol{\theta}^{\prime}})}\right),\tag{114} $$其中我们使用了全局相位惯例式(72)。结合式(78)、(110)和(112)证明了式(106)。线性保真度形式由 $1 - {\sqrt{1 - x}} \leq x$ 推出。□
定理B.5(PWO替代的一阶一致性)。假设 $\psi$ 在参考参数邻域内可微。对于相位替代,将重要性比率从梯度计算中分离:
$$ S_{\mathrm{arg}} (\pmb{\theta}^{\prime}; \pmb{\theta}) = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}}} \left[ \mathrm{sg} \left(r_{\pmb{\theta}^{\prime}; \pmb{\theta}} (\mathbf{s})\right) \phi_{\pmb{\theta}^{\prime}; \pmb{\theta}} (\mathbf{s}) A_{\pmb{\theta}}^{\mathrm{I}} (\mathbf{s}) \right]. $$则
$$ \nabla_{\pmb{\theta}^{\prime}} \left[ S_{\mathrm{mod}} (\pmb{\theta}^{\prime}; \pmb{\theta}) + S_{\mathrm{arg}} (\pmb{\theta}^{\prime}; \pmb{\theta}) \right] \big | _{\pmb{\theta}^{\prime} = \pmb{\theta}} = \nabla_{\pmb{\theta}} E [ \psi_{\pmb{\theta}} ].\tag{115} $$在参考点处,从裁剪目标函数也能得到相同的导数,因为 $r = 1$ 和 $\phi = 0$ 位于裁剪区间内部。
证明:在 ${\pmb \theta}^{\prime} = {\pmb \theta}_{\ast}$ 处
$$ \left. \nabla_{\boldsymbol{\theta}^{\prime}} r_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) \right| _{\boldsymbol{\theta}^{\prime} = \boldsymbol{\theta}} = \nabla_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) = 2 \nabla_{\boldsymbol{\theta}} \log | \psi_{\boldsymbol{\theta}} (\mathbf{s}) |,\tag{116} $$$$ \left. \nabla_{\boldsymbol{\theta}^{\prime}} \phi_{\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}} (\mathbf{s}) \right| _{\boldsymbol{\theta}^{\prime} = \boldsymbol{\theta}} = 2 \nabla_{\boldsymbol{\theta}} \arg \psi_{\boldsymbol{\theta}} (\mathbf{s}).\tag{117} $$因此 $S_{\mathrm{mod}}$ 的梯度恢复了式(62)中的 $2 A_{\pmb{\theta}}^{\mathrm{R}} \pmb{\nabla}$ log $| \psi_{\pmb{\theta}} |$ 项,而分离后的相位替代恢复了 $2 A_{\theta}^{\mathrm{I}} \nabla$ arg ψθ 项。因此两个替代梯度的和等于VMC梯度。□
定理4.1(PWO的一阶一致性)。设 $| \psi_{\pmb{\theta}} \rangle$ 在 $\pmb{\theta}_{\mathrm{old}}$ 处可微,且假设公共支撑集。对于 $\epsilon , \delta > 0$
$$ \nabla_{\boldsymbol{\theta}} \left(L_{\mathrm{mod}}^{\mathrm{clip}} (\boldsymbol{\theta}) + L_{\mathrm{arg}}^{\mathrm{clip}} (\boldsymbol{\theta})\right) \bigg | _{\boldsymbol{\theta} = \boldsymbol{\theta}_{\mathrm{old}}} = \left. \nabla_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] \right| _{\boldsymbol{\theta} = \boldsymbol{\theta}_{\mathrm{old}}}.\tag{19} $$证明见附录B.6。
证明:由于在 $r = 1$ 和 $\phi = 0$ 处裁剪到一阶无效,裁剪目标函数在参考点具有相同的导数,定理B.5的证明仍然适用。□## B.7 裁剪PWO改进保证
最终,我们将PWO替代界与幅度-相位保真度控制相结合。这给出了对应于裁剪PWO目标的确定性总体级保证。
定义裁剪损失:
$$ L_{\mathrm{mod}}^{\mathrm{clip}} (\pmb{\theta}^{\prime}; \pmb{\theta}) := \mathbb{E}_{\mathcal{P}_{\pmb{\theta}}} \left[ \max \left(r A_{\pmb{\theta}}^{\mathrm{R}}, \mathrm{clip} (r, 1 - \epsilon , 1 + \epsilon) A_{\pmb{\theta}}^{\mathrm{R}}\right) \right],\tag{118} $$$$ L_{\mathrm{arg}}^{\mathrm{clip}} (\boldsymbol{\theta}^{\prime}; \boldsymbol{\theta}) := \mathbb{E}_{\mathcal{P}_{\boldsymbol{\theta}}} \left[ \operatorname{sg} (r) \max \left(\phi A_{\boldsymbol{\theta}}^{\mathrm{I}}, \mathrm{clip} (\phi , - \delta , \delta) A_{\boldsymbol{\theta}}^{\mathrm{I}}\right) \right],\tag{119} $$其中,如上所述,$r = r_{\theta^{\prime} ; \theta}$ 且 $\phi = \phi_{\pmb{\theta}^{\prime} ; \pmb{\theta}} = 2 \alpha$。
推论4.3(裁剪PWO改进保证)。假设定理4.2的条件成立,包括有界中心局域能量,以及全局约束 $r_{\pmb{\theta}} ( \mathbf{s} ) \in [ 1 - \epsilon , 1 + \epsilon ]$ 和 $| \alpha_{\pmb \theta} ( \mathbf{s} ) | \leq \delta$ 对所有s成立,其中 $0 \leq \epsilon \leq 1$ 且 $0 \le \delta \le \pi$。那么存在 $C_{\theta_{\mathrm{old}}} < \infty$,使得:
$$ E [ \psi_{\boldsymbol{\theta}} ] - E [ \psi_{\boldsymbol{\theta}_{\mathrm{old}}} ] \leq L_{\mathrm{mod}}^{\mathrm{clip}} (\boldsymbol{\theta}) + L_{\mathrm{arg}}^{\mathrm{clip}} (\boldsymbol{\theta}) + 2 C_{\boldsymbol{\theta}_{\mathrm{old}}} \left(1 - \frac{1 + \sqrt{1 - \epsilon^{2}}}{2} \cos^{2} \left(\frac{\delta}{2}\right)\right). $$(22)
证明见附录B.7。
推论4.3的证明。首先,根据线性保真度界(108)和逐点不等式:
$$ L_{\mathrm{mod}}^{\mathrm{clip}} (\pmb{\theta}) \geq S_{\mathrm{mod}} (\pmb{\theta}; \pmb{\theta}_{\mathrm{old}}), \qquad L_{\mathrm{arg}}^{\mathrm{clip}} (\pmb{\theta}) \geq S_{\mathrm{arg}} (\pmb{\theta}; \pmb{\theta}_{\mathrm{old}}),\tag{120} $$可得到裁剪能量界。这些不等式成立是因为每个裁剪目标取未裁剪项与其裁剪对应项的最大值,且sg(r)的前向值与r相同。因此:
$$ E [ \psi_{\boldsymbol{\theta}} ] - E [ \psi_{\boldsymbol{\theta}_{\mathrm{old}}} ] \leq L_{\mathrm{mod}}^{\mathrm{clip}} (\boldsymbol{\theta}) + L_{\mathrm{arg}}^{\mathrm{clip}} (\boldsymbol{\theta}) + 2 C_{\boldsymbol{\theta}_{\mathrm{old}}} \mathcal{I} (\psi_{\boldsymbol{\theta}_{\mathrm{old}}}, \psi_{\boldsymbol{\theta}}).\tag{121} $$根据引理B.2,假设 $r_{\pm} \in [ 1 - \epsilon , 1 + \epsilon ]$ 和 $| \phi_{\pmb{\theta}} | \leq \delta$ 意味着:
$$ \mathcal{I} \left(\psi_{\boldsymbol{\theta}_{\text{old}}}, \psi_{\boldsymbol{\theta}}\right) \leq 1 - \frac{1 + \sqrt{1 - \epsilon^{2}}}{2} \cos^{2} \left(\frac{\delta}{2}\right),\tag{122} $$因为折叠相位本身是 $\phi_{\pmb{\theta}} / 2$。将此估计代入前式即得方程(22)。□
PWO仅鼓励但并不能保证该保证所需的全局信任域条件。首先,初始步骤总是从非裁剪目标出发,因为在 $(\pmb{\theta} = \pmb{\theta}_{\mathrm{old}})$ 时裁剪未激活。其次,即使裁剪在某个采样配置上激活,由其他未裁剪配置驱动的更新仍可能改变其幅度或相位,因为所有配置共享参数。因此,裁剪控制了采样批次上的经验替代函数,但并未在全局施加逐点界。因此,该保证应被解读为对满足整个支撑集上幅度和相位信任域的实际更新的条件性保证。## C 附加章节## C.1 随机重构的数值成本与改进
使用原始SR公式进行优化时会出现显著瓶颈。朴素实现涉及对 $P \times P$ 矩阵求逆,其中 $P$ 表示参数数量。Chen与Heyl [2024]证明可将该求逆问题转化为对大小为 $M \times M$ 的矩阵求逆,其中 $M$ 是蒙特卡洛估计中每次迭代使用的样本数——该方法名为minSR,其思想源自机器学习优化文献[Ren and Goldfarb, 2019]。minSR的计算复杂度为 $O(M^{2} P) + O(M^{3})$,而非 $O(P^{3})$,内存占用仅 $O(M P)$,而非 $O(P^{2})$。该方法已成功训练具有约 $3 \times 10^{5}$ 参数的Vision Transformer,为 $1 \bar{0} \times \bar{10} \ J_1\text{-}J_2$ 海森堡体系的Majumdar–Ghosh点这一困难基准提供了迄今最低能量[Rende et al., 2024]。
尽管minSR带来了改进,但部分NQS优化实现(尤其针对电子结构问题)仍采用KFAC [Martens and Grosse, 2015]而非SR。对于需要大量样本训练网络的问题,$O(M^{3})$ 的计算成本仍可能过高;KFAC提供了实用折衷方案:通过块对角近似避免显式矩阵求逆,在牺牲希尔伯特空间几何信息潜在代价下实现可扩展性。KFAC广泛应用于费米子系统[Choo et al., 2020],NQS在此类系统中取得显著成果,涵盖FermiNet [Pfau et al., 2020]、SchNet [Schütt et al., 2018]、PauliNet [Hermann et al., 2020]及近期基于Transformer的方法[von Glehn et al., 2023]。
近期研究致力于改进上述两种方法:包括结合minSR与KFAC以避免显式求逆的SPRING [Goldshlager et al., 2024]、利用量子几何张量块对角结构优化条件数与扩展性的方法[Nys et al., 2024, Shokry et al., 2025],以及通过提取多本征态信息加速收敛的变分Lanczos技术[Wang et al., 2026]。关于NQS二阶优化改进的详细分析,读者可参阅Drissi et al. [2024]。## C.2 PWO每次迭代的相对速度
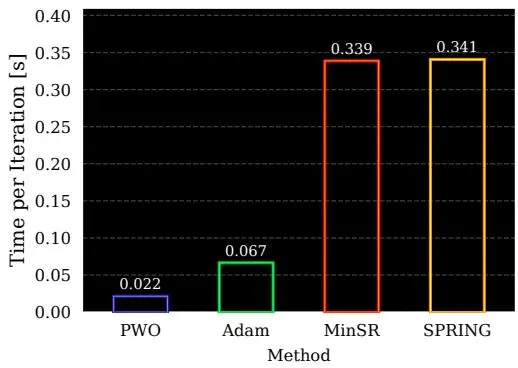 (a) 每次优化器迭代的墙上时间。
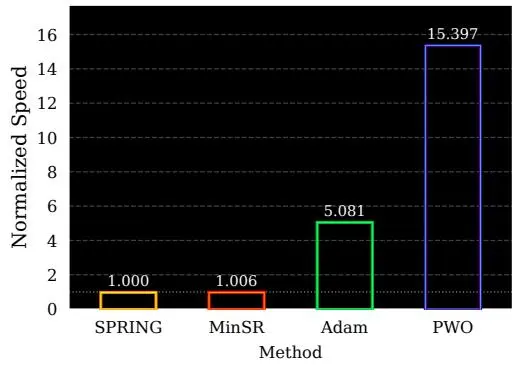 (b) 相对于SPRING的归一化迭代速度。
图7:在默认架构D.2的Heisenberg $J_{1} {-} J_{2}$ 链上,PWO与基线优化器的每次迭代计算成本及归一化迭代速度。两项测量均在单个NVIDIA L40S GPU上完成。归一化速度报告为单位时间内相对于SPRING的优化器迭代次数,因此数值越高表示速度越快。
除了墙上时间的收敛性之外,单独分析每次优化更新的计算成本也很有价值。图7b比较了PWO与基线优化器的归一化迭代速度(单位时间内的优化步数)。相对于minSR的速度优势是预期的:PWO是一阶方法,无需构建或求逆随机重构矩阵。相比之下,minSR将原始$P \times P$规模的重构矩阵求解替换为$\mathbf{\bar{\boldsymbol{M}}} \times \mathbf{\boldsymbol{M}}$规模(其中$\breve{M}$为样本数)的求解,但仍需要昂贵的雅可比收缩运算以及矩阵求逆或线性求解。PWO完全避免了这种曲率计算。
与Adam的比较则更为微妙。单次PWO更新相比Adam涉及额外的簿记工作,包括概率比率、裁剪项和包裹相位增量。然而在变分蒙特卡洛中,主要计算成本往往并非优化器本身的代数运算,而是采样构型及评估对应的局域能量。PWO对采样批次仅计算一次局域能量和优势,然后在该批次上重复利用进行多次邻近内循环迭代。相比之下,Adam每次采样批次仅执行单次更新,因此每次参数更新都需要重新承担局域能量的计算开销。因此,PWO能够将昂贵的能量计算分摊到多个优化步骤中,尽管其替代目标函数的结构更为复杂,但每次更新的有效成本仍能与Adam相媲美。## C.3 为何选择RWKV?
RWKV是一种特别适合大规模自回归神经量子态(NQS)的自然架构,因为它兼具序列模型的表达能力和循环推理的特性。与基于Transformer的自回归模型不同,RWKV无需不断增长的键值缓存,因此其每个标记的推理成本和内存占用在序列长度上保持恒定[Peng等,2025]。这与自回归变分蒙特卡洛(VMC)高度契合——在VMC中,自旋构型被顺序生成,且模型评估在蒙特卡洛优化过程中被反复调用。循环架构在更广泛的自回归NQS中也被证明是成功的,它能够从玻恩分布中精确独立采样,同时避免马尔可夫链混合问题[Hibat-Allah等,2020,Merali等,2026]。此外,近期关于超大规模RWKV微调的研究为将十亿参数级别的循环模型适配到非标准优化目标提供了实践基础[Sarkar等,2026]。基于这些原因,RWKV成为检验投影波函数优化(PWO)能否超越传统NQS架构的关键压力测试工具。## C.4 PWO的局限性
尽管PWO受到一阶一致性结果和修剪改进上界的支持,但该理论仍具有局部性和保守性:它依赖于共同支撑和有界性假设,并且不适用于神经网络训练的全局收敛分析。在实证方面,我们的结果包括一维链、受挫的二维方晶格以及大规模RWKV微调实验,但这些仍不能构成跨哈密顿量族的综合性NQS基准测试。特别地,在更大规模的二维系统、费米子模型以及电子结构问题上的广泛验证仍待解决。最后,PWO引入了额外的优化超参数,例如振幅和相位修剪阈值以及内层迭代次数,其最优值可能取决于哈密顿量、拟设、系统尺寸和样本预算。## D 实验细节## D.1 超参数搜索
针对每种方法,我们通过网格扫描对学习率进行小型超参数搜索,并选取验证性能最佳的配置。对于PWO,我们还额外调整用于控制振幅和相位替代目标的裁剪参数。具体而言,在选定初始学习率后,我们独立地逐次对每个裁剪参数进行网格搜索,同时固定先前找到的最优值。这种顺序方法提供了一种简单且计算可行的手段来调整PWO特有的额外超参数,无需对所有组合进行穷举联合扫描。
对于包括PWO在内的基于Adam的方法,我们采用余弦单周期学习率调度方案[Smith and Topin, 2018]。学习率首先在短预热阶段升至峰值,随后通过余弦衰减平滑退火至较小的终值。峰值学习率通过上述网格搜索选定,其他调度参数在不同运行中保持固定。对于每次采样批次执行多次优化轮次的PWO,我们按PPO轮次数缩放转换视界,使调度方案在可比较的外迭代时间尺度上演进。对于minSR和SPRING,恒定学习率的性能优于周期性调度方案。
由于海森堡链和J1–J2链的优化问题比横向场伊辛模型更具挑战性,我们在这些设置中采用更长的学习率调度方案(对比附录D.3-D.5)。具体而言,我们为海森堡链分配的转换步数多于伊辛模型,而为J1–J2链分配的转换步数多于海森堡链。这使优化器在面对更复杂的哈密顿量时拥有更长的退火视界,同时在不同问题间保持调度结构固定。为提升可读性,我们分别报告每种哈密顿量的方法特定超参数。首先展示伊辛配置,随后在后续各小节中呈现海森堡和J1–J2设置。## D.2 神经量子态架构
在所有实验中,我们对PWO和minSR采用相同的自回归循环神经网络,确保性能差异来自优化器而非参数化。给定自旋构型 $\mathbf{s} \in \{\pm 1 \}^{N}$ ,我们将自旋映射为二进制标记,在序列开头添加起始标记,并使用维度为32的学习型标记嵌入和学习型位置嵌入对所得序列进行嵌入。嵌入后的输入被投影至维度256,随后经过tanh非线性变换和层归一化。主干网络包含带有残差连接的GRU循环模块。基于共享的循环表示,我们使用两个独立的两层MLP头部和GELU激活函数:幅度头部通过log-softmax输出条件对数概率,相位头部通过经π缩放的tanh非线性变换输出有界相位。该模型包含140万参数。除非另有说明,所有方法和哈密顿量均采用相同架构。共享超参数汇总于表2。
| 架构超参数 | 值 |
| 标记嵌入维度 | 32 |
| 位点嵌入 | 学习型 |
| 主干网络输入维度 | 256 |
| 主干网络非线性变换 | tanh |
| 主干网络归一化 | 层归一化 |
| 循环主干网络 | GRU |
| GRU层数 | 3 |
| GRU隐藏维度 | 256 |
| 幅度头部 | 2层MLP |
| 相位头部 | 2层MLP |
| 头部隐藏维度 | 256 |
| 头部激活函数 | GELU |
| 相位输出 | $\pi \tanh(\cdot)$ |
| 相位缩放 | $\pi$ |
表2:所有哈密顿量和优化方法共享的NQS架构。Adam、PWO、minSR和SPRING均使用相同的基于GRU的自回归参数化。## D.3 伊辛模型
| 超参数 | Adam | PWO | minSR | SPRING |
| 优化器/方法 | Adam | Adam + PWO | minSR | SPRING |
| 学习率 | $10^{-5}$ | $10^{-5}$ | $10^{-2}$ | $10^{-2}$ |
| 峰值学习率 | $10^{-4}$ | $10^{-4}$ | - | - |
| 过渡步数 | 5,000 | 20,000 | - | - |
| PPO 轮次 | - | 4 | - | - |
| PPO 裁剪 $\epsilon$ | - | $10^{-3}$ | - | - |
| 优势归一化 | - | 是 | - | - |
| 相位损失 | - | $\Delta\phi$ 裁剪 | - | - |
| 相位系数 | - | 1.0 | - | - |
| 相位裁剪 | - | 0.3 | - | - |
| 中心化虚部优势 | - | 是 | - | - |
| 归一化虚部优势 | - | 是 | - | - |
| 相位雅可比基线 | - | 是 | - | - |
| SR 对角偏移 | - | - | $10^{-2}$ | $10^{-2}$ |
| NTK / minSR 模式 | - | - | 是 | 是 |
| 即时 SR | - | - | 是 | 是 |
| SPRING 动量 | - | - | - | 0.8 |
表3:伊辛实验使用的超参数。所有方法均采用 $N = 12$、周期性边界条件、$J = 1 , h = 1$、复数值神经量子态、1024个训练样本、精确对角化进行评估,以及每200次迭代评估一次。Adam和PWO使用余弦单周期调度。## D.4 海森堡链
| 超参数 | Adam | PWO | minSR | SPRING |
| 优化器/方法 | Adam | Adam + PWO | minSR | SPRING |
| 学习率参数/恒定学习率 | $10^{-5}$ | $10^{-5}$ | $10^{-3}$ | $10^{-3}$ |
| 峰值学习率 | $3 \times 10^{-4}$ | $10^{-4}$ | - | - |
| 过渡步数 | 10,000 | 40,000 | - | - |
| PPO 轮数 | - | 4 | - | - |
| PPO 裁剪参数 $\epsilon$ | - | $10^{-3}$ | - | - |
| 优势函数归一化 | - | 是 | - | - |
| 相位损失 | - | $\Delta\phi$ 裁剪 | - | - |
| 相位系数 | - | 1.0 | - | - |
| 相位裁剪阈值 | - | 0.3 | - | - |
| 中心化虚部优势 | - | 是 | - | - |
| 归一化虚部优势 | - | 是 | - | - |
| 相位雅可比基线 | - | 是 | - | - |
| SR 对角偏移 | - | - | $10^{-2}$ | $10^{-2}$ |
| NTK / minSR 模式 | - | - | 是 | 是 |
| 即时 SR | - | - | 是 | 是 |
| SPRING 动量 | - | - | - | 0.8 |
表4:海森堡链实验的超参数。所有方法均采用 $N = 12$ 、周期边界条件、耦合强度 $J = 0.25$ 、无符号规则、复值神经量子态、1024个训练样本、精确评估,以及每200次迭代进行评估。Adam和PWO使用余弦单周期学习率调度;minSR和SPRING使用恒定学习率。## D.5 海森堡 $J_{1} {-} J_{2}$ 链
| 超参数 | Adam | PWO | minSR | SPRING |
| 优化器/方法 | Adam | Adam + PWO | minSR | SPRING |
| 学习率参数/恒定学习率 | $10^{-5}$ | $10^{-5}$ | $10^{-3}$ | $10^{-3}$ |
| 峰值学习率 | $3 \times 10^{-4}$ | $10^{-4}$ | - | - |
| 转换步数 | 10,000 | 40,000 | - | - |
| PPO 轮次 | - | 4 | - | - |
| PPO 截断 $\epsilon$ | - | $10^{-3}$ | - | - |
| 优势函数归一化 | - | 是 | - | - |
| 相位损失 | - | $\Delta\phi$ 截断 | - | - |
| 相位系数 | - | 1.0 | - | - |
| 相位截断 | - | 0.3 | - | - |
| 中心化虚部优势 | - | 是 | - | - |
| 归一化虚部优势 | - | 是 | - | - |
| 相位雅可比基线 | - | 是 | - | - |
| SR 对角偏移 | - | - | $10^{-2}$ | $10^{-2}$ |
| NTK / minSR 模式 | - | - | 是 | 是 |
| 即时 SR | - | - | 是 | 是 |
| SPRING 动量 | - | - | - | 0.8 |
表5:受挫海森堡 $J_{1} {-} J_{2}$ 实验的超参数设置。所有方法均采用 $N = 12$ 周期边界条件,耦合强度 $J_{1} = 1$ 和 $J_{2} = 0.5$,无符号规则,复值神经量子态,1024个训练样本,精确评估,每200次迭代评估一次。Adam和PWO使用余弦单周期学习率调度;minSR和SPRING使用恒定学习率。## D.6 二维 $J_{1} {-} J_{2}$ 正方晶格实验
采用与上文相同的方法超参数,我们在二维正方晶格的阻挫自旋-1/2 $J_{1} {-} \bar{J_{2}}$ 海森堡模型上评估PWO性能:
$$ \hat{H}_{J_{1} - J_{2}}^{\mathrm{2D}} = J_{1} \sum_{\langle i, j \rangle} \hat{\mathbf{S}}_{i} \cdot \hat{\mathbf{S}}_{j} + J_{2} \sum_{\langle \langle i, j \rangle \rangle} \hat{\mathbf{S}}_{i} \cdot \hat{\mathbf{S}}_{j},\tag{123} $$其中 $\langle i , j \rangle$ 和 $\langle \langle i , j \rangle \rangle$ 分别表示最近邻和次近邻对。我们使用 $L \times L$ 正方晶格,其中 $L = 10$ ,采用周期性边界条件,$J_{1} = 1$ 且 ${\bar{J}}_{2} = 0 . {\bar{5}}$ 。所有运行均限于零磁化子空间 $S_{\mathrm{tot}}^{z} = 0$ ,通过在采样和评估过程中屏蔽不可行的自回归选择实现。
本实验使用针对二维晶格设计的复值块自回归Transformer。该模型并非逐个生成自旋,而是将 $10 \times 10$ 晶格划分为不重叠的 $2 \times 2$ 块。每个块表示为词表大小为 $2^{4} = 16$ 的分类标记,因此完整配置生成为
$$ T = \left(\frac{L}{2}\right)^{2} = 25\tag{124} $$个自回归标记的序列。波函数按块标记分解为
$$ \log \psi_{\theta} (\mathbf{s}) = \sum_{t = 1}^{T} \left[ \frac{1}{2} \log p_{\theta} (a_{t} \mid a_{< t}) + i \phi_{\theta} (a_{t} \mid a_{< t}) \right],\tag{125} $$其中因子 $1 / 2$ 对应Born规则约定 $P_{\theta} ( \mathbf{s} ) = | \psi_{\theta} ( \mathbf{s} ) | ^{2}$ 。
模型预置一个序列起始标记,并通过维度64的可学习标记嵌入对块标记进行嵌入。我们还使用可学习位置嵌入和编码部分磁化约束的前缀计数特征。这些嵌入投影至宽度96,通过层归一化归一化后,传入8层因果Transformer主干。每个Transformer块使用6个注意力头、基数为100的二维轴向RoPE、残差连接和 $4 \times 96 = 384$ 的前馈宽度。
从最终Transformer表示中,模型使用独立的振幅头和相位头。两个头均为隐藏维度192并使用GELU激活的双层MLP。振幅头通过log-softmax输出掩蔽条件对数概率,确保对可行块选择进行精确归一化。相位头使用 $\pi \tanh(\cdot)$ 参数化输出中心化相位增量,初始化尺度为 $\mathrm{\dot{1} 0^{- 3}}$ 。这产生了精确可采样的复自回归神经量子态,适配二维正方晶格。
尽管本实验旨在比较优化器而非追求最先进变分能量(约-199.0536 [Rende et al., 2024]),我们注意到PWO训练的150万参数自回归Transformer在30分钟后能量为-185,24小时后达到-195.6并持续下降。运行在单GPU上,除零磁化采样外未施加任何对称性。
| 超参数 | 数值 |
| 晶格尺寸 | $10 \times 10$ |
| 自旋数量 | 100 |
| 边界条件 | 周期 |
| 哈密顿量耦合 | $J_1 = 1, J_2 = 0.5$ |
| 磁化子空间 | $S_{\text{tot}}^z = 0$ |
| 块大小 | $2 \times 2$ |
| 块词表大小 | 16 |
| 自回归标记 | 25 |
| 标记嵌入维度 | 64 |
| Transformer宽度 | 96 |
| Transformer深度 | 8 |
| 注意力头数 | 6 |
| Transformer MLP隐藏维度 | 384 |
| RoPE类型 | 二维轴向RoPE |
| RoPE基数 | 100 |
| 振幅头 | 双层MLP |
| 相位头 | 双层MLP |
| 头部隐藏维度 | 192 |
| 相位参数化 | $\pi \tanh(\cdot)$ |
| 相位初始化标准差 | $10^{-3}$ |
| 前缀计数特征 | 是 |
| 可学习位置嵌入 | 是 |
表6:用于二维阻挫 $J_{1} {-} J_{2}$ 正方晶格实验的架构。该模型是 $2 \times 2$ 自旋块上的复块自回归Transformer,采用二维轴向RoPE并通过自回归掩蔽强制执行精确零磁化约束。## D.7 规模缩放实验
为研究性能如何随模型容量缩放,我们在阻挫海森堡 $J_{1} {-} J_{2}$ 链 $( N = 12 , J_{1} = 1 , J_{2} \overset{-} {=} 0 . \overset{-} {5}$ ,周期性边界条件) 上,使用 PWO、Adam 和 minSR 训练了三种模型规模。所有三种规模共享附录 D.2 中描述的自回归 GRU 架构;它们仅在循环层数和隐藏维度上有所不同。表 7 总结了这些规模及其对应的总参数量。
| 规模 | GRU 层数 | RNN 隐藏层 | 输出头隐藏层 | 参数量 |
| 微小型 | 1 | 64 | 64 | 44,452 |
| 小型 | 2 | 128 | 128 | 269,156 |
| 中型 | 3 | 256 | 256 | 1,456,356 |
表 7:规模缩放实验中使用的模型规模。所有模型均使用嵌入维度 32,并在具有 $N = 12$ 个格点的阻挫海森堡 $J_{1} {-} J_{2}$ 链上进行评估。参数量包含整个自回归网络(嵌入层、循环主干、振幅输出头、相位输出头)的所有权重和偏置。
规模缩放实验中每种优化方法使用的超参数列于表 8。调度和裁剪参数与主要 $J_{1} {-} J_{2}$ 实验相同(见表 5 和表 2);仅转移步数有所不同,以适配模型规模的变化。
| 超参数 | Adam | PWO | minSR |
| 优化器 / 方法 | Adam | Adam + PWO | minSR |
| 学习率 | $10^{-5}$ | $10^{-5}$ | $10^{-3}$ |
| 峰值学习率 | $3 \times 10^{-4}$ | $10^{-4}$ | - |
| 转移步数 | 40,000 | 40,000 | - |
| PPO 轮次 | - | 4 | - |
| PPO 裁剪 $\epsilon$ | - | $10^{-3}$ | - |
| 优势函数归一化 | - | 是 | - |
| 相位损失 | - | $\Delta\phi$ 裁剪 | - |
| 相位系数 | - | 1.0 | - |
| 相位裁剪值 | - | 0.3 | - |
| 中心化虚部优势 | - | 是 | - |
| 归一化虚部优势 | - | 是 | - |
| 相位雅可比基线 | - | 是 | - |
| SR 对角偏移 | - | - | $10^{-2}$ |
| NTK / minSR 模式 | - | - | 是 |
| 即时 SR | - | - | 是 |
| 训练样本数 | 2,048 | ||
| 随机种子数 | 10 |
表 8:阻挫海森堡 $J_{1} {-} J_{2}$ 链 $( N = 12 , \bar{J}_{1}^{-} = \bar{1} , J_{2} = 0.5 .$ ,周期性边界条件) 规模缩放实验的超参数。所有方法和规模使用相同的优化超参数;仅在不同运行中改变模型架构(见表 7)。Adam 和 PWO 使用余弦单周期学习率调度;minSR 使用恒定学习率。## D.8 RWKV-7在伊辛模型上的应用
| 超参数 | Adam | PWO |
| 优化器/方法 | Adam | Adam + PWO |
| 模型 | RWKV-7 | RWKV-7 |
| 模型大小 | 1.5B | 1.5B |
| 学习率 | $10^{-5}$ | $10^{-5}$ |
| 转移步数 | 1,200 | 4,800 |
| 衰减率 | 0.5 | 0.5 |
| PPO训练轮数 | - | 4 |
| PPO裁剪系数 $\epsilon$ | - | $10^{-3}$ |
| 优势函数归一化 | - | 是 |
| 批量大小 | 150 | 150 |
| 算力配置 | 2 | 2 |
| 评估样本数 | 4,096 | 4,096 |
| 评估批量大小 | 128 | 128 |
| 精确对角化 | 是 | 是 |
表9:在横场伊辛模型上对RWKV-7进行微调实验的超参数。两种方法均使用具有1.5B参数的自回归RWKV-7模型,$N = 12$,周期边界条件,$J = 1 , h = 1$,采用精确对角化进行评估,样本均从自回归Born分布中精确抽取。Adam对应单周期的一阶基线方法,而PWO方法则在每个采样批次中执行四个近端内循环。## E 补充图表## E.1 所有哈密顿量的独立种子图
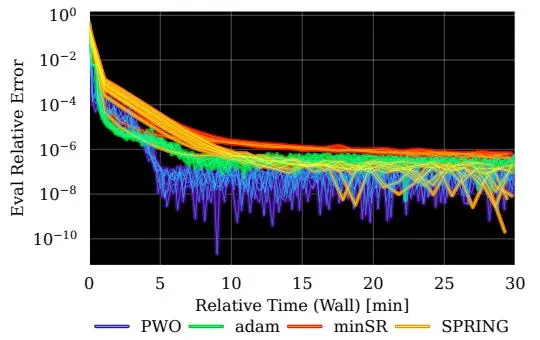
伊辛模型
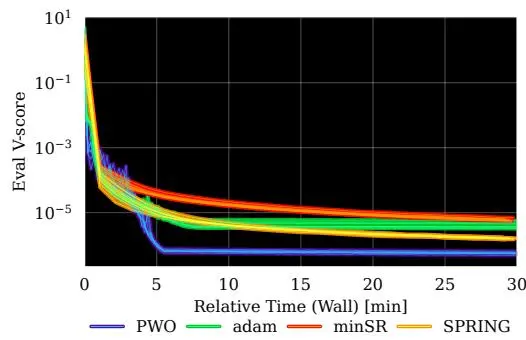
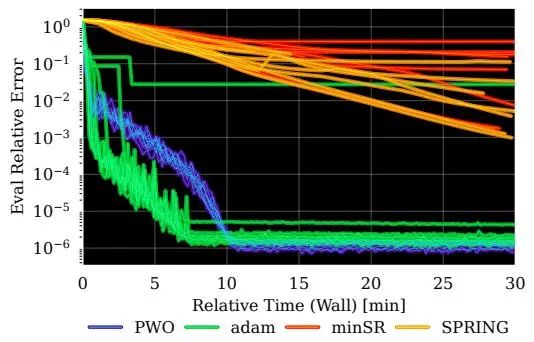
海森堡链
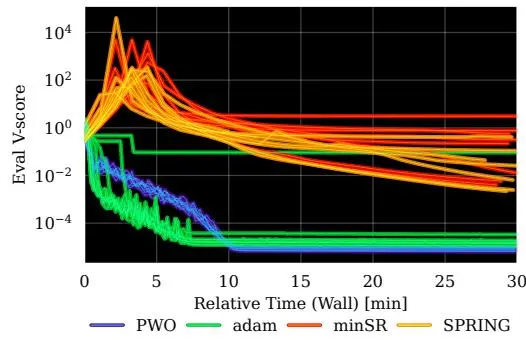
$J_{1} {-} J_{2}$ 海森堡模型
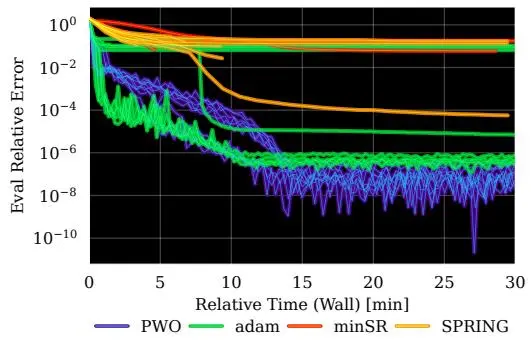
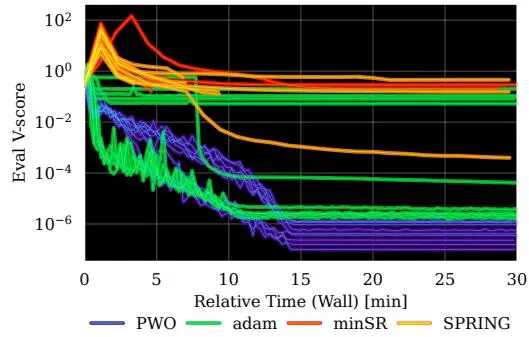
正方晶格 $J_{1} {-} J_{2}$ 海森堡模型
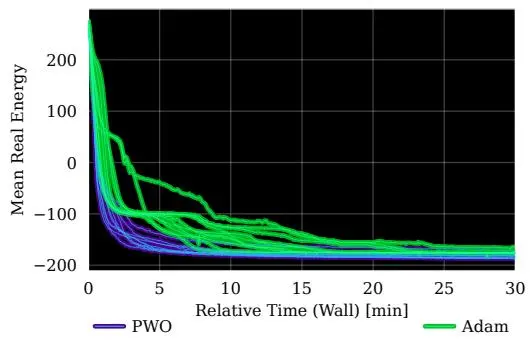
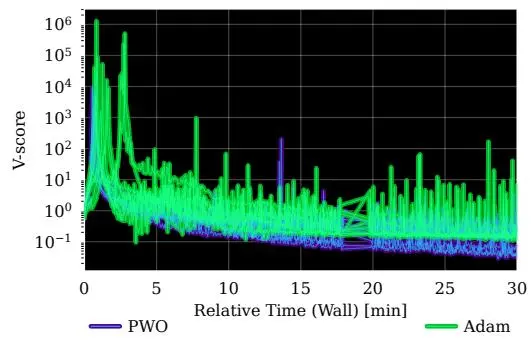
图8:所有哈密顿量的独立种子学习曲线。每一行对应一个哈密顿量,右列报告V分数。
## E.2 样本与系统规模的缩放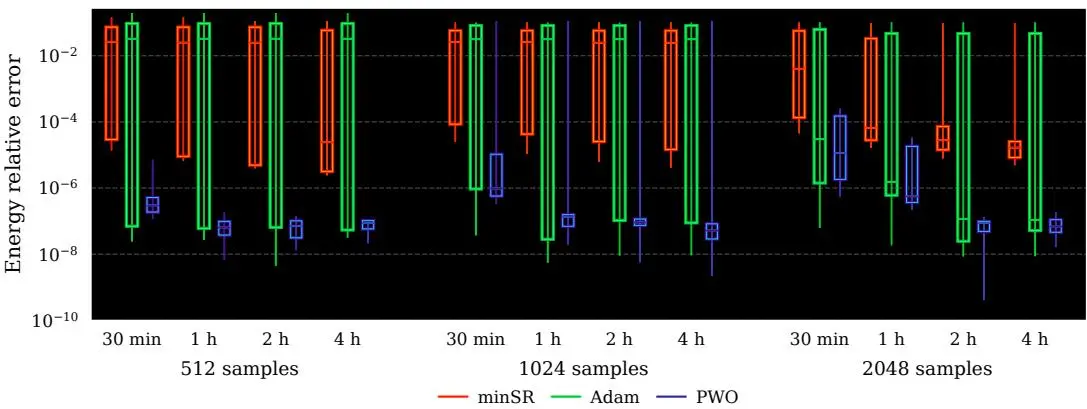
图9:不同样本数与优化方法下的实际时间缩放对比。箱线图展示了各随机种子间的四分位平均相对误差,箱体表示四分位距,线条表示最小值和最大值。结果按模型规模和实际运行时间分组,均在单个NVIDIA A100 GPU上运行。
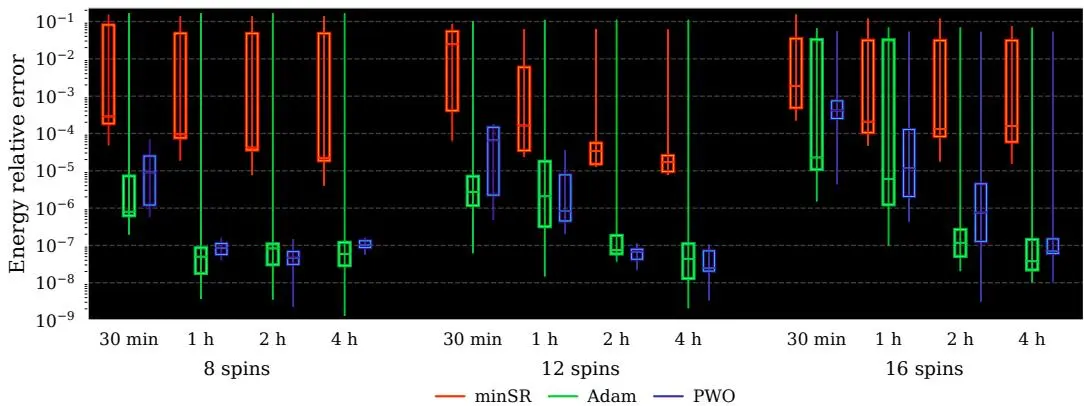
图10:不同系统规模与优化方法下的实际时间缩放对比。箱线图展示了各随机种子间的四分位平均相对误差,箱体表示四分位距,线条表示最小值和最大值。结果按模型规模和实际运行时间分组,均在单个NVIDIA A100 GPU上运行。
## E.3 RWKV7微调中的独立种子绘图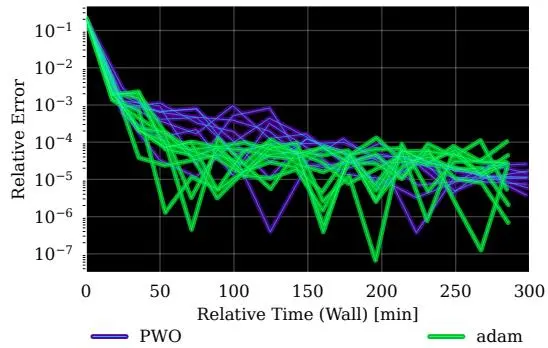
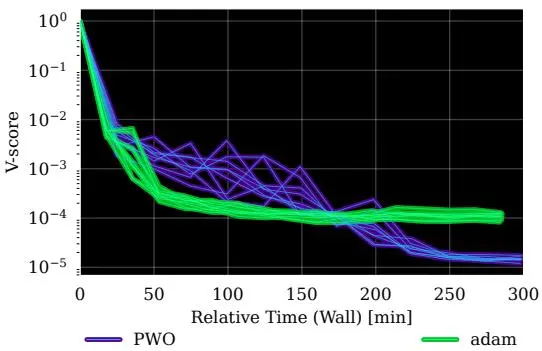
图11:1.5B参数RWKV-7神经量子态在横场伊辛模型上的独立种子微调曲线。每条曲线对应一个随机种子,左侧展示相对误差,右侧展示V分数。PWO在不同种子间始终保持稳定,且最终误差和方差均低于Adam基线,表明即使在十亿参数规模下,近端目标函数仍能提升鲁棒性。
阅读笔记#
一句话概括#
本文提出了近端波函数优化(PWO),一种受RL中PPO启发的信任域一阶优化器,用于训练自回归神经量子态(NQS)。核心方法:(1) 在stoquastic哈密顿量假设下证明VMC梯度等价于Born分布上的优势策略梯度(命题3.1);(2) 幅值通道裁剪概率比到$[1-10^{-3},1+10^{-3}]$,相位通道裁剪包裹相位增量到$[-\pi, \pi]$内的$0.3$;(3) 理论证明一阶一致性(定理4.1)和不保真度能量界(定理4.2)。实验结论:在1D横场伊辛模型上,PWO在$\sim5$分钟达到$\epsilon_{\text{rel}}=10^{-7}$,比minSR($\sim30$分钟)快约6倍;在$J_1{-}J_2$链上,minSR 10次运行中6次NaN崩溃,PWO无NaN且在$\sim15$分钟达$10^{-7}$;PWO能将1.5B参数RWKV-7作为NQS微调,规模超出此前工作三个数量级。
核心论证链#
动机:自回归NQS解决了采样问题,但优化成为新瓶颈。 MCMC采样NQS受自相关和慢混合困扰,自回归模型通过分解Born分布实现精确独立采样,消除了采样瓶颈。然而,Adam忽略了波函数空间的Fubini-Study几何导致不稳定收敛,SR/minSR虽考虑了几何但需求解$O(M^2P+M^3)$线性系统——在大网络和大样本下过高,因此需要一种既能处理几何信息又保持一阶优化可扩展性的算法。
形式化等价:stoquastic哈密顿量下VMC梯度退化为策略梯度。 VMC梯度包含$\mathbb{E}[E_\theta^{\text{loc}}\nabla_\theta\log\mathcal{P}_\theta] + \mathbb{E}[\nabla_\theta E_\theta^{\text{loc}}]$两项。第二项在stoquastic假设下(非对角元非正、基态实正)因$(\mathbf{s},\mathbf{s}')$对称性抵消为零(附录B.1证明),从而梯度纯化为$\mathbb{E}[(E_\theta^{\text{loc}}-\bar{E})\nabla_\theta\log\mathcal{P}_\theta]$——这正是REINFORCE策略梯度。因此,变分能量最小化可视为以Born分布为策略、中心化局域能量为优势函数的RL问题。
算法设计:PPO的双通道裁剪扩展到复波函数。 基于上述等价性,将PPO的信任域裁剪引入NQS:幅值通道中,采样构型存储后被复用$K=4$次内部更新,每次$r_\theta=\mathcal{P}_\theta/\mathcal{P}_{\theta_{\text{old}}}$被裁剪到$[1-\epsilon,1+\epsilon]$以防止概率比突变。但PPO仅处理实值概率,而VMC梯度有复值相位成分——因此额外引入第二个裁剪替代函数:在相位通道中裁剪包裹相位差$\phi_\theta$到$[-\delta,\delta]$,并将$r_\theta$的梯度从相位项中用stop_gradient分离(式(17)),以确保参考点处梯度精确匹配原始VMC。
理论保证:局部梯度一致性 + 全局不保真度能量界。 定理4.1证明PWO在$\theta=\theta_{\text{old}}$处的梯度与VMC梯度严格相等——裁剪在参考点不激活,因此"局部"无近似误差。定理4.2给出任意有限更新下的能量变化上界:主项是替代函数$\mathcal{A}_{\theta_{\text{old}}}(\theta)=2\mathbb{E}[\sqrt{r}(\cos\alpha A^R+\sin\alpha A^I)]$,残差项为$2\|\hat{H}-E\mathbb{1}\|_\infty(1-\sqrt{1-\mathcal{I}})$——如果更新保持波函数接近(小$\mathcal{I}$),则真实能量降低可由替代函数负值确保。
实验验证——简单系统:PWO在收敛速度和稳定性上均优于基线。 在1D横场Ising上,PWO约5分钟达$\epsilon_{\text{rel}}=10^{-7}$,minSR需约30分钟——差距主要来自minSR每一步需雅可比收缩和线性求解的额外开销。在$J_1{-}J_2$链(Majumdar-Ghosh点,强阻挫)上,minSR在10次运行中6次出现NaN(数值病态),Adam比PWO高出数个数量级出现平台,PWO则在$\sim15$分钟稳定达$10^{-7}$——"稳定性是最好的速度"。
实验验证——2D+扩展:趋势一致,但精度低于SOTA。 在$10\times10$方晶格$J_1{-}J_2$模型上,PWO在相同挂钟时间内能量低于Adam,V分数持续降低(表明往本征态收敛)。规模实验表明中等NQS(1.4M参数)下Adam需约4倍时间达PWO同等精度,但4小时长时运行后Adam能量更低——PWO的快速收敛优势在极长时间窗口可能被Adam超越。
极限测试:1.5B参数验证PWO不因规模崩溃。 RWKV-7作为自回归NQS(1.5B参数,超出此前NQS工作三个数量级)在12格点Ising上微调:PWO相对误差和V分数均低于Adam,全程训练稳定——证明裁剪替代函数不随参数量增大而失效。但该实验物理意义有限(12格点Ising可精确对角化),主要是"规模冒烟测试"。
实验参数详解#
| 参数 | 数值 | 含义 |
|---|---|---|
| 1D格点数$N$ | 12 | 所有1D基准系统和RWKV微调共用的链长 |
| 2D晶格尺寸 | $10\times10$ | 方晶格$J_1-J_2$模型,100个自旋 |
| 批次采样数$M$ | 1024(1D),2048(缩放),150(RWKV) | 每轮从Born分布精确抽取的构型数 |
| PPO内轮次$K$ | 4 | 每采样批次复用的内部更新次数 |
| 幅值裁剪$\epsilon$ | $10^{-3}$ | 概率比$r_\theta$的信任域半径 |
| 相位裁剪$\delta$ | 0.3 | 包裹相位差$ |
| 峰值学习率 | $10^{-4}$(PWO/Ising),$10^{-4}$(PWO/Heisenberg),$3\times10^{-4}$(Adam/Heisenberg) | 余弦单周期调度峰值 |
| 学习率转换步数 | 5000(Ising/Adam),20000(Ising/PWO),40000($J_1-J_2$) | 调度退火总步数 |
| GRU循环层数 | 3 | 自回归主干网络深度 |
| GRU隐藏维度 | 256 | 循环层神经元数 |
| minSR对角偏移 | $10^{-2}$ | SR矩阵正则化参数 |
| SPRING动量 | 0.8 | KFAC型动量系数 |
| RWKV模型参数量 | 1,500,000,000 | 微调实验的LLM规模 |
| 二维块自回归块大小 | $2\times2$ | $10\times10$晶格划分为25个块 |
批判性思考#
stoquastic假设的覆盖范围——等价性仅对实正波函数严格成立。 命题3.1的证明核心是式(39)双重和的对称抵消,这依赖于:$\hat{H}_{\mathbf{s},\mathbf{s}'}$为实数且$\psi_\theta(\mathbf{s})>0$(Perron-Frobenius)。对于带符号问题的费米子或阻挫海森堡模型,波函数有符号振荡,对称抵消不成立,$\mathbb{E}[\nabla_\theta E_\theta^{\text{loc}}]\neq0$。这意味着PWO的幅值裁剪会丢失梯度中的一部分,图3中$J_1-J_2$上的收敛可能因剩余修正项(未被裁剪项覆盖)而受损。
裁剪信任域仅是"经验性"而非"保证性"——全局条件不满足则推论4.3失效。 推论4.3要求对所有$\mathbf{s}\in\{\pm1\}^N$满足$r_\theta(\mathbf{s})\in[1-\epsilon,1+\epsilon]$和$|\alpha_\theta(\mathbf{s})|\leq\delta$。但PWO只在采样批次上施加裁剪,其他$2^N-M$个未采样构型可能任意违反约束——由于参数共享,一次违反所有构型的更新可能发生。论文附录B.7明确承认"仅鼓励而非保证",这意味着定理4.3的条件性改进在实际训练中的激活频率未知。
挂钟时间的比较存在"方法本身速度差异"的混淆因子。 PWO每一步是$O(P)$的一阶操作,minSR需$O(M^2P+M^3)$。论文图2显示PWO比minSR快约6倍达相同精度,但未分析"如果minSR用相同挂钟时间做更多迭代(减少$M$或使用更大lr)能否追上"。更公平的比较应是"相同计算预算$\tau$下谁的精度更高"而非"谁先到达某个精度"——因为minSR单步质量高但慢,PWO单步质量低但快,综合取决于问题。
相位通道裁剪策略的理论选择缺乏比较论证。 相位项$L_{\text{arg}}^{\text{clip}}$裁剪$\phi_\theta$而非$\exp(i\phi_\theta)$或相位比,其选择动机是"on-policy时梯度一致"(式(17)的stop_gradient设计)。但裁剪$\phi_\theta$到$[-\delta,\delta]$意味着相位变化超过$\delta$后梯度被完全截断——这等价于设定一个"相位移动上限",而物理上波函数相位可能与$\hat{H}$的符号结构密切相关。论文未比较其他相位正则化(如L2相位惩罚、余弦相似度裁剪)的效果,未排除本文策略仅为"恰好管用的启发式"的可能性。
RWKV微调实验缺乏物理动机——12格点Ising无需1.5B参数。 12格点Ising模型可精确对角化,基态能量已知。用1.5B参数LLM拟合这一简单问题属于严重的过参数化。论文虽自评"并非说明LLM是正确归纳偏置",但该实验的实质信息仅是"PWO不因参数量爆炸而训练崩溃",对于物理应用的价值有限——未测试PWO是否能发现此前不可及的大系统基态或新物理现象。
局限性#
- stoquastic假设排除了大量物理上有重要意义的系统—— 命题3.1的VMC-to-RL等价性对费米子符号问题、量子化学非Born-Oppenheimer哈密顿量以及一般阻挫自旋模型不严格成立,限制了PWO在量子化学和材料计算中的应用(论文附录B.1明确此条件)。
- 1D+小规模基准对结论的泛化能力支持有限—— 所有精确误差基准均基于$N=12$的1D链,这远小于典型NQS应用(如Rende et al. 2024的$20\times20$ PEPS)。论文未在$N>100$的1D系统或$20\times20$以上的2D系统中验证PWO的收敛可靠性和内存扩展性。
- minSR的高NaN率未被系统性地优化消除—— 在$J_1{-}J_2$链上minSR有60%NaN,但论文未进行回归化强度(对角偏移$\lambda$)的精细扫描来最小化NaN率,也未增加样本数$M$来改善数值条件($M$越大SR矩阵条件越好)。因此minSR的"不稳定"可能源于次优超参数而非方法本身缺陷。
- 理论保证的局部性无法解释全局收敛行为—— 定理4.1仅保证参考点处梯度一致,定理4.2给出对任意有限更新的上界但未保证该上界的单调递减性。对于非凸的NQS损失景观,PWO的训练轨迹可能被裁剪行为引导至低质量局部极小——实验未系统考察不同随机种子下最终能量的离散程度。
- 相位裁剪$\delta=0.3$的选择缺乏敏感度分析—— 论文对所有哈密顿量固定$\delta=0.3$和$\epsilon=10^{-3}$,未报告这些超参数对最终能量和收敛速度的敏感性。如果PWO的最佳$\delta$随系统尺寸、纠缠度或相位通道的初始尺度剧烈变化,则该算法的实际适用性受限。
- 与二阶方法的"精度上限"比较缺失—— 论文仅报告了PWO优于minSR/SPRING的相对精度,但未给出"已知最佳变分能量"作为上界参考(如论文自身引用的Rende et al. 2024的低能)。PWO在30分钟后$10\times10$ $J_1{-}J_2$上的能量$-185$距已知最佳约$-199$差距约7%,表明PWO可能在接近精确解时效率下降。
关键公式速查#
- $$\nabla_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ \left(E_{\boldsymbol{\theta}}^{\text{loc}} (\mathbf{s}) - \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\boldsymbol{\theta}}} \left[ E_{\boldsymbol{\theta}}^{\text{loc}} (\mathbf{s}) \right]\right) \nabla_{\boldsymbol{\theta}} \log \mathcal{P}_{\boldsymbol{\theta}} (\mathbf{s}) \right]$$— VMC梯度的策略梯度形式(stoquastic假设),式(14)
- $$L_{\mathrm{mod}}^{\mathrm{clip}} (\pmb{\theta}) = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}_{\mathrm{old}}}} \left[ \max \left(r_{\pmb{\theta}} (\mathbf{s}) A_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{R}} (\mathbf{s}), \mathrm{clip} (r_{\pmb{\theta}} (\mathbf{s}), 1 - \epsilon , 1 + \epsilon) A_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{R}} (\mathbf{s})\right) \right]$$— PWO幅值通道裁剪代理损失,式(15)
- $$L_{\mathrm{arg}}^{\mathrm{clip}} (\pmb{\theta}) = \mathbb{E}_{\mathbf{s} \sim \mathcal{P}_{\pmb{\theta}_{\mathrm{old}}}} \left[ \mathrm{sg} \big (r_{\pmb{\theta}} (\mathbf{s}) \big) \max \big (\phi_{\pmb{\theta}} (\mathbf{s}) A_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{I}} (\mathbf{s}), \mathrm{clip} \big (\phi_{\pmb{\theta}} (\mathbf{s}), - \delta , \delta \big) A_{\pmb{\theta}_{\mathrm{old}}}^{\mathrm{I}} (\mathbf{s}) \big) \right]$$— PWO相位通道裁剪代理损失(含stop_gradient),式(17)
- $$E [ \psi_{\pmb{\theta}} ] - E [ \psi_{\pmb{\theta}_{\mathrm{old}}} ] \leq \mathcal{A}_{\pmb{\theta}_{\mathrm{old}}} (\pmb{\theta}) + 2 \bigg \| \hat{H} - E [ \psi_{\pmb{\theta}_{\mathrm{old}}} ] \mathbb{1} \bigg \| _{\infty} \left(1 - \sqrt{1 - \mathcal{I} (\psi_{\pmb{\theta}_{\mathrm{old}}} , \psi_{\pmb{\theta}})}\right)$$— 不保真度能量界,定理4.2,式(21)
- $$\left. \nabla_{\boldsymbol{\theta}} \left(L_{\mathrm{mod}}^{\mathrm{clip}} (\boldsymbol{\theta}) + L_{\mathrm{arg}}^{\mathrm{clip}} (\boldsymbol{\theta})\right) \right| _{\boldsymbol{\theta} = \boldsymbol{\theta}_{\mathrm{old}}} = \left. \nabla_{\boldsymbol{\theta}} E [ \psi_{\boldsymbol{\theta}} ] \right| _{\boldsymbol{\theta} = \boldsymbol{\theta}_{\mathrm{old}}}$$— PWO一阶一致性,定理4.1,式(19)
- $$S_{ij} = \mathrm{Re} \left\{\mathrm{Cov}_{\mathbf{s} \sim \mathcal{P}_{\theta}} \left[ O_{i}^{*} (\mathbf{s}), O_{j} (\mathbf{s}) \right] \right\}$$— Fubini-Study度量(SR的Fisher矩阵),式(12)
术语对照#
| 中文 | 英文 | 含义 |
|---|---|---|
| 神经量子态 | Neural Quantum State (NQS) | 用神经网络参数化多体波函数的方法 |
| 自回归模型 | Autoregressive model | 分解Born分布为条件概率乘积,实现精确独立采样 |
| 变分蒙特卡洛 | Variational Monte Carlo (VMC) | 用采样估计能量和梯度的一类方法 |
| 随机重配置 | Stochastic Reconfiguration (SR) | 用Fubini-Study度量预处理的自然梯度下降 |
| minSR | minimum SR | 将$P\times P$求逆降为$M\times M$的SR变体 |
| 近端策略优化 | Proximal Policy Optimization (PPO) | RL中裁剪概率比实现信任域的算法 |
| 近端波函数优化 | Proximal Wavefunction Optimization (PWO) | 本文提出的NQS信任域优化算法 |
| 包裹相位差 | Wrapped phase difference | 经atan2处理、取值$[-\pi,\pi]$的相位增量 |
| Fubini-Study度量 | Fubini-Study metric | 量子态空间的Riemannian度量($\propto$不保真度) |
| 阻挫 $J_1-J_2$ 模型 | Frustrated $J_1{-}J_2$ model | 含最近邻和次近邻耦合的海森堡模型,$J_2/J_1=0.5$为Majumdar-Ghosh点 |