学习作用量以推进分子动力学长时间步模拟
学习用于分子动力学长时间步模拟的作用量#
Filippo Bigi,* Johannes Spies, Michele Ceriotti†
计算科学与建模实验室,材料研究所,洛桑联邦理工学院,1015 洛桑,瑞士
(收到:2025年7月23日;接受:2026年4月23日;发表:2026年6月9日)
经典力学的方程可用于模拟从天体物理到原子尺度的无数物理系统的时间演化。精确的数值积分需要很小的时间步长,这限制了计算效率——特别是在分子动力学等跨越截然不同时间尺度的情形中。使用机器学习算法预测轨迹可以极大地延长积分时间步长,但代价是会引入伪影,例如缺乏能量守恒以及系统不同自由度之间失去均分。我们提出学习数据驱动的结构保持(辛且时间可逆)映射以生成长时间步经典动力学,并表明该方法等同于学习所关注系统的力学作用量。这些模型可以基于短参考轨迹进行学习,并可在热力学条件和化学组成之间迁移。我们表明,一个由作用量导出的机器学习积分器消除了非结构保持的机器学习预测器的病态行为,并且该方法可以迭代应用,作为对计算成本更低的直接预测器的修正。
以高精度和高效率模拟经典力学系统是计算物理学中一个长期存在的挑战[1,2]。传统数值方法通常依赖小时间步长来传播动力系统的运动方程,以提供精确的积分。这些小步长限制了计算速度和可扩展性,尤其是对于原子模拟等问题,这类问题中最快运动的时标与决定相关物理过程的缓慢集体跃迁时标之间存在巨大差距[3]。
机器学习的最新进展通过实现复杂物理过程的数据驱动近似提供了有前景的替代方案[4–12]。例如,最近关于使用长时间步进行机器学习驱动的分子动力学轨迹预测的工作展示了原子模拟工作流程潜在的重大加速[13–18]。然而,这些方法不保留底层哈密顿流的几何结构,导致违反能量守恒、均分以及其他基本物理定律,这限制了它们在严谨科学应用中的使用。在此,我们研究一种参数化方法,直接学习近似经典动力系统长时间演化的结构保持映射,目标是在保持几何和物理保真度的同时显著增大模拟时间步长。
我们感兴趣的一般问题是那些时间演化服从哈密顿方程的问题
$$ \frac{d \pmb{p}} {dt} = - \frac{\partial H} {\partial \pmb{q}} , \frac{d \pmb{q}} {dt} = \frac{\partial H} {\partial \pmb{p}} ,\tag{ðÞ} $$其中 q 和 p 分别表示位置和动量矢量,其维数等于力学系统中的自由度数目。在此以及本快报的其余部分,我们将假设哈密顿量不依赖于时间,这对于封闭系统是合适的。例如,在许多科学相关的问题中,$\mathbb{H}$ 采取如下形式
$$ H ( p , q ) = \sum_{i = 1}^{F} \frac{p_{i}^{2}} {2 m_{i}} + V ( \pmb{q} ) ,\tag{ðÞ} $$其中 $m_{i}$ 是与每个自由度的质量相关联的,而 $V ( q )$ 是系统的势能。这涵盖了从天文学到分子动力学的大多数经典系统。
鉴于这类问题在数学和物理的许多领域中无处不在,人们已开发出多种数值积分方法来求解哈密顿动力学。在这些方法中,能够保持精确哈密顿流特定几何性质的算法已被证明具有令人满意的长时间行为[19]。特别是,辛积分器能在任意时间步长下精确地保持与 $( p , q )$ 空间中的面积元相对应的几何项(相关领域教科书结果的简要总结见补充材料[20])。辛性质保证了存在一个修正的(或“影子”)哈密顿量,其精确流在非常长的时间尺度上与数值解达到极好的近似[19,21]。这确保了数值传播的系统也是哈密顿系统,并且由于修正的哈密顿量接近于真实的哈密顿量,从而实现了能量的长时间近守恒。此外,时间可逆方法的优点是它们的修正哈密顿量在时间步长的二阶精度内等于真实的哈密顿量,这进一步提高了它们的精度和能量守恒性。
生成哈密顿系统演化的另一种方法是将其纯粹视为一个学习问题:给定时间 $t$ 时的动量与位置,$p := \pmb{p} ( t )$ 和 $\mathbf{\nabla}_{\mathbf{q}} := \mathbf{\nabla}_{\mathbf{q}} ( t )$,目标是预测演化后的值 $p^{\prime} := p ( t + h ) , q^{\prime} := \pmb{q} ( t + h )$,其中 $h$ 是(可能很大的)时间步长。如前所述,最近有几项工作展示了机器学习(ML)模型,这些模型能以高精度预测 $( p^{\prime} , q^{\prime} )$,其时间步长可比传统积分器的稳定性极限长两个数量级[15–17],并且可以应用于分子与材料模拟中化学空间的很大一部分[16,17]。尽管这些模型精度很高,但由于模型不守恒能量,由此产生的长时间轨迹是不稳定的。如文献[17]中所讨论的,这可以通过重新缩放和热浴粒子速度来缓解,但缺乏底层的哈密顿结构会导致其他伪影的出现,例如均分定理的丧失,这些伪影难以监控和修正。
我们可以采用另一种学习方法,即使用一种能保持哈密顿问题结构的参数化方法。已知在温和假设下[19],任何辛映射 $( p , q ) \to ( p^{\prime} , q^{\prime} )$ 都可以由一个标量生成函数 $S$ 来定义,反之亦然。生成函数可以有多种参数化方式,最常见的是
$$ S ( {\pmb q} , {\pmb q}^{\prime} ) , S^{1} ( {\pmb p}^{\prime} , {\pmb q} ) , S^{2} ( {\pmb p} , {\pmb q}^{\prime} ) , S^{3} ( {\pmb \bar{p}} , {\pmb \bar{q}} ) ,\tag{ðÞ} $$这里我们沿用了文献[19]中的符号,其中 $\bar{p} = ( p + p^{\prime} ) / 2 , \bar{q} = ( q + q^{\prime} ) / 2$。在这些参数化形式中,我们选择了 $S^{3}$ 参数化,因为它是对称的,能导出一个简单而优雅的时间可逆映射条件,并且因为与之相关联的辛变换的评估等价于众所周知的中点隐式规则[19],其实际实现将在下面讨论。关于选择 $S^{3}$ 的更多细节可在补充材料[20]中找到。形式为 $S^{3} ( \bar{p} , \bar{\pmb q} )$ 的生成函数将辛映射定义为
$$ \Delta p = - \frac{\partial S^{3}} {\partial \bar{\pmb q}} , \quad \Delta \pmb q = \frac{\partial S^{3}} {\partial \bar{\pmb p}} ,\tag{ðÞ} $$其中 $\Delta p = p^{\prime} - p$,$\Delta q = q^{\prime} - q$。接着,将 $S^{3}$ 表示为神经网络 $\tilde{S}^{3}$,由此得到辛映射 $( p , q ) \to ( p^{\prime} , q^{\prime} )$ 的通用参数化形式,并且该神经网络可以使用传统小时间步长积分器生成的 $( ( p , q ) , ( p^{\prime} , q^{\prime} ) )$ 配对数据进行训练。这种公式确保了预测的时间演化是辛的,但不一定是时间可逆的。为了施加这一额外对称性(可表示为约束 $\left( - p^{\prime} , q^{\prime} \right) \to \left( - p , q \right)$),需要确保 $S^{3} ( \bar{\pmb{p}} , \bar{\pmb{q}} ) = S^{3} ( - \bar{p} , \bar{q} )$(参见补充材料[20])。如果 $S^{3}$ 由神经网络 $\tilde{S}^{3}$ 表示,则可以在不失一般性的情况下施加这一条件。事实上,只需对神经网络关于 $\bar{p}$ 进行对称化处理即可,例如
$$ \tilde{S}^{3} ( \bar{p} , \bar{q} ) \frac{\tilde{S}^{3} ( \bar{p} , \bar{q} ) + \tilde{S}^{3} ( - \bar{p} , \bar{q} )} {2} .\tag{ðÞ} $$尽管本文不考虑变步长的机器学习,但讨论生成函数 $\mathbb{S}$ 和 $S^{3}$ 对时间步长 $h$ 的依赖性仍具有启发性。事实上,可以证明[19]时变生成函数 $S ( \pmb q , \pmb q^{\prime} , h )$ 必须满足 Hamilton-Jacobi 偏微分方程:
$$ - \frac{\partial S} {\partial h} = H \left( \frac{\partial S} {\partial q^{\prime}} , q^{\prime} \right) ,\tag{ðÞ} $$因此它对应于系统的作用量。由于 $S^{3}$ 与 $\mathbb{S}$ 的关系为(相差一个常数):
$$ {\cal S}^{3} ( \bar{p} , \bar{q} , h ) = \bar{p} ( h ) \cdot \Delta q ( h ) - {\cal S} ( \mathbf q , q^{\prime} , h ) ,\tag{ðÞ} $$学习由哈密顿流生成的辛映射 $S^{3}$ 实际上等价于学习系统的作用量 $\mathbb{S}$。这里,"作用量" $S ( \pmb q , \pmb q^{\prime} , h )$ 指的是哈密顿主函数,也称为哈密顿-雅可比作用量,它对应于作用量泛函在从 q 出发、结束于 $\pmb q^{\prime}$ 且历时为 $h$ 的路径上取最小值。
神经网络近似 $\tilde{S}^{3}$ 对 $h$ 的显式依赖性,也可用于严格证明由其生成的模拟中存在修正哈密顿量。假设神经网络 $\tilde{S}^{3} ( \bar{p} , \bar{q} , h )$ 的训练过程通过训练样本 $( ( p , q ) , ( p^{\prime} ( h ) , q^{\prime} ( h ) ) )$ 对 $h$ 的依赖关系,使得该函数是 $h$ 的光滑且无穷可微函数,那么我们可以将 $\tilde{S}^{3} ( \bar{p} , \bar{q} , h )$ 本身视为 $h$ 的光滑且无穷可微函数。在此假设下(见文献[19]第9章),离散化模拟遵循由修正哈密顿量生成的动力学,这赋予了其哈密顿动力学的优良性质,包括长时间能量守恒、能量均分等。
为了在实际模拟中说明这些优势,我们将考察几个案例。在以下所有示例中,我们通过使用速度 Verlet [22] 积分(以小时间步长运行短时经典轨迹)生成参考数据。这种积分方法非常适合生成参考数据,因为它对于我们所考虑的系统是显式、辛且时间可逆的,因为这些系统都具有可分离的哈密顿量 $H ( p , q ) = T ( p ) + V ( q )$。如果情况并非如此,则使用隐式中点法生成参考数据更为合适。然后,我们训练一个"直接预测"模型,该模型简单地将未来固定大时间延迟后的坐标预测为 $( p , q )$ 的函数;以及第二个模型,该模型改为预测 $\tilde{S}^{3} ( \bar{p} , \bar{q} )$。我们在补充材料[20]中讨论了所有示例的架构、超参数和训练集构建。
在训练时,式(4)的计算没有问题,因为 $( p , q )$、$( p^{\prime} , q^{\prime} )$ 以及 $( \bar{p} , \bar{\pmb q} )$ 都是已知的,并且模型可以被训练通过式(4)来重现参考的 $\Delta p$ 和 $\Delta \pmb q$。然而,系统动力学的预测[即仅从 $( p , q )$ 预测 $( p^{\prime} , q^{\prime} )$]涉及隐式问题的求解。由于后者恰好具有隐式中点法的形式,我们采用哈密顿系统积分中的标准技术,即使用不动点迭代[19](并通过混合方法稳定化)来求解隐式系统。我们以直接预测模型的输出初始化迭代,然后迭代直至收敛,或进行固定次数的迭代,这相当于对非保结构模型施加一个修正。在补充材料[20]中,我们提供了该方法的更多细节,并研究了使用有限记忆的安德森加速来提高用于求解隐式系统的不动点迭代的收敛速度。
作为第一个说明性示例,我们考虑对称构型下三体问题动力学的预测,该构型允许具有周期轨道的封闭解。两个模型对三个天体轨迹的预测(使用速度 Verlet 积分不稳定的较大步长运行)如图1所示,同时给出了相应的总能量曲线。辛模型的结果(迭代至收敛)展示了辛积分器典型的卓越长时间稳定性和精度,这允许定义修正哈密顿量;而直接模型则沿轨迹显示出非物理的进动和较差的能量守恒性。
这个三体问题展示了所提出的结构保持方法的优良特性,但经典动力学的应用通常涉及数量多得多的相互作用粒子以及复杂的多体势能函数。分子动力学正是如此,其目标通常是从微观模拟中获得热力学平均值。
为了说明原子尺度的应用,我们考虑液态水这一典型例子。我们首先考虑基于FlashMD架构[17]的直接预测ML积分器,该模型在固态和液态两相不同密度(介于水实验密度的90%和110%之间)和温度(从10到1000 K)下的NVE分子动力学轨迹上进行了训练。分子动力学模拟使用来自i-PI模拟软件包[24]的q-TIP4P/f [23]势能,并采用速度Verlet积分器,保守时间步长为0.25 fs。与上一个示例相同,直接模型预测经过固定时间间隔后的未来位置和动量,我们将其与随机速度重标热浴[25]结合,在恒温系综中进行模拟,替代对称Trotter分裂积分器(即所谓的OBABO积分器[26])中的速度Verlet步骤。当使用2 fs的时间步长时,直接积分器显示出守恒量的较大漂移、能量均分定理的违反,以及在计算得到的静态和动态性质上相对于参考短时间步长分子动力学(MD)结果的显著偏差(图2)。这些是所有当前ML积分器共有的采样伪影。然后,我们使用类似的图神经网络架构(模型细节见补充材料[20])为$S^{3}$训练一个模型,并以迭代方式使用,从$( p^{\prime} , q^{\prime} )$的直接预测开始,应用指定数量的不动点迭代。如图2所示,随着迭代次数的增加,积分器收敛到结构保持,逐渐减小能量漂移以及O和H原子之间的动力学温度不平衡。O-O对关联函数和均方位移曲线(反映水的结构和扩散性质)也收敛到参考值,这有力地证明了在ML积分器中强制执行哈密顿结构的有益效果。
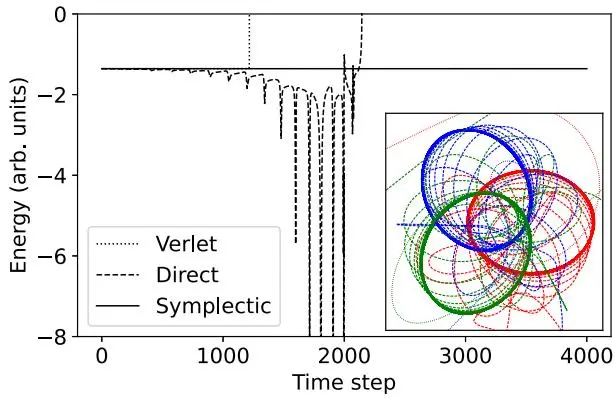
图1:使用大时间步长模拟对称三体问题的直接方法和辛方法的能量曲线及轨迹。同时展示了使用相同大时间步长的速度Verlet模拟结果。
作为一个更具挑战性的例子,我们考虑相变材料GeTe的情况。我们从参考文献[27]的模拟中获得启发,并在深度过冷条件下研究该系统,在该条件下它表现出玻璃态行为。特别地,我们观察到在参考MD模拟中,势能表现出对数行为弛豫,该行为持续到几纳秒的时间尺度。我们基于短轨迹训练直接模型和辛模型,这些轨迹是从沿恒压温度循环收集的构型出发,我们在该循环中将温度从100 K升至1500 K(历时400 ps),然后快速淬火回到100 K,使用了PET-MAD通用原子间势能[28]。
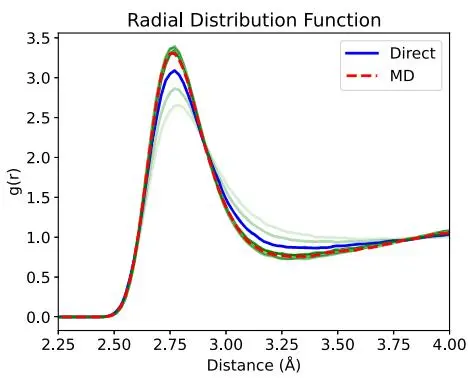
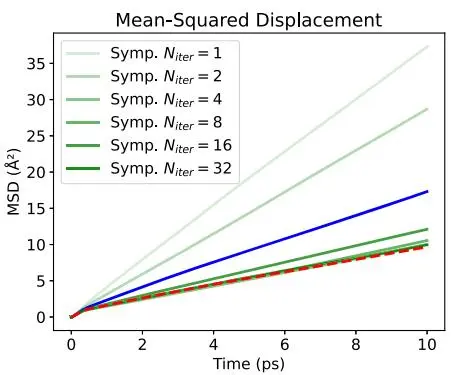
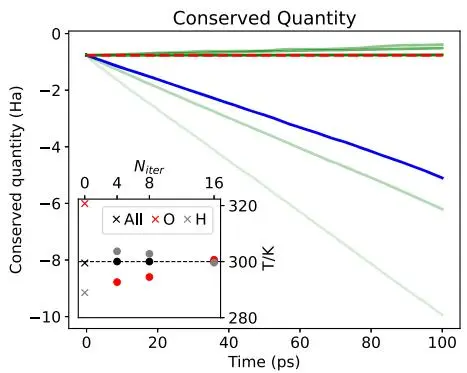
图2:在300 K下NVT系综中进行的液态水模拟,比较了速度Verlet基线、直接预测以及每个时间步使用可变数量不动点迭代的辛和可逆时间预测。左图:氧原子的径向分布函数。中图:氧原子的均方位移。右图:守恒量(总能量加热浴交换能量)的轮廓,插图表示平均原子类型分辨动力学温度。
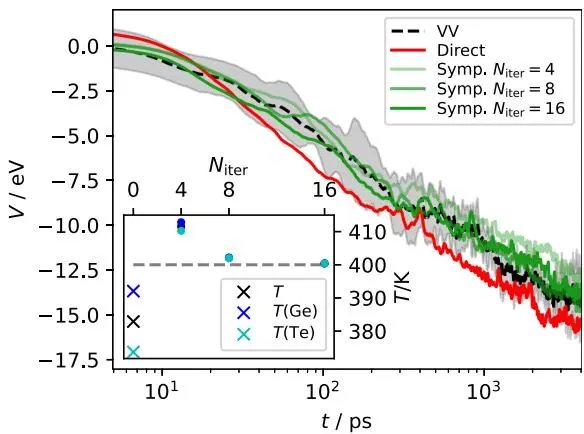
图3:使用包含432个原子的立方体盒对深度过冷GeTe $( T = 400 ~ \mathrm{K} )$ 进行长时间模拟的势能弛豫。不同曲线对应参考速度Verlet模拟(黑色)、直接轨迹预测(红色)以及采用不同数量不动点迭代的辛校正(绿色渐变)。曲线以2 ps高斯窗的移动平均进行平滑,并在四次独立运行中取平均值。灰色带表示速度Verlet参考值均值周围2个标准误差的范围;为清晰起见,其他曲线的误差棒已隐藏,但幅度相近。插图为:直接预测 $( N_{\mathrm{iter}} = 0 )$ 及不同辛迭代级别下平均温度(黑色)以及Ge(蓝色)与Te(青色)之间的温度分解。
随后,我们运行纳秒级轨迹,在400 K下采用温和的随机速度重缩放恒温器[25]进行热浴,分别使用4 fs时间步长的速度Verlet积分器和30 fs更长时间步长的基于机器学习的积分器。尽管训练数据有限,直接模型仅显示与目标温度的微小偏差,且Ge与Te原子之间的均分被打破的程度不到20 K。采用少数几次辛校正迭代即可强制均分并降低动温度误差,其中 $N_{\mathrm{iter}} = 16$ 足以实现完全平衡(图3)。机器学习积分器的良好性能也体现在它们定量捕捉类玻璃弛豫的能力上。即使是轨迹的直接预测也几乎不偏离参考模拟的置信区间,而所有采用辛校正的运行结果均在统计误差棒范围内。
更完整的示例集,包括使用更大的时间步长、NVE 和 NPT 模拟以及不同的基线势函数,均在补充材料 [20] 中讨论,该材料引用了文献 [8,17,19,22–38] 的结果。在那里,我们还展示了初步证据,表明该方法可适用于不同的材料成分,通过在一个通用数据集上训练的通用模型,并在六个高度多样化的系统中进行测试。总的来说,这些实验表明,违反结构保持特性是新兴机器学习方法在扩展经典动力学(特别是分子模拟)积分区间时的主要缺陷。长期能量守恒和能量均分定理的违反是问题严重性的良好间接诊断指标。我们提出了一种实用的参数化结构保持映射的方法,该方法显著提高了给定时间步长下机器学习积分器的稳定性,并解决了能量守恒和能量均分问题,从而恢复了传统小时间步长哈密顿积分器在实际模拟问题中的平衡态,以及更令人印象深刻的动力学性质。
我们方法当前的一个局限是需要通过反向传播计算导数,并使用隐式中点积分器——这两者都大幅增加了相比直接预测的计算成本(代表性示例见补充材料[20]中的图S3)。将隐式求解器的迭代作为修正手段——我们证明这种方法能系统地提高向收敛积分器逼近的精度——提供了一种缓解策略。从机器学习的角度看,未来工作可聚焦于提升直接预测的精度,将辛版本作为合理性检查以及监测哈密顿几何结构违反程度的实用方法,否则需要计算极为昂贵的映射雅可比矩阵。在更一般的层面上,我们所学到的生成函数——模去一个平凡变换后——本质上等价于哈密顿-雅可比作用量,这一事实表明,类似思想或许可用于以数据驱动方式近似相对论、量子力学及其他可用作用量表述的物理系统与理论的长时间步动力学。
致谢——本工作得到了瑞士先进科学计算平台(PASC)和瑞士国家科学基金会资助的NCCR MARVEL(资助号SNSF Grant No. 182892)的支持。我们感谢瑞士人工智能计划(项目编号aa02)及瑞士国家超算中心(项目编号lp133)提供的计算资源。F.B.得到了瑞士人工智能计划(2025年研究员计划)的支持。我们感谢Federico Grasselli、Kevin Huguenin-Dumittan、Pol Febrer和Sanggyu Chong的有益讨论。
数据可用性——支持本文研究结果的数据已公开发布[39]。
[1] Rubin H. Landau, Manuel J. Páez, and Cristian C. Bordeianu, Computational Physics: Problem Solving with Python (John Wiley & Sons, New York, 2024).
[2] Benedict Leimkuhler and Sebastian Reich, Simulating Hamiltonian Dynamics (Cambridge University Press, Cambridge, England, 2004), Vol. 14.
[3] John L. Klepeis, Kresten Lindorff-Larsen, Ron O. Dror, and David E. Shaw, Long-timescale molecular dynamics simulations of protein structure and function, Curr. Opin. Struct. Biol. , 120 (2009).[4] Steven L. Brunton, Bernd R. Noack, and Petros Koumoutsakos, Machine learning for fluid mechanics, Annu. Rev. Fluid Mech. , 477 (2020).
[5] Jonas Degrave, Federico Felici, Jonas Buchli, Michael Neunert, Brendan Tracey, Francesco Carpanese, Timo Ewalds, Roland Hafner, Abbas Abdolmaleki, Diego de Las Casas et al., Magnetic control of Tokamak plasmas through deep reinforcement learning, Nature (London) , 414 (2022).
[6] Markus Reichstein, Gustau Camps-Valls, Bjorn Stevens, Martin Jung, Joachim Denzler, Nuno Carvalhais, and F. Prabhat, Deep learning and process understanding for datadriven earth system science, Nature (London) , 195 (2019).
[7] Giuseppe Carleo, Ignacio Cirac, Kyle Cranmer, Laurent Daudet, Maria Schuld, Naftali Tishby, Leslie Vogt-Maranto, and Lenka Zdeborová, Machine learning and the physical sciences, Rev. Mod. Phys. , 045002 (2019).
[8] Samuel Greydanus, Misko Dzamba, and Jason Yosinski, Hamiltonian neural networks, Adv. Neural Inf. Process. Syst. , 15389 (2019).[9] Katharina Rath, Christopher G. Albert, Bernd Bischl, and Udo von Toussaint, Symplectic Gaussian process regression of maps in Hamiltonian systems, Chaos , 053121 (2021).
[10] Renyi Chen and Molei Tao, Data-driven prediction of general Hamiltonian dynamics via learning exactly-symplectic maps, in International Conference on Machine Learning (PMLR, 2021), pp. 1717–1727.
[11] Christian Offen and Sina Ober-Blöbaum, Symplectic integration of learned Hamiltonian systems, Chaos , 013122 (2022).
[12] Pengzhan Jin, Zhen Zhang, Aiqing Zhu, Yifa Tang, and George Em Karniadakis, Sympnets: Intrinsic structurepreserving symplectic networks for identifying Hamiltonian systems, Neural Netw. , 166 (2020).[13] Tianze Zheng, Weihao Gao, and Chong Wang, Learning large-time-step molecular dynamics with graph neural networks, arXiv:2111.15176.
[14] Pantelis R. Vlachas, Julija Zavadlav, Matej Praprotnik, and Petros Koumoutsakos, Accelerated simulations of molecular systems through learning of effective dynamics, J. Chem. Theory Comput. , 538 (2021).[15] Fabian L. Thiemann, Thiago Reschützegger, Massimiliano Esposito, Tseden Taddese, Juan D. Olarte-Plata, and Fausto Martelli, Force-free molecular dynamics through autoregressive equivariant Networks, arXiv:2503.23794.
[16] Fuchun Ge and Pavlo O. Dral, Artificial intelligence for direct prediction of molecular dynamics across chemical space, arXiv:2505.16301.
[17] Filippo Bigi, Sanggyu Chong, Agustinus Kristiadi, and Michele Ceriotti, FlashMD: Long-stride, universal prediction of molecular dynamics, arXiv:2505.19350.
[18] G. Dayhoff and Sameer Varma, Mlmd: Machine learning velocities to propagate molecular dynamics simulations, ChemRxiv preprint ChemRxiv 10 (2025).
[20] 参见补充材料,网址为 http://link.aps.org/supplemental/10.1103/shj2-hyw8,其中包含机器学习保持分子动力学结构映射的理论分析及更多实例,包括周期表中通用模型的训练与应用。
[21] Giancarlo Benettin and Antonio Giorgilli, On the Hamiltonian interpolation of near-to-the identity symplectic mappings with application to symplectic integration algorithms, J. Stat. Phys. , 1117 (1994).
[22] Loup Verlet, Computer “Experiments” on Classical Fluids, I, Thermodynamical properties of Lennard-Jones molecules, Phys. Rev. , 98 (1967)。[23] Scott Habershon, Thomas E. Markland, and David E. Manolopoulos, Competing quantum effects in the dynamics of a flexible water model, J. Chem. Phys. , 024501 (2009).
[24] Yair Litman, Venkat Kapil, Yotam M. Y. Feldman, Davide Tisi, Tomislav Begušić, Karen Fidanyan, Guillaume Fraux, Jacob Higer, Matthias Kellner, Tao E. Li, Eszter S. Pós, Elia Stocco, George Trenins, Barak Hirshberg, Mariana Rossi, and Michele Ceriotti, i-PI 3.0: A flexible and efficient framework for advanced atomistic simulations, J. Chem. Phys. , 062504 (2024)。[25] G. Bussi, D. Donadio, and M. Parrinello, Canonical sampling through velocity rescaling, J. Chem. Phys. , 14101 (2007)。
[26] G. Bussi and M. Parrinello, Accurate sampling using Langevin dynamics, Phys. Rev. E , 056707 (2007)。[27] Gabriele C. Sosso, Giacomo Miceli, Sebastiano Caravati, Federico Giberti, Jörg Behler, and Marco Bernasconi, Fast crystallization of the phase change compound GeTe by large-scale molecular dynamics simulations, J. Phys. Chem. Lett. , 4241 (2013)。
[28] Arslan Mazitov, Filippo Bigi, Matthias Kellner, Paolo Pegolo, Davide Tisi, Guillaume Fraux, Sergey Pozdnyakov, Philip Loche, and Michele Ceriotti, PET-MAD, a universal interatomic potential for advanced materials Modeling, arXiv:2503.14118。
[29] R. K. Pathria, Statistical Mechanics, 2nd ed. (Butterworth-Heinemann, Oxford, United Kingdom, 1996)。
[30] Aidan P. Thompson, H. Metin Aktulga, Richard Berger, Dan S. Bolintineanu, W. Michael Brown, Paul S. Crozier, Pieter J. In’t Veld, Axel Kohlmeyer, Stan G Moore, Trung
Dac Nguyen et al., LAMMPS-a flexible simulation tool for particle-based materials modeling at the atomic, meso, and continuum scales, Comput. Phys. Commun. , 108171 (2022)。
[31] Dorde Dangić, Olle Hellman, Stephen Fahy, and Ivana Savić, The origin of the lattice thermal conductivity enhancement at the ferroelectric phase transition in GeTe, npj Comput. Mater. (2021)。
[32] Giovanni Bussi, Tatyana Zykova-Timan, and Michele Parrinello, Isothermal-isobaric molecular dynamics using stochastic velocity rescaling, J. Chem. Phys. , 074101 (2009)。
[33] Diederik P. Kingma and Jimmy Ba, Adam: A method for stochastic optimization, arXiv:1412.6980。
[34] Filippo Bigi, Paolo Pegolo, Arslan Mazitov, and Michele Ceriotti, Pushing the limits of unconstrained machinelearned interatomic potentials, arXiv:2601.16195。
[35] Luis Barroso-Luque, Muhammed Shuaibi, Xiang Fu, Brandon M. Wood, Misko Dzamba, Meng Gao, Ammar Rizvi, C. Lawrence Zitnick, and Zachary W. Ulissi, Open materials 2024 (omat24) inorganic materials dataset and models, arXiv:2410.12771。
[36] Alexander D. Kaplan, Richard Liu, Junwen Qi, Tsz Wai Ko, Bowen Deng, Janosh Riebesell, Gerbrand Ceder, Kristin A. Persson, and Shyue Ping Ong, A foundational potential energy surface dataset for materials, arXiv:2503.04070。
[37] F. Bigi, J. W. Abbott, P. Loche, A. Mazitov, D. Tisi, M. F. Langer, A. Goscinski et al., Metatensor and metatomic: Foundational libraries for interoperable atomistic machine learning, J. Chem. Phys. , 064113 (2025)。[38] Donald G. Anderson, Iterative procedures for nonlinear integral equations, J. ACM , 547 (1965)。
学习用于分子动力学长时步模拟的作用量#
补充材料#
Filippo Bigi,1, ∗ Johannes Spies, and Michele Ceriotti1, †Laboratory of Computational Science and Modeling, Institut des Mat´eriaux, Ecole Polytechnique F´ed´erale de Lausanne, 1015 Lausanne, Switzerland ´ (日期:2026年4月24日)
S1. 辛映射的生成函数#
一个辛映射 $S : ( p , q ) \ : \ : ( p^{\prime} , q^{\prime} )$ 是一个可微映射,具有以下性质:
$$ \left( {\frac{d {\pmb y}^{\prime}} {d {\pmb y}}} \right)^{\top} {\pmb J} \left( {\frac{d {\pmb y}^{\prime}} {d {\pmb y}}} \right) = {\pmb J} ,\tag{S1} $$其中 $\pmb{y} \equiv ( \pmb{p} , \pmb{q} ) , \pmb{y}^{\prime} \equiv ( \pmb{p}^{\prime} , \pmb{q}^{\prime} )$,$d y^{\prime} / d y$ 是该映射的雅可比矩阵,并且
一般来说,任何辛映射都可以关联一个生成函数,该函数完全表征了该映射。生成函数是一个标量函数,可以有多种表达方式。正文中提到的有:
$$ S ( {\pmb q} , {\pmb q}^{\prime} ) , \quad{\pmb p} = - \frac{\partial S} {\partial{\pmb q}} , \quad{\pmb p}^{\prime} = \frac{\partial S} {\partial{\pmb q}^{\prime}} ,\tag{S3} $$$$ S^{1} ( p^{\prime} , q ) , \quad \Delta q = \frac{\partial S^{1}} {\partial p^{\prime}} , \quad \Delta p = - \frac{\partial S^{1}} {\partial q} ,\tag{S4} $$$$ S^{2} ( p , q^{\prime} ) , \Delta q = \frac{\partial S^{2}} {\partial p} , \Delta p = - \frac{\partial S^{2}} {\partial q^{\prime}} ,\tag{S5} $$S2. 第三类生成函数的选择#
虽然原则上,S1中强调的所有生成函数都可以用神经网络表示并学习,但第三类生成函数 $S^{3}$ 特别方便。
首先,我们考虑在辛映射上,进而也是在生成函数上,强制执行时间反演对称性的问题。时间反演对称性可以表述为:如果辛映射 $s$ 给出 $( p , q ) \rightarrow ( p^{\prime} , q^{\prime} )$,那么它也必须给出 $( - p^{\prime} , q^{\prime} ) \rightarrow ( - p , q )$。从S1中的方程可以看出,这意味着(相差一个常数加项):
$$ S ( {\pmb q} , {\pmb q}^{\prime} ) = S ( {\pmb q}^{\prime} , {\pmb q} ) ,\tag{S7} $$$$ S^{1} ( p^{\prime} , q ) = S ( - p , q^{\prime} ) ,\tag{S8} $$$$ S^{2} ( p , q^{\prime} ) = S^{2} ( - p^{\prime} , q ) ,\tag{S9} $$$$ S^{3} ( \bar{p} , \bar{q} ) = S^{3} ( - \bar{p} , \bar{q} ) .\tag{S10} $$对于 $S^{1}$ 和 $S^{2}$ 的条件会导致复杂的实现,因为强制执行时间反演对称性还需要将机器学习的目标也用作输入。
此外,选择 $S ( \pmb q , \pmb q^{\prime} )$ 虽然在训练时实用,但在推理时会带来问题:必须找到 $\pmb q^{\prime}$ 才能对已经已知的 $p$ 进行自洽预测。然而,数值求解此问题会导致 $\mathbf{\nabla}_{\mathbf{p}} \cdot$ 出现两个略有差异的值:一个来自上一步已知,另一个由当前步计算的生成函数 $S$ 给出。如果选择 $S^{3} ( \bar{\pmb{p}} , \bar{\pmb{q}} )$ 则不存在此问题,因为有限精度不会导致当前步位置和动量值的潜在变化,只会影响未来步的值,这与传统隐式积分器类似。此外,传播第三类生成函数 $S^{3}$ 的表达式与隐式中点法的表达式完全等价,这使得可以为此传统隐式积分器使用已有的优化实现。
最后,$S ( q , q^{\prime} , h )$ 在 $h = 0$ 处存在焦散,这可能影响训练和预测的稳定性,而 $S^{3} ( \bar{\pmb{p}} , \bar{\pmb{q}} , h )$ 的首个焦散则被延迟(例如,在谐振子中位于振荡周期的一半处)。更多细节,我们请读者参考下面关于通用分子动力学模型对液态水系统的16飞秒预测的讨论。
S3. 与传统积分器的关系#
我们的方法与传统积分器,特别是与隐式中点法的关系,可以进一步揭示所提出的辛映射参数化方法如何工作。隐式中点法基于将 $S^{3} ( \bar{\pmb{p}} , \bar{\pmb{q}} , h )$ 截断至其在步长 h 中的首阶项 [12]:
$$ S^{3} ( \bar{p} , \bar{q} , h ) \approx h H ( \bar{p} , \bar{q} ) .\tag{S11} $$这种近似对于小步长 $h$ 是良好的,但对于大时间步长则不准确。通过提供 $S^{3}$ 的任意参数化,我们的方法转而寻求精确表示它,因此能够使用更大的时间步长实现物理上保真度的动力学。作为一个教学示例,一维谐振子的 ${\bar{S}}^{3}$ 生成函数为
$$ S^{3} ( \bar{p} , \bar{q} , h ) = \frac{2} {\omega} \tan \left( \frac{\omega h} {2} \right) H ( \bar{p} , \bar{q} ) ,\tag{S12} $$其中 $\omega$ 是其角频率,${\cal H} ( \bar{p} , \bar{q} ) = \bar{p}^{2} / ( 2 m ) +$ $m \omega^{2} \bar{q}^{2} / 2$ 是其哈密顿量在中点变量处的取值。一个自然的推论是,学习哈密顿量 $H ( p , q )$ [10] 而非辛映射,并不能消除对小时间步长积分器的需求,因为传播依赖于方程 S12 中的近似,而该近似通常仅对小时间步长 $h$ 有效。
S4. 经典哈密顿量动量项中偏离均分的小偏差#
与传统数值积分器一样,我们的方法并不能保证在最直观的意义上实现精确的能量均分。在此我们讨论其原因,并分析影子哈密顿量的展开式,这可以为此提供有价值的见解。
设影子哈密顿量 $H ( p , q )$ 为哈密顿-雅可比方程的解,其中 $S$ 由神经网络定义(可能通过 $S^{3}$)。那么,均分定理在正则系综中成立(例如参考文献 [17] 第 3 章),其意义在于
$$ \left. x_{m} \frac{\partial H} {\partial x_{n}} \right. = \delta_{mn} k_{B} T ,\tag{S13} $$其中 $x_{m}$ 和 $x_{n}$ 是位置向量 $\pmb{q}$ 或动量向量 $\pmb{p}$ 的各个分量。然而,由于影子哈密顿量 $H$ 通常不采取以下形式
$$ H ( \pmb{p} , \pmb{q} ) = \sum_{i} \frac{p_{i}^{2}} {2 m_{i}} + V ( \pmb{q} ) ,\tag{S14} $$某些均分定理常见且直观的推论便不成立。例如,对于方程 S14 中的 $H$,方程 S13 意味着
$$ \frac{\langle p^{2} \rangle} {2 m} = \frac{1} {2} k_{B} T ,\tag{S15} $$其中 $p$ 可以是 $\pmb{p}$ 的任意分量,$m$ 是对应自由度相关的质量。
对于一般的影子哈密顿量,情况并非必然如此。为理解原因,我们在 $\pmb{p} = \mathbf{0}$ 附近展开 $H ( p , q )$ 并计算 $\langle p^{2} \rangle$
$$ \langle p^{2} \rangle = \frac{1} {Z} \int \bigg ( \int p^{2} e^{H ( p , q ) / k_{B} T} d p \bigg ) d q ,\tag{S16} $$$$ H ( p , q ) = c_{0} ( q ) + \pmb{c}_{1} ( \pmb{q} )^{\top} \pmb{p} + \pmb{p}^{\top} \pmb{C}_{2} ( \pmb{q} ) \pmb{p} + . . .\tag{S17} $$可以看到 $c_{0}( \pmb q )$ 对积分值没有影响(因为它与 $Z$ 中的对应项相消,就像哈密顿量中形如式S14的 $V( q )$ 项一样)。项 $\pmb{c}_{1}( \pmb{q} )^{\top} .\pmb{p}$ 确实有影响,但如果强制执行时间可逆动力学(由于条件 $H( - \pmb{p} , \pmb{q} ) = H( \pmb{p} , \pmb{q} ))$,它将连同 $\pmb{p}$ 中的三次项和所有其他奇次项一起消失。现在,为了使式S16对所有动量自由度成立,我们需要 $C_{2}$ 是对角矩阵、与 ${\pmb q}$ 无关,且其元素对应于每个自由度质量倒数的两倍;最后,所有高阶偶次项都需要被忽略。虽然这些条件通常不成立,但精确的作用模型会近似满足它们。
这一分析强调了为了获得能更好地满足原始系统哈密顿量中与动量二次项相关的直观能量均分定理的模型,强制保持辛性(这是定义影子哈密顿量的首要前提)和时间可逆性(它消除了展开式中最成问题的项)的重要性。
S5. 单体轨道#
由于正文中介绍的三体问题的设置可能难以复现,这里我们展示一个更简单版本,其中保结构动力学预测器的优越性能在一个简单得多的环境中得到体现。这个例子涉及一个绕静止质量运动的单体的轨道模拟。机器学习任务极其简单,因为系统时间演化的模型只以一个粒子的坐标和动量为输入。图S1显示,虽然直接预测方法不守恒能量并最终偏离正确轨迹,但保结构方法在长时间内守恒能量并产生稳定的轨迹。
S6. 伦纳德-琼斯氩的分子动力学#
正文中展示的分子动力学例子相对复杂,且/或使用的势函数可能从最常用的分子动力学模拟引擎中不易获得。这里,我们提供了一个特别简单的分子动力学例子,因为它使用了来自广泛可用模拟包LAMMPS [19]的标准势函数(伦纳德-琼斯势)。此外,与正文中研究的系统相比,它只包含一种化学物种,没有使用高级采样技术,并且是在单个热力学状态点生成的轨迹上进行训练。正文中的例子涉及NVT系综中的动力学,这里我们将限制在NVE系综,这在探索性代码中更容易实现。我们相信,这个分子动力学例子可以作为一个极简案例研究,易于复现,同时仍然非常清晰地展示了辛轨迹预测的优势。
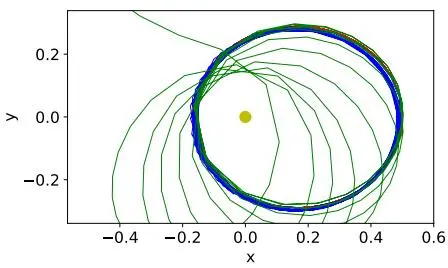
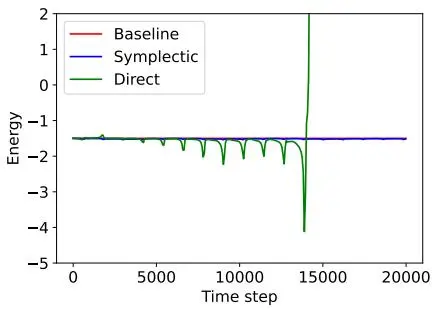
图S1: 对于单体模拟的轨迹(上)和总能量曲线(下)比较:(1) 使用小时间步长的速度Verlet方法得到的基线轨迹,(2) 辛且时间可逆的轨迹预测器,(3) 直接预测器。
我们在使用伦纳德-琼斯势的液态氩的NVE分子动力学轨迹上训练了两个模型。与之前的例子一样,一个神经网络直接预测16 fs时间间隔后的未来位置和动量,而另一个则使用可参数化的辛且时间可逆映射来进行预测。图S2显示,辛方法提供了极好的能量守恒,而直接模型则以非物理的方式迅速加热系统。
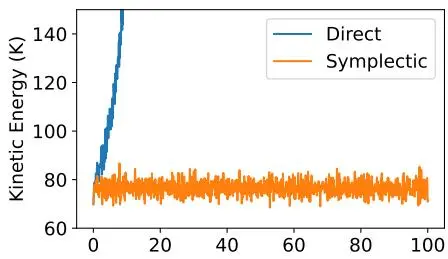
图S2: 使用直接预测模型和辛模型进行的两次液态氩NVE模拟的动能(以K为单位)。
S7. NPT系综中的案例研究#
为了探索NPT系综(除正文中介绍的NVT系综和S6中使用的NVE系综之外)中动力学的可行性,我们使用辛分子动力学预测器在300 K下模拟固态面心立方铝。
我们使用PET-MAD通用原子间势能对铝进行模拟,并训练一个辛神经网络来预测固态和液态的分子动力学轨迹,从而为体相铝创建一个可迁移的分子动力学模型。为了测试模型的物理正确性,我们进行了NPT模拟,记录了平均体积、温度以及执行100 ps模拟所需的时间,分别使用PET-MAD机器学习通用原子间势能和辛模型进行分子动力学预测。这些结果列于表S1,显示辛模型正确再现了可观测量,同时相比于使用机器学习原子间势能的简单分子动力学模拟实现了加速。
| 模拟 | T (K) | $\textrm{V} ( \textrm{\AA}^{3} )$ | 时间 (h) |
|---|---|---|---|
| MLIP | $300.5 \pm 0.9$ | $1782.1 \pm 0.0$ | 1.389 |
| 辛神经网络 | $301.5 \pm 1.2$ | $1783.0 \pm 0.2$ | 0.227 |
表S1: 使用机器学习原子间势能(MLIP)和辛模型对铝进行100 ps NPT模拟的动力学温度、体积和计时。计时在Nvidia H100 GPU上测量。
所提出的方法在实现对所需热力学系综正确采样的同时,与用于水和氩气等经验势能相比并未提供任何加速,因为这些势能的计算成本相对于神经网络非常低廉。然而,如本例所示,所提出的辛方法可以实现在神经网络势能基础上的加速,而神经网络势能在原子建模中使用日益广泛。
S8. 利用辛预测器监控分子动力学质量#
特别是在分子动力学模拟中使用辛积分器时,我们发现模拟质量与其能量守恒程度密切相关。这可以从分子动力学中热力学系综采样的角度来理解,该采样依赖于离散积分器满足的两个性质:
• 刘维尔定理,指出哈密顿流保持相空间体积及其方向不变
• 能量守恒,由哈密顿流精确满足
虽然所有辛方法都满足第一个条件,但在传统数值积分过程中第二个条件只能近似满足,因此在模拟过程中对其进行监控至关重要。观察到给定微观态$( p , q )$的概率为
$$ {\frac{1} {Z}} P ( H ( \pmb{p} , \pmb{q} ) ) d \pmb{p} d \pmb{q} ,\tag{S18} $$其中$P$是一个概率密度函数,依赖于哈密顿量(以及热力学量),并随不同热力学系综而变化;$Z$是配分函数。如果上述两个条件都满足,则有:
- 由第一个条件可得:$d p^{\prime} d q^{\prime} = d p d q$
- 由第二个条件可得:$H ( p^{\prime} , q^{\prime} ) = H ( p , q )$
给定这两个等式,离散化动力学步骤保持了观测到给定微观态的概率不变。因此,它也保持了任何热力学系综的概率分布。
因此,辛方法采样的质量直接与其能量守恒程度相关。这确实是在我们的实验中观察到的现象:当改变不动点迭代的收敛程度时,监测能量守恒是评估可以从动力学中提取的物理可观测量质量的一个非常好的指标。
S9. 模型、训练与模拟细节#
在本节中,我们介绍本研究用于训练模型以及使用模型进行模拟的方法。更多细节,读者可参考 zenodo.org/records/16274506 上的代码。
A. 模型#
1. 单体与三体模拟#
在这些模拟中,我们使用了简单的多层感知器。在单体情况下,我们使用了一个具有SiLU激活函数的简单多层感知器,其尺寸为 [4, 128, 128, 4],用于直接预测位置和动量;尺寸为 [4, 128, 128, 1] 用于预测辛映射。学习三体情况下的动力学使用了相同的架构,多层感知器的形状分别变为直接预测的 [12, 128, 128, 12] 和结构保持预测的 [12, 128, 128, 1]。此外,如正文中所述,结构保持预测经过对称化处理以强制执行时间可逆性。
2. 分子动力学#
对于用于分子动力学的模型,我们使用了FlashMD架构(一种图神经网络),其使用方式与原始论文[4]中直接进行分子动力学预测的方式完全相同,并在结构保持预测的情况下修改为预测单个标量,此时的预测结果还额外进行了对称化处理以强制执行时间可逆性。
B. 数据生成#
1. 单体问题#
我们通过使用速度Verlet算法(时间步长为0.001,共100 000步)模拟单个体绕固定静止质量的轨道运行,来生成用于学习该问题动力学数据。所有质量以及引力常数$G$均设为1。初始条件设置为$q_{x} = 1 / 2 , q_{y} = 1 , p_{x} = 0 , p_{y} = 1$。来自这些轨迹的所有可能的$( ( \boldsymbol{q} , \boldsymbol{p} ) , ( \boldsymbol{q}^{\prime} , \boldsymbol{p}^{\prime} ) )$对(时间相隔64个速度Verlet步长)都被包含在训练集中。
2. 三体问题#
我们通过使用速度Verlet算法(时间步长为0.0001,共200 000步)模拟三个体的运动,来生成用于学习该问题动力学数据。所有质量以及引力常数$G$均设为1。初始条件设置为$q_{1 , x} = 1 , q_{1 , y} = 0 , q_{2 , x} = - 1 / 2 , q_{2 , y} = \sqrt{3} / 2 , q_{3 , x} = - 1 / 2 , q_{3 , y} = - \sqrt{3} / 2 , p_{1 , x} = 0 , p_{1 , y} = 1 / 2 , p_{2 , x} = - \sqrt{3} / 4 , p_{2 , y} = - 1 / 4 , p_{3 , x} = \sqrt{3} / 4 , p_{3 , y} = - 1 / 4$。来自这些轨迹的所有可能的$( ( \mathbf{\nabla} q , p ) , ( \mathbf{\nabla} q^{\prime} , p^{\prime} ) )$对(时间相隔256个速度Verlet步长)都被包含在训练集中。
3. 水#
3. 水#
我们采用i-PI [15]中由q-$\mathrm{T I P 4 P / f}$ 势函数 [11] 在300 K、NVT系综下平衡好的一个结构,并使用室温常压下的实验密度。从这个结构出发,我们缩放所有原子位置和晶胞坐标,分别生成另外两个晶胞体积缩小10%和增大10%的结构。对于这三个结构,以及从20 K到1000 K(含两端)以20 K为步长的所有温度,我们使用朗之万恒温器 [6](时间常数为10 fs,步长为0.5 fs)在NVT系综下运行25 ps的平衡轨迹。随后,对于每个平衡后的结构,我们在NVE系综下使用速度Verlet积分算法 [20] 进行模拟,步长为0.25 fs,模拟时长为2 ps。所有在NVE系综下运行的轨迹都被包含在训练集中,每间隔100 fs取一对$( \pmb q , \pmb p )$,并在$( \boldsymbol{q} , \boldsymbol{p} )$之后2 fs(即8个速度Verlet步长)处取对应的$( \boldsymbol{q}^{\prime} , \boldsymbol{p}^{\prime} )$对。对于非保结构方法,数据集通过每个$( ( \boldsymbol{q} , \boldsymbol{p} ) , ( \boldsymbol{q}^{\prime} , \boldsymbol{p}^{\prime} ) )$训练样本的时间反演版本来扩充。
4. GeTe#
我们从公开数据库 [9] 中选取一个包含总计512个原子的GeTe结构。基于此结构,我们运行两次恒压模拟,使用文献 [8] 中的恒压器:第一次模拟中,温度从100 K线性升至1500 K,持续时间400 ps,使用随机速度再标定 [7] 恒温器(时间常数10 fs,步长4 fs);第二次模拟的轨迹从第一次的最终结构开始,温度在相同时间内从1500 K降至100 K。沿着这两条路径,我们在对应于温度从200 K到1400 K(含两端)以25 K为步长的模拟时刻收集结构。对于这些结构中的每一个,我们使用朗之万恒温器 [6](时间常数10 fs,步长1 fs)在各自温度下的NVT系综中运行50 ps的平衡轨迹。随后,对于每个平衡后的结构,我们在NVE系综下使用速度Verlet积分算法 [20] 进行模拟,步长为1 fs,模拟时长为8 ps。所有在NVE系综下运行的轨迹都被包含在训练集中,每间隔1000 fs取一对$( \boldsymbol{q} , \boldsymbol{p} )$,并在$( \boldsymbol{q} , \boldsymbol{p} )$之后30 fs(即30个速度Verlet步长)处取对应的$( \boldsymbol{q}^{\prime} , \boldsymbol{p}^{\prime} )$对。对于非保结构方法,数据集通过每个$( ( \boldsymbol{q} , \boldsymbol{p} ) , ( \boldsymbol{q}^{\prime} , \boldsymbol{p}^{\prime} ) )$训练样本的时间反演版本来扩充。
5. 氩#
我们使用Lennard-Jones势函数模拟液态氩,参数为$\bar{\epsilon} = 0.01 \bar{03} ~ \mathrm{eV} , \sigma = 3.4 ~ \mathring{\mathrm{A}}$,相互作用截断半径为10 ˚A,模拟软件包为LAMMPS [19]。使用4x4x4的超胞初始化十个模拟,每个单独的面心立方晶胞边长为4.05 ˚A,速度从80 K的麦克斯韦-玻尔兹曼分布中采样。对于每次模拟,在NPT系综下使用1 fs的步长进行100 ps的平衡运行,随后使用速度Verlet算法 [20] 在NVE系综下运行10 ps的轨迹,步长为1 fs。所有在NVE系综下运行的轨迹都被包含在训练集中,每间隔400 fs取一对$( \pmb q , \pmb p )$,并在$( \boldsymbol{q} , \boldsymbol{p} )$之后16 fs(即16个速度Verlet步长)处取对应的$( \boldsymbol{q}^{\prime} , \boldsymbol{p}^{\prime} )$对。对于非保结构方法,数据集通过每个$( ( \boldsymbol{q} , \boldsymbol{p} ) , ( \boldsymbol{q}^{\prime} , \boldsymbol{p}^{\prime} ) )$训练样本的时间反演版本来扩充。
6. 铝#
我们采用面心立方铝结构,其密度为室温常压下的实验密度。基于此结构,我们使用文献[8]中的压浴进行了两次恒压模拟:一次模拟中,温度从100 K线性升高至1500 K,持续1 ns,采用随机速度重缩放[7]恒温器,步长为${2 \ \mathrm{fs}}$;另一次模拟中,温度则从1500 K线性降低至100 K,时间跨度相同。然后,沿着这两条路径,在对应于200 K至1400 K(含两端)温度范围内、步长为25 K的模拟时刻收集结构。对于每个这样的结构,我们在NVT系综中,使用Langevin恒温器[6](时间常数为10 fs,步长为1 fs)在各自温度下运行50 ps的平衡轨迹。随后,对于每个平衡后的结构,我们在NVE系综中使用速度Verlet积分算法[20]进行模拟,步长为1 fs,持续8 ps。所有在NVE系综中运行的轨迹都包含在训练集中,每隔400 fs取一对$( \pmb q , \pmb p )$,并在$( \pmb q , \pmb p )$之后30 fs(即30步速度Verlet步长)取对应的$( \boldsymbol{q}^{\prime} , \boldsymbol{p}^{\prime} )$对。对于非保结构方法,数据集通过每个$( ( \boldsymbol{q} , \boldsymbol{p} ) , ( \bar{\boldsymbol{q}^{\prime}} , \boldsymbol{p}^{\prime} ) )$训练样本的时间反演版本来扩充。
C. 训练#
1. 单体和三体问题#
训练使用Adam优化器[14]进行20个epoch,批次大小为8,初始学习率为0.001,每10000训练步学习率衰减因子为0.7。训练过程中使用旋转增强,即在每个训练步,对批次中的每个训练样本应用一个不同的随机旋转。
2. 分子动力学#
训练使用metatrain包,采用Adam优化器[14]进行800个epoch,初始学习率为$\mathrm{1 {\cdot} 10^{- \bar{4}}}$,当验证指标停滞100个epoch时学习率衰减因子为0.5。训练过程中使用旋转和反演增强,即在每个训练步,对批次中的每个训练样本应用一个不同的随机(可能为不适当的)旋转。
D. 模拟#
1. 单体问题#
使用保结构模型和非保结构模型进行模拟,运行312步,步长为0.064。初始条件设置为$q_{x} = 1 / 2 , q_{y} = 1 , p_{x} = 0 , p_{y} = 1$。
2. 三体问题#
使用保结构模型、非保结构模型以及大步长速度Verlet算法进行模拟,运行4000步,步长为0.0256。初始条件设置为$q_{1 , x} =$ $1 , q_{1 , y} = 0 , q_{2 , x} = - 1 / 2 , q_{2 , y} = \sqrt{3} / 2 , q_{3 , x} = - 1 / 2 , q_{3 , y} =$ $- \sqrt{3} / 2 , p_{1 , x} ~ = ~ 0 , p_{1 , y} ~ = ~ 1 / 2 , p_{2 , x} ~ = ~ - \sqrt{3} / 4 , p_{2 , y} ~ = ~$ $- 1 / 4 , p_{3 , x} = \sqrt{3} / 4 , p_{3 , y} = - 1 / 4$,这是三体问题已知的几个周期解之一。
3. 水#
使用保结构模型和非保结构模型进行模拟,运行100 ps,步长为2 fs。参考MD模拟使用q-TIP4P/f势[11]运行100 ps,步长为0.25 fs。所有模拟均在300 K的NVT系综中进行,采用随机速度重缩放恒温器[7],时间常数为10 fs。
$$ \begin{array} {r l} {\mathit{4} .} & {{} G e T e} \end{array} $$遵循类似参考文献 18 的方案,我们首先在 1000 K 下对液相进行长时间模拟,使用时间常数为 1 fs 的随机速度重缩放恒温器,提取不相关样本作为 4 个独立模拟的起始点。对于每次淬火至 400 K,运行 20 ps,恒温器时间常数为 10 fs,并将最终构型作为 5 条轨迹的起始点,所有轨迹均采用弱恒温,随机速度重缩放时间常数为 1 ps:(1) 使用速度 Verlet 积分器的 4 ns 常规 MD 模拟,时间步长为 4 fs,作为参考;(2) 6 ns 直接 ML 预测轨迹,时间步长为 30 fs;(3-5) 6 ns 保结构 ML 积分器运行,分别使用 4、8、16 次不动点迭代,混合参数为 0.3。
5. 氩#
使用保结构模型和非保结构模型进行模拟,运行 100 ps,步长为 16 fs,不施加恒温器或恒压器。
6. 铝#
使用保结构模型和非保结构模型进行模拟,运行 100 ps,步长为 30 fs。参考 MD 模拟使用 PET-MAD 原子间势 [16] 运行 100 ps,步长为 1 fs。所有模拟均在 300 K 和 1 bar 的 NPT 系综中进行,采用随机速度重缩放恒温器 [7](时间常数为 100 fs)和文献 [8] 中的恒压器(时间常数为 1 ps),其中晶胞自由度与时间常数为 1 ps 的 Langevin 恒温器耦合。
E. 通用模型#
1. 概述#
为了证明本文所述辛结构具有广泛适用性,我们训练了两个用于预测周期表上分子动力学的通用模型:第一个模型训练用于预测 2 fs 的时间步长,第二个用于预测 16 fs 的时间步长。我们在参考文献 [4] 中发布的一组分子动力学轨迹数据集上训练这两个模型,这些轨迹使用 PET-OMATPES-L 通用 r2SCAN 机器学习力场 [5] 生成,该力场本身在 OMat24 [2] 和 MATPES [13] 数据集上训练。我们将这些模型与已发表的 FlashMD 模型进行比较,后者预测相同步长但采用直接方式(即不强制辛结构),并在相同的轨迹数据集上训练。我们在多种化学体系上进行实验:块体铝 (Al)、水 $\mathrm{( H_{2} O )}$、砷化镓 (GaAs)、钛酸钡 $\left( \mathrm{B a T i O_{3}} \right)$、硫代磷酸锂 $\mathrm{( L i_{3} P S_{4} )}$ 以及一种具有高化学多样性的高熵合金 (HEAs)。除了块体,我们还运行了一个模拟来展示模型在平板上的能力。图 S3 的结果表明,单一辛动力学模型可以成功应用于多种不同体系,实现辛结构和能量守恒动力学。
2. 训练细节#
我们使用 metatrain [3] 框架训练辛积分器模型,将 FlashMD 架构调整为输出标量生成函数 $S_{\theta}^{3} ( \bar{q} , \bar{p} )$。虽然原始 FlashMD 直接输出新的相空间坐标,但我们修改了架构,增加了一个标量头,使得能够通过自动微分计算辛更新。具体来说,模型将位置和动量的变化预测为公式 S6 中定义的已学习生成函数的梯度。
为了实现通过双反向自动微分(从标量输出计算更新所需)的稳定训练,我们仔细验证了使用 32 位单精度浮点运算的架构数值稳定性。从 64 位精度切换到 32 位显著降低了内存开销和计算成本,而不会影响模型精度。
此外,使用单精度浮点数使得能够在 FlashMD 训练所用的相同大型数据集上进行训练。这使得两个模型之间可以进行公平比较,并且能够将预训练的 FlashMD 选择作为不动点迭代的初始猜测。
模型通过直接最小化预测更新步长与从参考数据集导出的真实变化之间的平均绝对误差(MAE)进行训练:
其中 $\Delta p , \ \Delta q , \ \bar{p} ,$ 和 $\bar{\pmb q}$ 由训练轨迹计算得到。我们将位置损失项的权重设为 $\lambda_{q} = 50.0$,动量项权重设为 $\lambda_{p} = 1.0$,以补偿尺度差异。我们发现,在我们的目标函数中,$L_{1}$ 损失(MAE)优于 $L_{2}$ 损失(MSE)。
训练采用分布式数据并行策略,在 16 块 NVIDIA H100 GPU 上进行。每台设备使用的批量大小为 16,总共训练 50 个轮次。优化使用 Adam 优化器 [14],学习率为 $1 \times \bar{10}^{- 4}$,并包含占总步数 5% 的线性预热阶段。架构的节点维度为 1024,边特征维度为 256。我们使用了三层 GNN。
3. 模拟细节#
所有模拟均在 300 K 的 NVT 系综中进行。采用随机速度重缩放热浴 [7] 控制温度,时间常数为 $\tau = 100$ fs。在 NVT 模拟中,总能量不守恒,但我们可以通过监测与热浴的热量平衡来计算一个守恒量 [6]。我们使用直接 FlashMD 和辛 FlashMD 在 2 fs 和 16 fs 的时间步长下进行模拟,并将其与参考 MD 轨迹进行比较,参考 MD 轨迹采用极小的 0.25 fs 时间步长计算,以确保尽可能高的精度。MD 模拟中可实际使用的时间步长取决于系统。
在每个积分步中,我们通过不动点迭代数值求解方程 S6。我们将问题重新表述为更新规则 $\bar{\pmb x}_{n + 1} = f ( \bar{\pmb x}_{n} )$,其中状态向量定义为 $\bar{\pmb x}_{n} = \left[ \bar{\pmb q}_{n} \bar{\pmb p}_{n} \right]$。步函数 $f$ 由关系 $\begin{array} {r} {\bar{\pmb q}_{n + 1} = {\pmb q} + \frac{1} {2} \frac{\partial S_{\theta}^{3}} {\partial \bar{\pmb p}_{n}}} \end{array}$ 2 $\begin{array} {r} {\bar{\pmb{p}}_{n + 1} = \pmb{p} - \frac{1} {2} \frac{\partial S_{\theta}^{3}} {\partial \bar{\pmb q}_{n}}} \end{array}$ 定义,其中 $\pmb{p}$ 和 $\pmb q$ 是当前模拟步中已知的坐标。在每一步,我们使用 FlashMD 的预测 $\pmb{x}_{0}^{\prime}$ 作为首次迭代的初始猜测,并据此计算初始中点 $\bar{\mathbf{x}}_{0}$。我们重复不动点迭代,直到连续迭代之间的差值低于预设阈值:$\| \bar{\pmb x}_{n + 1} - \bar{\pmb x}_{n} \| _{2} < \varepsilon .$ 在我们的实验中,确定阈值 $\varepsilon = 1 \times 10^{- 4}$ 能够提供足够的精度。
整个模拟流程通过将 i-PI 通用力引擎与 FlashMD 库中实现的辛求解器进行耦合来实现。
在模拟中,我们验证了守恒能量尽可能接近速度 Verlet 基线。在图 S3 中,我们比较了在 100 ps 轨迹上,速度 Verlet 基线、FlashMD 和我们辛版本的守恒能量。除 16 $\mathrm{fs}$ 的水之外,模拟在 100 ps 的模拟时间内均接近辛基线。
4. 一个病理案例:16 fs 时间步长下的液态水#
从图 S3 可以看出,训练用于预测 16 fs 时间步长的辛通用模型在预测液态水动力学方面失效。这种失效很可能可以用两点作用量 $S ( \pmb q , \pmb q^{\prime} )$ 的焦散来解释。S 型生成函数通过下式定义映射:
$$ {\pmb{p}} = - {\frac{\partial S} {\partial{\pmb q}}} , \qquad{\pmb{p}}^{\prime} = {\frac{\partial S} {\partial{\pmb q}^{\prime}}} .\tag{S19} $$局部上,这要求端点映射 $( p , q ) \to ( q , q^{\prime} )$ 定义良好,而这依赖于 $\pmb{p}$ 作为 $\pmb q^{\prime}$ 函数的雅可比矩阵的可逆性,并因此依赖于混合 Hessian 矩阵的可逆性:
$$ \frac{\partial^{2} S} {\partial \pmb q \partial \pmb q^{\prime}^{\top}} .\tag{S20} $$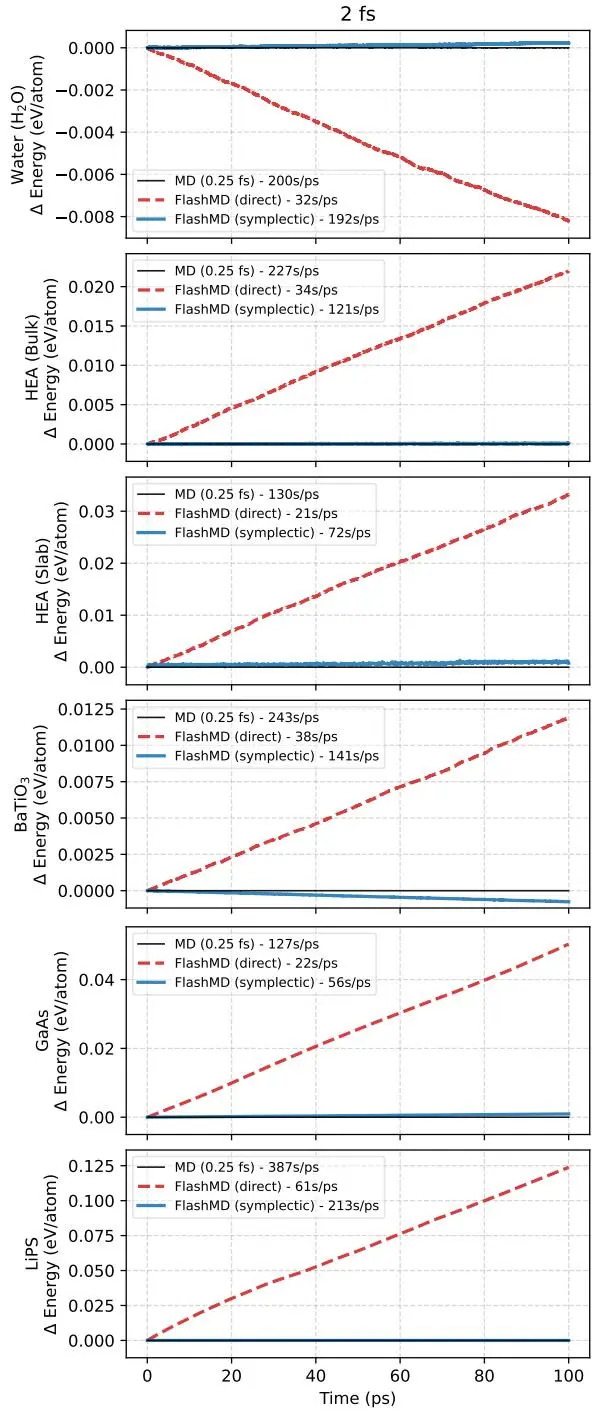
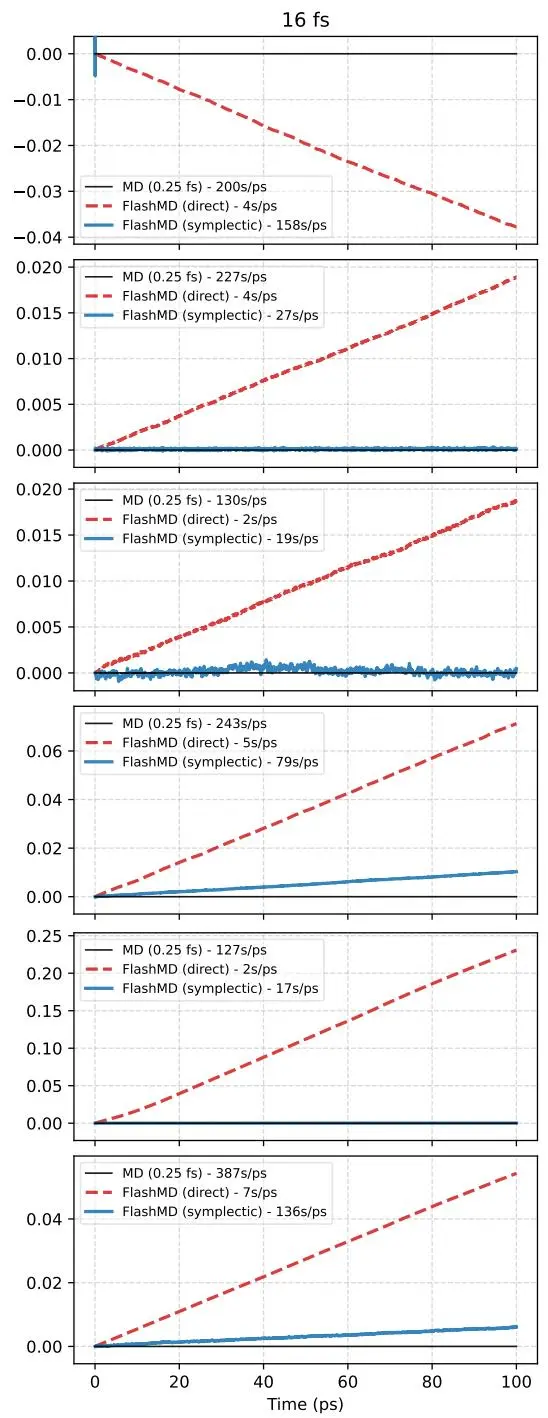
图 S3: 六个材料体系的能量守恒比较。图中展示了每原子守恒能量漂移(∆E)在 100 ps 内的变化,在 20 ps 平衡后归零。左图:2 fs 时间步长,右图:16 fs 时间步长。辛FlashMD(蓝色实线)相比标准FlashMD(红色虚线)表现出更优的稳定性,维持了与 0.25 fs 基线(黑色实线)相当的微小漂移,尤其是在 16 fs 较大时间步长下(除液态水外)。图例中给出了不同模拟方法在单张 NVIDIA H100 上测量的挂钟时间。注意,对于本文所考虑的体系,0.25 fs 是一个过于保守的选择;这些体系更现实的时间步长是:0.5 fs(H₂O)、2 fs(HEA)、2 fs(BTO)、4 fs(GaAs)、1 fs(LiPS)。
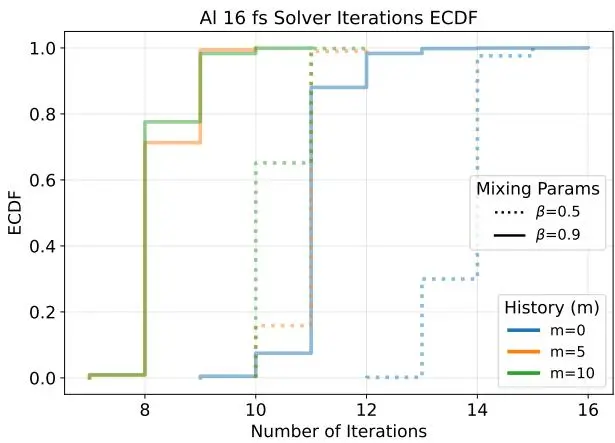
图 S4: 使用 Anderson 加速的求解器迭代达到收敛所需次数的经验累积分布函数(ECDF)。阶跃函数展示了对于不同历史步长(m)和混合参数(β)所观测到的迭代次数。
在焦散点处,该矩阵变得奇异,映射 $( p , q ) \to ( q , q^{\prime} )$ 失去局部可逆性,不同的经典轨迹对应于同一对 $( q , q^{\prime} )$。因此,在焦散点邻域内,$S ( \pmb q , \pmb q^{\prime} )$ 变为多值函数(呈现多个分支)。
在这种类型的状态下,任何作用量的单值参数化都必须隐式地选择或混合分支,从而导致不一致的导数和病态的隐式更新。虽然使用 $S^{3} ( \bar{\pmb{p}} , \bar{\pmb{q}} )$ 相比 $S ( \pmb q , \pmb q^{\prime} )$ 延迟了首个焦散点的出现(如前文在论证选择 $S^{3}$ 时所述),但并未消除它;对于 $h = 16$ fs 的液态水,我们很可能探测到了一个多分支区域,这与观测到的不稳定性一致。在硫代磷酸锂和钛酸钡模拟中观测到的适度能量漂移,或许也是由于采样接近焦散点的区域所致。
F. 加速动力学传播的定常迭代#
为了高效求解隐式辛积分格式中出现的定常方程,我们探索了 Anderson [1] 加速方法。与仅基于当前状态计算下一步更新的标准定常迭代不同,Anderson 加速利用了此前 m 次迭代的历史记录。在每一步,该方法计算这些存储残差的线性组合,以在历史所张成的相空间部分内最小化误差的欧几里得范数。这显著减少了达到指定容差所需的迭代次数。求解器的效率由历史深度(m)和混合参数(β)决定,后者调节更新的步长。
我们尝试了不同的历史步长。如图 S4 所示,增加历史步长通常会提高收敛稳定性,并降低每个时间步的计算成本。在我们的实验中,我们发现历史步长 $m = 5$ 可以使定常求解器快速收敛。将 m 进一步增加到 10 对于预测 2 fs 时间步长适得其反,但有助于在 16 fs 下对诸如 $\mathrm{BaTiO_{3}}$ 这样的大体系进行收敛。
S10. 几何数值积分中有用结果的总结#
1. 辛映射与生成函数之间的对应关系#
我们将报告与生成函数 $S$ 和 ${\bar{S}}^{3}$(使用文献 [12] 的记号)相关的结果,因为这些结果与我们的研究最为直接相关。前者也称为哈密顿主函数、两点作用量、哈密顿-雅可比作用量;后者也称为庞加莱生成函数或中点生成函数。
(文献 [12] 第 6 章,定理 5.1)一个映射 $( p , q ) \rightarrow ( p^{\prime} , q^{\prime} )$ 是辛映射,当且仅当局部存在一个函数 $S ( \pmb q , \pmb q^{\prime} )$,使得
$$ \begin{array} {r} {p^{\prime \top} d \pmb{q}^{\prime} - \pmb{p}^{\top} d \pmb{q} = d S .} \end{array}\tag{S21} $$由此立即得到
$$ \mathbf{\nabla} \pmb{p} = - \frac{\partial S} {\partial \mathbf{q}} , \quad \pmb{p}^{\prime} = \frac{\partial S} {\partial \mathbf{q}^{\prime}} .\tag{S22} $$(文献 [12] 第 6 章,引理 5.2)类似地,如果 $S^{3} = {\bar{p}} \Delta q - S$,则有
并且得到
2. 哈密顿-雅可比方程#
(文献 [12] 第 6 章,定理 5.5)如果 $S ( \pmb q , \pmb q^{\prime} , t )$ 是以下方程的平滑解
$$ \frac{\partial S} {\partial t} + H \Big ( \frac{\partial S} {\partial q^{\prime}} , q^{\prime} \Big ) = 0 ,\tag{S25} $$并且矩阵 $( \partial^{2} S ) / ( \partial q \partial q^{\prime \top} )$ 可逆,则存在一个由 $( p , q ) \rightarrow ( p^{\prime} , q^{\prime} )$ 定义的映射,其中 $\pmb{p} = - \partial S / \partial \pmb{q}$ 且 $\pmb{p}^{\prime} = \partial S / \partial \pmb{q}^{\prime}$,该映射是哈密顿量为 $H ( p , q )$ 的哈密顿系统的流。
为完整起见,我们还报告了 $S^{3} ( \bar{p} , \bar{q} , t )$ 的哈密顿-雅可比方程版本(文献 [12] 第 6 章,定理 5.7):
$$ \frac{\partial S^{3}} {\partial t} = H \bigg ( \bar{p} - \frac{1} {2} \frac{\partial S^{3}} {\partial \bar{q}} , \bar{q} + \frac{1} {2} \frac{\partial S^{3}} {\partial \bar{p}} \bigg ) .\tag{S26} $$3. 修正哈密顿量与辛积分器的长时间行为#
(参考文献[12]第9章,定理8.1,根据当前上下文重新表述和改编) 设 $\mathbf{\nabla}_{p_{t} , q_{t}}$ 为在辛积分器作用下由 $\mathbf{\psi}_{p_{0}} , \mathbf{\psi}_{q_{0}}$ 时间演化给出的动量和坐标。则修正哈密顿量满足 $\tilde{H} ( p_{t} , q_{t} ) = \tilde{H} ( p_{0} , q_{0} ) + \mathcal{O} ( e^{- h_{0} / ( 2 h )} )$ ,其中 $h$ 为积分步长,$h$ 为一个常数;真实哈密顿量满足 $H ( p_{t} , q_{t} ) = H ( p_{0} , q_{0} ) + \mathcal{O} ( h^{p} )$ ,其中 $p$ 为辛方法的阶数,该性质在关于 $1/h$ 的指数级长时间内成立。
(1) D. G. Anderson. Iterative procedures for nonlinear integral equations. J. ACM, 12(4):547–560, Oct. 1965. ISSN 0004-5411. doi:10.1145/321296.321305. URL https://doi.org/10.1145/321296.321305.
(2) L. Barroso-Luque, M. Shuaibi, X. Fu, B. M. Wood, M. Dzamba, M. Gao, A. Rizvi, C. L. Zitnick, and Z. W. Ulissi. Open materials 2024 (omat24) inorganic materials dataset and models, 2024. URL https://arxiv.org/abs/2410.12771.
(3) F. Bigi, J. W. Abbott, P. Loche, A. Mazitov, D. Tisi, M. F. Langer, A. Goscinski, P. Pegolo, S. Chong, R. Goswami, S. Chorna, M. Kellner, M. Ceriotti, and G. Fraux. Metatensor and metatomic: Foundational libraries for interoperable atomistic machine learning, Aug. 2025.
(4) F. Bigi, S. Chong, A. Kristiadi, and M. Ceriotti. Flashmd: long-stride, universal prediction of molecular dynamics. arXiv preprint arXiv:2505.19350, 2025.
(5) F. Bigi, P. Pegolo, A. Mazitov, and M. Ceriotti. Pushing the limits of unconstrained machine-learned interatomic potentials, 2026. URL https://arxiv.org/abs/2601.16195.
(6) G. Bussi and M. Parrinello. Accurate sampling using Langevin dynamics. Physical Review E, 75(5):56707, 2007. doi:10.1103/PhysRevE.75.056707.
(7) G. Bussi, D. Donadio, and M. Parrinello. Canonical sampling through velocity rescaling. Journal of Chemical Physics, 126(1):14101, 2007.
(8) G. Bussi, T. Zykova-Timan, and M. Parrinello. Isothermal-isobaric molecular dynamics using stochastic velocity rescaling. The Journal of chemical physics, 130 (7), 2009.
(9) D. Dangi´c, O. Hellman, S. Fahy, and I. Savi´c. The origin of the lattice thermal conductivity enhancement at the ferroelectric phase transition in gete. npj Computational Materials, 7(1), Apr. 2021. ISSN 2057-3960. doi: 10.1038/s41524-021-00523-7. URL http://dx.doi.org/10.1038/s41524-021-00523-7.
(10) S. Greydanus, M. Dzamba, and J. Yosinski. Hamiltonian neural networks. Advances in neural information processing systems, 32, 2019.
我们注意到,在我们的上下文中,正如在"用辛预测器监控分子动力学质量"中所讨论的,辛演化和近似能量守恒保证了相关热力学系综(在各态历经假设下)的近似定量采样。
water model. The journal of chemical physics, 131(2), 2009.
(12) E. Hairer, C. Lubich, and G. Wanner. Geometric numerical integration. Springer, 2010.
(13) A. D. Kaplan, R. Liu, J. Qi, T. W. Ko, B. Deng, J. Riebesell, G. Ceder, K. A. Persson, and S. P. Ong. A foundational potential energy surface dataset for materials. arXiv preprint arXiv:2503.04070, 2025. doi: 10.48550/arXiv.2503.04070.
(14) D. P. Kingma and J. Ba. Adam: A method for stochastic optimization. arXiv preprint arXiv:1412.6980, 2014.
(15) Y. Litman, V. Kapil, Y. M. Y. Feldman, D. Tisi, T. Beguˇsi´c, K. Fidanyan, G. Fraux, J. Higer, M. Kellner, T. E. Li, E. S. P´os, E. Stocco, G. Trenins, B. Hirshberg, M. Rossi, and M. Ceriotti. I-PI 3.0: A flexible and efficient framework for advanced atomistic simulations. The Journal of Chemical Physics, 161(6):062504, Aug. 2024. ISSN 0021-9606, 1089-7690. doi:10.1063/5.0215869.
(16) A. Mazitov, F. Bigi, M. Kellner, P. Pegolo, D. Tisi, G. Fraux, S. Pozdnyakov, P. Loche, and M. Ceriotti. Pet-mad, a universal interatomic potential for advanced materials modeling. arXiv preprint arXiv:2503.14118, 2025.
(18) G. C. Sosso, G. Miceli, S. Caravati, F. Giberti, J. Behler, and M. Bernasconi. 通过大规模分子动力学模拟实现相变化合物GeTe的快速结晶. The Journal of Physical Chemistry Letters, 4(24):4241–4246, 2013年12月. ISSN 1948-7185, 1948-7185. doi:10.1021/jz402268v.
(19) A. P. Thompson, H. M. Aktulga, R. Berger, D. S. Bolintineanu, W. M. Brown, P. S. Crozier, P. J. In’t Veld, A. Kohlmeyer, S. G. Moore, T. D. Nguyen, 等人. Lammps——用于原子、介观和连续尺度粒子基材料建模的灵活模拟工具. Computer physics communications, 271:108171, 2022.
(20) L. Verlet. 经典流体的计算机“实验”. I. 伦纳德-琼斯分子的热力学性质. Physical Review, 159(1):98–103, 1967年7月. ISSN 0031-899X. doi:10.1103/PhysRev.159.98.
阅读笔记#
一句话概括#
本文用图神经网络学习第三类生成函数 (S^3(\bar{p},\bar{q})) 参数化辛且时间可逆的映射,以大时间步长(8–120 倍于 Velocity Verlet 稳定性极限)传播分子动力学轨迹,并证明这等价于学习系统的哈密顿–雅可比作用量。在三体、液态水(q-TIP4P/f,2 fs)、GeTe 玻璃(PET-MAD,30 fs)及六种通用材料上的验证表明,该方法彻底消除了直接 ML 预测器(如 FlashMD)的能量漂移与温度均分破缺,在 30 fs 步长下仍定量复现径向分布函数、均方位移及类玻璃弛豫等性质。
核心论证链#
- 指出直接 ML 预测的结构缺陷:传统辛积分器步长受稳定性限制(~0.25–4 fs),直接 ML 预测器可将步长放大 10–100 倍 → 但破坏哈密顿几何结构,导致能量不守恒、均分定理失效、采样偏差 → 无法用于严谨科学计算。
- 从辛映射的生成函数理论切入:任何辛映射均可由标量生成函数定义 → 选择对称中点变量形式的第三类生成函数 (S^3(\bar{p},\bar{q})),因为其导出的映射自然等价于隐式中点规则、时间可逆性可通过 (\bar{p}) 偶函数对称化强制(式 5)、首个焦散点出现最晚 → 为 ML 参数化提供物理正确的框架。
- 建立 (S^3) 与作用量的等价性:(S^3) 通过勒让德变换与哈密顿主函数 (S(q,q',h)) 关联(式 7),而 (S) 满足哈密顿–雅可比方程(式 6)→ 学习 (S^3) 等价于从数据中学习系统的作用量 → 若神经网络对步长 (h) 光滑依赖,则离散映射对应某个影子哈密顿量 (\tilde{H}) 的精确流 → 保证长时间能量守恒与正确系综采样。
- 设计可实现的训练‑推理流程:用图神经网络(FlashMD 架构)输出标量 (\tilde{S}^3(\bar{p},\bar{q})) → 训练时直接最小化式(4)给出的 (\Delta p,\Delta q) 与参考值的 MAE 损失 → 推理时通过不动点迭代求解隐式系统,并以直接 FlashMD 的预测作为初值加速收敛(固定 (N_{\text{iter}}=4,8,16) 或按阈值 (\varepsilon=10^{-4}) 自适应停止)→ 混合方法允许用户按精度‑速度需求调节计算量。
- 多尺度案例逐步验证:从简单(单体/三体轨道)到复杂(液态水、GeTe 玻璃、氩 NVE、铝 NPT)逐级加码 → 每个案例中,辛模型均消除能量漂移与温度均分偏差(GeTe 中 Ge/Te 温度差从 ~20 K 降为零),且随 (N_{\text{iter}}) 增加逐步收敛至参考径向分布函数和势能弛豫曲线 → 在 NPT 铝模拟中,辛模型以 30 fs 步长实现与 1 fs PET-MAD MLIP 相同的体积与温度,但挂钟时间快 6 倍。
- 揭示通用性边界:在 6 种材料(Al, H₂O, GaAs, BaTiO₃, Li₃PS₄, HEA)上的通用模型(0.25 fs 基准,2/16 fs 预测)证明方法可跨化学空间迁移 → 但 16 fs 下液态水因 (S^3) 的 Hessian 矩阵奇异(焦散)导致训练/推理病态,映射分支混合产生不连续导数 → 指出该参数化路径的固有拓扑障碍。
实验参数详解#
| 参数 | 数值 | 含义 |
|---|---|---|
| 参考积分器步长(水) | 0.25 fs | Velocity Verlet 生成训练数据的保守步长 |
| 辛模型步长(水) | 2 fs | 8× 参考步长 |
| 辛模型步长(氩 NVE) | 16 fs | 16× 参考步长 (1 fs) |
| 辛模型步长(GeTe) | 30 fs | 30× 参考步长 (1 fs) |
| GeTe 系统大小 | 432 原子 | 过冷态 (T=400\ \mathrm{K}) |
| 训练数据采样间距(水) | 每 100 fs 取一对,预测间距 2 fs | 即相隔 8 参考步 |
| 训练数据采样间距(GeTe) | 每 1000 fs 取一对,预测间距 30 fs | 相隔 30 参考步 |
| 训练数据采样间距(氩) | 每 400 fs 取一对,预测间距 16 fs | 相隔 16 参考步 |
| 不动点迭代收敛阈值 (\varepsilon) | (1\times10^{-4}) | 中点变量差值的 (L_2) 范数 |
| Anderson 加速历史深度 (m) | 5 | 效果最佳,16 fs 大体系可增至 10 |
| Anderson 加速混合参数 (\beta) | 0.3 | 调节更新步长 |
| 神经网络(单体/三体) | MLP [128,128] | 2 层 SiLU 激活 |
| 图神经网络(分子动力学) | 节点 1024,边 256,3 层 GNN | 单精度浮点(32-bit),16 H100 训练 |
| 水温训练范围 | 20–1000 K,步长 20 K | 含密度 90%–110% 实验密度 |
| GeTe 温度训练范围 | 200–1400 K,步长 25 K | 沿升温-淬火循环收集 |
| 铝 NPT 模拟时长 | 100 ps | H100: 辛模型 0.227 h vs MLIP 1.389 h |
| 通用模型训练轮次 | 50 epochs | 每设备 batch size 16 |
| 通用模型步长预测 | 2 fs 与 16 fs | 基准 0.25 fs |
批判性思考#
1. 隐式求解的双重计算成本未被充分量化解耦:每一步需 (N_{\text{iter}}) 次前向‑反向传播,图 S3 显示 16 fs 下辛模型挂钟时间仅比直接 FlashMD 快约 2 倍而非 8 倍(Li₃PS₄ 等)。论文未分解 (N_{\text{iter}}) 与体系大小 (N) 对成本的耦合标度——对 (N>10^4) 的大型体系,迭代开销可能完全抵消步长放大收益。
2. 焦散(caustic)是 (S^3) 参数化的拓扑障碍而非工程可调参数:16 fs 液态水在 300 K 下的失效并非偶然——焦散出现在混合 Hessian (\partial^2S/\partial q\partial q'^\top) 奇异处,任何单值神经网络必然在此邻域内导数不连续。论文仅指出“延迟”而非“消除”焦散,未讨论如何检测或回避焦散区域(如自适应步长或分支选择策略)。
3. 有限次不动点迭代后的映射不严格保持辛结构:以非辛初值(直接 FlashMD)启动,经固定 (N_{\text{iter}}=4,8,16) 次迭代不保证收敛至真解。论文未提供 (|x_{n+1}-x_n|) 与影子哈密顿量阶数之间的定量关系,也未证明残余的非辛分量在纳秒级累计中不会放大——阈值 (\varepsilon=10^{-4}) 仅为工程设定,缺乏理论支撑。
4. 均分恢复的定量机制分析不足:S4 节通过影子哈密顿量的动量展开解释了均分偏差的来源,但仅给出“偶函数对称化消除奇次项”的定性论证。未给出预测的 (\langle p_i^2\rangle) 偏差与 (N_{\text{iter}})、步长 (h) 之间的标度律,也无公式联系影子哈密顿量中 (O(p^4)) 项系数与残余温度偏差(如 GeTe 中 ~20 K)的大小。
5. 训练数据生成成本在实用场景中可能占主导:辛模型仍需以极小步长(0.25–1 fs)运行短参考轨迹生成配对数据。对于第一性原理 MD(如 DFT 精度),生成这些参考数据的计算时间可能远超推理阶段的加速收益。论文未讨论“训练数据成本‑推理加速”的全局盈亏点分析。
6. 缺少与哈密顿神经网络(HNN)的定量对比:论文引用了 Greydanus et al. (2019) 学习 (H(p,q)) 的 HNN 方法,但未实验对比。HNN 学得哈密顿量后仍需小步长辛积分器传播(因为 (S^3\approx hH) 的大 (h) 近似失效),而本文直接学习 (S^3) 可容忍大 (h)——这一步长优势的具体倍数和精度损失曲线应量化呈现,以便社区判断实用价值。
7. 固定步长假设与标准 MD 实践脱节:所有实验采用固定时间步长,而实际 MD 中不同区域(键伸缩 vs 自由平动)最优步长可差 10–100 倍。传统积分器常结合变步长策略;本文 (S^3) 虽将 (h) 作为网络输入,但未探索变步长预测的实现,也未见讨论如何在该框架下处理步长切换时的累积误差。
局限性#
- 焦散限制(caustic barrier):16 fs 步长下液态水(300 K, q-TIP4P/f)因 (S^3) 的混合 Hessian 奇异导致多值分支混合,训练和推理均病态——这是单值参数化路径的拓扑固有障碍,并非工程改进可以彻底消除,仅能通过缩短步长或更换生成函数类型来规避。
- 隐式迭代的计算开销与规模限制:每步需 (N_{\text{iter}}) 次反向传播计算 (\partial S^3/\partial\bar{p}) 和 (\partial S^3/\partial\bar{q}),对于 >10³ 原子、>ns 的模拟,迭代成本可能完全抵消步长放大的加速;论文未报告不同系统在 >100 ps 模拟中的实际加速比衰减曲线。
- 训练数据的参考积分器依赖:所有参考轨迹由 Velocity Verlet 生成,该积分器仅对可分哈密顿量显式。若系统含不可分项(如磁场、约束动力学),需改用隐式中点法生成参考数据,这会大幅增加数据生成的计算复杂度与内存开销。
- 有限次迭代不保证严格辛性:(N_{\text{iter}}=16) 时残余误差 (O(10^{-4})) 对应的映射分量非严格辛,其长时间累计是否会导致纳秒级能量漂移——论文仅展示 GeTe 中 6 ns 轨迹无漂移,未做更长时间(>100 ns)或更大步长(>30 fs)的压力测试。
- 均分偏差存在不可消除的残余:影子哈密顿量中 (O(p^4)) 及更高阶偶次项(来自展开式 S17 的 (\mathbf{C}_2$\mathbf{q}$) 的空间依赖性)导致不同自由度及不同原子类型间的温度分解存在小但非零的偏差(GeTe 中约 20 K),论文未提出消除这些高阶项的修正策略。
- 通用模型训练成本极高:需 16 块 H100 GPU、大规模数据集(与 FlashMD 相同)、50 个 epoch,论文未报告具体训练挂钟时间,也未比较辛模型与直接预测模型在收敛速度和最终损失上的差异——辛模型的标量输出可能比向量输出更容易拟合,但缺乏实证。
- 迁移性验证不完整:未测试对未包含在训练中的系统大小(外推至更大超胞)、不同力场精度(如从 r2SCAN 迁移至 PBE0)或非平衡工况(剪切、冲击)的迁移能力——辛结构保持仅约束积分器几何,不补偿势函数本身的误差。
- 与随机热浴/压浴耦合的理论分析缺失:NPT 模拟中加入了随机恒温器与恒压器,但论文未证明辛映射与随机过程耦合后的整体动力学仍满足正确的稳态分布(即修正的刘维尔‑主方程解与目标 NPT 分布一致)。
关键公式速查#
- [ \frac{d\mathbf{p}}{dt} = -\frac{\partial H}{\partial\mathbf{q}},\quad \frac{d\mathbf{q}}{dt} = \frac{\partial H}{\partial\mathbf{p}} ] — 哈密顿运动方程,式 (1)
- [ \Delta\mathbf{p} = -\frac{\partial S^3}{\partial\bar{\mathbf{q}}},\quad \Delta\mathbf{q} = \frac{\partial S^3}{\partial\bar{\mathbf{p}}} ] — 第三类生成函数 (S^3) 定义的辛映射,式 (4)
- [ \tilde{S}^3(\bar{p},\bar{q}) \leftarrow \frac{\tilde{S}^3(\bar{p},\bar{q}) + \tilde{S}^3(-\bar{p},\bar{q})}{2} ] — 对 (\bar{p}) 的偶函数对称化强制时间可逆性,式 (5)
- [ -\frac{\partial S}{\partial h} = H\left(\frac{\partial S}{\partial q'}, q'\right) ] — 哈密顿–雅可比方程(主函数 (S(q,q',h)) 满足),式 (6)
- [ \mathcal{S}^3(\bar{p},\bar{q},h) = \bar{p}(h)\cdot\Delta q(h) - \mathcal{S}(\mathbf{q},q',h) ] — (S^3) 与主函数 (S) 的勒让德变换关系,式 (7)
- [ S^3(\bar{p},\bar{q},h) \approx h H(\bar{p},\bar{q}) ] — 隐式中点法的首阶近似(小步长极限),式 (S11)
- [ S^3(\bar{p},\bar{q},h) = \frac{2}{\omega}\tan\left(\frac{\omega h}{2}\right) H(\bar{p},\bar{q}) ] — 一维谐振子的精确 (S^3)(解析解),式 (S12)
- [ \left\langle x_m \frac{\partial \tilde{H}}{\partial x_n} \right\rangle = \delta_{mn} k_B T ] — 影子哈密顿量下的能量均分定理,式 (S13)
- [ p^{\prime\top} d\mathbf{q}' - \mathbf{p}^\top d\mathbf{q} = dS ] — 辛映射与生成函数 (S(q,q')) 的微分形式对应关系,式 (S21)
术语对照#
| 中文 | 英文 | 含义 |
|---|---|---|
| 生成函数 | generating function | 标量函数,其偏导数定义辛映射;本文选用第三类 (S^3(\bar{p},\bar{q})) |
| 第三类生成函数 | type-3 generating function | 以中点变量 ((\bar{p},\bar{q})) 为自变量,导出隐式中点法等价映射 |
| 哈密顿–雅可比作用量 | Hamilton–Jacobi action / principal function | 满足哈密顿–雅可比方程的主函数 (S(q,q',h)),对应于物理作用量 |
| 影子哈密顿量 | shadow Hamiltonian | 离散积分器精确满足的修正哈密顿量 (\tilde{H}),与实际哈密顿量指数级接近 |
| 辛映射 | symplectic map | 保持辛形式 (\omega=dp\wedge dq) 的微分同胚,保证刘维尔定理 |
| 不动点迭代 | fixed-point iteration | 求解隐式方程 (\bar{x}=f(\bar{x})) 的迭代法;本文求解 (S^3) 定义的隐式系统 |
| 安德森加速 | Anderson acceleration | 利用历史残差线性组合加速定常迭代收敛的算法 |
| 焦散 | caustic | 生成函数的混合 Hessian 奇异,映射失去局部可逆性,多分支混合 |
| 均分定理 | equipartition theorem | 正则系综中每个二次型自由度平均动能为 (\frac12 k_BT) |
| 刘维尔定理 | Liouville's theorem | 哈密顿流保相空间体积元 (dp,dq) |
| q-TIP4P/f | q-TIP4P/f | 柔性四站点水模型,本文的液态水参考势函数 |
| PET-MAD | PET-MAD | 通用机器学习原子间势,用于 GeTe 和 Al 模拟 |
| FlashMD | FlashMD | 基于图神经网络的长步长 MD 直接预测架构;本文改为输出标量 (S^3) |
| 哈密顿神经网络 | Hamiltonian Neural Networks (HNN) | 学习哈密顿量 (H(p,q)) 的神经网络方法,需再接小步长积分器 |
深入:为什么学习 (S^3) 等价于学习作用量——以及这为何保证长时间能量守恒#
直接将神经网络的输出解释为映射的“更新量”会导致训练难以收敛,而本文把问题重新框架为“学一个标量函数”带来两个根本优势。
第一,勒让德变换连接生成函数与作用量。 由分析力学,哈密顿主函数 (S(q,q',h))(即作用量)满足哈密顿–雅可比方程 (6)。第三类生成函数 (S^3(\bar{p},\bar{q},h)) 与 (S) 通过式 (7) 的勒让德变换关联:(S^3 = \bar{p}\cdot\Delta q - S)。因此,一旦训练数据中的映射来自真实的哈密顿流,学习 (S^3) 就等效于从数据中重建作用量函数。这不是一个任意的函数拟合——神经网络被强制学习一个满足(或近似满足)哈密顿–雅可比方程的标量函数。
第二,作用量的光滑性导出影子哈密顿量。 传统辛积分器(如 Verlet)构造一个人工的生成函数,其泰勒展开的首项是 (hH),高阶项是误差。而本文的神经网络 (\tilde{S}^3) 如果在拟合中捕获了 (S^3) 对 (h) 的真实依赖关系(光滑、无穷可微),那么由该 (\tilde{S}^3) 定义的离散映射必然对应某个哈密顿系统——即存在影子哈密顿量 (\tilde{H})。这个 (\tilde{H}) 不是人为截断的近似,而是从数据中隐式学出的精确量。因此,(\tilde{H}) 的在长时间内的守恒性由辛映射的几何性质保证(指数级而非幂级数),而不是依赖小步长假设。
对比学习哈密顿量 (H(p,q)) 再接小步长积分器的方案(HNN):后者的传播等价于用 (S^3 \approx hH) 近似式 (S11),该近似仅在 (h) 很小时成立——谐振子精确解式 (S12) 清楚显示,当 (h) 接近半周期时 (\tan(\omega h/2)) 发散。本文学的是精确 (S^3),故步长不再受此近似限制。
延伸阅读#
- 理论基础:Hairer, Lubich & Wanner, Geometric Numerical Integration (Springer 2010) — 本文生成函数、辛积分器与影子哈密顿量理论的系统来源。
- 直接 ML 预测方法对比:Bigi et al., "FlashMD: long-stride, universal prediction of molecular dynamics" (arXiv:2505.19350) — 本文的直接预测基线,无结构保持。
- 哈密顿神经网络:Greydanus et al., "Hamiltonian neural networks" (NeurIPS 2019) — 学习哈密顿量接小步长辛积分器的替代路线。
- 通用机器学习力场:Mazitov et al., "PET-MAD, a universal interatomic potential" (arXiv:2503.14118) — 本文在 GeTe 和 Al 案例中使用的参考势函数。