张量网络方法#
Timo Felser and Simone Montangero
在本章中,我们介绍张量网络方法的核心概念:首先在第5.1节中定义张量本身,以及用于其操作的最常见运算(第5.2节),作为基本构建块。在此基础上,第5.3节引入了张量网络态的原理,并阐述了最突出的张量网络几何结构。接着,我们介绍了一些最成功的算法,这些算法利用张量网络来研究多体问题(第5.4节)。尽管所介绍的材料远未涵盖该领域快速增长的文献,但它为进入张量网络方法领域奠定了坚实的起点。我们在第5.6节中以快速概述和指向最近开发的、旨在超越我们模拟多体量子系统能力的进一步张量网络方法的文献作为本章的结束。
值得一提的是,本章为张量网络方法的基础理解提供了全面的介绍,而本章中选定的主题将在本书后续章节中,以更技术性的细节讨论实际实现和各种具体应用。
5.1 张量与张量运算#
5.1.1 张量定义与图形表示#
我们首先介绍我们将使用的张量的定义和图形表示,以及对其进行操作的标准运算。
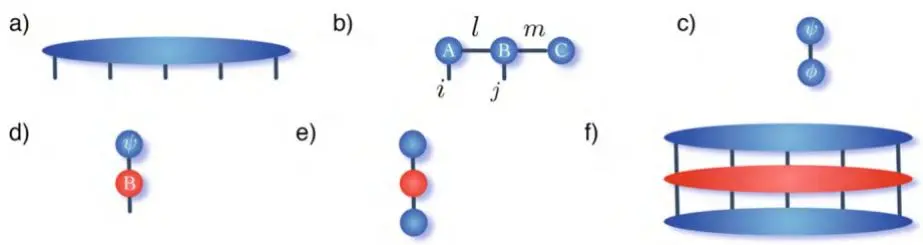
图5.1 张量图形表示:(a) 一个n阶张量。(b) 一个由三个张量组成的张量网络,其张量缩并等价于式(5.5)。(c) 波函数标量积$\langle\varphi|\psi \rangle$。(d) 算子$\hat{B}$作用于波函数$\psi .$。(e) 由蓝色张量编码的波函数所表示的状态的可观测量的期望值(红色张量)。(f) 同(e),但针对一个N体波函数
定义5.1(张量) 一个张量$\mathcal{T} \in C^{d_{1} \times d_{2} \times \cdots \times d_{N}}$是一个N维数组,具有N个指标,通常形式为
$$ \mathcal{T}_{\alpha_{1} , \dots , \alpha_{N}} ,\tag{5.1} $$如图5.1a所示。张量的指标数N也指其阶或秩。
计算上,单个张量$\mathcal{T}$可视为线性代数中向量和矩阵的推广。事实上,向量等价于一阶张量(秩1张量),其元素仅由一个指标$i_{1}$访问。此外,矩阵构成二阶张量(秩2张量),分别用两个指标$i_{1}$和$i_{2}$表示行和列。类似地,三阶张量可视为一个三维数字立方体,每个维度对应一个指标。这种信息表示的概念可推广至任意高阶张量。下表5.1列出了低阶张量的常见名称及典型示例。
为简洁起见,张量网络引入了数学张量符号的图形表示:我们用圆圈(或类似的封闭图形)表示张量,用线或链接表示指标,这些线可以连接两个张量。连接两个不同张量的每条链接表示对匹配指标的缩并,详见第5.2.1节。
表5.1 不同N阶张量的定义
| 名称 | 示例 | 阶 | 记法 |
| 标量 | 常数 | 0 | λ |
| 向量 | 波函数 | 1 | $\psi_{i}$ |
| 矩阵 | 算子 | 2 | $O_{i , j}$ |
| ·.· | . | .·· | |
| N阶张量 | N体波函数 | N | $\psi_{\alpha_{1} , \dots , \alpha_{N}}$ |
5.1.2 特殊张量#
在实际应用中,张量网络使用或包含满足特定数学约束的特殊张量。在各种张量网络计算中常用的主要有等距张量(isometry)和解纠缠张量(disentangler),它们可视为酉矩阵到高阶张量的推广。
5.1.2.1 等距张量#
等距张量广泛应用于大量张量网络计算中,对于许多张量网络几何结构而言,它是确保高效实现的关键。与酉矩阵$U$满足$U U^{\dagger} = \mathbb{1}$类似,等距张量$U$与其复共轭缩并后得到单位矩阵:
$$ \sum_{\{i_{r} \} \backslash i_{k}} ( \mathcal{T} )_{i_{1} , \dots , i_{R}} ( \mathcal{T}^{\dagger} )_{i_{1}^{\prime} , \dots , i_{R}^{\prime}} = \delta_{i_{k} , i_{k}^{\prime}} .\tag{5.2} $$此时,该张量是关于链接$i_{k}$的等距张量。一般而言,张量网络中的任意张量可通过执行QR分解(详见第5.2.4节)来面向某个链接$i_{k}$甚至一组链接$\{i_{k} \}$进行等距化。此外,我们将在第8章中详细看到,树张量网络(Tree Tensor Network)经常使用三阶等距张量$\mathcal{T}_{[ i_{1} , i_{2} , i_{3} ]}$以实现高效计算。
5.1.2.2 解纠缠张量#
与之相反,解纠缠张量是一种特殊的四阶等距张量。事实上,解纠缠张量$u$可视为酉矩阵$U$到四阶张量的推广,满足酉性条件:
$$ \sum_{i_{3} , i_{4}} ( u )_{i_{3} , i_{4}}^{i_{1} , i_{2}} ( u^{\dagger} )_{i_{1}^{\prime} , i_{2}^{\prime}}^{i_{3} , i_{4}} = \delta_{i_{1} , i_{1}^{\prime}} \delta_{i_{2} , i_{2}^{\prime}} .\tag{5.3} $$因此,解纠缠张量 $u_{k}$ 对两个链接 $i_{1}$ 和 $i_{2}$ 执行酉操作。这一特定的等距张量是一些张量网络几何结构的关键元素,例如我们将在第 5.3 节中展示的 MERA [147,148],以及在第九章中详细解释的 aTTN [149,150]。在这两种应用中,这些解纠缠张量的目的是在量子系统计算中局部解耦或解纠缠相关的自由度。
5.2 张量操作#
在本节中,我们介绍张量的基本操作,这些操作在本书的后续部分中需要忠实且高效地描述感兴趣的物理系统:它们允许我们操作、压缩和变换张量网络内张量的条目。
5.2.1 张量收缩#
张量收缩是对张量的最基本操作之一,尤其是因为每个张量网络通常是由不同张量通过不同索引的收缩连接而成的网络(更多细节见第 5.3 节)。作为标准矩阵-矩阵乘法的自然推广,张量收缩对两个张量的重合索引求和,遵循以下方式:
$$ C_{l , n} = \sum_{m} A_{l , m} B_{m , n} \equiv A_{l , m} B_{m , n}\tag{5.4} $$其中,在最右边的等式中,我们引入了爱因斯坦(Einstein)求和约定:重复索引隐式求和。张量代数与矩阵乘法的关键区别在于,方程 (5.4) 中的每个张量 A、B 和 C 现在可能附着多个索引,因此 $l ~ = ~ ( l_{1} , . . . , l_{\lambda} ) , m ~ = ~ ( m_{1} , . . . , m_{\mu} )$ 且 $n = ( n_{1} , . . . , n_{\nu} )$。因此,在这种张量代数中,矩阵乘法是两个秩为2的张量在单个重合链接 m 上的特殊张量收缩。此外,图 5.1b 中描绘的收缩等价于:
$$ \sum_{l , m} A_{i , l} B_{l , j , m} C_{m} \equiv A_{i , l} B_{l , j , m} C_{m} .\tag{5.5} $$这里的结果是一个具有两个索引的张量(一个矩阵),因为其他索引都已被收缩。类似地,两个波函数之间标量积的计算,即:
$$ \langle \phi | \psi \rangle = \sum_{i} \phi_{i}^{*} \psi_{i} = \phi_{i}^{*} \psi_{i} ,\tag{5.6} $$可以如图 5.1c 所示来描绘,其中我们引入了约定:索引朝上的张量是相同张量索引朝下的伴随(adjoint)。注意,生成的对象没有索引(所有索引都被收缩),因此它是一个标量,这是理所应当的。算子对波函数的应用以及期望值的计算分别类似地描绘在图 5.1d 和 e 中。同样,可以通过计算最终自由索引的数量来检验结果的正确性:它应与计算量的预期结果匹配。注意,计算以乘积基 $( | \alpha_{1} \rangle \otimes | \alpha_{2} \rangle \otimes \cdot \cdot \cdot \otimes | \alpha_{N} \rangle )$ 写出的 N 体波函数的标量积与方程 (5.6) 所示并无不同。实际上,在这种情况下,我们有:
$$ \langle \phi_{N} | \psi_{N} \rangle = \phi_{\alpha_{1} , \dots , \alpha_{N}}^{*} \psi_{\alpha_{1} , \dots , \alpha_{N}} = \phi_{\mathbf{i}}^{*} \psi_{\mathbf{i}} ,\tag{5.7} $$其中,我们引入了全局或融合索引(global or fused index)的概念,即分组和拆分索引的操作(将在下一节介绍)。最后,可以将算子操作重铸为类似形式,例如,能量期望值的计算可以明确写为:
$$ \langle \psi_{N} | \hat{H} | \psi_{N} \rangle = \psi^{* \beta_{1} , \hdots , \beta_{N}} H_{\beta_{1} , \hdots , \beta_{N}}^{\alpha_{1} , \hdots , \alpha_{N}} \psi_{\alpha_{1} , \hdots , \alpha_{N}} = \psi^{* \mathbf{i}} H_{\mathbf{i}}^{\mathbf{j}} \psi_{\mathbf{j}} .\tag{5.8} $$这里我们引入上标(上标)和下标(下标)的概念,是为了表述的紧凑性,并与图5.1f中的连接方向保持一致。
5.2.2 张量收缩的计算复杂度#
下面,我们将更详细地展示张量收缩的计算成本,以及为什么始终要使用秩最小的张量。实际上,从图5.1c所示并由式(5.6)定义的波函数标量积出发,不难看出其计算需要 $O ( m )$ 次操作,其中 $m$ 是波函数所在的希尔伯特空间的维数,也就是指标 $j$ 的维数。图5.1b所示并由式(5.5)表示的收缩稍微复杂一些。简单的检查就能得出计算它所需的操作次数:对于结果矩阵的每个元素(两个自由指标),需要计算两个嵌套求和,总的操作次数为 $O ( m^{4} )$(假设所有指标的维数都是 $m$)。从这些例子中,我们可以更容易地归纳出一个通用规则,用于计算执行张量网络收缩所需的操作次数:收缩复杂度由自由指标维数与收缩指标维数的乘积给出。事实上,自由指标的乘积给出了需要计算的结果张量的系数个数,而收缩指标维数的乘积则给出了计算每个系数所需操作次数的量级。需要指出的是,尽管这个估算对于指导算法开发非常有用,但实际上它只给出了收缩复杂度的量级估计。因为,可以通过使用先进的线性代数操作算法(例如,用于矩阵-矩阵操作的分治策略[124])来降低它:例如,用于矩阵-矩阵乘法的Strassen算法提供了近似 $O \big ( n^{2.8} \big )$ 的复杂度,而不是 $O ( n^{3} )$ [151]。
总之,上述规则导致对任意 $N$ 体波函数执行任何操作都具有指数级的算法复杂度。实际上,式(5.7)中标量积的计算复杂度为 $O \big ( m^{N} \big )$,无论它是作为两个秩为 $N$ 的张量的收缩执行,还是被视为两个秩为1的张量的收缩(在后一种情况下,收缩指标的维数是 $m^{N} )$)。正如我们将在后续章节,特别是在第7.1.3节中看到的,张量网络的引入在许多情况下将收缩复杂度从指数级降低为多项式函数,从而使得操作由数百个格点组成的系统的 $N$ 体波函数成为可能。
5.2.3 指标融合与分裂#
张量不过是一种组织信息的有结构方式,即一个有序的数字或变量集合。例如,为了描述三维相对论系统,四个时空变量 $x, y, z$ 和 $t$ 通常被组织成一个单一的向量,以提高我们的表示和操作能力。但是,如果更方便的话,也可以将它们排列成一个 $2 \times 2$ 的矩阵。正如我们将看到的,将向量转化为矩阵以及该操作的推广,在各种场景中都非常有用。通常,一个秩为 $n$ 的张量可以按照某种给定的(可逆)规则重新排列成不同秩的张量:在上述例子中,有
$$ X_{i} = {\left( \begin{array} {l} {x} \\ {y} \\ {z} \\ {t} \end{array} \right)} \Leftrightarrow O_{j , k} = {\left( \begin{array} {l} {x} \\ {z} \\ {z} \end{array} \right)} ;\tag{5.9} $$这里我们改变了组织感兴趣变量的方式,并且没有丢失任何信息。显然,作用于这些对象的操作也必须相应地改变。式(5.9)中执行的变换,如果应用于波函数,则称为 Liouville 表示,更正式地,称为 Choi-Jamiolkowski 同构(Choi-Jamiolkowski isomorphism)[152–157]。注意,在将矩阵变换为向量的过程中,我们将两个指标融合为一个指标。这种指标融合操作可以推广到任意数量的指标,简单表示为
$$ \alpha_{1} \ldots \alpha_{n} \equiv \mathrm{d} - \mathrm{coding} ( \mathbf{i} ) ;\tag{5.10} $$其中 $\alpha_{i} = 1 , 2 , \ldots , d$,变换由全局指标 i 的 d 进制编码给出。从现在起,我们将融合操作表示为 $\alpha_{1} \ldots \alpha_{n} \succ \mathbf{i}$;其逆操作是指标分裂(index splitting),即 $\mathbf{i} \prec \alpha_{1} \ldots . \alpha_{n}$。最后,注意根据上述定义,式 (5.7) 中的最后一个等式自动成立;类似地,图5.1e 和 f 中图形表示之间的关系,就是将全部指标融合为单一指标的操作。
5.2.4 因子化与压缩#
融合操作允许我们将任意 n 阶张量重新表示为矩阵形式。事实上,总可以选取 n 个指标的一个二分法,将其分为两个不相交的组,并将每组中的指标融合在一起,即:
$$ T_{\alpha_{1} , \dots , \alpha_{N}} \equiv T_{\mathbf{i} , \mathbf{j}} ,\tag{5.11} $$其中 $\{\alpha_{k} , \alpha_{j} , . . . \alpha_{l} \} \ \sim \ {\bf i} , \ \{\alpha_{m} , \alpha_{n} , . . . \alpha_{p} \} \ \sim \ {\bf j}$,且 $\{\alpha_{k} , \alpha_{j} . . . \alpha_{l} \} \cup \{\alpha_{m} , \alpha_{n} . . . \alpha_{p} \}$ $= \{\alpha_{1} , \alpha_{2} , \ldots , \alpha_{N} \}$。由于张量现在被重新表示为矩阵形式,我们可以充分利用作用于矩阵的线性代数运算的潜力。
这使得我们能够利用线性代数运算(例如奇异值分解(SVD)或 QR 分解)将给定张量因子化或分解。因此,为了正确地将张量因子化,我们将其变换为矩阵,分解该矩阵,随后将之前融合的联接重新分裂回其原始形式。这里,QR 分解不仅可用于分解张量,也是创建等距(isometry)的便捷工具。由于它将 $T_{\mathbf{i , j}} = Q_{\mathbf{i , k}} R_{k , j}$ 分解,其中 Q 是满足 $Q^{\dagger} Q = \mathbb{1}$ 的正交矩阵,因此在将指标 i 分裂回后,所得张量 $Q_{\alpha_{1} , \dots , \alpha_{N}}$ 成为一个等距,并满足式 (5.2) 的幺正条件。
另一方面,SVD——作为矩阵对角化的推广——是张量网络实际应用中的关键工具。它允许在无环网络(如第8章将详细描述的 TTN)中计算纠缠性质。此外,SVD 可用于有效地压缩一个张量甚至整个张量网络,如下文所述。事实上,给定张量 $T_{\mathbf{i , j}}$,总可通过 SVD 将其分解为三个张量,即:
$$ T_{\mathbf{i} , \mathbf{j}} = \sum_{\mathbf{k} = 1}^{d^{N}} S_{\mathbf{i} , \mathbf{k}} V_{\mathbf{k} , \mathbf{k}} D_{\mathbf{k} , \mathbf{j}} ,\tag{5.12} $$其中 V 是对角且正定的实矩阵,而 S 和 D 是幺正矩阵。张量 V 的对角元素 $V_{j , j} \equiv \lambda_{j}$ 是 T 的奇异值,它们是实正数,并以零为下界,因此可以排序。从现在起,我们假设它们按照降序排列,即 $V_{1 , 1} \equiv \lambda_{1} > V_{2 , 2} \equiv \lambda_{2} > V_{3 , 3} \equiv \lambda_{3} \cdot \cdot \cdot > 0$。张量网络算法中的一个核心作用是:如果 $\lambda_{j} < \epsilon , \forall j > z$,则可以忽略某些奇异值 $\lambda_{j}$。也就是说,每当奇异值衰减得足够快(或在某个给定值 $\lambda_{z} = 0$ 之后精确为零)时,我们可以将其忽略。相应地,矩阵 S, V 可被截断。这种缩减会引入表示原始张量 $T_{\mathbf{i} , \mathbf{j}}$ 的误差,该误差可估算为:
$$ | | T_{\mathbf{i} , \mathbf{j}} - \sum_{\mathbf{k} = 1}^{\mathbf{m}} S_{\mathbf{i} , \mathbf{k}} \lambda_{\mathbf{k}} D_{\mathbf{k} , \mathbf{j}} | | = | | \sum_{\mathbf{k} = \mathbf{m} + 1}^{d^{N}} S_{\mathbf{i} , \mathbf{k}} \lambda_{\mathbf{k}} D_{\mathbf{k} , \mathbf{j}} | | < \sum_{\mathbf{k} = \mathbf{m} + 1}^{d^{N}} | | S_{\mathbf{i} , \mathbf{k}} \epsilon D_{\mathbf{k} , \mathbf{j}} | | < \epsilon \mathbf{C}\tag{5.13} $$其中 $C$ 是一个有界常数,可根据某种矩阵范数及其维度进行估计。实际上,关于 Frobenius 范数 $| | T | | _{F}^{2} := \textstyle \sum_{ij} | T_{ij} | ^{2}$,由这种截断引入的误差 $\zeta$ 等于所有被舍弃的奇异值之平方和
$$ \zeta = \sum_{k = m + 1}^{d^{N}} \lambda_{k}^{2}\tag{5.14} $$特别地,如果 $\zeta$ 降至零(即等价于其数值表示,在双精度计算时通常为 $\mathrm{i} 0^{-15}$ 量级),则将张量维度截断至 $m$ 不会引入误差,从而大幅减少描述所关注系统所需的计算资源。可以证明,无论如何,SVD都能在 Frobenius 范数下,通过一个压缩在更小空间(即矩阵秩更低)中的 $\tilde{T}_{\mathbf{i} , \mathbf{j}}$,给出对 $T_{\mathbf{i , j}}$ 的最佳可能逼近。由于张量网络中的这种范数与物理量(例如所表示的量子多体态的范数)相关联,因此这种压缩技术使我们能够高效且可控地降低计算成本,同时在计算中保留最多数量的相关信息。
5.3 张量网络态与操作#
如上所述,张量网络是由不同张量通过收缩不同指标连接而成的网络。因此,张量网络将一个指数级大小的 $N$ 维张量分解为一组较小且可单独控制和操作的互联张量。这样,我们就可以表示式 (4.1) 中引入的量子多体态——回忆可知,该态可写成一个 $N$ 维张量,其开链对应系统的局域希尔伯特空间(见图 5.2)。将这样一个张量精确分解为张量网络(即网络中单个张量的连接)有多种方式,从而产生不同的张量网络几何结构,我们稍后将详细描述。然而,我们可以将每种张量网络几何结构视为类似于数学图的对象,关键区别在于张量网络可以拥有开链,即物理链。在图论背景下,我们可以参照文献[150]中的定义,形式上像定义图一样定义一个张量网络:
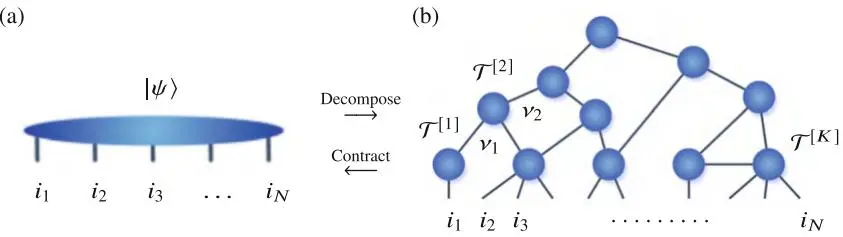
图 5.2 一个高维(秩为 N)张量精确描述了量子多体波函数,包含了所有指数级数量的系数 (a)。波函数的一种可能的张量网络表示 (b)。连接张量 $\mathcal{T}^{[ k ]}$ 的这些键链的维度 $\nu_{j}$ 可以调整,以压缩网络内封装的
信息定义 5.3.1(张量网络)#
张量网络 张量网络应定义为一个元组 $\mathcal{G} = ( \mathfrak{T} , \mathfrak{N} )$,该元组由一组两个或更多张量 $\mathfrak{T} = \{\mathcal{T} \}$ 和一组对应的链 $\mathfrak{N} = \{\nu \}$ 组成。集合 $\mathfrak{N}$ 进一步分为连接张量之间的内部链 $\{\chi \}$ 和仅连接一个张量的外部链(即物理链) $i$,因此每个外部链仅有一个开端。
此外,我们规定:
- 网络的大小 K 定义为元组 $\mathcal{G}$ 中张量的总数,即大小 $\mathcal{G}$ 或分别指 $\mathfrak{T}$。
- 物理链的总数 N,即 $i$ 的大小,为系统大小 [或物理大小]。
典型文献引入 $d_{k} = \dim i_{k}$ 作为物理链 $i_{k}$ 的维度。根据网络和描述的不同,内部链的维度通常记作 $\chi$、$m$ 或 $D$。[...]
每个张量网络在理论上应能通过在所有内部链 $\{\chi \}$ 上收缩其组成张量,而收缩为单个张量 $\Psi_{\{i \}}$,遵循
$$ \Psi_{i_{1} , \dots , i_{N}} = \sum_{\chi_{1} = 1}^{m_{1}} \sum_{\chi_{2} = 1}^{m_{2}} \cdot \cdot \cdot \sum_{\chi_{N} = 1}^{m_{N}} \left( \prod_{\kappa = 1}^{K} \mathcal{T}_{\{i \}_{\kappa} , \{\chi \}_{\kappa}}^{[ \kappa ]} \right) ,\tag{5.15} $$其中$\mathcal{T}_{\{i \}_{K} , \{\chi \}_{K}}^{[ \kappa ]}$是集合$\mathfrak{T}$中的第$\kappa$个张量,其链$\{i \}_{\kappa}$和$\{\chi \}_{\kappa}$分别表示连接到该第$\kappa$个张量的所有物理链和内部链的集合。注意到每个内部链$\chi_{\kappa}$在张量集合$\mathfrak{T}$中出现两次,需要进行缩并,而每个物理链在$\mathfrak{T}$中仅出现一次。
• 最后,我们将所有内部链的最大维度定义为网络的键维(bond dimension)$m = {\mathrm{max}}_{\kappa = 1 , \dots , K} \{{\mathrm{dim}} \chi_{\kappa} \}$
下面,我们更详细地描述张量网络上的典型运算。
5.3.1 张量网络微分(Tensor Network Differentiation)#
在许多情况下,我们需要针对给定品质因数(figure of merit)对张量网络中张量的条目进行优化,例如在最小化能量期望值以寻找系统基态的张量网络表示时。因此,对张量网络系数的函数求极值的能力是基础性的。式(5.8)中平均能量的计算是两个N秩张量的二次函数:
$$ \langle \psi_{N} | \hat{H} | \psi_{N} \rangle = \mathcal{H} ( \psi_{\beta_{1} , \dots , \beta_{N}}^{*} , \psi_{\alpha_{1} , \dots , \alpha_{N}} ) \equiv \mathcal{H} ( \psi_{\mathbf{i}}^{*} , \psi_{\mathbf{j}} ) ,\tag{5.16} $$在此我们回顾,由于是复值函数,根据复分析 [158] 的规则,$\psi_{\mathbf{i}}^{*}$和$\psi_{\mathbf{j}}$是独立变量。因此,要找到函数关于张量条目的极值,需将函数的微分设为零:
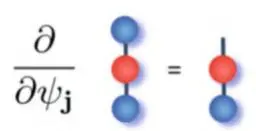
$$ \frac{\partial \mathcal{H}} {\partial \psi_{\mathbf{j}}} \overset{!} {=} 0 ;\tag{5.17} $$考虑到式(5.8)中的表达式,由于该变量在函数中线性出现,这等价于条件${\psi}_{\bf i}^{*} H_{\bf j}^{\bf i} = 0$。
总之,毫不意外地,任何张量的线性函数(任何通过张量网络定义的函数,其中每个张量仅出现一次)关于特定张量A的导数,就是移除该张量A后的张量网络。此类计算的一个示例的图形表示见图5.3b。
5.3.2 规范变换(Gauging)#
在张量网络算法中扮演重要角色的一种运算是规范变换,即通过局域变换改变张量的条目,而不改变全局态,以利用某些所需性质。确实,当两个张量被缩并时,可以在它们之间插入一个恒等算符,而不改变整个张量网络的性质。利用对任何幺正算符$U$都成立的等价关系$1 = U^{\dagger} U$,
a)
 b)
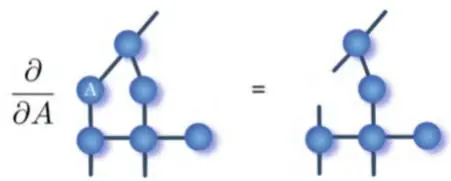
图5.3 (a)式(5.17)推导的图形表示;(b)对嵌入张量网络中的张量A进行一般偏导的图形表示
张量的条目可以改变为:
$$ A_{\mathbf{i}} B_{\mathbf{i}} = A_{\mathbf{i}} \mathbb{1}_{\mathbf{i} , \mathbf{j}} B_{\mathbf{j}} = A_{\mathbf{i}} U_{\mathbf{i , k}}^{\dagger} U_{\mathbf{k , j}} B_{\mathbf{j}} = {\tilde{A}}_{\mathbf{k}} {\tilde{B}}_{\mathbf{k}} ;\tag{5.18} $$最终的净效果是张量结构保持不变,但张量元素发生了变化,从而能够满足某些期望的性质。显然,这种自由度既可以在融合指标 i, j 层面加以利用,也可以在每一个单独的指标 $\alpha_{j}$ 上独立利用。
为避免可能的混淆,我们在此提醒读者:在后续内容(见第 6.4 节)中,我们将介绍规范不变张量网络(gauge invariant tensor networks):尽管二者名称相似且存在明确关联(两种情况下我们都利用了张量网络在局部变换作用下的不变性),但这两类构造通常不同,具有不同的物理起源。在这里,我们利用的是变换在辅助指标上的不变性;而在后者中,不变性来源于所研究理论的对称性,并且规范变换作用于物理指标上。
另一种强大的操作工具是极分解,即每个矩阵都可以分解为一个酉部分和一个非酉部分(从几何角度看,任何线性操作都可以分解为一个旋转和一个缩放),即:
$$ A_{\mathbf{i} , \mathbf{j}} = U_{\mathbf{i} , \mathbf{k}} P_{\mathbf{k} , \mathbf{j}} ,\tag{5.19} $$其中 $U$ 是一个酉矩阵,而 $P$ 是一个半正定矩阵。
我们将看到,这些操作能够大幅减少某些全局缩并的计算时间。例如,我们将展示,利用酉矩阵的性质,大型张量网络范数的计算可以简化为一个简单的小向量范数计算。
5.3.3 面积律与纠缠性质#
本节讨论量子纠缠对将多体态表示为张量网络的影响。虽然一般的量子波函数存在于一个指数增长的向量空间中,使得用张量网络进行精确表示不可行,但物理上的量子态通常遵守称为面积律(area law)的纠缠上界。与纠缠随系统体积缩放(即体积律,volume law)的朴素预期相反,经验证据表明,许多物理态,尤其是在更高维度中,服从更严格的纠缠上限 [38, 159–163]。
引入纠缠熵(entanglement entropy)$S$(由冯·诺伊曼熵衡量)的概念,用以量化量子系统两个二分分区之间的纠缠量。在此框架下,服从面积律的量子态的纠缠熵预计随二分区的边界面积比例增长,而非随二分区的体积增长,即:
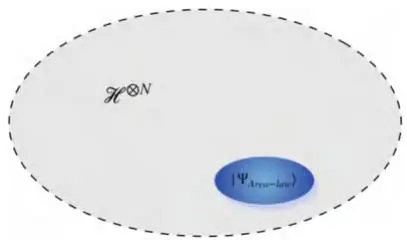
图5.4 量子多体希尔伯特空间包含了由 表示的整个纯态谱。在这个指数级巨大的空间中,那些遵循纠缠熵面积律缩放的态 $\left| \psi_{Area-Law} \right.$ 仅占据整体流形的一小部分区域
$$ S = {\cal O} ( \partial \mathcal{A} ) \left( \sim L^{D - 1} \right) $$(后面括号内表示一个维度均匀的 $D$ 维系统,其中各维尺寸均为 $L$,即 $\begin{array} {r} {N = \prod_{i = 1}^{D} L_{i} \stackrel{( L_{i} = L )} {=} L^{D} )} \end{array}$。从信息论的角度来看(熵被用作衡量系统固有信息含量的指标 [164–166]),这些面积律表明,描述物理态的相关信息位于指数级巨大希尔伯特空间中一个相对很小的角落(比较图5.4)。因此,量子系统的面积律通常能够以最小损失将态高效地分解为张量网络结构。
在张量网络表示中,冯·诺伊曼熵可以通过施密特分解(Schmidt decomposition)[166] 来评估,形式上将张量网络态分解为两个二分分区 $| \Psi^{[ \mathcal{A} ]} \rangle$ 和 $| \Psi^{[ \mathcal{B} ]} \rangle$。事实上,每一个二分量子态 $| \Psi \rangle \in \mathcal{H}_{\mathcal{A}} \otimes$ $\mathcal{H}_{\mathcal{B}}$ 都可以通过施密特分解表示为:
$$ | \Psi \rangle = \sum_{\alpha = 1}^{\chi} \lambda_{\alpha}^{[ \mathcal{A} , \mathcal{B} ]} | \Psi^{[ \mathcal{A} ]} \rangle \otimes | \Psi^{[ \mathcal{B} ]} \rangle , $$其中 $\lambda_{\alpha}^{\left[ \mathcal{R} , \mathcal{B} \right]}$ 代表施密特系数,$| \Psi^{[ \mathcal{A} ]} \rangle$ 和 $| \Psi^{[ \mathcal{B} ]} \rangle$ 是对应于二分划 $\mathcal{A}$ 和 $\mathcal{B}$ 的希耳伯特空间 $\mathcal{H}_{\mathcal{A}}$ 和 $\mathcal{H}_{\mathcal{B}}$ 的标准正交基,也称为施密特基(Schmidt bases)。二分划之间的纠缠熵 $s$ 现在由施密特系数给出:
$$ S = - \sum_{\alpha = 1}^{\chi} \vert \lambda_{\alpha}^{[ \mathcal{R} , \mathcal{B} ]} \vert^{2} \log \{\vert \lambda_{\alpha}^{[ \mathcal{A} , \mathcal{B} ]} \vert^{2} \} . $$在实际应用中,可以利用奇异值分解(Singular Value Decomposition, SVD)进行施密特分解。首先将量子态表示为关于两个二分划的矩阵 $\begin{array} {r} {\Psi = \sum_{\{i \}} \psi_{( i_{1} , \dots , i_{k} ) , ( i_{k + 1} , \dots , i_{N} )} | i_{1} , . . . , i_{k} \rangle_{\mathcal{R}} | i_{k + 1} , . . . , i_{N} \rangle_{\mathcal{B}}} \end{array}$,然后将其分解为 $\Psi = U \sigma V^{\dagger}$。这里,$U$ 和 $V$(满足 $U^{\dagger} U = \mathbb{1}$ 和 $V V^{\dagger} = \mathbb{1}$)张成标准正交基,而 $\sigma$ 的非零归一化奇异值就是施密特系数 $\lambda_{\alpha}^{\left[ \mathcal{R} , \mathcal{B} \right]}$。因此,当只有一个非零奇异值 $(\lambda_{1} = 1)$ 时,最小熵 $S = 0$,这意味着两个二分划之间完全可分离。相反,更高的 $S > 0$ 则表示纠缠程度增加。值得注意的是,冯·诺伊曼熵受限于 $S \le \log \chi$。
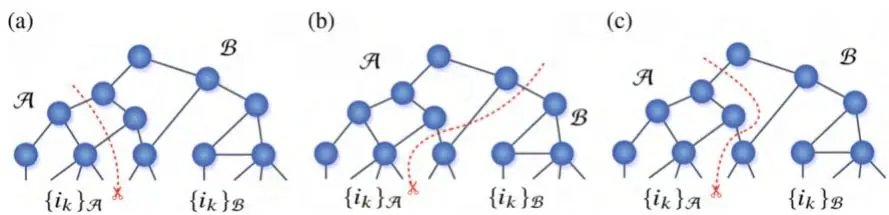
图5.5 各种张量网络二分划示意图,展示了对应于二分划 $\mathcal{A}$ 和 $\mathcal{B}$ 物理位置的链接 $\{i_{k} \}_{\mathcal{A}}$(蓝色表示)和 $\{i_{k} \}_{\mathcal B}$(橙色表示)。每次切断链接都会贡献一笔熵,其上限受限于其键维数 $m_{\ltimes}$,即 $\log m_{\ltimes}$
现在,考虑一个张量网络表示(如定义5.3.1所定义),其物理链接为 $\{i_{k} \}$。子集 $\{i_{k} \}_{\mathcal{A}} \left( \{i_{k} \}_{\mathcal{B}} \right)$ 对应于二分划 $\mathcal{A}$($\mathcal{B}$)内部的物理位置(见图5.5)。通过切断张量网络态的内部链接 $\{\chi_{\ l \times} \}$ 对其进行二分,可以得到关于冯·诺伊曼纠缠熵的不等式:
$$ S_{T N}^{[ \mathcal{R} , \mathcal{B} ]} \leq \operatorname*{min}_{\{\times \}} \left[ \sum_{\ l \ l \kappa} \log m_{\ l \ l \kappa} \right] ,\tag{5.20} $$其中 $m_{\ltimes}$ 表示连接 $\chi_{\ltimes}$ 的键维(bond dimension)。此过程将网络分解为子张量网络,每个断裂的连接贡献最大熵 $\log m_{\ltimes}$(受其键维 $m_{\ltimes}$ 约束)。遍历所有可能切割的最小值给出网络纠缠熵的上界。因此,键维 $m = 1$ 的网络意味着 $S_{T N}^{[ \mathcal{R} , \mathcal{B} ]} = \bar{0}$,表示无纠缠的乘积态,符合平均场理论。增大 $m$ 使得张量网络能够忠实表示遵循式 (5.20) 纠缠边界的态。平衡计算效率与表示精度需根据这些纠缠边界缩放 $m$ 或切割连接的数量。在更高维度中实现这种平衡对张量网络几何结构构成重大挑战。
5.3.4 张量网络几何结构(Tensor Network Geometries)#
如本节引言所述,存在多种方法用不同张量网络几何结构表示特定量子多体态。以下仅简要概述最常见的几何结构,后续章节将以更技术性的方式介绍其中一些。具体而言,第 7 章介绍矩阵乘积态 (MPS) 的技术实现及其不同算法;第 8 章阐述树张量网络 (TTN) 的实操实现;第 9 章专注于增强型树张量网络 (aTTN) 的实现。
本质上,对于一维系统,矩阵乘积态是处理平衡问题以及在许多情况下处理非平衡问题的成熟张量网络结构。另一方面,多尺度纠缠重整化 Ansatz (MERA) 提供了特别适用于临界一维系统的高效表示 [45, 147, 168, 169]。然而,二维或更高维张量网络算法的开发仍在进行中,因为在使用张量网络方法模拟高维系统时,平衡精度与可扩展性仍是一个重大挑战 [170, 171]。值得注意的高维张量网络表示包括主要设计用于二维系统的投影纠缠对态 (PEPS) [172–176] 和原则上可定义为任意维度系统的树张量网络 [42,170,177–179,282, 353]。
5.3.4.1 平均场作为张量网络#
如第 4.1 节所述,平均场方法通过近似粒子或量子自由度之间的相互作用来简化复杂量子系统的描述。在此方法中,每个量子粒子或自由度被视作因其他所有粒子的存在而经历一个平均相互作用场。该方法可以重新解释为张量网络算法:我们可以将第 4.3 节引入的(单体)平均场近似建模为由每个量子粒子(即物理位点)的 $N$ 个单秩张量乘积构成的张量网络。任务随后是找到使在平均场 Ansatz 内计算的能量期望值最小化的张量元。在第 7 章中,我们将详细描述这种平均场计算的张量网络方法,进而引出对 MPS 的技术性介绍,将其作为平均场方法的推广。
5.3.4.2 矩阵乘积态(Matrix Product States)#
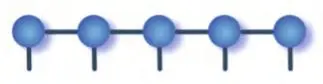
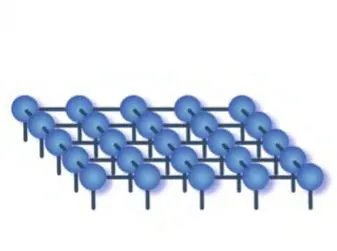
矩阵乘积态(Matrix Product State, MPS)是最成功的张量网络框架之一,最初由 Ostlund 和 Rommer [47] 提出,并被证明与 DMRG 描述等价 [25]。它已常规应用于一维量子系统的研究,包括平衡态和非平衡态场景。作为平均场拟设的延伸,MPS 在不同局域位点之间引入了额外连接来表示系统中的关联。因此,它由若干个张量 $\mathcal{T}^{[ k ]}$ 组成,每个物理位点 k 对应一个,每个张量通过内部辅助链接与其最近邻相连,如图 5.6a 所示。由于这种链式结构,在数学界也被称为张量列(Tensor Trains)[183]。与第 4.1.2 节介绍的团簇平均场拟设不同,MPS 具有平移不变性,并且能够根据内部链接的辅助维度在平均场和精确多体表示之间灵活插值。
(a)
(b)
(c)
 (d)
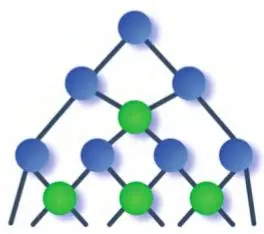
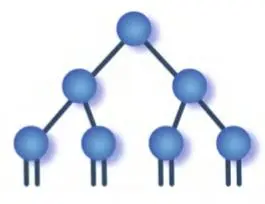
图 5.6 表示量子多体波函数最常用的张量网络几何结构:MPS (a)、TTN (b)、MERA (c) 和 PEPS (d)
在过去的二十年中,基于 MPS 发展出了多种算法,使其成为张量网络领域的基石。对于主要的极小化和时间演化算法,其数值复杂度为 $O ( m^{3} )$,因而是处理一维平衡态 [184, 185] 乃至许多非平衡态问题 [53, 186] 的主要计算工具。虽然 MPS 可以扩展到二维系统(2D-DMRG)[188, 189],并在柱面构型的实际应用中具有优化后的标度,但其在更高维系统中的效用会降低。在大于一维的维度中,MPS 需要指数级增大的键维数来弥补其固有限制,从而阻碍了它在系统尺寸增大时准确表示量子多体态的能力。
在第7章中,我们将通过具体的实例和练习,更详细地描述 MPS 及其技术实现。
5.3.4.3 树张量网络(Tree Tensor Networks)#
树张量网络(Tree Tensor Network, TTN)与 MPS 不同,它由一种分层的张量网络结构构成。在此谱系的一端是二叉树,如图 5.6b 所示,通常被称为树张量网络,其中每个张量的秩为三,这是构成树结构所需的最小秩 [42, 44, 190, 191, 282]。由于其分层结构,并且每对张量之间通过最多长度为 $2 \log N$ 的链接路径相连(其中 N 是位点数量),这种结构是描述临界系统(见第四部分中更多讨论)的理想候选,至少在一维情况下如此 [44, 192]。它可以很直接地推广到更高维系统或一般的无环图 [42, 150, 191, 193, 194]。
在第8章中,将更详细地介绍 TTN 及其在高维系统中的实现,包括其形式定义、典型结构、优化方法、可观测量计算,以及最关键的是,在将此张量网络扩展到更高维度时遇到的实际障碍。
5.3.4.4 投影纠缠对态 (PEPS)#
与一维中的矩阵乘积态 (MPS) 类似,投影纠缠对态 (PEPS) 为二维量子系统的完整态矢量提供了一种近似:每个物理格点对应一个张量,这些张量以模拟底层物理晶格结构的网格配置连接(见图5.6c)。这产生了一个包含"环"或非规范冗余的张量网络。因此,PEPS 代表了一种直观且可能强大的描述二维量子多体波函数的方法。然而,PEPS 伴随着高数值复杂度,对于有限大小的 PEPS 通常缩放为 $O ( m^{10} )$ [39, 174],并且缺乏精确期望值计算的能力 [195]。对于具有 $N = L \times L$ 个格点的有限方格,此类计算所需的完整 PEPS 收缩随平均系统长度 L 呈指数缩放 [196]。因此,计算上优化 PEPS 试探波函数通常导致典型键维数约为 $m \sim 10$,这对于具有更高局部维数的系统(例如高阶自旋系统、晶格规范理论或费米子哈伯德类系统中遇到的)是不足的。此外,PEPS 主要针对具有开放边界条件的二维问题量身定制,使其在具有周期性边界条件或更高维度的系统中的应用实际上不可行。
5.3.4.5 多尺度纠缠重整化假设 (MERA)#
多尺度纠缠重整化假设 (MERA) 于2007年首次亮相,是分析临界一维 (1D) 系统的有效表示 [45]。与矩阵乘积态 (MPS) 相比,MERA 在处理临界一维系统中的纠缠熵时表现出色,超越了面积律。其复杂结构包括错位单元 (isometries) 和解纠缠器 (disentanglers) 的交替层(如图5.6d所示),允许高效收缩。然而,优化 MERA 的复杂度至少为 $O ( m^{7} )$ 或更高,具体取决于具体配置 [147]。
MERA 的基本概念也可以扩展到二维 (2D) 系统 [148]。与投影纠缠对态 (PEPS) 不同,2D MERA 可以精确计算期望值。然而,其计算复杂度急剧上升到 $O \left( m^{16} \right)$,使其在实际应用的高维系统中不切实际。因此,由于来自 PEPS 和树张量网络 (TTN) 的日益激烈的竞争,2D MERA 的使用近年来有所减少。虽然原则上 MERA 可以应用于更高维度的系统,但随着维度的增长,数值缩放变得越来越不利。MERA 在量子引力 [168, 169, 197–200] 中找到了值得注意的应用,其中它与空间几何(例如反德西特空间 (AdS) 或共形场论 (CFT))存在联系。
5.3.4.6 增强树张量网络#
增强树张量网络 (aTTN) 结合了普通 TTN 的思想和 MERA 的优势。通过仅在 TTN 结构的底部放置解纠缠器(如 MERA 中所使用的),它可以结合 TTN 的低计算规模优势和更好地表示复杂量子系统的能力,特别是对于高维系统。在第9章中,我们将介绍这种张量网络几何结构,并更详细地描述它如何以编码面积律并提升高维计算的方式增强 TTN 方法。
5.3.5 张量网络算子#
在本节中,我们简要展示如何以张量网络表示形式描述作用于多体态的算子。我们展示算子如何以通用张量积算子 (TPO) 的形式在张量网络语言中表示。
这些 TPO $\mathcal{T}$ 是一种以分解的张量网络形式表示通用算子的手段。这个概念在文献 [170, 201] 中被引入,其中算子可以表示为:
$$ ( \mathcal{T} )_{\{i_{j}^{\prime} \}}^{\{i_{j} \}} = \sum_{\{\gamma_{\nu} \}} \prod_{j} ( \mathfrak{t}^{[ j ]} )_{i_{j} , i_{j}^{\prime}}^{\{\gamma_{\nu^{\prime}} \}} .\tag{5.21} $$在此表达式中,每个张量 $\mathbf{t}^{[ j ]}$ 局域作用于位点 $i_{j}$,并通过链接 $\gamma_{\nu^{\prime}}$ 与 TPO 内的其他张量相连。因此,整个 TPO 作用于物理位点 $i_{j}$ 上。与张量网络态不同——后者每个物理位点 $i_{j}$ 只对应一条物理链接——TPO 对其处理的每个局域位点拥有两条物理链接,分别记为 $i_{j}$ 和 $i_{j}^{\prime}$。这种 TPO 形式允许我们描述多种实体,包括局域可观测量 $( \mathcal{T}_{i} )$、哈密顿量 $\begin{array} {r} {( \mathcal{H} = \sum_{p} \mathcal{H}_{p} )} \end{array}$ 的相互作用项 $( \mathcal{T}_{i_{j}} = \mathcal{H}_{p} )$、弦可观测量 $( \mathcal{T}_{i_{j}} )$,以及更复杂的结构,例如矩阵乘积算符(Matrix Product Operator, MPO)[185, 203]——这将在第7.1.4节中详细探讨——或投影纠缠对算符(Projected Entangled Pair Operator, PEPO)[204–206]。图5.7展示了在典型量子多体系统的张量网络分析中常见的各种 TPO 的可视化表示。为确保计算效率,维持合理的链接数量并有效管理其内部键维 $\kappa$ 至关重要。
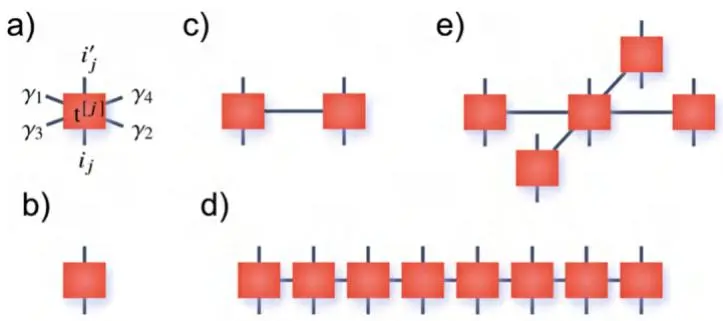
图5.7 每个张量网络算符(TPO)由局域张量 $\mathbf{t}^{[ j ]}$ 构建,这些张量作用于对应不同局域希尔伯特空间的物理位点 $i_{j}$ (a)。用于张量网络计算的 TPO 包括:局域算符 (b)、两体算符或关联函数 (c)、模拟二维系统中势相互作用的星形算符 (d),以及常用于 MPS 分析中建模哈密顿量的矩阵乘积算符(MPO) (e)
一个 TPO,或一组 TPO,是表示量子系统哈密顿量 $\mathcal{H} \in \mathcal{H}$ 的有用工具,其形式适合张量网络计算。计算完整哈密顿量 $\mathcal{H} \in \mathcal{H}$ 的期望值 $\langle \mathcal{H} \rangle_{\psi}$ 即使在采用张量网络表示时,也可能代价高昂。然而,通常情况下,完整哈密顿量可以表示为相互作用项的乘积之和,即 $\mathcal{H} = \textstyle \sum_{p} {\mathcal{H}}_{p}$。因此,每个相互作用项 $\mathcal{H}_{p}$ 都可以被有效地描述为一个张量积算符(TPO)。在第8.2.3节中,我们提供了一个说明性示例,演示了如何使用一组 TPO 表示哈密顿量。这个示例展示了二维树张量网络的优化过程。
5.4 张量网络算法#
张量网络不仅在量子物理学中,而且在其他多个领域都有着广泛的应用。在接下来的章节中,我们将简要介绍一些通过利用张量网络处理的最著名算法和挑战。
5.4.1 基态计算#
确定相互作用的量子多体系统的基态,对数值技术来说往往是一个严峻的挑战。在张量网络的背景下,这一任务可以高效地完成,即维持足够低的数值复杂度以满足能量最小化的需求。给定哈密顿量 $\mathcal{H}$,我们优化张量网络波函数 $\psi$ 的变分参数,通过最小化能量来发现系统的基态:
$$ E = \langle \psi | {\mathcal{H}} | \psi \rangle .\tag{5.22} $$张量网络的显著优势在于,网络中的每个单个张量都可以被视为独立变量。因此,其基本思想是每次只最小化一个或有限个张量。这种方法将全局的、指数级大小的优化问题转化为一系列在显著更小子空间内的局部最小化问题,该子空间的大小由所选择的网络键维决定。基于这一概念,可以应用各种优化技术,例如本征值最小化、梯度下降法或虚时演化。在第8.1.4节中,我们将使用树张量网络(Tree Tensor Networks)对此方法进行更详细的技术说明。
5.4.2 时间演化#
特别是在一维系统中,张量网络经常被用于研究非平衡动力学,即通过在幺正哈密顿量演化下随时间演变一个量子态。具体而言,有两种成熟的数值时间演化方法。首先要提到的一类算法,如时间演化块消减(TEBD)[53] 和 tDMRG [186],其基础是利用铃木-特罗特分解(Suzuki-Trotter decomposition)将幺正演化分解为一组局部算子,再将这些算子应用于网络。另一种值得注意的方法是含时变分原理(TDVP)[54, 207],它利用微分学中的数学概念,基于网络的几何结构来计算时间演化。虽然这些技术具有广泛的应用,例如执行各种淬火(quenches)[208–211]、受控动力学[212],或利用虚时进行量子退火,但这些应用目前仍局限于一维小系统尺寸或短时间尺度。
5.4.3 开放系统动力学#
张量网络另一个值得注意的应用涉及开放系统中混合态的表示 [213–217]。实际上,张量网络可用于研究由林德布拉德主方程(Lindblad master equation)支配的稳态或分析耗散时间演化。此应用背后的概念是通过张量网络有效分解混合多体态的指数级大小的密度矩阵,而不是表示纯态的波函数。然后可以通过直接积分 [214, 216] 或采用随机方法 [217] 来实现由底层主方程规定的动力学。这一研究方向相对较新,但有望成为模拟和验证新兴量子技术(如量子计算机)中耗散的竞争性方法。
5.4.4 机器学习#
张量网络不仅作为量子物理学中的数值方法出现:它们在应用数学领域,特别是在机器学习中 [218–226],也越来越重要。在这里,网络擅长以紧凑的形式有效表示海量信息,使其在识别模式和分类数据方面用途广泛。鉴于它们在最初开发时旨在解决高维线性量子系统,网络提供了一种直接的方法来计算那些能为机器学习应用所学数据提供宝贵见解的量 [227]。
在第13章中,我们将更详细地阐述机器学习背后的思想,以及张量网络如何作为人工智能的有效工具。在本章中,我们重点介绍张量网络机器学习的一些应用,范围从对欧洲核子研究中心大型强子对撞机底夸克探测器数据中质子-质子碰撞的分类 [227] 到自动驾驶 [228]。
5.5 测量与可获取信息#
尽管张量网络通过利用其固有的纠缠结构能够高效表示量子态,但从通用的张量网络几何结构中提取嵌入的信息并不总是那么简单。实际上,访问这些信息的能力是设计张量网络配置时的一个关键挑战。最终,我们的目标是从张量网络中提取关于该态的有意义信息。为解决这一关键点,让我们探讨在利用张量网络分析量子系统时通常感兴趣的典型量。
5.5.1 期望值(Expectation Values)#
计算可观测量 $O$ 的期望值 $\langle \Psi | O | \Psi \rangle$ 是从张量网络表示的量子多体态中提取信息的最重要手段之一。自然地,在分析量子系统时,我们最关心的可观测量之一就是其哈密顿量,记为 $\mathcal{H}$。如第5.3.5节所述,$\mathcal{H}$ 可以表示为张量网络算子(TPO)的形式,从而在实际应用中计算能量期望值 $\langle \mathcal{H} \rangle_{\psi}$。
除了 $\mathcal{H}$,通常还有三类可观测量引起我们的兴趣:局域可观测量,记为 $\mathcal{O} = \mathcal{O}^{[ s ]}$,作用于单个局域位点 $s$,常用于判别局域序参量;关联子(correlators),表示为 $O = O^{[ s_{1} , s_{2} ]}$,作用于两个位点,对于研究长程有序至关重要;以及更广泛的弦可观测量(string observables),表示为 $O = O^{[ s_{1} , s_{2} , \ldots , s_{\omega} ]}$,作用于系统中的 $\omega$ 个位点,对于探测拓扑性质等任务至关重要。
能否精确计算这些期望值,或者是否需要近似计算,取决于所使用的网络几何结构。后者的一个显著例子是PEPS,它无法高效收缩,这意味着该网络无法在与自身大小成多项式时间的关系内完成收缩。
在第8.1.5节中,我们以TTN为实际示例,更详细地展示了这些可观测量的计算方法。
5.5.2 态重叠与保真度#
比较两个物理态,记为 $\left| \psi^{[ 1 ]} \right\rangle$ 和 $\left| \psi^{[ 2 ]} \right\rangle$,我们可以评估它们的重叠量 $\langle \psi^{[ 1 ]} | \psi^{[ 2 ]} \rangle$ 或保真度(fidelity)$|\langle \psi^{[ 1 ]} | \psi^{[ 2 ]} \rangle|^{2}$,作为衡量两个态相似程度的度量。实际上,这一计算涉及收缩两个网络,一个表示 $\left| \psi^{[ 1 ]} \right\rangle$,另一个表示 $\left| \psi^{[ 2 ]} \right\rangle$,在它们共享的物理键上收缩。能够高效收缩的张量网络可以轻易提供该信息,而对于PEPS这类网络,随着系统尺寸增加,这种收缩在计算上会变得极具挑战性。
此外,态范数(norm),记为 $\langle \psi | \psi \rangle$,可以作为态重叠计算的一个特例,采用类似方法计算。而且,在执行此计算时,常可利用张量网络的规范自由度(gauge freedom)来进一步降低计算成本 [170, 185]。
5.5.3 纠缠性质#
由于纠缠在量子系统及其张量网络表示中扮演核心角色,我们通常对量子态的纠缠性质感兴趣。在此背景下,对于无环张量网络,我们可以计算系统某一二分剖分(bipartition)的纠缠量,该剖分将张量网络划分为两个子网络。为了衡量给定二分剖分下张量网络中所蕴含的纠缠量,可以收缩其中一个对应的子网络。这种收缩允许我们重构约化密度矩阵的谱,从而能够测量冯·诺依曼熵(Von Neumann entropy)和所有 Rényi 熵 [42, 229, 230]。
然而,根据张量网络的几何结构,收缩任意子系统可能会变得极其困难。特别是,无环张量网络在这方面表现优异(详见第8章)。通过采用合适的等距化技术(isometrization technique),它们可以直接以施密特分解(Schmidt decomposition)的形式表达,从而使得提取冯·诺依曼熵在计算上变得直接(详见第8.2.2节)。
5.6 进一步的发展#
到目前为止介绍的张量网络拟设和算法,构成了研究以有限一维闭多体量子系统为主的基本工具。然而,基于本章引入的工具,张量网络方法已扩展到许多其他场景,且发展水平与成功程度各不相同。例如,已提出了直接处理热力学极限 [52,202] 或在动量或混合空间 [231–233] 中工作的张量网络公式。也提出了用于计算多体量子系统热力学性质的张量网络方法 [234, 235]。此外,如前所述,通过使用MPDO或LPTN拟设以及量子轨迹,已引入了向有限温度和开放的Lindbladian动力学的扩展 [51, 236–241]。
张量网络方法的其他扩展正朝着描述连续统中定义的系统(例如量子场论)这一有前景的方向发展。在首次尝试将二次量子化与张量网络方法结合到所谓的连续MPS [242, 243] 之后,出现了更严谨的形式化工作。同时,诸如维格纳晶体等凝聚态系统已经使用自适应局域基 [244] 得到了有效描述。
最后,值得一提的是,张量网络方法在凝聚态和量子科学之外的不同领域中的应用正在增加。除了前面提到的在高能物理中研究格点规范理论的应用(见第6.4节),张量网络方法在量子化学问题中的应用也正在迅速增长:正在进行中的研究旨在确定最有前景的方法,并将其与标准方法进行基准测试 [245–248]。MERA张量网络所依据的理论构造已被一些量子引力理论所利用。实际上,现在有猜想认为MERA实现了CFT/AdS对偶 [249–252] 的某些特征,并且一些数值计算(可能支持这些方向的活跃理论活动)已经进行,例如参见 [253, 254]。
最后但同样重要的是,张量网络方法在经典计算机科学问题中有许多可能的应用。事实上,作为一类高效处理、压缩和优化大量数据的工具,不同的应用正在被探索:从图像压缩到机器学习和数据分析 [221, 224]。
5.7 软件#
迄今为止,已有大量软件平台可供使用,允许在不同层面进入张量网络的世界。其中一些是即用型套件,几乎无需了解底层运行程序细节即可开始研究感兴趣的模型。Itensor 和 TNT 库允许方便地操作张量并编写张量网络算法,无需底层编程 [255–257]。TNT 库还包含一个 DMRG/MPS 代码,类似于其他免费可用的实现,如 ALPS 项目和 openMPS 代码 [258, 259]。也可以免费下载专门针对量子化学电子结构问题的特定张量网络代码实现 [247, 260, 261]。
一个即用型、简单但可靠且灵活(嵌入了任意数量的阿贝尔对称性)的 DMRG 和 t-DMRG 代码已于 2006 年由本书作者之一及其合作者发布 [262]。该软件经历了多次升级,现已成熟为一个开源项目 Quantum TEA [1],可供下载并预装在意大利超级计算中心 CINECA 中,用于进行 HPC 和 GPU 计算。Quantum TEA 提供了越来越多的即用型功能,包括一维和二维多体量子系统的平衡和非平衡模拟、与标准量子算法软件(例如,Qiskit)兼容的量子计算仿真以及张量网络机器学习任务。
5.8 习题#
定义一个对象类来描述一般的 n 阶张量,并包含对其的基本操作:初始化和缩并。
在前一练习的基础上,增加作用于一般张量的函数:指标融合、重塑、奇异值分解和压缩。
从数学上证明,SVD 能够以弗罗贝尼乌斯范数(Frobenius norm)$\begin{array} {r} {| | \boldsymbol{M} | | _{F}^{2} : = \sum_{i j} | M_{i j} | ^{2} = \mathrm{tr} \{| \boldsymbol{M} M^{\dagger} \}} \end{array}$ 中引入的最小偏差,将任意矩阵M近似为另一个秩更低 $\tilde{r} < r$ 的矩阵 $\tilde{M}$。