第10章 · 演员-评论家方法#
10.1 最简单的演员-评论家算法:QAC#
本节将介绍最简单的 Actor-Critic 算法。我们可以通过推广式(9.32)中的策略梯度算法很容易地得到该算法。
首先,让我们回想一下。策略梯度方法的基本思想是通过最大化一个目标函数 $J(\theta)$ 来得到最优策略。用于最大化 $J(\theta)$ 的梯度上升算法是
$$ \begin{array}{r l} \theta_{t + 1} & = \theta_{t} + \alpha \nabla_{\theta} J (\theta_{t}) \\ & = \theta_{t} + \alpha \mathbb{E} _{S \sim \eta , A \sim \pi} \Big [ \nabla_{\theta} \ln \pi (A | S, \theta_{t}) q_{\pi} (S, A) \Big ], \end{array}\tag{10.1} $$其中 $\eta$ 是状态的分布(更多信息可参见定理9.1)。由于真实的梯度是无法得到的,我们可以使用随机梯度来近似:
$$ \theta_{t + 1} = \theta_{t} + \alpha \nabla_{\theta} \ln \pi (a_{t} | s_{t}, \theta_{t}) q_{t} (s_{t}, a_{t}).\tag{10.2} $$这就是上一章式(9.32)中给出的算法。
式(10.2)非常重要,因为它清楚地展示了如何融合基于策略的方法和基于价值的方法。一方面,它是一个基于策略的算法,因为它直接更新策略参数。另一方面,它的更新需要知道 $q_{t}(s_{t},a_{t})$ ,这是动作值 $q_{\pi}(s_{t},a_{t})$ 的估计量,需要另一个基于价值的算法来得到 $q_{t}(s_{t},a_{t})$ 。
到目前为止,本书介绍了两种估计动作值的方法:第一种是基于蒙特卡罗的方法,第二种是时序差分的方法。
如果 $q_{t}(s_{t},a_{t})$ 是通过蒙特卡罗方法来估计的,那么相应的算法被称为REINFORCE或者蒙特卡罗策略梯度。该算法已经在第9章介绍过了。
如果 $q_{t}(s_{t},a_{t})$ 是通过时序差分方法来估计的,那么相应的算法通常被称为Actor-Critic。换句话说,当我们把基于时序差分的价值估计引入到策略梯度方法时,就得到了Actor-Critic方法。
算法10.1给出了最简单的Actor-Critic算法。其中Actor对应于式(10.2)给出的策略更新步骤;Critic对应于式(8.36)给出的Sarsa算法,用于估计策略对应的值,其中动作值由函数 $q(s,a,w)$ 表示。这种Actor-Critic算法有时被称为Q Actor-Critic(QAC)。尽管它很简单,但QAC揭示了Actor-Critic算法的核心思想。我们在本章后面看到的许多高级算法都可以通过推广QAC得到。
初始化:一个策略函数 $\pi(a|s,\theta_{0})$ ,其中 $\theta_{0}$ 是初始参数。一个价值函数 $q(s,a,w_{0})$ ,其中 $w_{0}$ 是初始参数。 $\alpha_{w},\alpha_{\theta}>0$ 。
目标:学习一个最优策略来最大化 $J(\theta)$ 。
在每个回合中的 t 时刻
根据 $\pi(a|s_{t},\theta_{t})$ 产生 $a_{t}$ ,观测 $r_{t+1},s_{t+1}$ ,然后根据 $\pi(a|s_{t+1},\theta_{t})$ 生成 $a_{t+1}$
Actor(策略更新):
$\theta_{t+1}=\theta_{t}+\alpha_{\theta}\nabla_{\theta}\ln\pi(a_{t}|s_{t},\theta_{t})q(s_{t},a_{t},w_{t})$
Critic(价值更新):
$w_{t+1}=w_{t}+\alpha_{w}[r_{t+1}+\gamma q(s_{t+1},a_{t+1},w_{t})-q(s_{t},a_{t},w_{t})]\nabla_{w}q(s_{t},a_{t},w_{t})$
10.2 优势演员-评论家#
下面介绍优势演员-评论家(advantage actor-critic,A2C)算法。这个算法的核心思想是引入一个基准来减少估计的方差。
10.2.1 基准不变性#
策略梯度有一个重要性质:它对额外的基准(baseline)是不变的,即
$$ \mathbb{E} _{S \sim \eta , A \sim \pi} \Big [ \nabla_{\theta} \ln \pi (A | S, \theta_{t}) q_{\pi} (S, A) \Big ] = \mathbb{E} _{S \sim \eta , A \sim \pi} \Big [ \nabla_{\theta} \ln \pi (A | S, \theta_{t}) (q_{\pi} (S, A) - b (S)) \Big ],\tag{10.3} $$其中 $b(S)$ 是基准函数,它是 $S$ 的一个标量函数。上式表明了添加或去掉基准函数 $b(S)$ 不会影响策略梯度。下面回答两个重要问题。
◇ 第一,为什么式(10.3)是成立的?#
式(10.3)成立的充分必要条件是下式成立:
$$ \mathbb{E} _{S \sim \eta , A \sim \pi} \left[ \nabla_{\theta} \ln \pi (A | S, \theta_{t}) b (S) \right] = 0. $$而该式成立的原因如下所示:
$$ \begin{array}{r l} \mathbb{E} _{S \sim \eta , A \sim \pi} \Big [ \nabla_{\theta} \ln \pi (A | S, \theta_{t}) b (S) \Big ] & = \sum_{s \in \mathcal{S}} \eta (s) \sum_{a \in \mathcal{A}} \pi (a | s, \theta_{t}) \nabla_{\theta} \ln \pi (a | s, \theta_{t}) b (s) \\ & = \sum_{s \in \mathcal{S}} \eta (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta_{t}) b (s) \\ & = \sum_{s \in \mathcal{S}} \eta (s) b (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta_{t}) \\ & = \sum_{s \in \mathcal{S}} \eta (s) b (s) \nabla_{\theta} \sum_{a \in \mathcal{A}} \pi (a | s, \theta_{t}) \\ & = \sum_{s \in \mathcal{S}} \eta (s) b (s) \nabla_{\theta} 1 = 0. \end{array} $$◇ 第二,为什么我们要引入基准函数?它有什么用?
基准函数之所以有用,是因为它能够在我们使用随机样本近似真实梯度时减少近似的方差。具体来说,定义
$$ X (S, A) \doteq \nabla_{\theta} \ln \pi (A | S, \theta_{t}) [ q_{\pi} (S, A) - b (S) ].\tag{10.4} $$此时真实的梯度是 $\mathbb{E}[X(S,A)]$ 。由于我们需要使用一个随机样本 $x$ 来近似 $\mathbb{E}[X]$ 的值,我们希望方差 $\operatorname{var}(X)$ 越小越好。如果 $\operatorname{var}(X)$ 接近0,那么任何样本 $x$ 都可以准确地近似 $\mathbb{E}[X]$ 。相反,如果 $\operatorname{var}(X)$ 很大,样本 $x$ 的值可能和 $\mathbb{E}[X]$ 有较大差距,此时用 $x$ 来近似 $\mathbb{E}[X]$ 可能很不准确。
虽然 $\mathbb{E}[X]$ 对于基准是不变的,但是方差 $\operatorname{var}(X)$ 是会随着基准变化的。因此,我们可以设计一个好的基准从而最小化 $\operatorname{var}(X)$ 。在REINFORCE和QAC的算法中,我们实际上设置了 $b = 0$ ,而这不一定是一个好的基准函数。
事实上,能够最小化 $\operatorname{var}(X)$ 的最优基准是
$$ b^{*} (s) = \frac{\mathbb{E} _{A \sim \pi} \left[ \| \nabla_{\theta} \ln \pi (A | s , \theta_{t}) \| ^{2} q_{\pi} (s , A) \right]}{\mathbb{E} _{A \sim \pi} \left[ \| \nabla_{\theta} \ln \pi (A | s , \theta_{t}) \| ^{2} \right]}, \quad s \in \mathcal{S}.\tag{10.5} $$详细的证明可参见方框10.1。
尽管式(10.5)中的基准是最优的,但它太复杂,无法在实际中使用。如果从式(10.5)中移除权重 $\| \nabla_{\theta}\ln \pi (A|s,\theta_t)\|^2$ ,就可以得到一个次优的基准,它有一个简洁的表达式:
$$ b^{\dagger} (s) = \mathbb{E} _{A \sim \pi} [ q_{\pi} (s, A) ] = v_{\pi} (s), \quad s \in \mathcal{S}. $$值得注意的是,这个次优的基准函数就是状态值函数。
令 $\bar{x} \doteq \mathbb{E}[X]$ 。如果 $X$ 是一个向量,那么其方差 $\operatorname{var}(X)$ 是一个矩阵。通常可以选择其迹(trace)作为优化的标量目标函数:
$$ \begin{array}{r l} \mathrm{tr} [ \mathrm{var} (X) ] & = \mathrm{tr} \mathbb{E} [ (X - \bar{x}) (X - \bar{x}) ^{\mathrm{T}} ] \\ & = \mathrm{tr} \mathbb{E} [ X X^{\mathrm{T}} - \bar{x} X^{\mathrm{T}} - X \bar{x} ^{\mathrm{T}} + \bar{x} \bar{x} ^{\mathrm{T}} ] \\ & = \mathbb{E} [ X^{\mathrm{T}} X - X^{\mathrm{T}} \bar{x} - \bar{x} ^{\mathrm{T}} X + \bar{x} ^{\mathrm{T}} \bar{x} ] \\ & = \mathbb{E} [ X^{\mathrm{T}} X ] - \bar{x} ^{\mathrm{T}} \bar{x}. \end{array}\tag{10.6} $$在导出上式时,我们使用了迹的性质 $\operatorname{tr}(AB) = \operatorname{tr}(BA)$ ,其中 $A, B$ 是两个方阵。如果 $\bar{x}$ 是不变的,那么式(10.6)表明我们只需要最小化 $\mathbb{E}[X^{\mathrm{T}}X]$ 就可以最小化 $\operatorname{tr}[\operatorname{var}(X)]$ 。
把 $X$ 在式(10.4)中的表达式代入 $\mathbb{E}[X^{\mathrm{T}}X]$ 可得
$$ \begin{array}{r} \mathbb{E} [ X^{\mathrm{T}} X ] = \mathbb{E} \left[ (\nabla_{\theta} \ln \pi) ^{\mathrm{T}} (\nabla_{\theta} \ln \pi) (q_{\pi} (S, A) - b (S)) ^{2} \right] \\ = \mathbb{E} \left[ \| \nabla_{\theta} \ln \pi \| ^{2} (q_{\pi} (S, A) - b (S)) ^{2} \right], \end{array} $$其中 $\pi (A|S,\theta)$ 简写为 $\pi$ 。由于 $S\sim \eta$ 且 $A\sim \pi$ ,上述方程可以改写为
$$ \mathbb{E} [ X^{\mathrm{T}} X ] = \sum_{s \in \mathcal{S}} \eta (s) \mathbb{E} _{A \sim \pi} \left[ \| \nabla_{\theta} \ln \pi \| ^{2} (q_{\pi} (s, A) - b (s)) ^{2} \right]. $$目标函数最优的必要条件是 $\nabla_{b}\mathbb{E}[X^{\mathrm{T}}X] = 0$ 。为确保 $\nabla_{b}\mathbb{E}[X^{\mathrm{T}}X] = 0$ ,对任意 $s\in S$ , $b(s)$ 应满足
$$ \mathbb{E} _{A \sim \pi} \big [ \| \nabla_{\theta} \ln \pi \| ^{2} (b (s) - q_{\pi} (s, A)) \big ] = 0. $$不难求解上述方程进而得到最优基准函数:
$$ b^{*} (s) = \frac{\mathbb{E} _{A \sim \pi} [ \| \nabla_{\theta} \ln \pi \| ^{2} q_{\pi} (s , A) ]}{\mathbb{E} _{A \sim \pi} [ \| \nabla_{\theta} \ln \pi \| ^{2} ]}, \qquad s \in \mathcal{S}. $$关于策略梯度方法中最优基准的更多讨论可参见[69,70]。
10.2.2 算法描述#
当 $b(s) = v_{\pi}(s)$ 时,式(10.1)中的梯度上升算法变成了
$$ \begin{array}{r l} & {\theta_{t + 1} = \theta_{t} + \alpha \mathbb{E} \Big [ \nabla_{\theta} \ln \pi (A | S, \theta_{t}) [ q_{\pi} (S, A) - v_{\pi} (S) ] \Big ]} \\ & {\quad \doteq \theta_{t} + \alpha \mathbb{E} \Big [ \nabla_{\theta} \ln \pi (A | S, \theta_{t}) \delta_{\pi} (S, A) \Big ].} \end{array}\tag{10.7} $$其中
$$ \delta_{\pi} (S, A) \doteq q_{\pi} (S, A) - v_{\pi} (S) $$被称为优势函数(advantage function),它反映了一个动作相对于其他动作的优势。具体来说,由于状态值 $v_{\pi}(s) = \sum_{a \in \mathcal{A}} \pi(a|s) q_{\pi}(s, a)$ 是平均动作值,因此 $\delta_{\pi}(s, a) > 0$ 意味着相应的动作值大于均值,具有一定的优势。
如果把式(10.7)中的真实梯度替换成随机梯度,可以得到
$$ \begin{array}{r} \theta_{t + 1} = \theta_{t} + \alpha \nabla_{\theta} \ln \pi (a_{t} | s_{t}, \theta_{t}) [ q_{t} (s_{t}, a_{t}) - v_{t} (s_{t}) ] \\ = \theta_{t} + \alpha \nabla_{\theta} \ln \pi (a_{t} | s_{t}, \theta_{t}) \delta_{t} (s_{t}, a_{t}). \end{array}\tag{10.8} $$其中 $s_t, a_t$ 是在 $t$ 时刻 $S, A$ 的样本。这里 $q_t(s_t, a_t)$ 和 $v_t(s_t)$ 分别是 $q_{\pi(\theta_t)}(s_t, a_t)$ 和 $v_{\pi(\theta_t)}(s_t)$ 的估计值。值得指出的是,算法(10.8)是基于 $q_t - v_t$ 这个相对值更新策略的,而不是基于其绝对值。这在直观上是合理的,因为当我们在一个状态选择一个动作时,我们只关心哪个动作相对于其他动作具有更大的价值,而并不关心其绝对动作值。
如果 $q_{t}(s_{t},a_{t})$ 和 $v_{t}(s_{t})$ 是通过蒙特卡罗方法估计的,那么式(10.8)中的算法被称为带基准的REINFORCE(REINFORCE with baseline)。如果 $q_{t}(s_{t},a_{t})$ 和 $v_{t}(s_{t})$ 是通过时序差分方法估计的,那么这种算法通常被称为Advantage Actor-Critic(A2C)。算法10.2给出了A2C算法的流程。应该注意的是,算法10.2中的优势函数是通过时序差分误差近似的,即
$$ q_{t} (s_{t}, a_{t}) - v_{t} (s_{t}) \approx r_{t + 1} + \gamma v_{t} (s_{t + 1}) - v_{t} (s_{t}). $$这个近似是合理的原因是
$$ q_{\pi} (s_{t}, a_{t}) - v_{\pi} (s_{t}) = \mathbb{E} \Big [ R_{t + 1} + \gamma v_{\pi} (S_{t + 1}) - v_{\pi} (S_{t}) | S_{t} = s_{t}, A_{t} = a_{t} \Big ]. $$上式是基于 $q_{\pi}(s_t, a_t)$ 的原始定义得到的。使用时序差分误差的一个优势是我们只需要使用一个神经网络来表征 $v_{\pi}(s)$ 。相反,如果我们使用 $\delta_t = q_t(s_t, a_t) - v_t(s_t)$ ,则需要维护两个网络来分别表示 $v_{\pi}(s)$ 和 $q_{\pi}(s, a)$ 。当我们使用时序差分误差时,该算法也被称为TD Actor-Critic。此外,值得注意的是, $\pi(\theta_t)$ 是一个随机策略,因此它具有一定的探索性,所以它可以直接用来生成经验样本,而不需要诸如 $\epsilon$ -Greedy之类的技巧。A2C还有一些变体,例如A3C(asynchronous advantage actor-critic)等。感兴趣的读者可以参考文献[71, 72]。
初始化:策略函数 $\pi(a|s,\theta_{0})$ ,其中 $\theta_{0}$ 是初始参数。价值函数 $v(s,w_{0})$ ,其中 $w_{0}$ 是初始参数。 $\alpha_{w},\alpha_{\theta}>0$ 。
目标:学习最优策略以最大化 $J(\theta)$ 。
在每个回合中的 t 时刻
根据 $\pi(a|s_{t},\theta_{t})$ 生成 $a_{t}$ ,然后得到 $r_{t+1}, s_{t+1}$
优势函数(时序差分误差):
$\delta_{t}=r_{t+1}+\gamma v(s_{t+1},w_{t})-v(s_{t},w_{t})$
Actor(策略更新):
$\theta_{t+1}=\theta_{t}+\alpha_{\theta}\delta_{t}\nabla_{\theta}\ln\pi(a_{t}|s_{t},\theta_{t})$
Critic(价值更新):
$w_{t+1}=w_{t}+\alpha_{w}\delta_{t}\nabla_{w}v(s_{t},w_{t})$
10.3 异策略演员-评论家#
迄今为止,我们介绍的策略梯度方法,包括REINFORCE、QAC、A2C都是同策略(on-policy)的,其原因可以从真实梯度的表达式中看出:
$$ \nabla_{\theta} J (\theta) = \mathbb{E} _{S \sim \eta , A \sim \pi} \left[ \nabla_{\theta} \ln \pi (A | S, \theta_{t}) (q_{\pi} (S, A) - v_{\pi} (S)) \right]. $$为了使用随机梯度来近似这个真实梯度,我们必须按照 $\pi (\theta)$ 生成动作样本。因此, $\pi (\theta)$ 是行为策略。因为 $\pi (\theta)$ 也是我们要改进的目标策略,所以策略梯度方法是On-policy的。
如果我们已经有一些由其他行为策略生成的样本,那么策略梯度方法仍然可以使用这些样本来得到最优策略,此时的方法就变成了异策略(off-policy),不过此时需要采用一种称为重要性采样(importance sampling)的技术。值得一提的是,重要性采样并不仅限于强化学习领域,它是通过使用根据某一个概率分布得到的样本来估计另一个概率分布的期望值的一种通用技术。
10.3.1 重要性采样#
考虑一个随机变量 $X \in \mathcal{X}$ 。假设 $p_0(X)$ 是一个概率分布,我们的目标是估计 $\mathbb{E}_{X \sim p_0}[X]$ 。假设我们有一些独立同分布的样本 $\{x_i\}_{i=1}^n$ 。
◇ 第一个场景:样本 $\{x_{i}\}_{i=1}^{n}$ 是根据 $p_{0}$ 生成的。此时,平均值 $\bar{x} = \frac{1}{n} \sum_{i=1}^{n} x_{i}$ 可以用来近似 $E_{X \sim p_{0}}[X]$ 。这是因为 $\bar{x}$ 是 $E_{X \sim p_{0}}[X]$ 的无偏估计,并且估计的方差随着 $n \to \infty$ 收敛到 0。更多信息请参见方框5.1中的大数定律。
第二个场景:样本 $\{x_{i}\}_{i = 1}^{n}$ 不是根据 $p_0$ 生成的,而是根据另一个概率分布 $p_1$ 生成的。我们是否仍然可以使用这些样本来近似 $\mathbb{E}_{X\sim p_0}[X]$ 呢?答案是可以的。然而,我们不能再使用 $\bar{x} = \frac{1}{n}\sum_{i = 1}^{n}x_{i}$ 来近似 $\mathbb{E}_{X\sim p_0}[X]$ ,这是因为 $\bar{x}\approx \mathbb{E}_{X\sim p_1}[X]$ 而非 $\mathbb{E}_{X\sim p_0}[X]$ 。
在第二个场景中,我们就需要使用重要性采样的技术来估计 $\mathbb{E}_{X\sim p_0}[X]$ 。具体来说, $\mathbb{E}_{X\sim p_0}[X]$ 满足下式:
$$ \mathbb{E} _{X \sim p_{0}} [ X ] = \sum_{x \in \mathcal{X}} p_{0} (x) x = \sum_{x \in \mathcal{X}} p_{1} (x) \underbrace{\frac{p_{0} (x)}{p_{1} (x)} x} _{f (x)} = \mathbb{E} _{X \sim p_{1}} [ f (X) ].\tag{10.9} $$上式表明,估计 $\mathbb{E}_{X\sim p_0}[X]$ 被转换为估计 $\mathbb{E}_{X\sim p_1}[f(X)]$ 的问题。此时,令
$$ \bar{f} \doteq \frac{1}{n} \sum_{i = 1} ^{n} f (x_{i}). $$因为 $\bar{f}$ 可以有效地近似 $\mathbb{E}_{X\sim p_1}[f(X)]$ ,所以由式(10.9)可知
$$ \mathbb{E} _{X \sim p_{0}} [ X ] = \mathbb{E} _{X \sim p_{1}} [ f (X) ] \approx \bar{f} = \frac{1}{n} \sum_{i = 1} ^{n} f (x_{i}) = \frac{1}{n} \sum_{i = 1} ^{n} \underbrace{\frac{p_{0} (x_{i})}{p_{1} (x_{i})}} _{\text{重要性权重}} x_{i}.\tag{10.10} $$式(10.10)表明 $\mathbb{E}_{X\sim p_0}[X]$ 可以通过 $x_{i}$ 的加权平均来近似,而这里的权重就是 $\frac{p_0(x_i)}{p_1(x_i)}$ ,它被称为重要性权重(importance weight)。当 $p_1 = p_0$ 时,重要性权重等于1, $\bar{f}$ 就变成了 $\bar{x}$ 。当 $p_0(x_i)\geqslant p_1(x_i)$ 时,这意味着 $x_{i}$ 可以在 $p_0$ 下更频繁地被采样到,而在 $p_1$ 下较少地被采样到。此时重要性权重大于1,突出了这个样本的重要性。
一些读者可能会提出下面的问题:为了计算 $E_{X\sim p_{0}}[X]$ ,式(10.10)需要知道 $p_{0}(x)$ ;如果我们已经知道了 $p_{0}(x)$ ,为什么不直接使用期望值的定义 $E_{X\sim p_{0}}[X]=\sum_{x\in\mathcal{X}}p_{0}(x)x$ 来计算呢?这个问题具有一定的迷惑性。答案如下所述。实际上,如果要使用定义来计算 $E_{X\sim p_{0}}[X]$ ,我们需要知道 $p_{0}$ 的解析表达式或者对于每一个 $x\in\mathcal{X}$ 的 $p_{0}(x)$ 的值。然而,当分布是由一个神经网络表示时,我们难以获得 $p_{0}$ 的解析表达式;或者当X很大时,也难以获得对于每一个 $x\in\mathcal{X}$ 的 $p_{0}(x)$ 的值。相比之下,式(10.10)仅需要一些样本的 $p_{0}(x_{i})$ 的值,因此在实践中更容易实施。
下面来看一个例子,从而更好地理解重要性抽样。考虑 $X \in \mathcal{X} \doteq \{+1, -1\}$ ,即每次采样只能得到 $+1$ 或者 $-1$ 的样本。假设一个概率分布 $p_0$ 满足
$$ p_{0} (X = + 1) = 0. 5, \quad p_{0} (X = - 1) = 0. 5. $$根据期望值的定义,我们知道 $X$ 在 $p_0$ 上的真实期望值是
$$ \mathbb{E} _{X \sim p_{0}} [ X ] = (+ 1) \cdot 0. 5 + (- 1) \cdot 0. 5 = 0. $$假设另一个概率分布 $p_1$ 满足
$$ p_{1} (X = + 1) = 0. 8, \quad p_{1} (X = - 1) = 0. 2. $$根据期望值的定义,我们知道 $X$ 在 $p_1$ 上的真实期望值是
$$ \mathbb{E} _{X \sim p_{1}} [ X ] = (+ 1) \cdot 0. 8 + (- 1) \cdot 0. 2 = 0. 6. $$假设我们有一些样本 $\{x_{i}\}$ ,这些样本是根据 $p_1$ 采样得到的,此时我们的任务是利用这些样本来估计 $\mathbb{E}_{X\sim p_0}[X]$ 。图10.2展示了采集到的样本,其中 $+1$ 的样本数量远多于 $-1$ ,这是因为 $p_1(X = +1) = 0.8 > p_1(X = -1) = 0.2$ 。此时如果我们直接计算样本的平均值,那么这个值会收敛到 $\mathbb{E}_{X\sim p_1}[X] = 0.6$ (见图10.2中的虚线)。如果我们利用式(10.10)计算加权平均值,那么这个值可以成功地收敛到 $\mathbb{E}_{X\sim p_0}[X] = 0$ (见图10.2中的实线)。
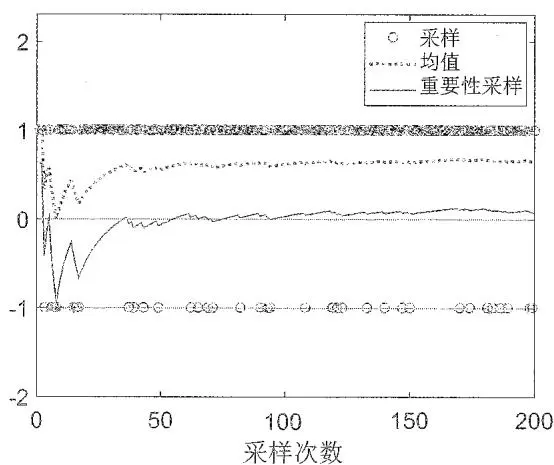
图10.2 用于演示重要性采样的例子。这里 $X \in \{+1, -1\}$ 且 $p_0(X = +1) = p_0(X = -1) = 0.5$ 。样本根据 $p_1$ 生成,其中 $p_1(X = +1) = 0.8$ 且 $p_1(X = -1) = 0.2$ 。样本的平均值收敛于 $E_{X \sim p_1}[X] = 0.6$ ,但是式(10.10)计算的加权平均值成功收敛于 $E_{X \sim p_0}[X] = 0$ 。
最后值得指出的是,由于式(10.10)中 $p_1(x)$ 位于分母,因此用于生成样本的分布 $p_1$ 必须满足当 $p_0(x) \neq 0$ 时 $p_1(x) \neq 0$ 。否则,如果 $p_1(x) = 0$ 而 $p_0(x) \neq 0$ ,估计结果可能会有问题。例如,假设
$$ p_{1} (X = + 1) = 1, \quad p_{1} (X = - 1) = 0, $$此时根据 $p_1$ 生成的样本只可能是 $+1: \{x_i\} = \{+1, +1, \ldots, +1\}$ 。显然,这些样本无法正确估计 $\mathbb{E}_{X \sim p_0}[X] = 0$ ,因为无论 $n$ 有多大都会有
$$ \frac{1}{n} \sum_{i = 1} ^{n} \frac{p_{0} (x_{i})}{p_{1} (x_{i})} x_{i} = \frac{1}{n} \sum_{i = 1} ^{n} \frac{p_{0} (+ 1)}{p_{1} (+ 1)} 1 = \frac{1}{n} \sum_{i = 1} ^{n} \frac{0 . 5}{1} 1 \equiv 0. 5. $$10.3.2 Off-policy 策略梯度定理#
利用重要性采样,我们可以推导出 Off-policy 策略梯度定理。假设 $\beta$ 是一个行为策略,我们的目标是使用由 $\beta$ 生成的样本来得到一个目标策略 $\pi$ ,从而最大化下面的目标函数:
$$ J (\theta) = \sum_{s \in \mathcal{S}} d_{\beta} (s) v_{\pi} (s) = \mathbb{E} _{S \sim d_{\beta}} [ v_{\pi} (S) ], $$其中 $d_{\beta}$ 是在策略 $\beta$ 下的平稳分布, $v_{\pi}$ 是在策略 $\pi$ 下的状态值。这个目标函数的梯度在下述定理中给出。
定理10.1 (Off-policy策略梯度定理)。如果 $\gamma \in (0,1)$ ,那么 $J(\theta)$ 的Off-policy梯度为
$$ \nabla_{\theta} J (\theta) = \mathbb{E} _{S \sim \rho , A \sim \beta} \Big [ \underbrace{\frac{\pi (A | S , \theta)}{\beta (A | S)}} _{\text{重要性权重}} \nabla_{\theta} \ln \pi (A | S, \theta) q_{\pi} (S, A) \Big ],\tag{10.11} $$其中状态分布 $\rho$ 为
$$ \rho (s) \doteq \sum_{s^{\prime} \in \mathcal{S}} d_{\beta} (s^{\prime}) \operatorname * {P r} _{\pi} (s | s^{\prime}), \quad s \in \mathcal{S}. $$这里 $\Pr_{\pi}(s|s') = \sum_{k=0}^{\infty} \gamma^{k}[P_{\pi}^{k}]_{s's} = [(I - \gamma P_{\pi})^{-1}]_{s's}$ 是在策略 $\pi$ 下从 $s'$ 到 $s$ 的折扣总概率。
式(10.11)中的 Off-policy 梯度与定理9.1中的 On-policy 梯度相似,但有两个区别。第一个区别是重要性权重,第二个区别是 $A \sim \beta$ 而不是 $A \sim \pi$ ,因此我们可以使用由 $\beta$ 采样得到的样本来近似真实梯度。该定理的证明在方框 10.2 中给出。
由于 $d_{\beta}$ 独立于 $\theta$ ,因此 $J(\theta)$ 的梯度满足
$$ \nabla_{\theta} J (\theta) = \nabla_{\theta} \sum_{s \in \mathcal{S}} d_{\beta} (s) v_{\pi} (s) = \sum_{s \in \mathcal{S}} d_{\beta} (s) \nabla_{\theta} v_{\pi} (s).\tag{10.12} $$根据引理9.2, $\nabla_{\theta}v_{\pi}(s)$ 的表达式为
$$ \nabla_{\theta} v_{\pi} (s) = \sum_{s^{\prime} \in \mathcal{S}} \operatorname * {P r} _{\pi} (s^{\prime} | s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s^{\prime}, \theta) q_{\pi} (s^{\prime}, a),\tag{10.13} $$其中 $\mathrm{Pr}_{\pi}(s'|s) \doteq \sum_{k=0}^{\infty} \gamma^{k}[P_{\pi}^{k}]_{ss'} = \left[(I_n - \gamma P_{\pi})^{-1}\right]_{ss'}$ 。将(10.13)代入(10.12)得
$$ \begin{array}{r l} & {{\nabla_{\theta} J (\theta) = \sum_{s \in \mathcal{S}} d_{\beta} (s) \nabla_{\theta} v_{\pi} (s) = \sum_{s \in \mathcal{S}} d_{\beta} (s) \sum_{s^{\prime} \in \mathcal{S}} \mathrm{Pr} _{\pi} (s^{\prime} | s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s^{\prime}, \theta) q_{\pi} (s^{\prime}, a)}} \\ & {{\qquad \qquad = \sum_{s^{\prime} \in \mathcal{S}} \left(\sum_{s \in \mathcal{S}} d_{\beta} (s) \mathrm{Pr} _{\pi} (s^{\prime} | s)\right) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s^{\prime}, \theta) q_{\pi} (s^{\prime}, a)}} \\ & {{\qquad \dot{=} \sum_{s^{\prime} \in \mathcal{S}} \rho (s^{\prime}) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s^{\prime}, \theta) q_{\pi} (s^{\prime}, a)}} \\ & {{\qquad = \sum_{s \in \mathcal{S}} \rho (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) \qquad (\mathrm{将} s^{\prime} \mathrm{换为} s)}} \\ & {{\qquad = \mathbb{E} _{S \sim \rho} \left[ \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | S, \theta) q_{\pi} (S, a) \right].}} \end{array} $$利用重要性采样,上式可以转换为
$$ \begin{array}{r l} & {\mathbb{E} _{S \sim \rho} \left[ \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | S, \theta) q_{\pi} (S, a) \right] = \mathbb{E} _{S \sim \rho} \left[ \sum_{a \in \mathcal{A}} \beta (a | S) \frac{\pi (a | S , \theta)}{\beta (a | S)} \frac{\nabla_{\theta} \pi (a | S , \theta)}{\pi (a | S , \theta)} q_{\pi} (S, a) \right]} \\ & {\qquad = \mathbb{E} _{S \sim \rho} \left[ \sum_{a \in \mathcal{A}} \beta (a | S) \frac{\pi (a | S , \theta)}{\beta (a | S)} \nabla_{\theta} \ln \pi (a | S, \theta) q_{\pi} (S, a) \right]} \\ & {\qquad = \mathbb{E} _{S \sim \rho , A \sim \beta} \left[ \frac{\pi (A | S , \theta)}{\beta (A | S)} \nabla_{\theta} \ln \pi (A | S, \theta) q_{\pi} (S, A) \right].} \end{array} $$证明完毕。上述证明类似于定理9.1的证明。
10.3.3 算法描述#
基于 Off-policy 策略梯度定理,下面介绍 Off-policy Actor-Critic 算法。由于 Off-policy Actor-Critic 与 On-policy Actor-Critic 有许多共同之处,因此只重点介绍一些关键步骤。
第一,Off-policy策略梯度对额外的基准函数 $b(s)$ 也是不变的。具体来说,因为 $\mathbb{E}\left[\frac{\pi(A|S,\theta)}{\beta(A|S)}\nabla_{\theta}\ln \pi (A|S,\theta)b(S)\right] = 0$ ,我们有
$$ \nabla_{\theta} J (\theta) = \mathbb{E} _{S \sim \rho , A \sim \beta} \left[ \frac{\pi (A | S , \theta)}{\beta (A | S)} \nabla_{\theta} \ln \pi (A | S, \theta) \big (q_{\pi} (S, A) - b (S) \big) \right]. $$第二,为了降低估计方差,我们可以选择基准函数为 $b(S) = v_{\pi}(S)$ 。此时策略梯度为
$$ \nabla_{\theta} J (\theta) = \mathbb{E} \left[ \frac{\pi (A | S , \theta)}{\beta (A | S)} \nabla_{\theta} \ln \pi (A | S, \theta) \big (q_{\pi} (S, A) - v_{\pi} (S) \big) \right]. $$第三,此时对应的随机梯度算法是
$$ \theta_{t + 1} = \theta_{t} + \alpha_{\theta} \frac{\pi (a_{t} | s_{t} , \theta_{t})}{\beta (a_{t} | s_{t})} \nabla_{\theta} \ln \pi (a_{t} | s_{t}, \theta_{t}) \left(q_{t} (s_{t}, a_{t}) - v_{t} (s_{t})\right), $$其中 $\alpha_{\theta} > 0$ 。第四,类似于On-policy的情况,优势函数 $q_{t}(s,a) - v_{t}(s)$ 可以被时序差分误差所替代,即
$$ q_{t} (s_{t}, a_{t}) - v_{t} (s_{t}) \approx r_{t + 1} + \gamma v_{t} (s_{t + 1}) - v_{t} (s_{t}) \doteq \delta_{t} (s_{t}, a_{t}). $$此时,该算法变成了
$$ \theta_{t + 1} = \theta_{t} + \alpha_{\theta} \frac{\pi (a_{t} | s_{t} , \theta)}{\beta (a_{t} | s_{t})} \nabla_{\theta} \ln \pi (a_{t} | s_{t}, \theta) \delta_{t} (s_{t}, a_{t}). $$其具体步骤在算法10.3中给出。可以看出该算法与A2C算法相似,唯一的区别是在策略更新和值更新步骤都加入了额外的重要性权重。值得注意的是,除了策略更新之外,值更新也通过重要性采样变成了Off-policy的。实际上,重要性采样是一种通用技术,可以应用于诸多基于策略或基于值的算法。最后,算法10.3可以推广得到更多算法,例如可以引入Eligibility trace等[73]。
10.4 确定性演员-评论家#
到目前为止,我们介绍的策略梯度算法都是基于随机策略的,即 $\pi(a|s,\theta)>0$ 对每一个 $(s,a)$ 都成立。实际上,确定性策略也可以在策略梯度方法中使用。这里,“确定性”指的是对于任何一个状态,策略选择某一个动作的概率是1,而选择其他动作的概率都是0。
基于确定性策略的 Actor-Critic 方法被称为确定性 Actor-Critic(deterministic actor-critic)或者确定性策略梯度(deterministic policy gradient)。该方法非常重要,因为它天然就是 Off-policy 的,并且可以有效处理连续动作空间。
具体来说,之前我们一直使用 $\pi (a|s,\theta)$ 来表示一个策略,这个策略可以是随机性的或确定性的。在本节中,我们使用
$$ a = \mu (s, \theta) $$来专门表示一个确定性的策略。 $\mu$ 是从S到A的一个映射,因此会直接输出一个动作。这与之前的 $\pi$ 不同: $\pi$ 输出的是某一个动作的概率。这种确定性策略也可以由神经网络来实现:例如输入是状态s,输出是动作a,参数是 $\theta$ 。简单起见,我们通常将 $\mu(s,\theta)$ 简写为 $\mu(s)$ 。
10.4.1 确定性策略梯度定理#
第9章介绍的策略梯度定理仅适用于随机策略。如果我们要求策略必须为确定性的,那么需要推导新的策略梯度定理。下面首先给出确定性策略梯度定理,再解释如何得到这个定理。
定理10.2 (确定性策略梯度定理)。 $J(\theta)$ 的梯度是
$$ \begin{array}{r l} \nabla_{\theta} J (\theta) & = \sum_{s \in S} \eta (s) \nabla_{\theta} \mu (s) \big (\nabla_{a} q_{\mu} (s, a) \big) | _{a = \mu (s)} \\ & = \mathbb{E} _{S \sim \eta} \left[ \nabla_{\theta} \mu (S) \big (\nabla_{a} q_{\mu} (S, a) \big) | _{a = \mu (S)} \right], \end{array}\tag{10.14} $$其中 $\eta$ 是状态的分布。
定理10.2实际上是后面定理10.3和定理10.4的汇总。由于定理10.3和定理10.4中的结果具有相似的形式,我们在定理10.2中以统一的方式呈现。具体的细节诸如 $J(\theta)$ 和 $\eta$ 的表达式将在定理10.3和定理10.4中给出。
确定性策略梯度方法是Off-policy的。这一点可以从式(10.14)中的梯度表达式看出来。与随机策略情况不同,式(10.14)所示的梯度并不涉及动作随机变量 $A$ 。因此,当我们使用样本来近似该真实梯度时无需动作样本,自然也就不需要关心动作样本是哪个策略产生的,所以生成样本的策略可以和目标策略不同。
另外,一些读者可能会好奇为什么 $\left(\nabla_{a}q_{\mu}(S,a)\right)|_{a = \mu (S)}$ 不能被写作 $\nabla_{a}q_{\mu}(S,\mu (S))?$ 这样看起来不是更简洁吗?如果我们这样做,就看不出来为什么 $q_{\mu}(S,\mu (S))$ 是变量 $a$ 的函数了。当然,我们也可以使用另一个简洁而不会引起混淆的表达式: $\nabla_{a}q_{\mu}(S,a = \mu (S))$ 。
在本节的剩余部分,我们将给出定理10.2的推导细节。我们会推导两个常见目标函数的梯度:第一个目标函数是平均状态值,第二个目标函数是平均奖励值。由于这两个目标函数已经在第9.2节详细讨论过,因此我们有时会不加说明地使用它们的一些性质。
对于大多数读者而言,只要熟悉定理10.2的结论就足够了,而并不需要了解其推导细节。对推导细节感兴趣的读者可以有选择性地阅读本节后面的内容。
目标函数1:平均状态值#
我们首先推导平均状态值的梯度。平均状态值的表达式是
$$ J (\theta) = \mathbb{E} [ v_{\mu} (s) ] = \sum_{s \in \mathcal{S}} d_{0} (s) v_{\mu} (s),\tag{10.15} $$其中 $d_0$ 是状态的概率分布。简单起见,我们可以假设 $d_0$ 是一个与策略 $\mu$ 独立的分布,这样 $d_0$ 对 $\theta$ 的梯度等于0。 $d_0$ 的选择有两种特殊但重要的情形。第一种情形是选择 $d_0(s_0) = 1$ 且 $d_0(s \neq s_0) = 0$ ,其中 $s_0$ 是一个我们感兴趣的特定状态。在这种情况下,学习到的策略旨在最大化从 $s_0$ 出发获得的回报。第二种情形是选择 $d_0$ 为一个给定的行为策略的分布,该行为策略可以与目标策略不同。
为了计算 $J(\theta)$ 的梯度,我们需要首先计算对任意状态 $s \in S$ 的状态值 $v_{\mu}(s)$ 的梯度。
引理10.1 $(v_{\mu}(s)$ 的梯度)。当 $\gamma \in (0,1)$ ,对于任意 $s \in S$ 有
$$ \nabla_{\theta} v_{\mu} (s) = \sum_{s^{\prime} \in \mathcal{S}} \operatorname * {P r} _{\mu} \left(s^{\prime} | s\right) \nabla_{\theta} \mu \left(s^{\prime}\right) \left(\nabla_{a} q_{\mu} \left(s^{\prime}, a\right)\right) | _{a = \mu \left(s^{\prime}\right)},\tag{10.16} $$其中
$$ \operatorname * {P r} _{\mu} (s^{\prime} | s) \doteq \sum_{k = 0} ^{\infty} \gamma^{k} [ P_{\mu} ^{k} ] _{s s^{\prime}} = \left[ (I - \gamma P_{\mu}) ^{- 1} \right] _{s s^{\prime}} $$是在策略 $\mu$ 下从状态 $s$ 转移到状态 $s'$ 的折扣总概率。这里 $[\cdot]_{ss'}$ 代表矩阵中 $s$ 行 $s'$ 列的元素。
由于策略 $\mu$ 是确定性的,我们有
$$ v_{\mu} (s) = q_{\mu} (s, \mu (s)). $$由于 $q_{\mu}$ 和 $\mu$ 都是 $\theta$ 的函数,我们有
$$ \nabla_{\theta} v_{\mu} (s) = \nabla_{\theta} q_{\mu} (s, \mu (s)) = \big (\nabla_{\theta} q_{\mu} (s, a) \big) | _{a = \mu (s)} + \nabla_{\theta} \mu (s) \big (\nabla_{a} q_{\mu} (s, a) \big) | _{a = \mu (s)}.\tag{10.17} $$根据动作价值的定义,对于任何给定的 $(s, a)$ ,我们有
$$ q_{\mu} (s, a) = r (s, a) + \gamma \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) v_{\mu} (s^{\prime}), $$其中 $r(s,a) = \sum_r rp(r|s,a)$ 。由于 $r(s,a)$ 不依赖 $\mu$ ,进而可以得到
$$ \nabla_{\theta} q_{\mu} (s, a) = 0 + \gamma \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) \nabla_{\theta} v_{\mu} (s^{\prime}). $$将上式代入式(10.17)可以得到
$$ \nabla_{\theta} v_{\mu} (s) = \gamma \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, \mu (s)) \nabla_{\theta} v_{\mu} (s^{\prime}) + \underbrace{\nabla_{\theta} \mu (s) (\nabla_{a} q_{\mu} (s , a)) | _{a = \mu (s)}} _{}, \quad s \in \mathcal{S}. $$由于上述方程对所有 $s \in S$ 都成立,因此我们可以将这些方程联立从而得到一个矩阵-向量形式:
$$ \underbrace{\left[ \begin{array}{c} \vdots \\ \nabla_{\theta} v_{\mu} (s) \\ \vdots \end{array} \right]} _{\nabla_{\theta} v_{\mu} \in \mathbb{R} ^{m n}} = \underbrace{\left[ \begin{array}{c} \vdots \\ u (s) \\ \vdots \end{array} \right]} _{u \in \mathbb{R} ^{m n}} + \gamma (P_{\mu} \otimes I_{m}) \underbrace{\left[ \begin{array}{c} \vdots \\ \nabla_{\theta} v_{\mu} (s^{\prime}) \\ \vdots \end{array} \right]} _{\nabla_{\theta} v_{\mu} \in \mathbb{R} ^{m n}}, $$其中 $n = |\mathcal{S}|$ ,参数向量 $\theta$ 的维数为 $m$ , $P_{\mu}$ 是状态转移矩阵, $[P_{\mu}]_{ss'} = p(s'|s, \mu(s))$ , $\otimes$ 是克罗内克积。上述矩阵-向量形式可以简洁地写为
$$ \nabla_{\theta} v_{\mu} = u + \gamma (P_{\mu} \otimes I_{m}) \nabla_{\theta} v_{\mu}. $$由于这是 $\nabla_{\theta}v_{\mu}$ 的一个线性方程,我们可以求解得到
$$ \begin{array}{r} \nabla_{\theta} v_{\mu} = (I_{m n} - \gamma P_{\mu} \otimes I_{m}) ^{- 1} u \\ = (I_{n} \otimes I_{m} - \gamma P_{\mu} \otimes I_{m}) ^{- 1} u \end{array} $$$$ = \left[ (I_{n} - \gamma P_{\mu}) ^{- 1} \otimes I_{m} \right] u.\tag{10.18} $$式(10.18)按元素展开的形式为
$$ \begin{array}{l} \nabla_{\theta} v_{\mu} (s) = \sum_{s^{\prime} \in \mathcal{S}} \left[ (I - \gamma P_{\mu}) ^{- 1} \right] _{s s^{\prime}} u (s^{\prime}) \\ = \sum_{s^{\prime} \in \mathcal{S}} \left[ (I - \gamma P_{\mu}) ^{- 1} \right] _{s s^{\prime}} \left[ \nabla_{\theta} \mu (s^{\prime}) (\nabla_{a} q_{\mu} (s^{\prime}, a)) | _{a = \mu (s^{\prime})} \right]. \end{array}\tag{10.19} $$其中 $\left[(I - \gamma P_{\mu})^{-1}\right]_{ss'}$ 的概率解释如下所述。由于 $(I - \gamma P_{\mu})^{-1} = I + \gamma P_{\mu} + \gamma^{2}P_{\mu}^{2} + \dots$ ,我们有
$$ \left[ (I - \gamma P_{\mu}) ^{- 1} \right] _{s s^{\prime}} = [ I ] _{s s^{\prime}} + \gamma [ P_{\mu} ] _{s s^{\prime}} + \gamma^{2} [ P_{\mu} ^{2} ] _{s s^{\prime}} + \dots = \sum_{k = 0} ^{\infty} \gamma^{k} [ P_{\mu} ^{k} ] _{s s^{\prime}}. $$因为 $[P_{\mu}^{k}]_{ss'}$ 是正好使用 $k$ 步从 $s$ 转移到 $s'$ 步的概率(更多信息可参见方框8.1),所以 $\left[(I - \gamma P_{\mu})^{-1}\right]_{ss'}$ 是使用任意步数从 $s$ 转移到 $s'$ 的折扣总概率。通过令 $\left[(I - \gamma P_{\mu})^{-1}\right]_{ss'} \doteq \Pr_{\mu}(s'|s)$ ,由式(10.19)可以推出式(10.16)。
有了引理10.1,下面可以推导 $J(\theta)$ 的梯度。
定理10.3 (有折扣的情况下的确定性策略梯度定理)。在折扣因子 $\gamma \in (0,1)$ 的情况下,式(10.15)中给出的 $J(\theta)$ 的梯度是
$$ \begin{array}{r l} & {\nabla_{\theta} J (\theta) = \sum_{s \in \mathcal{S}} \rho_{\mu} (s) \nabla_{\theta} \mu (s) \big (\nabla_{a} q_{\mu} (s, a) \big) | _{a = \mu (s)}} \\ & {\qquad = \mathbb{E} _{S \sim \rho_{\mu}} \left[ \nabla_{\theta} \mu (S) \big (\nabla_{a} q_{\mu} (S, a) \big) | _{a = \mu (S)} \right],} \end{array} $$其中状态分布 $\rho_{\mu}$ 是
$$ \rho_{\mu} (s) = \sum_{s^{\prime} \in \mathcal{S}} d_{0} (s^{\prime}) \mathrm{Pr} _{\mu} (s | s^{\prime}), \qquad s \in \mathcal{S}. $$这里 $\mathrm{Pr}_{\mu}(s|s') = \sum_{k=0}^{\infty}\gamma^{k}[P_{\mu}^{k}]_{s's} = \left[(I - \gamma P_{\mu})^{-1}\right]_{s's}$ 是在策略 $\mu$ 下从 $s'$ 转移到 $s$ 的折扣总概率。
由于 $d_{0}$ 与 $\mu$ 无关, $d_{0}$ 对 $\theta$ 的导数为0。因此,我们有
$$ \nabla_{\theta} J (\theta) = \sum_{s \in \mathcal{S}} d_{0} (s) \nabla_{\theta} v_{\mu} (s). $$将引理10.1中给出的 $\nabla_{\theta}v_{\mu}(s)$ 的表达式代入上式可得
$$ \begin{array}{r l} & {{\nabla_{\theta} J (\theta) = \sum_{s \in \mathcal{S}} d_{0} (s) \nabla_{\theta} v_{\mu} (s)}} \\ & {{\quad = \sum_{s \in \mathcal{S}} d_{0} (s) \sum_{s^{\prime} \in \mathcal{S}} \operatorname * {P r} _{\mu} (s^{\prime} | s) \nabla_{\theta} \mu (s^{\prime}) \big (\nabla_{a} q_{\mu} (s^{\prime}, a) \big) | _{a = \mu (s^{\prime})}}} \\ & {{\quad = \sum_{s^{\prime} \in \mathcal{S}} \left(\sum_{s \in \mathcal{S}} d_{0} (s) \operatorname * {P r} _{\mu} (s^{\prime} | s)\right) \nabla_{\theta} \mu (s^{\prime}) \big (\nabla_{a} q_{\mu} (s^{\prime}, a) \big) | _{a = \mu (s^{\prime})}}} \\ & {{\quad \doteq \sum_{s^{\prime} \in \mathcal{S}} \rho_{\mu} (s^{\prime}) \nabla_{\theta} \mu (s^{\prime}) \big (\nabla_{a} q_{\mu} (s^{\prime}, a) \big) | _{a = \mu (s^{\prime})}}} \\ & {{\quad = \sum_{s \in \mathcal{S}} \rho_{\mu} (s) \nabla_{\theta} \mu (s) \big (\nabla_{a} q_{\mu} (s, a) \big) | _{a = \mu (s)} \qquad (\mathrm{将} s^{\prime} \mathrm{更改为} s)}} \\ & {{\quad = \mathbb{E} _{S \sim \rho_{\mu}} \left[ \nabla_{\theta} \mu (S) \big (\nabla_{a} q_{\mu} (S, a) \big) | _{a = \mu (S)} \right].}} \end{array} $$证明完毕。上述证明与文献[74]中的定理1的证明一致。这里我们考虑状态和动作个数有限的情况。当它们是连续的时,证明是类似的,不过此时求和应该换成积分[74]。
目标函数2:平均奖励值#
下面推导平均奖励值的梯度。平均奖励值的定义是
$$ \begin{array}{c} J (\theta) = \bar{r} _{\mu} = \sum_{s \in \mathcal{S}} d_{\mu} (s) r_{\mu} (s) \\ = \mathbb{E} _{S \sim d_{\mu}} [ r_{\mu} (S) ], \end{array}\tag{10.20} $$其中
$$ r_{\mu} (s) = \mathbb{E} [ R | s, a = \mu (s) ] = \sum_{r} r p (r | s, a = \mu (s)) $$是即时奖励的期望值。该目标函数已经在第9.2节有详细介绍,这里不再赘述。
下面的定理给出了 $J(\theta)$ 的梯度。
定理10.4 (无折扣的情况下的确定性策略梯度定理)。在无折扣的情况下,式(10.20)所示的 $J(\theta)$ 的梯度为
$$ \begin{array}{r l} & {\nabla_{\theta} J (\theta) = \sum_{s \in \mathcal{S}} d_{\mu} (s) \nabla_{\theta} \mu (s) \big (\nabla_{a} q_{\mu} (s, a) \big) | _{a = \mu (s)}} \\ & {\qquad = \mathbb{E} _{S \sim d_{\mu}} \left[ \nabla_{\theta} \mu (S) \big (\nabla_{a} q_{\mu} (S, a) \big) | _{a = \mu (S)} \right],} \end{array} $$其中 $d_{\mu}$ 是在策略 $\mu$ 下状态的平稳分布。
由于策略是确定性的,我们有
$$ v_{\mu} (s) = q_{\mu} (s, \mu (s)). $$由于 $q_{\mu}$ 和 $\mu$ 都是 $\theta$ 的函数,我们有
$$ \nabla_{\theta} v_{\mu} (s) = \nabla_{\theta} q_{\mu} (s, \mu (s)) = (\nabla_{\theta} q_{\mu} (s, a)) | _{a = \mu (s)} + \nabla_{\theta} \mu (s) (\nabla_{a} q_{\mu} (s, a)) | _{a = \mu (s)}.\tag{10.21} $$在无折扣的情况下,根据动作值的定义(参见第9.3.2节),我们有
$$ \begin{array}{r l} q_{\mu} (s, a) & = \mathbb{E} [ R_{t + 1} - \bar{r} _{\mu} + v_{\mu} (S_{t + 1}) | s, a ] \\ & = \sum_{r} p (r | s, a) (r - \bar{r} _{\mu}) + \sum_{s^{\prime}} p (s^{\prime} | s, a) v_{\mu} (s^{\prime}) \\ & = r (s, a) - \bar{r} _{\mu} + \sum_{s^{\prime}} p (s^{\prime} | s, a) v_{\mu} (s^{\prime}). \end{array} $$由于 $r(s, a) = \sum_{r} rp(r|s, a)$ 不依赖于 $\theta$ ,我们有
$$ \nabla_{\theta} q_{\mu} (s, a) = 0 - \nabla_{\theta} \bar{r} _{\mu} + \sum_{s^{\prime}} p (s^{\prime} | s, a) \nabla_{\theta} v_{\mu} (s^{\prime}). $$将上式代入式(10.21)可得
$$ \nabla_{\theta} v_{\mu} (s) = - \nabla_{\theta} \bar{r} _{\mu} + \sum_{s^{\prime}} p (s^{\prime} | s, \mu (s)) \nabla_{\theta} v_{\mu} (s^{\prime}) + \underbrace{\nabla_{\theta} \mu (s) \big (\nabla_{a} q_{\mu} (s , a) \big) | _{a = \mu (s)}} _{u (s)}, s \in \mathcal{S}. $$因为上述方程对所有 $s \in S$ 都成立,所以我们可以将这些方程联立从而得到一个矩阵-向量形式:
$$ \underbrace{\left[ \begin{array}{c} \vdots \\ \nabla_{\theta} v_{\mu} (s) \\ \vdots \end{array} \right]} _{\nabla_{\theta} v_{\mu} \in \mathbb{R} ^{m n}} = - \mathbf{1} _{n} \otimes \nabla_{\theta} \bar{r} _{\mu} + (P_{\mu} \otimes I_{m}) \underbrace{\left[ \begin{array}{c} \vdots \\ \nabla_{\theta} v_{\mu} (s^{\prime}) \\ \vdots \end{array} \right]} _{\nabla_{\theta} v_{\mu} \in \mathbb{R} ^{m n}} + \underbrace{\left[ \begin{array}{c} \vdots \\ u (s) \\ \vdots \end{array} \right]} _{u \in \mathbb{R} ^{m n}}, $$其中 $n = |\mathcal{S}|$ ,参数向量 $\theta$ 的维度为 $m$ , $P_{\mu}$ 是状态转换矩阵, $[P_{\mu}]_{ss'} = p(s'|s, \mu(s))$ , $\otimes$ 是克罗内克积。上述矩阵-向量形式可以简写为
$$ \nabla_{\theta} v_{\mu} = u - \mathbf{1} _{n} \otimes \nabla_{\theta} \bar{r} _{\mu} + (P_{\mu} \otimes I_{m}) \nabla_{\theta} v_{\mu}. $$上式可转换为
$$ \mathbf{1} _{n} \otimes \nabla_{\theta} \bar{r} _{\mu} = u + (P_{\mu} \otimes I_{m}) \nabla_{\theta} v_{\mu} - \nabla_{\theta} v_{\mu}.\tag{10.22} $$因为 $d_{\mu}$ 是平稳分布,所以它满足 $d_{\mu}^{\mathrm{T}}P_{\mu} = d_{\mu}^{\mathrm{T}}$ 。在式(10.22)两边同时乘以 $d_{\mu}^{\mathrm{T}} \otimes I_m$ 可得
$$ \begin{array}{r l} (d_{\mu} ^{\mathrm{T}} \mathbb{1} _{n}) \otimes \nabla_{\theta} \bar{r} _{\mu} & = d_{\mu} ^{\mathrm{T}} \otimes I_{m} u + (d_{\mu} ^{\mathrm{T}} P_{\mu}) \otimes I_{m} \nabla_{\theta} v_{\mu} - d_{\mu} ^{\mathrm{T}} \otimes I_{m} \nabla_{\theta} v_{\mu} \\ & = d_{\mu} ^{\mathrm{T}} \otimes I_{m} u + d_{\mu} ^{\mathrm{T}} \otimes I_{m} \nabla_{\theta} v_{\mu} - d_{\mu} ^{\mathrm{T}} \otimes I_{m} \nabla_{\theta} v_{\mu} \\ & = d_{\mu} ^{\mathrm{T}} \otimes I_{m} u. \end{array} $$因为 $d_{\mu}^{\mathrm{T}}\mathbb{1}_n = 1$ ,上述方程可以变换为
$$ \begin{array}{r l} & {\nabla_{\theta} \bar{r} _{\mu} = d_{\mu} ^{\mathrm{T}} \otimes I_{m} u} \\ & {\qquad = \sum_{s \in \mathcal{S}} d_{\mu} (s) u (s)} \\ & {\qquad = \sum_{s \in \mathcal{S}} d_{\mu} (s) \nabla_{\theta} \mu (s) (\nabla_{a} q_{\mu} (s, a)) | _{a = \mu (s)}} \\ & {\qquad = \mathbb{E} _{S \sim d_{\mu}} [ \nabla_{\theta} \mu (S) (\nabla_{a} q_{\mu} (S, a)) | _{a = \mu (S)} ].} \end{array} $$证明完毕。
10.4.2 算法描述#
基于定理10.2中给出的梯度,我们可以应用梯度上升算法来最大化 $J(\theta)$ :
$$ \theta_{t + 1} = \theta_{t} + \alpha_{\theta} \mathbb{E} _{S \sim \eta} \left[ \nabla_{\theta} \mu (S) \big (\nabla_{a} q_{\mu} (S, a) \big) | _{a = \mu (S)} \right]. $$相应的随机梯度上升算法是
$$ \theta_{t + 1} = \theta_{t} + \alpha_{\theta} \nabla_{\theta} \mu (s_{t}) \big (\nabla_{a} q_{\mu} (s_{t}, a) \big) | _{a = \mu (s_{t})}. $$具体的实施步骤可参见算法10.4。下面是对该算法的一些解释说明。
第一,该算法是Off-policy的,这是因为行为策略 $\beta$ 可能与目标策略 $\mu$ 不同。具体来说,这里Actor是Off-policy的,我们在介绍定理10.2时已经解释过原因;这里Critic也是Off-policy的。有的读者可能会问为什么这里Critic是Off-policy却不需要重要性采样呢?这是因为Critic需要的经验样本是 $(s_t, a_t, r_{t+1}, s_{t+1}, \tilde{a}_{t+1})$ ,其中 $\tilde{a}_{t+1} = \mu(s_{t+1})$ 。这个经验样本的生成涉及两个策略:第一个是在 $s_t$ 生成 $a_t$ 的策略,第二个是在 $s_{t+1}$ 生成 $\tilde{a}_{t+1}$ 的策略。其中生成 $a_t$ 的策略是行为策略,因为 $a_t$ 用于与环境交互;而生成 $\tilde{a}_{t+1}$ 的策略是目标策略 $\mu$ ,它也是Critic要评价的策略。值得注意的是, $\tilde{a}_{t+1}$ 不会在下一个时刻执行,因此 $\mu$ 不是行为策略。综上所述,这里Critic是Off-policy的。
第二,如何选择函数 $q(s, a, w)$ ?最初提出确定性策略梯度方法的工作[74]采用了线性函数 $q(s, a, w) = \phi^{\mathrm{T}}(s, a)w$ ,其中 $\phi(s, a)$ 是特征向量。目前主流的做法是使用神经网络来表示 $q(s, a, w)$ ,例如深度确定性策略梯度(deep deterministic policy gradient, DDPG)算法[75]。
第三,如何选择行为策略 $\beta$ ?它可以是任何探索性策略,也可以是通过给 $\mu$ 添加噪声获得的随机策略[75]。
10.5 总结#
本章介绍了多种 Actor-Critic 算法。
◇ 第10.1节介绍了一种称为QAC的最简单的Actor-Critic算法。该算法与上一章介绍的策略梯度算法REINFORCE非常类似,唯一的区别在于QAC中的q值的估计依赖于时序差分方法,而REINFORCE依赖于蒙特卡罗方法。
◇ 第10.2节将 QAC 推广到了优势 Actor-Critic 算法。我们证明了当引入额外的基准函数时策略梯度是不变的,然后给出了最优的基准函数,从而可以减小估计的方差。
◇ 第10.3节将优势 Actor-Critic 算法扩展到了 Off-policy 的情况。为了做到这一点,我们介绍了一种称为重要性采样的重要技术。
◇ 之前介绍的策略梯度算法都依赖于随机策略,而第10.4节展示了策略梯度方法中的策略也可以被强制限制为确定性的。我们推导了相应的确定性策略梯度,并且给出了确定性策略梯度算法。
策略梯度和 Actor-Critic 方法在现代强化学习中被广泛使用。文献中有许多先进的算法,如 SAC[76, 77]、TRPO[78]、PPO[79]、TD3[80] 等。此外,单智能体情况也可以扩展到多智能体强化学习情况(multi-agent reinforcement learning, MARL)[81-85]。经验样本也可用于估计系统模型,从而实现基于模型的强化学习(model-based reinforcement learning, MBRL)[15, 86, 87]。分布式强化学习(distributional reinforcement learning)提供了一个与传统强化学习不同的视角 [88, 89]。强化学习与控制理论之间的关系在 [90-95] 中有讨论。本书无法涵盖所有主题,不过相信本书能为读者未来的学习和研究奠定良好的基础。
10.6 问答#
◇ 提问:Actor-Critic算法与策略梯度算法之间的关系是什么?
回答:Actor-Critic算法实际上就是策略梯度方法。任何策略梯度算法在更新策略的同时也需要估计状态值或者动作值。此时,如果我们使用基于值函数的时序差分算法,那么这样的算法被称为Actor-Critic。“Actor-Critic”这个名称强调了算法的结构,说明了其结合了策略更新(actor)和价值更新(critic)的模块。实际上,策略更新和价值更新也是所有强化学习算法的两大基本模块,只不过不同算法中这两者的具体实现有所不同。
◇ 提问:为什么在 Actor-Critic 方法需要引入额外的基准函数呢?
回答:由于引入额外的基准函数并不会改变策略梯度,因此我们可以利用该基准函数来减少估计的方差,由此产生的算法称为优势 Actor-Critic。
◇ 提问:除了基于策略的算法外,重要性采样可以应用到基于值的算法中吗?#
答案:可以的。这是因为重要性采样是一种通用技术,它可以使用由一个概率分布得到的样本来估计另一个概率分布的期望值。实际上,强化学习中的许多问题本质上都是期望值估计问题。例如,在基于值的方法中,动作值或状态值被定义为期望值;在基于策略的方法中,真实策略梯度也是一个期望值。因此,重要性采样可以用在基于值或基于策略的算法中。实际上,它已经在算法10.3中被应用于价值更新了。
◇ 提问:为什么确定性策略梯度方法是 Off-policy 的?#
回答:如果策略是确定性的,那么相应的策略梯度并不涉及动作的随机变量。因此,当我们使用样本来近似真实梯度时,就不需要动作样本。详细解释可以参见正文。