第9章 · 策略梯度方法#
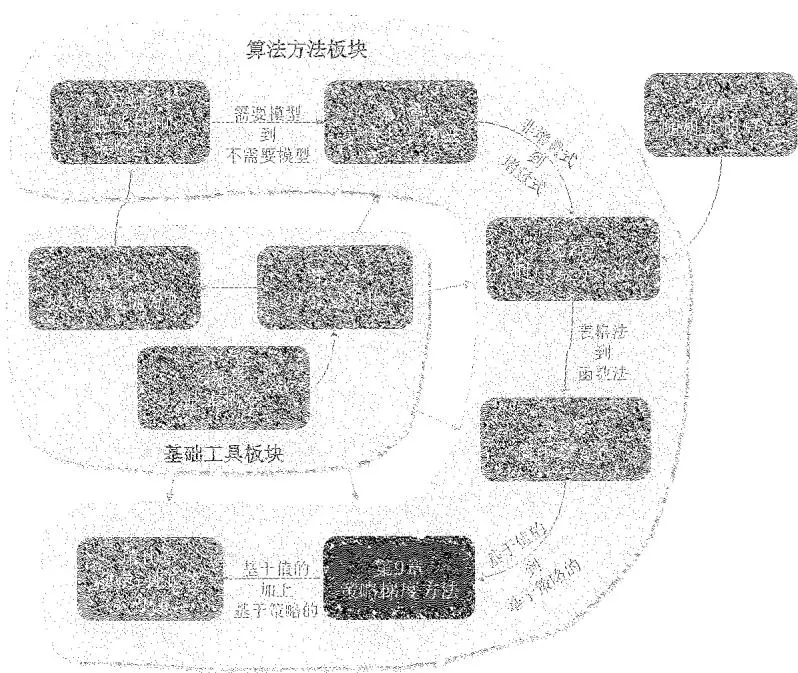
图 9.1 本章在全书中的位置。
上一章介绍了用函数表示值的方法,本章将介绍用函数表示策略的方法。当用函数表示策略时,我们可以选择一个目标函数,进而优化该目标函数以得到最优策略。这种方法被称为策略梯度(policy gradient)。策略梯度方法是基于策略的(policy-based),而本书之前的所有章节介绍的方法都是基于值的(value-based)。这两者有什么区别呢?其本质区别在于基于策略的方法是直接优化关于策略参数的目标函数,从而得到最优策略;而基于值的方法是通过先估计值再得到最优策略的。具体的区别大家学完本章就会清楚了。
9.1 策略表示:从表格到函数#
在本书之前的章节中,策略都是用表格来表示的:所有状态的动作概率都存储在一个表格中,参见表9.1。实际上,策略也可以用函数来表示,记为 $\pi (a|s,\theta)$ ,其中 $\theta \in \mathbb{R}^m$ 是参数向量。该策略函数也可以写成其他形式,如 $\pi_{\theta}(a|s)$ 、 $\pi_{\theta}(a,s)$ 、 $\pi (a,s,\theta)$ 。
表 9.1 用表格来表示策略。
我们首先说明表格法和函数法之间的区别。
◇ 第一,定义最优策略的方式不同。
当用表格描述策略时,最优策略的定义是它能够最大化所有状态的状态值,即其状态值大于或等于其他任意策略的状态值。当用函数描述策略时,最优策略的定义是它能够最大化一个标量目标函数。至于是什么标量目标函数,后面将详细介绍。
◇ 第二,更新策略的方式不同。
当用表格描述策略时,可以通过直接改变表格中的元素来直接更新选择某些动作的概率。当用函数描述策略时,不能再以这种方式更新策略,而只能通过改变函数参数 $\theta$ 来间接更新选择某些动作的概率。
◇ 第三,查看动作概率的方式不同。
当用表格描述策略时,可以通过查看表格中相应的元素直接获得某个动作的概率。当用函数描述策略时,我们需要将 $(s, a)$ 输入到函数中,通过计算函数值来获得其
(b)
概率(见图9.2(a))。当然,函数的结构可能多种多样。例如,我们也可以输入一个状态,然后输出所有动作的概率(见图9.2(b))。
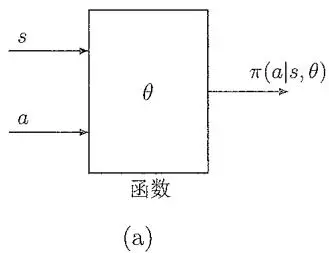
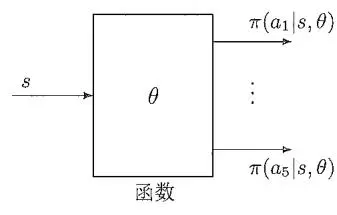
图9.2 用函数来表示策略。这些函数可能有不同的结构。
由于上面的几点不同,使用函数表示策略具有诸多优势,例如它在处理大型状态-动作空间时更加高效,也具有更强的泛化能力。其原因与用函数表示值是类似的,这里不再赘述。
当用函数表示策略时,我们的任务是最大化一个标量目标函数 $J(\theta)$ ,其中 $\theta$ 代表策略函数的参数。不同参数对应不同的目标函数值,因此我们需要找到最优的参数从而优化该目标函数。最简单的优化方法是梯度上升:
$$ \theta_{t + 1} = \theta_{t} + \alpha \nabla_{\theta} J (\theta_{t}), $$其中 $\nabla_{\theta}J$ 是 $J$ 相对于 $\theta$ 的梯度, $\alpha > 0$ 是步长。
这实际上就是策略梯度方法的基本思想。虽然这个基本思想非常简单,但是想要理解其中的细节还是要花一些功夫的。我们将在本章剩余部分详细回答以下三个问题。
◇ 第一,应该使用什么目标函数?(第9.2节)
◇ 第二,如何计算目标函数的梯度?(第9.3节)
◇ 第三,如何使用经验样本来计算梯度并优化目标函数?(第9.4节)
9.2 目标函数:定义最优策略#
在策略梯度方法中,用于定义最优策略的目标函数有如下两种。
目标函数1:平均状态值
第一个常见的目标函数是平均状态值,其定义为
$$ \bar{v} _{\pi} = \sum_{s \in \mathcal{S}} d (s) v_{\pi} (s), $$其中 $d(s)$ 是状态 $s$ 的权重,它满足对任何 $s \in S$ 有 $d(s) \geqslant 0$ 且 $\sum_{s \in S} d(s) = 1$ 。因此,权重 $d(s)$ 也可以理解为状态 $s$ 的概率分布,那么该目标函数可以重写为
$$ \bar{v} _{\pi} = \mathbb{E} _{S \sim d} [ v_{\pi} (S) ]. $$顾名思义, $\bar{v}_{\pi}$ 是所有状态值的加权平均。不同的 $\theta$ 值将导致不同的 $\bar{v}_{\pi}$ 值。我们的任务是找到一个最优策略(即最优的 $\theta$ )来最大化 $\bar{v}_{\pi}$ 。
在该目标函数中,如何选择概率分布 $d(s)$ 呢?有如下两种常见情况。
◇ 第一,d 与策略 $\pi$ 无关,此时该目标函数对策略参数求梯度不需要考虑 d,因此这种情况最为简单。在此情况下,我们特别地用 $d_{0}$ 来代替 d,用 $\bar{v}_{\pi}^{0}$ 来代替 $\bar{v}_{\pi}$ ,以表明该概率分布与策略无关。
例如,如果我们认为所有状态的重要性相同,那么可以选择 $d_0(s) = 1 / |\mathcal{S}|$ 。如果我们只对某个特定状态 $s_0$ 感兴趣(例如智能体始终从 $s_0$ 出发),那么可以设计
$$ d_{0} (s_{0}) = 1, \quad d_{0} (s \neq s_{0}) = 0. $$此时 $\bar{v}_{\pi} = v_{\pi}(s_0)$ ,优化该目标函数就是优化从 $s_0$ 出发的回报期望值。
第二, $d$ 与策略 $\pi$ 有关。此时常见的选择是将 $d$ 设为 $d_{\pi}$ ,即在 $\pi$ 下的平稳分布。如何理解这一选择呢?平稳分布反映了在给定策略下马尔可夫决策过程的长期行为。如果一个状态在长期内经常被访问,则其重要性高,应该有更高的权重;如果一个状态很少被访问,则其重要性低,应该有较低的权重。
$d_{\pi}$ 的一个基本性质是 $d_{\pi}^{\mathrm{T}}P_{\pi} = d_{\pi}^{\mathrm{T}}$ 。其中 $P_{\pi}$ 是状态转移概率矩阵。我们已经详细介绍过平稳分布了,更多信息可参见方框8.1。
下面介绍 $\bar{v}_{\pi}$ 的两个等价表达式。特别是第一个表达式,大家在文献中会经常遇到。
◇ 等价表达式1:假设智能体根据给定策略 $\pi(\theta)$ 收集了一个奖励序列 $\{R_{t+1}\}_{t=0}^{\infty}$ 。大家会经常在文献中看到如下目标函数:
$$ J (\theta) = \lim_{n \rightarrow \infty} \mathbb{E} \left[ \sum_{t = 0} ^{n} \gamma^{t} R_{t + 1} \right] = \mathbb{E} \left[ \sum_{t = 0} ^{\infty} \gamma^{t} R_{t + 1} \right].\tag{9.1} $$虽然这个目标函数乍一看难以理解,但它实际上就是平均状态值 $\bar{v}_{\pi}$ ,这是因为
$$ \begin{array}{r l} & {\mathbb{E} \left[ \sum_{t = 0} ^{\infty} \gamma^{t} R_{t + 1} \right] = \sum_{s \in \mathcal{S}} d (s) \mathbb{E} \left[ \sum_{t = 0} ^{\infty} \gamma^{t} R_{t + 1} | S_{0} = s \right]} \\ & {\qquad = \sum_{s \in \mathcal{S}} d (s) v_{\pi} (s)} \\ & {\qquad = \bar{v} _{\pi}.} \end{array} $$上式中的第一个等号是根据总期望定律(law of total expectation),第二个等号是根据状态值的定义。
◇ 等价表达式2:目标函数 $\bar{v}_{\pi}$ 也可以重写为两个向量的内积。令
$$ v_{\pi} = [ \dots , v_{\pi} (s), \dots ] ^{\mathrm{T}} \in \mathbb{R} ^{| \mathcal{S} |}, $$$$ d = [ \dots , d (s), \dots ] ^{\mathrm{T}} \in \mathbb{R} ^{| \mathcal{S} |}. $$那么有
$$ \bar{v} _{\pi} = d^{\mathrm{T}} v_{\pi}. $$这个表达式在分析其梯度时十分有用。
目标函数2:平均奖励
第二个常见的目标函数是平均奖励(average reward)[2, 64, 65]。它的定义是
$$ \begin{array}{l} \bar{r} _{\pi} \doteq \sum_{s \in \mathcal{S}} d_{\pi} (s) r_{\pi} (s) \\ = \mathbb{E} _{S \sim d_{\pi}} [ r_{\pi} (S) ], \end{array}\tag{9.2} $$其中 $d_{\pi}$ 是平稳分布,另外
$$ r_{\pi} (s) \doteq \sum_{a \in \mathcal{A}} \pi (a | s, \theta) r (s, a) = \mathbb{E} _{A \sim \pi (s, \theta)} [ r (s, A) | s ]\tag{9.3} $$是从状态 $s$ 出发的(单步)即时奖励的期望值。这里 $r(s, a) \doteq \mathbb{E}[R|s, a] = \sum_{r} rp(r|s, a)$ 。
下面介绍 $\bar{r}_{\pi}$ 的两个等价表达式。特别是第一个表达式,大家在文献中会经常遇到。
等价表达式1:假设智能体根据给定策略 $\pi (\theta)$ 收集到一个奖励序列 $\{R_{t + 1}\}_{t = 0}^{\infty}$ 。大家可能经常在文献中看到如下目标函数:
$$ J (\theta) = \lim_{n \to \infty} \frac{1}{n} \mathbb{E} \left[ \sum_{t = 0} ^{n - 1} R_{t + 1} \right].\tag{9.4} $$虽然这个目标函数乍一看很复杂,特别是其中还涉及求极限,但它实际上就是平均奖励 $\bar{r}_{\pi}$ ,这是因为
$$ \lim_{n \to \infty} \frac{1}{n} \mathbb{E} \left[ \sum_{t = 0} ^{n - 1} R_{t + 1} \right] = \sum_{s \in \mathcal{S}} d_{\pi} (s) r_{\pi} (s) = \bar{r} _{\pi}.\tag{9.5} $$式(9.5)的证明可参见方框9.1。
◇ 等价表达式2:平均奖励 $\bar{r}_{\pi}$ 也可以表示为两个向量的内积。令
$$ r_{\pi} = [ \dots , r_{\pi} (s), \dots ] ^{\mathrm{T}} \in \mathbb{R} ^{| \mathcal{S} |}, $$$$ d_{\pi} = [ \dots , d_{\pi} (s), \dots ] ^{\mathrm{T}} \in \mathbb{R} ^{| \mathcal{S} |}, $$其中 $r_{\pi}(s)$ 在式(9.3)中给出。不难看出
$$ \bar{r} _{\pi} = \sum_{s \in \mathcal{S}} d_{\pi} (s) r_{\pi} (s) = d_{\pi} ^{\mathrm{T}} r_{\pi}. $$这个表达式在分析其梯度时将会很有用。
第一步,证明以下方程对任何起始状态 $s_0 \in S$ 都是成立的:
$$ \bar{r} _{\pi} = \lim_{n \to \infty} \frac{1}{n} \mathbb{E} \left[ \sum_{t = 0} ^{n - 1} R_{t + 1} | S_{0} = s_{0} \right].\tag{9.6} $$为此,首先注意到
$$ \begin{array}{r l} \lim_{n \to \infty} \frac{1}{n} \mathbb{E} \left[ \sum_{t = 0} ^{n - 1} R_{t + 1} | S_{0} = s_{0} \right] & = \lim_{n \to \infty} \frac{1}{n} \sum_{t = 0} ^{n - 1} \mathbb{E} \left[ R_{t + 1} | S_{0} = s_{0} \right] \\ & = \lim_{t \to \infty} \mathbb{E} \left[ R_{t + 1} | S_{0} = s_{0} \right], \end{array}\tag{9.7} $$其中最后一个等号是根据 Cesaro 均值的性质(也称为 Cesaro 求和)。具体来说,如果 $\{a_{k}\}_{k=1}^{\infty}$ 是一个收敛序列并且极限 $\lim_{k\to\infty}a_{k}$ 存在,那么 $\{1/n\sum_{k=1}^{n}a_{k}\}_{n=1}^{\infty}$ 也是一个收敛序列,并且有 $\lim_{n\to\infty}1/n\sum_{k=1}^{n}a_{k}=\lim_{k\to\infty}a_{k}$ 。
下面分析式(9.7)中的 $\mathbb{E}[R_{t + 1}|S_0 = s_0]$ 。根据总期望定律可得
$$ \begin{array}{r l} \mathbb{E} \left[ R_{t + 1} | S_{0} = s_{0} \right] & = \sum_{s \in \mathcal{S}} \mathbb{E} \left[ R_{t + 1} | S_{t} = s, S_{0} = s_{0} \right] p^{(t)} (s | s_{0}) \\ & = \sum_{s \in \mathcal{S}} \mathbb{E} \left[ R_{t + 1} | S_{t} = s \right] p^{(t)} (s | s_{0}) \\ & = \sum_{s \in \mathcal{S}} r_{\pi} (s) p^{(t)} (s | s_{0}), \end{array} $$其中 $p^{(t)}(s|s_0)$ 表示从 $s_0$ 开始后恰好使用 $t$ 步转移到 $s$ 的概率。上式中的第二个等号是由于马尔可夫性质:下一时刻获得的奖励只依赖于当前状态而与之前的状态无关。根据平稳分布的定义可得
$$ \lim_{t \to \infty} p^{(t)} (s | s_{0}) = d_{\pi} (s). $$上式表明不论从哪个状态出发,最终转移到 $s$ 的概率都是 $d_{\pi}(s)$ 。因此,我们有
$$ \lim_{t \to \infty} \mathbb{E} \left[ R_{t + 1} | S_{0} = s_{0} \right] = \lim_{t \to \infty} \sum_{s \in \mathcal{S}} r_{\pi} (s) p^{(t)} (s | s_{0}) = \sum_{s \in \mathcal{S}} r_{\pi} (s) d_{\pi} (s) = \bar{r} _{\pi}. $$将上式代入式(9.7)可得式(9.6)。
第二步,考虑任意的状态分布向量 d。根据总期望定律有
$$ \begin{array}{r l r} & & {\underset{n \to \infty} {\lim} \frac{1}{n} \mathbb{E} \left[ \sum_{t = 0} ^{n - 1} R_{t + 1} \right] = \underset{n \to \infty} {\lim} \frac{1}{n} \sum_{s \in \mathcal{S}} d (s) \mathbb{E} \left[ \sum_{t = 0} ^{n - 1} R_{t + 1} | S_{0} = s \right]} \\ & & {= \sum_{s \in \mathcal{S}} d (s) \underset{n \to \infty} {\lim} \frac{1}{n} \mathbb{E} \left[ \sum_{t = 0} ^{n - 1} R_{t + 1} | S_{0} = s \right].} \end{array} $$将式(9.6)代入上述方程可得
$$ \lim_{n \to \infty} \frac{1}{n} \mathbb{E} \left[ \sum_{t = 0} ^{n - 1} R_{t + 1} \right] = \sum_{s \in \mathcal{S}} d (s) \bar{r} _{\pi} = \bar{r} _{\pi}. $$上式中第二个等号是因为 $\sum_{s\in S}d(s) = 1$ 。证明完毕。
小结#
到目前为止,我们介绍了两种目标函数: $\bar{v}_{\pi}$ 和 $\bar{r}_{\pi}$ 。每种目标函数都有几种不同但等价的表达式,见表9.2。另外,我们有时用 $\bar{v}_{\pi}$ 特指状态分布是稳定分布 $d_{\pi}$ 的情况,而用 $\bar{v}_{\pi}^{0}$ 特指分布 $d_{0}$ 与 $\pi$ 无关的情况。下面是对这些目标函数的一些补充说明。
表 9.2 $\bar{v}_{\pi}$ 和 $\bar{r}_{\pi}$ 的不同但等价的表达式。
| 目标函数 | 表达式1 | 表达式2 | 表达式3 |
| $\bar{v}_{\pi}$ | $\sum_{s \in S} d(s) v_{\pi}(s)$ | $\mathbb{E}_{S \sim d}[v_{\pi}(S)]$ | $\lim_{n \to \infty} \mathbb{E}\left[\sum_{t=0}^{n} \gamma^{t} R_{t+1}\right]$ |
| $\bar{r}_{\pi}$ | $\sum_{s \in S} d_{\pi}(s) r_{\pi}(s)$ | $\mathbb{E}_{S \sim d_{\pi}}[r_{\pi}(S)]$ | $\lim_{n \to \infty} \frac{1}{n} \mathbb{E}\left[\sum_{t=0}^{n-1} R_{t+1}\right]$ |
◇ 第一,所有这些目标函数都是 $\pi$ 的函数。由于 $\pi$ 是由 $\theta$ 参数化的,因此这些目标函数是 $\theta$ 的函数。不同的 $\theta$ 值会得到不同的目标函数值,我们的任务是寻找最优的 $\theta$ 来最大化这些目标函数,这就是策略梯度方法的基本思想。
◇ 第二,这两个目标函数 $\bar{v}_{\pi}$ 和 $\bar{r}_{\pi}$ 在 $\gamma < 1$ 的情况下是等价的,这是因为
$$ \bar{r} _{\pi} = (1 - \gamma) \bar{v} _{\pi}. $$上式表明这两个目标函数可以同时被最大化,因此我们不需要纠结究竟选用哪个目标函数。为什么上式成立?证明见后面的引理9.1。不过,当 $\gamma = 1$ 时,情况会比较复杂,后面也会有详细介绍。
9.3 目标函数的梯度#
为了最大化上一节介绍的目标函数,可以使用梯度上升的方法。为此,需要首先计算这些目标函数的梯度。下面的定理给出了目标函数梯度的表达式,它也是本章最重要的理论结果。
定理9.1(策略梯度定理)。 $J(\theta)$ 的梯度是
$$ \nabla_{\theta} J (\theta) = \sum_{s \in \mathcal{S}} \eta (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a),\tag{9.8} $$其中 $\eta$ 是状态的概率分布, $\nabla_{\theta}\pi$ 是 $\pi$ 关于 $\theta$ 的梯度。此外,式(9.8)有如下等价的形式:
$$ \nabla_{\theta} J (\theta) = \mathbb{E} _{S \sim \eta , A \sim \pi (S, \theta)} \Big [ \nabla_{\theta} \ln \pi (A | S, \theta) q_{\pi} (S, A) \Big ],\tag{9.9} $$其中 $\ln$ 是自然对数。
下面是关于定理9.1的一些重要说明。
◇ 第一,需要特别注意的是,定理9.1是对定理9.2、定理9.3、定理9.5的汇总。虽然这三个定理是针对不同场景的,但是因为这些不同场景中的梯度的表达式都类似,所以为了方便阅读汇总得到了定理9.1。其中 $J(\theta)$ 和 $\eta$ 的具体表达式并没有给出,而是分别在定理9.2、定理9.3、定理9.5中给出。不同定理中, $J(\theta)$ 和 $\eta$ 可能不同,例如 $J(\theta)$ 可以是 $\bar{v}_{\pi}^{0}$ 、 $\bar{v}_{\pi}$ 或 $\bar{r}_{\pi}$ ,而且式(9.8)可能变成严格的等式或一个近似。
推导目标函数的梯度是策略梯度方法中最复杂的部分。对于大部分读者来说,熟悉定理9.1中的基本结论已经足够了,而不需要了解其证明过程。特别感兴趣的读者可以详细阅读9.3.1节和9.3.2节,其中数学推导和分析较多,建议读者根据自己的兴趣有选择性地学习。
◇ 第二,表达式(9.9)比式(9.8)往往更受欢迎。这是因为它是以期望形式表达的,后面我们将看到这个带有期望的真实的梯度可以通过随机梯度来近似。
为什么式(9.8)可以等价写成式(9.9)? 证明如下。根据期望的定义,(9.8)可以重写为
$$ \begin{array}{r l} & {\nabla_{\theta} J (\theta) = \sum_{s \in \mathcal{S}} \eta (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a)} \\ & {\qquad = \mathbb{E} _{S \sim \eta} \left[ \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | S, \theta) q_{\pi} (S, a) \right].} \end{array}\tag{9.10} $$考虑函数 $\ln \pi (a|s,\theta)$ ,其梯度是
$$ \nabla_{\theta} \ln \pi (a | s, \theta) = \frac{\nabla_{\theta} \pi (a | s , \theta)}{\pi (a | s , \theta)}. $$上式可写成
$$ \nabla_{\theta} \pi (a | s, \theta) = \pi (a | s, \theta) \nabla_{\theta} \ln \pi (a | s, \theta).\tag{9.11} $$将式(9.11)代入式(9.10)可得
$$ \begin{array}{r l} & {\nabla_{\theta} J (\theta) = \mathbb{E} \left[ \sum_{a \in \mathcal{A}} \pi (a | S, \theta) \nabla_{\theta} \ln \pi (a | S, \theta) q_{\pi} (S, a) \right]} \\ & {\qquad = \mathbb{E} _{S \sim \eta , A \sim \pi (S, \theta)} \Big [ \nabla_{\theta} \ln \pi (A | S, \theta) q_{\pi} (S, A) \Big ].} \end{array} $$◇ 第三,自然对数 $\ln$ 要求 $\pi(a|s,\theta)$ 对所有 $(s,a)$ 都满足 $\pi(a|s,\theta)>0$ (而不能出现 $\pi(a|s,\theta)=0$ ),因此这个策略必须是随机且探索性的,这可以通过使用 Softmax 函数来实现:
$$ \pi (a | s, \theta) = \frac{e^{h (s , a , \theta)}}{\sum_{a^{\prime} \in \mathcal{A}} e^{h (s , a^{\prime} , \theta)}}, \quad a \in \mathcal{A},\tag{9.12} $$其中 $h(s,a,\theta)$ 是一个特征函数,表示在状态 $s$ 选择动作 $a$ 的优先度。式(9.12)中的策略满足 $\pi (a|s,\theta)\in (0,1)$ 并且 $\sum_{a\in \mathcal{A}}\pi (a|s,\theta) = 1$ 对任何 $s\in \mathcal{S}$ 都成立。这个策略可以通过神经网络实现:网络的输入是 $s$ ,输出层是一个Softmax层,因此网络输出所有动作的概率为 $\pi (a|s,\theta)$ ,并且输出的总和等于1,参见图9.2(b)。
9.3.1 推导策略梯度:有折扣的情况#
下面开始推导目标函数的梯度。首先我们考虑有折扣的情况,即 $\gamma \in (0,1)$ ,这也是到目前为止本书一直考虑的情况。此时,状态值和动作值的定义是
$$ \begin{array}{r} v_{\pi} (s) = \mathbb{E} [ R_{t + 1} + \gamma R_{t + 2} + \gamma^{2} R_{t + 3} + \dots | S_{t} = s ], \\ q_{\pi} (s, a) = \mathbb{E} [ R_{t + 1} + \gamma R_{t + 2} + \gamma^{2} R_{t + 3} + \dots | S_{t} = s, A_{t} = a ]. \end{array} $$并且它们满足 $v_{\pi}(s) = \sum_{a\in \mathcal{A}}\pi (a|s,\theta)q_{\pi}(s,a)$ 。
第一,我们证明 $\bar{v}_{\pi}(\theta)$ 是与 $\bar{r}_{\pi}(\theta)$ 等价的目标函数。
引理9.1 $(\bar{v}_{\pi}(\theta)$ 与 $\bar{r}_{\pi}(\theta)$ 等价)。在有折扣的情况下,即当 $\gamma \in (0,1)$ 时,有
$$ \bar{r} _{\pi} = (1 - \gamma) \bar{v} _{\pi}.\tag{9.13} $$因此, $\bar{v}_{\pi}(\theta)$ 和 $\bar{r}_{\pi}(\theta)$ 可以被同时最大化。
证明:注意到 $\bar{v}_{\pi}(\theta) = d_{\pi}^{\mathrm{T}}v_{\pi}$ 并且 $\bar{r}_{\pi}(\theta) = d_{\pi}^{\mathrm{T}}r_{\pi}$ ,其中 $v_{\pi}, r_{\pi}$ 满足贝尔曼方程 $v_{\pi} = r_{\pi} +$
$\gamma P_{\pi}v_{\pi}$ 。在贝尔曼方程两边同乘以 $d_{\pi}^{\mathrm{T}}$ 可得
$$ \bar{v} _{\pi} = \bar{r} _{\pi} + \gamma d_{\pi} ^{\mathrm{T}} P_{\pi} v_{\pi} = \bar{r} _{\pi} + \gamma d_{\pi} ^{\mathrm{T}} v_{\pi} = \bar{r} _{\pi} + \gamma \bar{v} _{\pi}. $$上式可推出(9.13).
第二,下面的引理给出了任意一个状态值对策略的梯度。
引理9.2(状态值的梯度)。在有折扣的情况下,即当 $\gamma \in (0,1)$ 时,对于任意 $s\in S$ 都有
$$ \nabla_{\theta} v_{\pi} (s) = \sum_{s^{\prime} \in \mathcal{S}} \operatorname * {P r} _{\pi} (s^{\prime} | s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s^{\prime}, \theta) q_{\pi} (s^{\prime}, a),\tag{9.14} $$其中
$$ \operatorname * {P r} _{\pi} (s^{\prime} | s) \doteq \sum_{k = 0} ^{\infty} \gamma^{k} [ P_{\pi} ^{k} ] _{s s^{\prime}} = \left[ (I_{n} - \gamma P_{\pi}) ^{- 1} \right] _{s s^{\prime}} $$是在策略 $\pi$ 下从状态 $s$ 转移到状态 $s'$ 的折扣总概率。这里 $[s]_{ss'}$ 表示矩阵的第 $s$ 行和第 $s'$ 列的元素。 $[P_{\pi}^{k}]_{ss'}$ 等于在策略 $\pi$ 下恰好用 $k$ 步从 $s$ 转移到 $s'$ 的概率。
首先,对任意 $s \in S$ 有
$$ \begin{array}{l} \nabla_{\theta} v_{\pi} (s) = \nabla_{\theta} \left[ \sum_{a \in \mathcal{A}} \pi (a | s, \theta) q_{\pi} (s, a) \right] \\ = \sum_{a \in \mathcal{A}} [ \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) + \pi (a | s, \theta) \nabla_{\theta} q_{\pi} (s, a) ], \end{array}\tag{9.15} $$其中动作值 $q_{\pi}(s,a)$ 的表达式为
$$ q_{\pi} (s, a) = r (s, a) + \gamma \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) v_{\pi} (s^{\prime}). $$在上式两边求对 $\theta$ 的梯度可得
$$ \nabla_{\theta} q_{\pi} (s, a) = 0 + \gamma \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) \nabla_{\theta} v_{\pi} (s^{\prime}). $$上式中 $r(s, a) = \sum_{r} rp(r|s, a)$ 对 $\theta$ 的梯度等于0,这是因为这一项与 $\theta$ 无关。将上式代入(9.15)可得
$$ \nabla_{\theta} v_{\pi} (s) = \sum_{a \in \mathcal{A}} \left[ \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) + \pi (a | s, \theta) \gamma \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) \nabla_{\theta} v_{\pi} (s^{\prime}) \right] $$$$ = \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) + \gamma \sum_{a \in \mathcal{A}} \pi (a | s, \theta) \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) \nabla_{\theta} v_{\pi} (s^{\prime}).\tag{9.16} $$我们的任务是推导 $\nabla_{\theta}v_{\pi}$ 的表达式,值得注意的是它出现在上式的两边。为了求解该项,一种常见的方法是使用铺开技术(unrolling technique)[64]。不过,这里使用另一种基于矩阵-向量形式的方法,该方法相比铺开技术更加直观。首先,设
$$ u (s) \doteq \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a). $$其次,有
$$ \sum_{a \in \mathcal{A}} \pi (a | s, \theta) \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) \nabla_{\theta} v_{\pi} (s^{\prime}) = \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s) \nabla_{\theta} v_{\pi} (s^{\prime}) = \sum_{s^{\prime} \in \mathcal{S}} [ P_{\pi} ] _{s s^{\prime}} \nabla_{\theta} v_{\pi} (s^{\prime}), $$因此,式(9.16)的矩阵-向量形式为
$$ \underbrace{\left[ \begin{array}{c} \vdots \\ \nabla_{\theta} v_{\pi} (s) \\ \vdots \end{array} \right]} _{\nabla_{\theta} v_{\pi} \in \mathbb{R} ^{m n}} = \underbrace{\left[ \begin{array}{c} \vdots \\ u (s) \\ \vdots \end{array} \right]} _{u \in \mathbb{R} ^{m n}} + \gamma (P_{\pi} \otimes I_{m}) \underbrace{\left[ \begin{array}{c} \vdots \\ \nabla_{\theta} v_{\pi} (s^{\prime}) \\ \vdots \end{array} \right]} _{\nabla_{\theta} v_{\pi} \in \mathbb{R} ^{m n}} $$其中 $n = |\mathcal{S}|$ 是状态的个数, $m$ 是参数向量 $\theta$ 的维度。上式出现了克罗内克积(Kronecker product) $\otimes$ ,这是因为 $\nabla_{\theta}v_{\pi}(s)$ 是一个向量。上式可以更简洁地写为
$$ \nabla_{\theta} v_{\pi} = u + \gamma (P_{\pi} \otimes I_{m}) \nabla_{\theta} v_{\pi}. $$显然上式是关于 $\nabla_{\theta}v_{\pi}$ 的一个线性方程,其解为
$$ \begin{array}{r l} \nabla_{\theta} v_{\pi} & = (I_{n m} - \gamma P_{\pi} \otimes I_{m}) ^{- 1} u \\ & = (I_{n} \otimes I_{m} - \gamma P_{\pi} \otimes I_{m}) ^{- 1} u \\ & = [ (I_{n} - \gamma P_{\pi}) ^{- 1} \otimes I_{m} ] u. \end{array}\tag{9.17} $$式(9.17)给出了 $\nabla_{\theta}v_{\pi}$ 的向量形式,其针对状态 $s$ 的展开形式为
$$ \begin{array}{r l} & {\nabla_{\theta} v_{\pi} (s) = \sum_{s^{\prime} \in \mathcal{S}} \left[ (I_{n} - \gamma P_{\pi}) ^{- 1} \right] _{s s^{\prime}} u (s^{\prime})} \\ & {\qquad = \sum_{s^{\prime} \in \mathcal{S}} \left[ (I_{n} - \gamma P_{\pi}) ^{- 1} \right] _{s s^{\prime}} \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s^{\prime}, \theta) q_{\pi} (s^{\prime}, a).} \end{array}\tag{9.18} $$如何解读上式中的 $\left[(I_n - \gamma P_\pi)^{-1}\right]_{ss'}$ 呢?它的解读如下所示。由于 $(I_n - \gamma P_\pi)^{-1} =$
$I + \gamma P_{\pi} + \gamma^{2}P_{\pi}^{2} + \cdots$ ,我们有
$$ \left[ \left(I_{n} - \gamma P_{\pi}\right) ^{- 1} \right] _{s s^{\prime}} = [ I ] _{s s^{\prime}} + \gamma [ P_{\pi} ] _{s s^{\prime}} + \gamma^{2} [ P_{\pi} ^{2} ] _{s s^{\prime}} + \dots = \sum_{k = 0} ^{\infty} \gamma^{k} [ P_{\pi} ^{k} ] _{s s^{\prime}}. $$注意, $[P_{\pi}^{k}]_{ss'}$ 是从 $s$ 出发恰好用 $k$ 步转移到 $s'$ 的概率(见方框8.1)。因此, $\left[(I_n - \gamma P_\pi)^{-1}\right]_{ss'}$ 是从 $s$ 转移到 $s'$ 的总概率。通过令 $\left[(I_n - \gamma P_\pi)^{-1}\right]_{ss'} \doteq \Pr_{\pi}(s'|s)$ ,方程(9.18)变为(9.14)。
基于引理9.2,下面推导 $\bar{v}_{\pi}^{0}$ 的梯度。正如前面提到的,这里的上标“0”表示该目标函数中的状态概率分布与策略 $\pi$ 无关。
定理9.2 (有折扣的情况下 $\bar{v}_{\pi}^{0}$ 的梯度)。在有折扣的情况下,即当 $\gamma \in (0,1)$ 时, $\bar{v}_{\pi}^{0} = d_{0}^{\mathrm{T}} v_{\pi}$ 的梯度是
$$ \nabla_{\theta} \bar{v} _{\pi} ^{0} = \mathbb{E} \big [ \nabla_{\theta} \ln \pi (A | S, \theta) q_{\pi} (S, A) \big ], $$其中 $S \sim \rho_{\pi}, A \sim \pi(S, \theta)$ 而且
$$ \rho_{\pi} (s) = \sum_{s^{\prime} \in \mathcal{S}} d_{0} (s^{\prime}) \operatorname * {P r} _{\pi} (s | s^{\prime}), \quad s \in \mathcal{S},\tag{9.19} $$其中 $\Pr_{\pi}(s|s') = \sum_{k=0}^{\infty} \gamma^{k}[P_{\pi}^{k}]_{s's} = \left[(I - \gamma P_{\pi})^{-1}\right]_{s's}$ 是在策略 $\pi$ 下从 $s'$ 到 s 的折扣总概率。
对 $\bar{v}_{\pi}^{0} = d_{0}^{\mathrm{T}}v_{\pi}$ 两边求梯度。由于 $d_0(s)$ 与 $\pi$ 无关,可得
$$ \nabla_{\theta} \bar{v} _{\pi} ^{0} = \nabla_{\theta} \sum_{s \in \mathcal{S}} d_{0} (s) v_{\pi} (s) = \sum_{s \in \mathcal{S}} d_{0} (s) \nabla_{\theta} v_{\pi} (s). $$将引理9.2中 $\nabla_{\theta}v_{\pi}(s)$ 的表达式代入上式可得
$$ \begin{array}{r l} \nabla_{\theta} \bar{v} _{\pi} ^{0} & = \sum_{s \in \mathcal{S}} d_{0} (s) \nabla_{\theta} v_{\pi} (s) = \sum_{s \in \mathcal{S}} d_{0} (s) \sum_{s^{\prime} \in \mathcal{S}} \operatorname * {P r} _{\pi} (s^{\prime} | s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s^{\prime}, \theta) q_{\pi} (s^{\prime}, a) \\ & = \sum_{s^{\prime} \in \mathcal{S}} \left(\sum_{s \in \mathcal{S}} d_{0} (s) \operatorname * {P r} _{\pi} (s^{\prime} | s)\right) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s^{\prime}, \theta) q_{\pi} (s^{\prime}, a) \\ & \doteq \sum_{s^{\prime} \in \mathcal{S}} \rho_{\pi} (s^{\prime}) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s^{\prime}, \theta) q_{\pi} (s^{\prime}, a) \end{array} $$$$ \begin{array}{r l} & {= \sum_{s \in \mathcal{S}} \rho_{\pi} (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) \qquad (\text{将} s^{\prime} \text{换为} s)} \\ & {= \sum_{s \in \mathcal{S}} \rho_{\pi} (s) \sum_{a \in \mathcal{A}} \pi (a | s, \theta) \nabla_{\theta} \ln \pi (a | s, \theta) q_{\pi} (s, a)} \\ & {= \mathbb{E} \left[ \nabla_{\theta} \ln \pi (A | S, \theta) q_{\pi} (S, A) \right],} \end{array} $$其中 $S \sim \rho_{\pi}, A \sim \pi(S, \theta)$ 。证明完毕。
根据引理9.1和引理9.2,我们可以推导出 $\bar{v}_{\pi}$ 和 $\bar{r}_{\pi}$ 的梯度。与定理9.2不同,下面定理中目标函数的状态概率分布与策略 $\pi$ 相关。
定理9.3 (有折扣的情况下 $\bar{v}_{\pi}$ 和 $\bar{r}_{\pi}$ 的梯度)。在有折扣的情况下,即当 $\gamma \in (0,1)$ 时, $\bar{v}_{\pi}$ 和 $\bar{r}_{\pi}$ 的梯度为
$$ \begin{array}{r l} \nabla_{\theta} \bar{r} _{\pi} = (1 - \gamma) \nabla_{\theta} \bar{v} _{\pi} & \approx \sum_{s \in \mathcal{S}} d_{\pi} (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) \\ & = \mathbb{E} \big [ \nabla_{\theta} \ln \pi (A | S, \theta) q_{\pi} (S, A) \big ], \end{array} $$其中 $S \sim d_{\pi}, A \sim \pi(S, \theta)$ 。当 $\gamma$ 接近1时,上面的近似更加准确。
对 $\bar{v}_{\pi} = \sum_{s\in S}d_{\pi}(s)v_{\pi}(s)$ 两边求梯度可得
$$ \begin{array}{r l} & {\nabla_{\theta} \bar{v} _{\pi} = \nabla_{\theta} \sum_{s \in \mathcal{S}} d_{\pi} (s) v_{\pi} (s)} \\ & {\qquad = \sum_{s \in \mathcal{S}} \nabla_{\theta} d_{\pi} (s) v_{\pi} (s) + \sum_{s \in \mathcal{S}} d_{\pi} (s) \nabla_{\theta} v_{\pi} (s).} \end{array}\tag{9.20} $$我们首先分析上式中的第二项 $\sum_{s\in S}d_{\pi}(s)\nabla_{\theta}v_{\pi}(s)$ 。将式(9.17)中的 $\nabla_{\theta}v_{\pi}$ 代入第二项中可得
$$ \begin{array}{r l} \sum_{s \in \mathcal{S}} d_{\pi} (s) \nabla_{\theta} v_{\pi} (s) & = (d_{\pi} ^{\mathrm{T}} \otimes I_{m}) \nabla_{\theta} v_{\pi} \\ & = (d_{\pi} ^{\mathrm{T}} \otimes \bar{I} _{m}) \left[ (I_{n} - \gamma P_{\pi}) ^{- 1} \otimes \bar{I} _{m} \right] u \\ & = \left[ d_{\pi} ^{\mathrm{T}} (I_{n} - \gamma P_{\pi}) ^{- 1} \right] \otimes \bar{I} _{m} u. \end{array}\tag{9.21} $$注意到下式成立:
$$ d_{\pi} ^{\mathrm{T}} (I_{n} - \gamma P_{\pi}) ^{- 1} = \frac{1}{1 - \gamma} d_{\pi} ^{\mathrm{T}}. $$该式可以通过两边乘以 $(I_{n} - \gamma P_{\pi})$ 得到证明。将上式代入式(9.21)可得
$$ \begin{array}{r l} \sum_{s \in \mathcal{S}} d_{\pi} (s) \nabla_{\theta} v_{\pi} (s) & = \frac{1}{1 - \gamma} d_{\pi} ^{\mathrm{T}} \otimes I_{m} u \\ & = \frac{1}{1 - \gamma} \sum_{s \in \mathcal{S}} d_{\pi} (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a). \end{array} $$虽然式(9.20)有两项,但是由于第二项包含一个缩放因子 $\frac{1}{1 - \gamma}$ ,当 $\gamma \to 1$ 时,第二项起到主导作用,第一项可以忽略。此时,
$$ \nabla_{\theta} \bar{v} _{\pi} \approx \frac{1}{1 - \gamma} \sum_{s \in \mathcal{S}} d_{\pi} (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a). $$上述推导过程中的近似要求第一项在 $\gamma \rightarrow 1$ 时不会趋向无穷大。更多信息可参见文献[66,第4节]。另外,根据 $\bar{r}_{\pi} = (1 - \gamma)\bar{v}_{\pi}$ 可知
$$ \begin{array}{r l} \nabla_{\theta} \bar{r} _{\pi} = (1 - \gamma) \nabla_{\theta} \bar{v} _{\pi} & \approx \sum_{s \in \mathcal{S}} d_{\pi} (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) \\ & = \sum_{s \in \mathcal{S}} d_{\pi} (s) \sum_{a \in \mathcal{A}} \pi (a | s, \theta) \nabla_{\theta} \ln \pi (a | s, \theta) q_{\pi} (s, a) \\ & = \mathbb{E} \left[ \nabla_{\theta} \ln \pi (A | S, \theta) q_{\pi} (S, A) \right]. \end{array} $$证明完毕。
9.3.2 推导策略梯度:无折扣的情况#
下面继续介绍目标函数梯度的推导,不过这次我们考虑无折扣的情况,即 $\gamma = 1$ 。到目前为止,本书只考虑了有折扣的情况,为什么现在突然开始考虑无折扣的情况呢?目标函数 $\bar{r}_{\pi}$ 的定义对有折扣和无折扣的情况都是成立的。在有折扣的情况下, $\bar{r}_{\pi}$ 的梯度是一种近似(定理9.3)。在无折扣的情况下,我们将看到其梯度的推导更加严格且优美。
状态值和泊松方程#
在无折扣的情况下,我们需要重新定义状态值和动作值。由于奖励的直接求和 $\mathbb{E}[R_{t + 1} + R_{t + 2} + R_{t + 3} + \dots |S_t = s]$ 可能发散,因此状态值和动作值需要以一种特殊
的方式来定义[64]:
$$ \begin{array}{r l} & v_{\pi} (s) \doteq \mathbb{E} [ (R_{t + 1} - \bar{r} _{\pi}) + (R_{t + 2} - \bar{r} _{\pi}) + (R_{t + 3} - \bar{r} _{\pi}) + \ldots | S_{t} = s ], \\ & q_{\pi} (s, a) \doteq \mathbb{E} [ (R_{t + 1} - \bar{r} _{\pi}) + (R_{t + 2} - \bar{r} _{\pi}) + (R_{t + 3} - \bar{r} _{\pi}) + \ldots | S_{t} = s, A_{t} = a ], \end{array} $$其中 $\bar{r}_{\pi}$ 是平均奖励。文献中对 $v_{\pi}(s)$ 有不同的称呼,如差分奖励(differential reward)[65]或偏置(bias)[2, 第8.2.1节]。不难验证,上述状态值满足下式:
$$ v_{\pi} (s) = \sum_{a} \pi (a | s, \theta) \left[ \sum_{r} p (r | s, a) (r - \bar{r} _{\pi}) + \sum_{s^{\prime}} p (s^{\prime} | s, a) v_{\pi} (s^{\prime}) \right].\tag{9.22} $$此外,通过对比上式和 $v_{\pi}(s) = \sum_{a\in \mathcal{A}}\pi (a|s,\theta)q_{\pi}(s,a)$ ,可以得到动作值的表达式为 $q_{\pi}(s,a) = \sum_r p(r|s,a)(r - \bar{r}_{\pi}) + \sum_{s'}p(s'|s,a)v_{\pi}(s')$ 。将式(9.22)写成矩阵-向量形式可得
$$ v_{\pi} = r_{\pi} - \bar{r} _{\pi} \mathbf{1} _{n} + P_{\pi} v_{\pi},\tag{9.23} $$其中 $\mathbf{1}_n = [1,\dots ,1]^{\mathrm{T}}\in \mathbb{R}^n$ 。读者可能注意到了方程(9.22)和(9.23)与贝尔曼方程很类似,两者唯一的区别是多了 $\bar{r}_{\pi}$ 这一项。实际上,它们有一个特定的名称:泊松方程(Poisson equation)[65, 67]。
如何从泊松方程中求解 $v_{\pi}$ ?答案将在下面的定理中给出。
定理 9.4 (泊松方程的解)。令
$$ v_{\pi} ^{*} \doteq (I_{n} - P_{\pi} + \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}) ^{- 1} r_{\pi}.\tag{9.24} $$那么 $v_{\pi}^{*}$ 是式(9.23)中泊松方程的一个解,且泊松方程的任意解具有以下形式:
$$ v_{\pi} = v_{\pi} ^{*} + c \mathbb{1} _{n}, $$其中 $c \in \mathbb{R}$ 。
上述定理表明泊松方程的解可能是不唯一的。
证明分为三步。
第1步:证明 $v_{\pi}^{*}$ 是泊松方程的一个解。
$$ A \doteq I_{n} - P_{\pi} + 1_{n} d_{\pi} ^{\mathrm{T}}. $$那么 $v_{\pi}^{*} = A^{-1}r_{\pi}$ 。 $A$ 的可逆性将在第3步中证明。将 $v_{\pi}^{*} = A^{-1}r_{\pi}$ 代入式(9.23)
可得
$$ A^{- 1} r_{\pi} = r_{\pi} - \mathbf{1} _{n} d_{\pi} ^{\mathrm{T}} r_{\pi} + P_{\pi} A^{- 1} r_{\pi}. $$我们只需要证明上式是成立的,从而证明 $v_{\pi}^{*}$ 是泊松方程的一个解。具体来说,上式等价为 $(-A^{-1} + I_n - 1_n d_\pi^{\mathrm{T}} + P_\pi A^{-1})r_\pi = 0$ 。该式可以重写为
$$ (- I_{n} + A - \mathbf{1} _{n} d_{\pi} ^{\mathrm{T}} A + P_{\pi}) A^{- 1} r_{\pi} = 0. $$上式是成立的,因为左侧括号内的项等于0,即 $-I_{n} + A - \mathbf{1}_{n}d_{\pi}^{\mathrm{T}}A + P_{\pi} = -I_{n} + (I_{n} - P_{\pi} + \mathbf{1}_{n}d_{\pi}^{\mathrm{T}}) - \mathbf{1}_{n}d_{\pi}^{\mathrm{T}}(I_{n} - P_{\pi} + \mathbf{1}_{n}d_{\pi}^{\mathrm{T}}) + P_{\pi} = 0$ 。所以, $v_{\pi}^{*}$ 是泊松方程的一个解。
◇ 第2步:证明任意解的表达式。
将 $\bar{r}_{\pi} = d_{\pi}^{\mathrm{T}}r_{\pi}$ 代入式(9.23)可得
$$ v_{\pi} = r_{\pi} - \mathbf{1} _{n} d_{\pi} ^{\mathrm{T}} r_{\pi} + P_{\pi} v_{\pi}.\tag{9.25} $$上式可以化为
$$ (I_{n} - P_{\pi}) v_{\pi} = (I_{n} - \mathbf{1} _{n} d_{\pi} ^{\mathrm{T}}) r_{\pi}.\tag{9.26} $$注意 $I_{n} - P_{\pi}$ 是奇异的,这是因为对于任何策略 $\pi$ 都有 $(I_n - P_\pi)\mathbf{1}_n = 0$ 。因此,式(9.26)的解不是唯一的:如果 $v_{\pi}^{*}$ 是一个解,那么对于任意的 $x\in \mathrm{Null}(I_n - P_\pi)$ 可知 $v_{\pi}^{*} + x$ 也是一个解。更进一步,如果 $P_{\pi}$ 不可约(irreducible),那么 $\mathrm{Null}(I_n - P_\pi) = \mathrm{span}\{\mathbf{1}_n\}$ 。此时,泊松方程的任意解都可以写成 $v_{\pi}^{*} + c\mathbf{1}_{n}$ ,其中 $c\in \mathbb{R}$ 是任意实数。
◇ 第3步:证明 $A = I_{n} - P_{\pi} + 1_{n} d_{\pi}^{T}$ 是可逆的。
前面用到了 A 的可逆性,下面来证明该性质。
引理9.3。矩阵 $I_{n} - P_{\pi} + \mathbf{1}_{n}d_{\pi}^{\mathrm{T}}$ 是可逆的,其逆矩阵是
$$ \left[ I_{n} - \left(P_{\pi} - \mathbf{1} _{n} d_{\pi} ^{\mathrm{T}}\right) \right] ^{- 1} = \sum_{k = 1} ^{\infty} \left(P_{\pi} ^{k} - \mathbf{1} _{n} d_{\pi} ^{\mathrm{T}}\right) + I_{n}. $$证明:首先我们不加证明地给出一些基本知识。设 $\rho(M)$ 为矩阵 $M$ 的谱半径。如果 $\rho(M) < 1$ ,那么 $I - M$ 是可逆的。此外, $\rho(M) < 1$ 当且仅当 $\lim_{k \to \infty} M^k = 0$ 。接下来我们展示 $\lim_{k \to \infty} (P_\pi - \mathbf{1}_nd^{\mathrm{T}})_k \to 0$ ,进而证明 $I_n - (P_\pi - \mathbf{1}_nd^{\mathrm{T}})_n$ 的可
逆性。具体来说,注意到
$$ \left(P_{\pi} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}\right) ^{k} = P_{\pi} ^{k} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}, \quad k \geqslant 1.\tag{9.27} $$上式可以通过归纳法证明。例如,当 $k = 1$ 时,很明显等式成立。当 $k = 2$ 时,我们有
$$ \begin{array}{r l} & {(P_{\pi} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}) ^{2} = (P_{\pi} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}) (P_{\pi} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}})} \\ & {\qquad = P_{\pi} ^{2} - P_{\pi} \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}} P_{\pi} + \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}} \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}} \\ & {\qquad = P_{\pi} ^{2} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}},} \end{array} $$其中最后一个等号是由于 $P_{\pi} \mathbf{1}_n = \mathbf{1}_n, d_{\pi}^{\mathrm{T}} P_{\pi} = d_{\pi}^{\mathrm{T}}, d_{\pi}^{\mathrm{T}} \mathbf{1}_n = 1$ 。 $k \geqslant 3$ 的情况可以类似地证明。
由于 $d_{\pi}$ 是平稳分布,故满足 $\lim_{k\to \infty}P_{\pi}^{k} = d_{\pi}^{\mathrm{T}}\mathbf{1}_{n}$ (见方框8.1)。对式(9.27)两边求极限可得
$$ \lim_{k \rightarrow \infty} (P_{\pi} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}) ^{k} = \lim_{k \rightarrow \infty} P_{\pi} ^{k} - d_{\pi} ^{\mathrm{T}} \mathbb{1} _{n} = 0. $$因此有 $\rho (P_{\pi} - \mathbb{1}_{n}d_{\pi}^{\mathrm{T}}) < 1$ ,进而有 $I_{n} - (P_{\pi} - \mathbb{1}_{n}d_{\pi}^{\mathrm{T}})$ 是可逆的,且其逆矩阵是
$$ \begin{array}{r l} & {(I_{n} - (P_{\pi} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}})) ^{- 1} = \sum_{k = 0} ^{\infty} (P_{\pi} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}) ^{k}} \\ & {\qquad = I_{n} + \sum_{k = 1} ^{\infty} (P_{\pi} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}) ^{k}} \\ & {\qquad = I_{n} + \sum_{k = 1} ^{\infty} (P_{\pi} ^{k} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}})} \\ & {\qquad = \sum_{k = 0} ^{\infty} (P_{\pi} ^{k} - \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}) + \mathbb{1} _{n} d_{\pi} ^{\mathrm{T}}.} \end{array} $$证明完毕。
引理9.3的证明受到了文献[66]的启发。然而,文献[66]在其中公式(16)中给出的结论 $(I_{n} - P_{\pi} + 1_{n}d_{\pi}^{\mathrm{T}})^{-1} = \sum_{k = 0}^{\infty}(P_{\pi}^{k} - 1_{n}d_{\pi}^{\mathrm{T}})$ 是不准确的,这因为 $\sum_{k = 0}^{\infty}(P_{\pi}^{k} - 1_{n}d_{\pi}^{\mathrm{T}})$ 是奇异的(例如 $\sum_{k = 0}^{\infty}(P_{\pi}^{k} - 1_{n}d_{\pi}^{\mathrm{T}})\mathbf{1}_n = 0$ ),因此它不可能是一个矩阵的逆矩阵。引理9.3纠正了这个不准确之处。
梯度的推导#
虽然定理9.4表明在无折扣的情况下 $v_{\pi}$ 的值不是唯一的,但是 $\bar{r}_{\pi}$ 的值是唯一的。具体来说,将 $v_{\pi} = v_{\pi}^{*} + c\mathbf{1}_n$ 代入泊松方程可得
$$ \begin{array}{r l} \bar{r} _{\pi} \mathbf{1} _{n} & = r_{\pi} + (P_{\pi} - I_{n}) v_{\pi} \\ & = r_{\pi} + (P_{\pi} - I_{n}) (v_{\pi} ^{*} + c \mathbf{1} _{n}) \\ & = r_{\pi} + (P_{\pi} - I_{n}) v_{\pi} ^{*}. \end{array} $$注意其中 c 被抵消了,因此 $\bar{r}_{\pi}$ 的值是唯一的,所以我们可以在无折扣的情况下计算 $\bar{r}_{\pi}$ 的梯度。
定理9.5(无折扣情况下 $\bar{r}_{\pi}$ 的梯度)。在无折扣的情况下,平均奖励 $\bar{r}_{\pi}$ 的梯度是
$$ \begin{array}{r l} \nabla_{\theta} \bar{r} _{\pi} & = \sum_{s \in \mathcal{S}} d_{\pi} (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) \\ & = \mathbb{E} \left[ \nabla_{\theta} \ln \pi (A | S, \theta) q_{\pi} (S, A) \right], \end{array}\tag{9.28} $$其中 $S \sim d_{\pi}, A \sim \pi(S, \theta)$ 。
与前面有折扣的情况下的结果相比(定理9.3), $\bar{r}_{\pi}$ 在无折扣的情况下的梯度在数学上更为优美,这是因为式(9.28)是严格成立的。
首先,对 $v_{\pi}(s) = \sum_{a\in \mathcal{A}}\pi (a|s,\theta)q_{\pi}(s,a)$ 两边求梯度可得
$$ \begin{array}{r l} \nabla_{\theta} v_{\pi} (s) & = \nabla_{\theta} \left[ \sum_{a \in \mathcal{A}} \pi (a | s, \theta) q_{\pi} (s, a) \right] \\ & = \sum_{a \in \mathcal{A}} \left[ \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) + \pi (a | s, \theta) \nabla_{\theta} q_{\pi} (s, a) \right], \end{array}\tag{9.29} $$其中 $q_{\pi}(s,a)$ 是动作值,满足
$$ \begin{array}{c} q_{\pi} (s, a) = \sum_{r} p (r | s, a) (r - \bar{r} _{\pi}) + \sum_{s^{\prime}} p (s^{\prime} | s, a) v_{\pi} (s^{\prime}) \\ = r (s, a) - \bar{r} _{\pi} + \sum_{s^{\prime}} p (s^{\prime} | s, a) v_{\pi} (s^{\prime}). \end{array} $$对上式两边求导,由于 $r(s,a) = \sum_r rp(r|s,a)$ 不依赖于 $\theta$ ,可得
$$ \nabla_{\theta} q_{\pi} (s, a) = 0 - \nabla_{\theta} \bar{r} _{\pi} + \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) \nabla_{\theta} v_{\pi} (s^{\prime}). $$将上式代入式(9.29)可得
$$ \begin{array}{l} \nabla_{\theta} v_{\pi} (s) = \sum_{a \in \mathcal{A}} \left[ \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) + \pi (a | s, \theta) \left(- \nabla_{\theta} \bar{r} _{\pi} + \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) \nabla_{\theta} v_{\pi} (s^{\prime})\right) \right] \\ = \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a) - \nabla_{\theta} \bar{r} _{\pi} + \sum_{a \in \mathcal{A}} \pi (a | s, \theta) \sum_{s^{\prime} \in \mathcal{S}} p (s^{\prime} | s, a) \nabla_{\theta} v_{\pi} (s^{\prime}). \end{array}\tag{9.30} $$设
$$ u (s) \doteq \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a). $$由于 $\sum_{a\in \mathcal{A}}\pi (a|s,\theta)\sum_{s^{\prime}\in \mathcal{S}}p(s^{\prime}|s,a)\nabla_{\theta}v_{\pi}(s^{\prime}) = \sum_{s^{\prime}\in \mathcal{S}}p(s^{\prime}|s)\nabla_{\theta}v_{\pi}(s^{\prime})$ ,方程(9.30)可以写成矩阵-向量形式:
$$ \underbrace{\left[ \begin{array}{c} \vdots \\ \nabla_{\theta} v_{\pi} (s) \\ \vdots \end{array} \right]} _{\nabla_{\theta} v_{\pi} \in \mathbb{R} ^{m n}} = \underbrace{\left[ \begin{array}{c} \vdots \\ u (s) \\ \vdots \end{array} \right]} _{u \in \mathbb{R} ^{m n}} - \mathbf{1} _{n} \otimes \nabla_{\theta} \bar{r} _{\pi} + (P_{\pi} \otimes I_{m}) \underbrace{\left[ \begin{array}{c} \vdots \\ \nabla_{\theta} v_{\pi} (s^{\prime}) \\ \vdots \end{array} \right]} _{\nabla_{\theta} v_{\pi} \in \mathbb{R} ^{m n}}, $$其中 $n = |\mathcal{S}|$ , $m$ 是向量 $\theta$ 的维数, $\otimes$ 是克罗内克积。上述方程可以简洁地写为
$$ \nabla_{\theta} v_{\pi} = u - \mathbb{1} _{n} \otimes \nabla_{\theta} \bar{r} _{\pi} + (P_{\pi} \otimes I_{m}) \nabla_{\theta} v_{\pi}, $$进而可得
$$ \mathbb{1} _{n} \otimes \nabla_{\theta} \bar{r} _{\pi} = u + (P_{\pi} \otimes I_{m}) \nabla_{\theta} v_{\pi} - \nabla_{\theta} v_{\pi}. $$在上式两边同时乘以 $d_{\pi}^{\mathrm{T}}\otimes I_m$ 可得
$$ \begin{array}{r l} & {(d_{\pi} ^{\mathrm{T}} \mathbb{1} _{n}) \otimes \overline{{\nabla}} _{\theta} \bar{r} _{\pi} = d_{\pi} ^{\mathrm{T}} \otimes I_{m} u + (d_{\pi} ^{\mathrm{T}} P_{\pi}) \otimes I_{m} \nabla_{\theta} v_{\pi} - d_{\pi} ^{\mathrm{T}} \otimes I_{m} \nabla_{\theta} v_{\pi}} \\ & {\qquad = d_{\pi} ^{\mathrm{T}} \otimes I_{m} u.} \end{array} $$由于 $d_{\pi}^{\mathrm{T}}\mathbb{1}_{n} = 1$ ,由上式可得
$$ \nabla_{\theta} \bar{r} _{\pi} = d_{\pi} ^{\mathrm{T}} \otimes \mathcal{I} _{m} u $$$$ \begin{array}{l} = \sum_{s \in \mathcal{S}} d_{\pi} (s) u (s) \\ = \sum_{s \in \mathcal{S}} d_{\pi} (s) \sum_{a \in \mathcal{A}} \nabla_{\theta} \pi (a | s, \theta) q_{\pi} (s, a). \end{array} $$证明完毕。
最后,由于 $v_{\pi}$ 不是唯一的,因此 $\bar{v}_{\pi}$ 也不是唯一的,所以我们这里不关注 $\bar{v}_{\pi}$ 的梯度。对于感兴趣的读者,值得一提的是我们可以通过增加更多的约束来唯一确定 $v_{\pi}$ 。例如,假设存在一个循环状态(recurrent state),这个循环状态的状态值可以确定下来[65,第II节],进而可以唯一确定 $c$ 。当然,还有其他方式可以唯一确定 $v_{\pi}$ ,参见文献[2]中的方程(8.6.5)~(8.6.7)。
9.4 蒙特卡罗策略梯度(REINFORCE)#
有了定理9.1中给出的目标函数的梯度,我们就可以利用如下的梯度上升算法来最大化目标函数以获得最佳策略:
$$ \begin{array}{r l} \theta_{t + 1} & = \theta_{t} + \alpha \nabla_{\theta} J (\theta_{t}) \\ & = \theta_{t} + \alpha \mathbb{E} \Big [ \nabla_{\theta} \ln \pi (A | S, \theta_{t}) q_{\pi} (S, A) \Big ], \end{array}\tag{9.31} $$其中 $\alpha > 0$ 是学习率。由于算法(9.31)中的真实梯度含有期望,而这在实际中是未知的,因此我们可以用随机梯度替换真实梯度,从而得到如下算法:
$$ \theta_{t + 1} = \theta_{t} + \alpha \nabla_{\theta} \ln \pi (a_{t} | s_{t}, \theta_{t}) q_{t} (s_{t}, a_{t}),\tag{9.32} $$其中 $q_{t}(s_{t},a_{t})$ 是对 $q_{\pi}(s_t,a_t)$ 在 $t$ 时刻的估计值。
算法(9.32)非常重要,因为许多其他策略梯度算法都可以通过推广该算法得到。从其表达式可以看出,策略参数 $\theta_{t}$ 的更新依赖于对动作值的估计 $q_{t}(s_{t},a_{t})$ 。到目前为止,本书介绍了两种估计值的方法,一种是蒙特卡罗方法,另一种是时序差分方法。如果 $q_{t}(s_{t},a_{t})$ 是通过蒙特卡罗估计得到的,那么该算法被称为蒙特卡罗策略梯度(Monte Carlo policy gradient)或者REINFORCE[68],这是最早和最简单的策略梯度算法之一。如果 $q_{t}(s_{t},a_{t})$ 是通过时序差分方法得到的,那么相应的算法实际上就是Actor-Critic方法,这将在下一章介绍。
下面我们更仔细地分析算法(9.32)。由于
$$ \nabla_{\theta} \ln \pi (a_{t} | s_{t}, \theta_{t}) = \frac{\nabla_{\theta} \pi (a_{t} | s_{t} , \theta_{t})}{\pi (a_{t} | s_{t} , \theta_{t})}, $$算法(9.32)可重写为
$$ \theta_{t + 1} = \theta_{t} + \alpha \underbrace{\left(\frac{q_{t} (s_{t} , a_{t})}{\pi (a_{t} | s_{t} , \theta_{t})}\right)} _{\beta_{t}} \nabla_{\theta} \pi (a_{t} | s_{t}, \theta_{t}). $$上式可简写为
$$ \theta_{t + 1} = \theta_{t} + \alpha \beta_{t} \nabla_{\theta} \pi (a_{t} | s_{t}, \theta_{t}).\tag{9.33} $$从上面这个方程可以得到两方面的重要结论。
◇ 第一,由于式(9.33)是一个梯度上升算法,我们可以得到如下结论。
- 如果 $\beta_{t} \geqslant 0$ ,则在 $s_{t}$ 选择 $a_{t}$ 的概率会增大,即
$$ \pi (a_{t} | s_{t}, \theta_{t + 1}) \geqslant \pi (a_{t} | s_{t}, \theta_{t}). $$- 如果 $\beta_{t} < 0$ ,则在 $s_t$ 选择 $a_{t}$ 的概率会降低,即
$$ \pi (a_{t} | s_{t}, \theta_{t + 1}) < \pi (a_{t} | s_{t}, \theta_{t}). $$为什么上面的结论成立呢?当 $\theta_{t + 1} - \theta_t$ 足够小时,根据一阶泰勒展开可知
$$ \begin{array}{r l} {{\pi (a_{t} | s_{t}, \theta_{t + 1}) \approx \pi (a_{t} | s_{t}, \theta_{t}) + (\nabla_{\theta} \pi (a_{t} | s_{t}, \theta_{t})) ^{\mathrm{T}} (\theta_{t + 1} - \theta_{t})}} \\ & {{= \pi (a_{t} | s_{t}, \theta_{t}) + \alpha \beta_{t} (\nabla_{\theta} \pi (a_{t} | s_{t}, \theta_{t})) ^{\mathrm{T}} (\nabla_{\theta} \pi (a_{t} | s_{t}, \theta_{t})) \quad (\mathrm{代入} (9. 33))}} \\ & {{= \pi (a_{t} | s_{t}, \theta_{t}) + \alpha \beta_{t} \| \nabla_{\theta} \pi (a_{t} | s_{t}, \theta_{t}) \| _{2} ^{2}.}} \end{array} $$很明显,当 $\beta_{t}\geqslant 0$ 时, $\pi (a_t|s_t,\theta_{t + 1})\geqslant \pi (a_t|s_t,\theta_t)$ ;当 $\beta_{t} < 0$ 时, $\pi (a_t|s_t,\theta_{t + 1})<$ $\pi (a_t|s_t,\theta_t)$ 。
◇ 第二,根据上述第一个结论和 $\beta_{t}$ 的表达式,我们可以知道该算法可以平衡探索(exploration)和利用(exploitation)。注意 $\beta_{t}$ 的表达式为
$$ \beta_{t} = \frac{q_{t} (s_{t} , a_{t})}{\pi (a_{t} | s_{t} , \theta_{t})}. $$一方面, $\beta_{t}$ 与 $q_{t}(s_{t}, a_{t})$ 呈正比。如果 $q_{t}(s_{t}, a_{t})$ 较大,那么 $\pi(a_{t} | s_{t}, \theta_{t})$ 将增大,即下一个时刻选择 $a_{t}$ 的概率会增大,因此该算法倾向于利用具有更大价值的动作。另一方面,当 $q_{t}(s_{t}, a_{t}) > 0$ 时, $\beta_{t}$ 与 $\pi(a_{t} | s_{t}, \theta_{t})$ 呈反比。此时,如果 $\pi(a_{t} | s_{t}, \theta_{t})$ 较小,即选择 $a_{t}$ 的概率较小,那么 $\pi(a_{t} | s_{t}, \theta_{t})$ 将增大,即下一个时刻选择 $a_{t}$ 的概率会增大,因此该算法会探索那些之前概率低的动作。
此外,由于式(9.32)需要使用随机样本来近似式(9.31)中的真实梯度,那么该如何进行随机采样呢?
◇ 第一,如何采样 S?真实梯度 $\mathbb{E}[\nabla_{\theta}\ln\pi(A|S,\theta_{t})q_{\pi}(S,A)]$ 中的 S 应服从概率分布 $\eta$ ,这是平稳分布 $d_{\pi}$ 或者式(9.19)给出的分布 $\rho_{\pi}$ 。无论是哪一个分布,都代表在策略 $\pi$ 下的长期行为。
◇ 第二,如何采样 A?真实梯度 $\mathbb{E}[\nabla_{\theta}\ln\pi(A|S,\theta_{t})q_{\pi}(S,A)]$ 中的 A 应服从概率分布 $\pi(A|S,\theta)$ 。采样 A 的理想方式是按照 $\pi(a|s_{t},\theta_{t})$ 采样得到 $a_{t}$ 。
然而,实际中往往不会严格按照上述理论采样 S 和 A,这主要是因为实际中的样本可能是稀缺的,例如我们不太可能等到策略运行了很久并进入平稳态之后才使用其经验样本来学习。
算法9.1给出了具体实现式(9.32)的流程。在这个算法中,首先利用 $\pi (\theta)$ 生成一个回合,然后使用回合中的每一个经验样本对 $\theta$ 进行多次更新。
9.5 总结#
本章介绍了策略梯度方法,这是许多现代强化学习算法的基础。策略梯度方法是基于策略的,而之前章节中的所有方法都是基于值的。策略梯度方法的基本思想很简单,那就是选择一个合适的标量目标函数,然后通过梯度上升算法来优化它。
策略梯度方法中最复杂的部分是目标函数梯度的推导过程。为了推导梯度,我们必须区分具有不同目标函数、有无折扣等情况。幸运的是,不同情况下梯度的表达式是相似的,因此我们在定理9.1中总结了统一的梯度表达式,这是本章中最重要的理论结果。对于许多读者来说,了解这个定理就已经足够了;对于该定理的证明,读者可以有选择性地学习。
读者应该很好地理解策略梯度算法(9.32),因为它是许多更复杂的策略梯度算法的
基础。在下一章中,这个算法将被推广得到Actor-Critic的方法。
9.6 问答#
◇ 提问:策略梯度方法的基本思想是什么?
回答:其基本思想很简单。第一,定义合适的标量目标函数。第二,推导该目标函数的梯度。第三,利用梯度上升算法来优化这个目标函数。第四,由于真实梯度难以获得,因此可以用随机梯度来近似真实梯度。
◇ 提问:策略梯度方法中最复杂的部分是什么?
回答:虽然策略梯度方法的基本思想很简单,但是其中梯度的推导过程相当复杂,这是因为我们必须区分众多不同的情况。
◇ 提问:策略梯度方法有哪些目标函数?
回答:本章介绍了两类目标函数:平均状态值和平均奖励。具体涉及三个目标函数: $\bar{v}_{\pi}, \bar{v}_{\pi}^{0}, \bar{r}_{\pi}$ 。由于它们对应的梯度是类似的,因此它们都可以在策略梯度方法中被采用。值得一提的是,式(9.1)和式(9.4)中的目标函数表达式在文献中经常遇到。
◇ 提问:为什么策略梯度的表达式包含一个自然对数?
回答:引入自然对数是为了将梯度表达式写成一个期望值。通过这种方式,我们可以用一个随机梯度来近似真实梯度。
◇ 提问:为什么在推导策略梯度时需要考虑无折扣的情况?
回答:平均奖励 $\bar{r}_{\pi}$ 的定义对有折扣和无折扣的情况都是成立的。在有折扣的情况下, $\bar{r}_{\pi}$ 的梯度是一个近似值,但是在无折扣的情况下,其梯度更为严格和优美。
◇ 提问:策略梯度算法(9.32)在数学上究竟在做什么事情?
回答:为了更好地理解这个算法,建议读者关注其在式(9.33)中的简洁表达式,该式清楚地展示了它是一个用于更新 $\pi (a_{t}|s_{t},\theta_{t})$ 的梯度上升算法,即一个样本要么使得 $\pi (a_t|s_t,\theta_{t + 1})\geqslant \pi (a_t|s_t,\theta_t)$ ,要么使得 $\pi (a_t|s_t,\theta_{t + 1}) < \pi (a_t|s_t,\theta_t)$ 。