第2章 从一个示例到马尔可夫决策过程#
求解强化学习问题可以理解为个体在与环境交互过程中如何最大化地获得累积奖励。环境的动力学特征确定了个体在交互时的状态序列和即时奖励,环境的状态是构建环境动力学特征所需要的所有信息。当环境状态是完全可观测时,个体可以通过构建马尔可夫决策过程来描述整个强化学习问题。有时环境状态虽不是完全可观测的,但个体仍然可以结合自身对于环境的历史观测数据来描述自身处于一个近似完全可观测的环境中所面临的强化学习问题。从这个角度来说,几乎对所有的强化学习问题的描述都可以被认为或被转化为描述一个马尔可夫决策过程。正确理解马尔可夫决策过程中的一些概念和关系对于正确理解强化学习问题非常重要。
2.1 马尔可夫过程#
在一个时序过程中,如果t+1时的状态仅取决于t时的状态 $S_{\mathrm{t}}$ ,而与t时之前的任何状态都无关,则认为t时的状态 $S_t$ 具有马尔可夫性质(Markov Property)。若过程中的每一个状态都具有马尔可夫性质,则这个过程就具备马尔可夫性质。具备了马尔可夫性质的随机过程称为马尔可夫过程(Markov Process),或称为马尔可夫链(MarkovChain,MC),它是由状态空间和概率空间组成的一个元组<S,P>。马尔可夫过程中的每一个状态 $S_{\mathrm{t}}$ 记录了过程历史上所有相关的信息,而且一旦 $s$ 确定了,历史状态信息 $\mathrm{S}_1, \mathrm{S}_2, \cdots, \mathrm{S}_{t-1}$ 对于确定 $\mathrm{S}_{t+1}$ 就不再重要,可有可无。描述一个马尔可夫过程的核心是状态转移概率矩阵:
$$ \boldsymbol{P} _{s s^{\prime}} = \boldsymbol{P} \left[ S_{t + 1} = s^{\prime} \mid S_{t} = s \right] \tag{2.1} $$式(2.1)中的状态转移概率矩阵定义了从任意一个状态s到其所有后续状态 $\boldsymbol{s}^{\prime}$ 的状态转移概率:
$$ \boldsymbol{P} = \left[ \begin{array}{c c c} P_{11} & \dots & P_{1 n} \\ \vdots & & \vdots \\ P_{n 1} & \dots & P_{n n} \end{array} \right] \tag{2.2} $$其中,矩阵P中每一行的数据表示从某一个状态到所有n个状态的转移概率值。每一行的这些转移概率值加起来之和应该为1。
通常使用一个元组<S,P>来描述马尔可夫过程,其中S是有限数量的状态集,P是状态转移概率矩阵。
图2.1描述了一个假想的学生学习一门课程的马尔可夫过程。在这个随机过程中,学生需要顺利完成3节课并且通过最终的考试才能完成这门课程的学习。学生处在第一节课中时会有50%的概率拿起手机浏览社交软件中的信息,另有50%的概率完成该节课的学习并进入第二节课。一旦学生在第一节课中浏览手机社交软件上的信息,就有90%的概率继续沉迷于浏览,仅有10%的概率放下手机继续听第一节课。学生处在第二节课时有80%的概率听完第二节课并顺利进入第三节课的学习中,有20%的概率因课程内容枯燥或难度较大而休息或者退出。学生在学习第三节课的内容后,有60%的概率通过考试继而100%进入休息状态,也有40%的概率因为各种原因而出去娱乐泡吧,随后可能因为忘掉了不少学到的东西而分别以20%、40%和40%的概率需要重新返回第一、二、三节课进行学习。
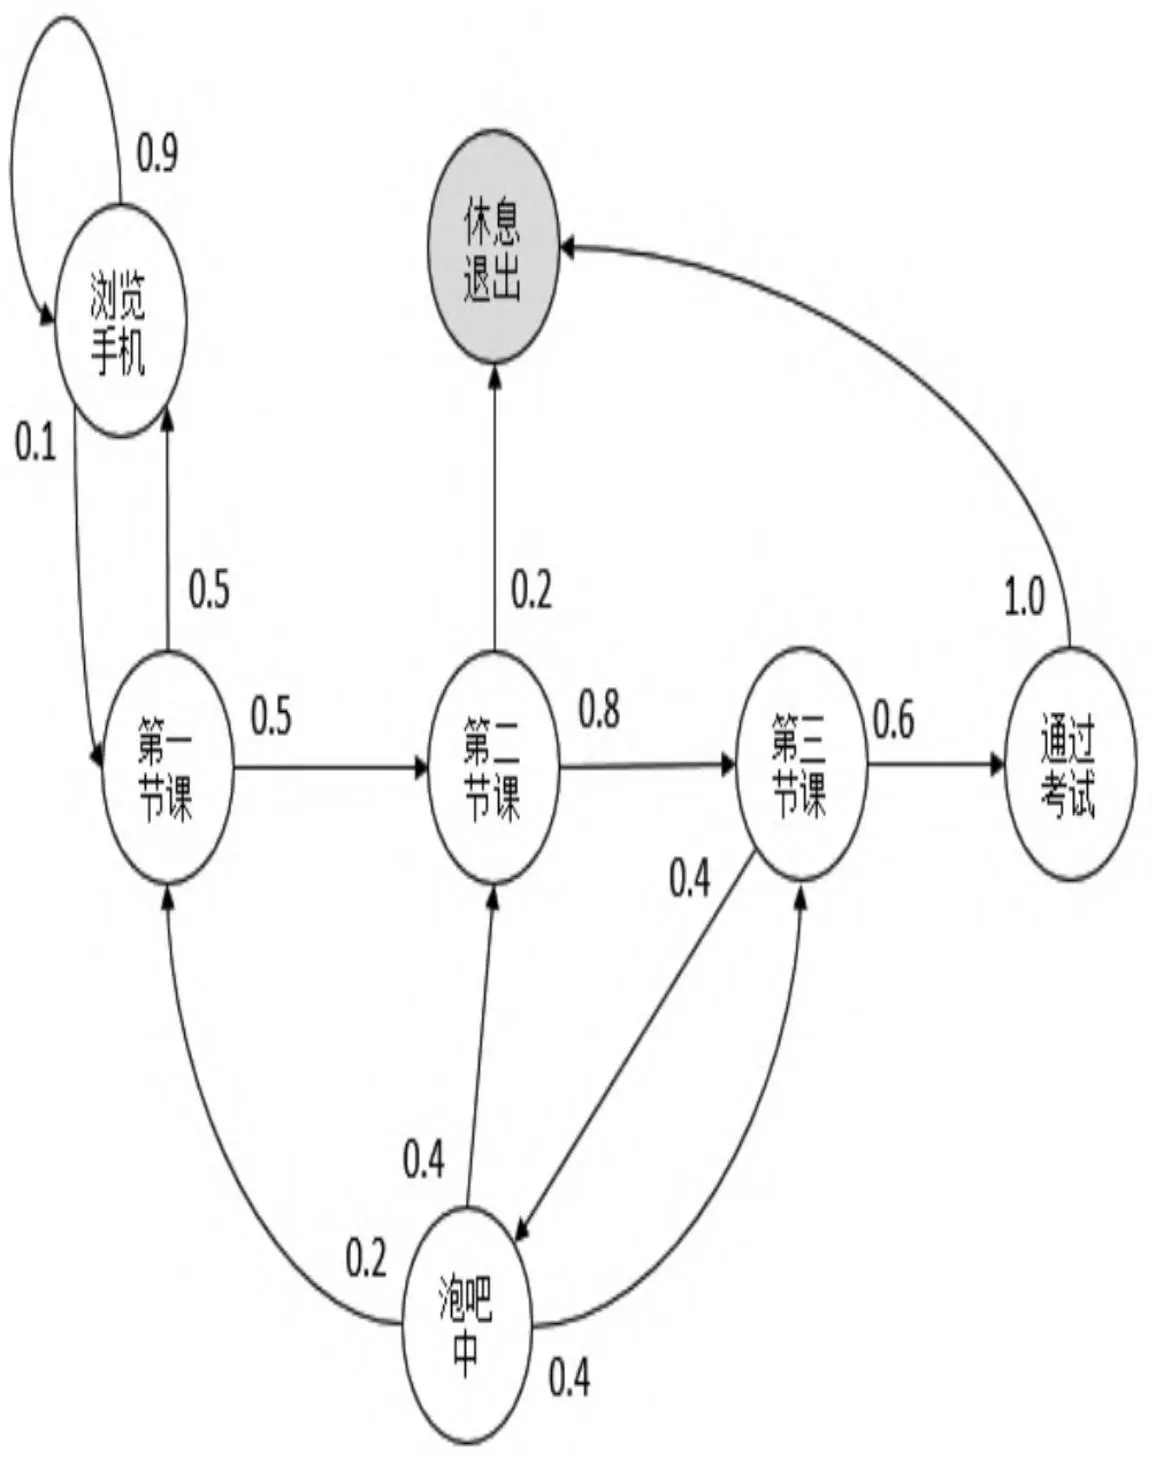
图2.1 学生学习一门课的马尔可夫过程
在图2.1中,我们使用内有文字的空心圆圈来描述学生所处的状态,包括第一节课(C1)、第二节课(C2)、第三节课(C3)、泡吧中(Pub)、通过考试(Pass)、浏览手机(FB)以及休息退出(Sleep),其中最后一个状态是终止状态,意味着学生一旦进入该状态就永久保持在该状态,或者说该状态的下一个状态100%还是该状态。连接状态的箭头表示状态转移过程,箭头附近的数字表明发生箭头所示方向状态转移的概率。
假设学生目前处于状态“第一节课(C1)”中,我们按照马尔可夫过程给出的状态转移概率可以得到若干学生随后的状态转化序列。例如,下面的这4个序列都是可能存在的状态转化序列:
·C1―C2―C3―Pass―Sleep ·C1―FB―FB―C1―C2―Sleep ·C1―C2―C3―Pub―C2―C3―Pass―Sleep ·C1―FB―FB―C1―C2―C3―Pub―C1―FB―FB―FB―C1―C2 ―C3―Pub―C2―Sleep
从符合马尔可夫过程给定的状态转移概率矩阵生成一个状态序列的过程称为采样(Sampling)。
采样将得到一系列的状态转换过程,称为状态序列(Episode,或称为情节、片段)。当状态序列的最后一个状态是终止状态时,该状态序列称为完整的状态序列(Complete Episode)。本书中所指的状态序列大多数是完整的状态序列。
2.2 马尔可夫奖励过程#
马尔可夫过程只涉及状态之间的转移概率,并未触及强化学习问题中伴随着状态转换的奖励反馈。如果把奖励考虑进马尔可夫过程,则称为马尔可夫奖励过程(Markov Reward Process,MRP)。它是由<S,P,R,γ>构成的一个元组,其中:
·S是一个有限状态集。 ·P是集合中状态转移概率矩阵: $P_{s s^{\prime}} = P \big [ S_{t + 1} = s^{\prime} | S_{t} = s \big ]$ 。 ·R是一个奖励函数: $R_{s} = \mathbb{E} \big [ R_{t + 1} | S_{\prime} = s \big ]$ 。 ·γ是一个衰减因子: $\gamma \in \left[ 0 , 1 \right]$ 。
图2.2在图2.1中的每一个状态旁增加了一个奖励值,表明到达该状态后(或离开该状态时)学生可以获得的奖励,这样就构成了一个学生学习一门功课的马尔可夫奖励过程。
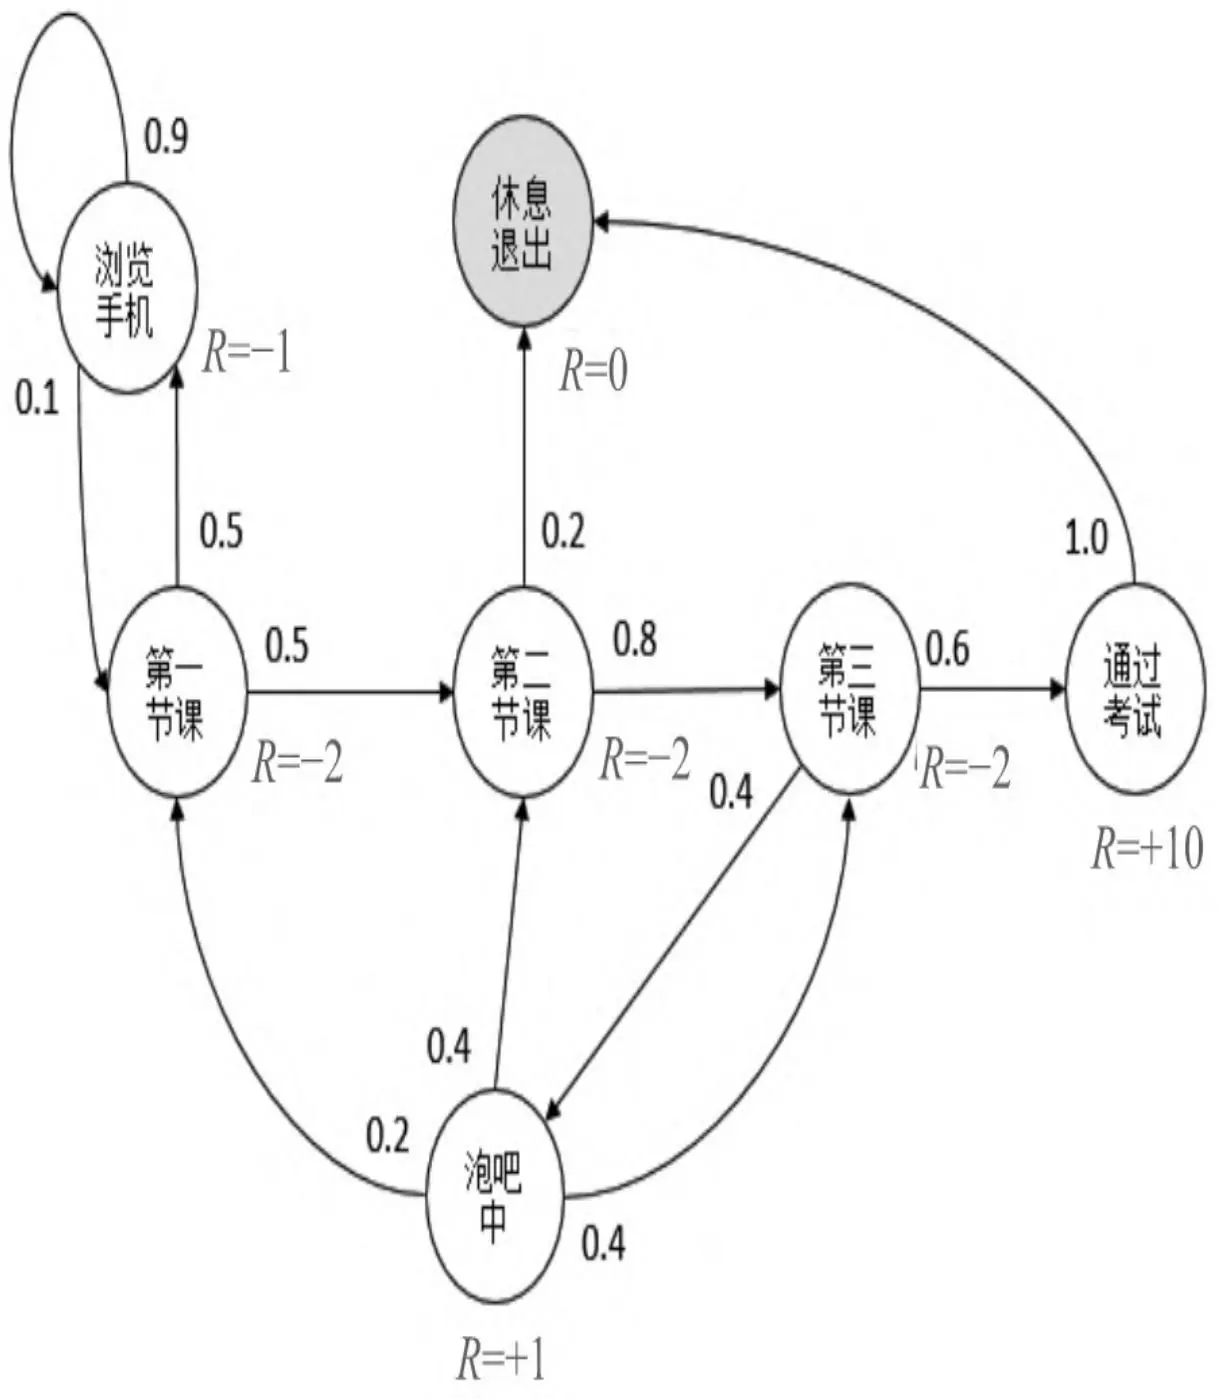
图2.2 学生马尔可夫奖励过程
学生到达每一个状态能获得多少奖励不是学生自己能决定的,而是由充当环境的授课老师或教务部门来确定的。从强化学习的角度来讲,奖励值由环境动力学确定。在上述的学生马尔可夫奖励过程中,授课老师的主要目的是希望学生能够尽早通过考试,因而给了“考试通过”这个状态较高的奖励(+10),而对于过程中的其他状态多数给的是负奖励。虽然设定状态“泡吧中”的奖励为+1,但由于状态“泡吧中”随后的3个可能状态获得的奖励都低于-1,因而可以认为授课教师并不十分赞成“第三节课”后出去泡吧。从学生的角度来说,学生的目标是在学习一门课程的过程中获得尽可能多的累积奖励,针对这个例子来说,也就是尽早地到达“考试通过”状态进而进入“休息退出”终止状态,完成一个完整的状态序列。在强化学习中,我们给这个累积奖励一个新的名称:收获(Return,或回报)。注:根据上下文也可以称之为“收获值”。
收获(Return)是在一个马尔可夫奖励过程中从某一状态St开始采样直到终止状态时所有奖励的衰减之和。数学表达式如下:
$$ G_{t} = R_{t + 1} + \gamma R_{t + 2} + \dots = \sum_{k = 0} ^{\infty} \gamma^{k} R_{t + k + 1} \tag{2.3} $$收获有时也被翻译为回报。从式(2.3)中可以看出,收获是对应于状态序列中某一时刻状态的,计算从该状态开始直至结束还能获得的累积奖励。在一个状态序列中,不同时刻的状态一般对应着不同的收获。从该式中我们还可以看出,收获并不是后续状态奖励的直接相加,而是引入了一个取值范围在[0,1]间的衰减系数γ。引入该系数使得后续某一状态对当前状态收获的贡献要小于个体在该后续状态时所获得的即时奖励。如此设计从数学上可以避免在计算收获时因陷入循环而无法求解,从现实考虑也反映了远期奖励对于当前状态具有一定的不确定性,需要折扣计算。当γ取0时,表明某状态下的收获就是当前状态获得的即时奖励,不考虑后续状态,属于“短视”行为。当γ取1时,表明将考虑所有的后续状态,属于有“长远眼光”的行为。求解实际问题时,模型构建者可根据实际问题的特点来设定γ值。
下文给出学生马尔可夫过程中4个状态序列的开始状态(即“第一节课”)的收获值的计算,选取 $S_1$ “第一节课”, $\gamma = 0 . 5$ :
$$ \text{· C1-C2-C3-Pass-Sleep} $$$$ G_{1} = - 2 + (- 2) \times 1 / 2 + (- 2) \times 1 / 4 + 10 \times 1 / 8 + 0 \times 1 / 16 = - 2. 25 $$$$ \text{· C1-FB-FB-C1-C2-Sleep} $$$$ G_{1} = - 2 + (- 1) \times 1 / 2 + (- 1) \times 1 / 4 + (- 2) \times 1 / 8 + (- 2) \times 1 / 16 + 0 \times 1 / 32 = - 3. 125 $$$$ \text{· C1-C2-C3-Pub-C2-C3-Pass-Sleep} $$$$ G_{1} = - 2 + (- 2) \times 1 / 2 + (- 2) \times 1 / 4 + 1 \times 1 / 8 + (- 2) \times 1 / 16 + \dots = - 3. 41 $$$$ \text{· C1-FB-FB-C1-C2-C3-Pub-C1-FB-FB-FB-C1-C2-C3-Pub-C2-Sleep} $$$$ G_{1} = - 2 + (- 1) \times 1 / 2 + (- 1) \times 1 / 4 + (- 2) \times 1 / 8 + (- 2) \times 1 / 16 + (- 2) \times 1 / 32 + \dots = - 3. 20 $$可以认为,收获间接地给状态序列中的每一个状态设定了一个数据标签,反映了某状态的重要程度。由于收获的计算是基于一个状态序列的,因此从某状态开始,根据状态转移概率矩阵的定义,可能会采样生成多个不同的状态序列,依据不同的状态序列得到的同一个状态的收获值就会不完全相同。那么如何评价从不同状态序列计算得到的某个状态的收获呢?
此外,一个状态还可能存在于一个状态序列的多个位置,例如学生马尔可夫过程的第四个状态序列中的状态“第一节课”。这说明在一个状态序列下同一个状态可能会有不同的收获,如何理解这些不同收获的意义呢?
不难看出,收获对于描述一个状态的重要性还存在许多不明确的地方,为了准确描述一个状态的重要性,我们引入状态的“价值”这个概念。
价值(Value)是马尔可夫奖励过程中状态收获的期望。其数学表达式为:
$$ v (s) = \mathbb{E} \left[ G_{t} \mid S_{t} = s \right] \tag{2.4} $$从式(2.4)可以看出,一个状态价值是该状态的收获的期望值,也就是说从该状态开始依据状态转移概率矩阵采样生成一系列的状态序列,对每一个状态序列计算该状态的收获,然后对该状态的所有收获计算平均值得到一个平均收获。依据状态转移概率采样生成的状态序列越多,计算得到的平均收获就越接近该状态的价值,因而价值可以更准确地反映某一状态的重要程度。
如果存在一个函数,给定一个状态能得到该状态对应的价值,那么该函数就被称为价值函数(Value Function)。价值函数建立了从状态到价值的映射。
不难理解,获得每一个状态的价值,进而得到状态的价值函数对于求解强化学习问题是非常重要的。通过计算收获的平均值来求解状态的价值不是一个可取的办法,因为一个马尔可夫过程针对一个状态可能会产生无穷多个不同的状态序列。有没有比较可取的计算状态价值的方法呢?
我们对价值函数中的收获按照其定义进行展开:
$$ \begin{array}{l} v (s) = \mathbb{E} \left[ G_{t} \mid S_{t} = s \right] \\ = \mathbb{E} \left[ R_{t + 1} + \gamma R_{t + 2} + \gamma^{2} R_{t + 3} + \dots \mid S_{t} = s \right] \\ = \mathbb{E} \left[ R_{t + 1} + \gamma \left(R_{t + 2} + \gamma R_{t + 3} + \dots\right) \mid S_{t} = s \right] \\ = \mathbb{E} \left[ R_{t + 1} + \gamma G_{t + 1} \mid S_{t} = s \right] \\ = \mathbb{E} \left[ R_{t + 1} + \gamma v \left(S_{t + 1}\right) \mid S_{t} = s \right] \\ \end{array} $$最终得到:
$$ v (s) = \mathbb{E} \left[ R_{t + 1} + \gamma v \left(S_{t + 1}\right) \mid S_{t} = s \right] \tag{2.5} $$在式(2.5)中,根据马尔可夫奖励过程的定义, $R_{t+1}$ 的期望就是其自身,因为每次离开同一个状态得到的奖励都是一个固定的值。下一时刻状态价值的期望可以根据下一时刻状态的概率分布得到。如果用 $s^{\prime}$ 表示s状态下一时刻任一可能的状态:
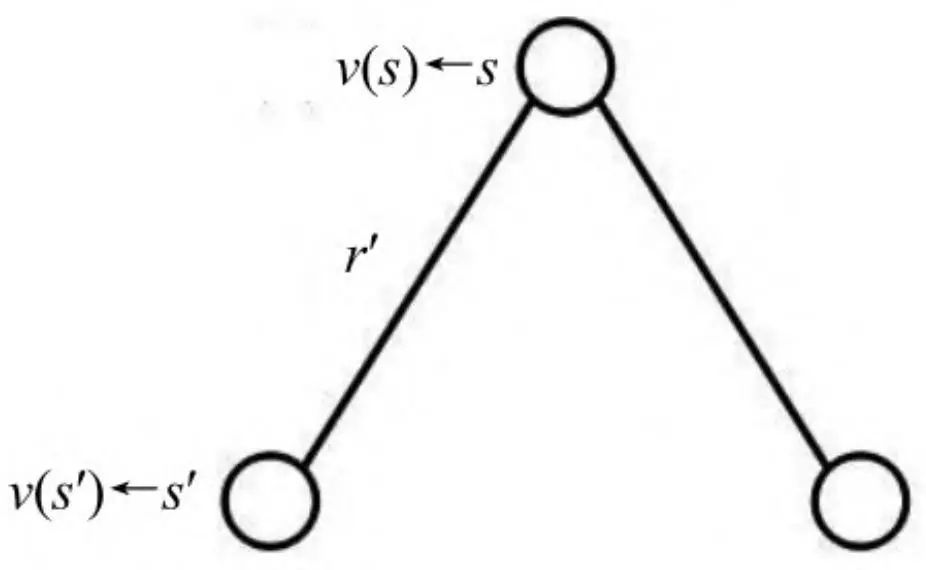
那么上述方程可以写成:
$$ v (s) = R_{s} + \gamma \sum_{s^{\prime} \in S} P_{s s^{\prime}} v (s^{\prime}) \tag{2.6} $$式(2.6)称为马尔可夫奖励过程中的贝尔曼方程(BellmanEquation),它表明一个状态的价值由两部分组成:一部分是该状态的即时奖励,另一部分与后续所有可能的状态价值、对应的转移概率以及衰减系数相关。
图2.3根据奖励值和衰减系数的设定计算出了学生马尔可夫奖励过程中各状态的价值(保留小数点后一位),并对状态“第三节课”的价值进行了验证演算。读者可以根据上述方程对其他状态的价值进行验证。
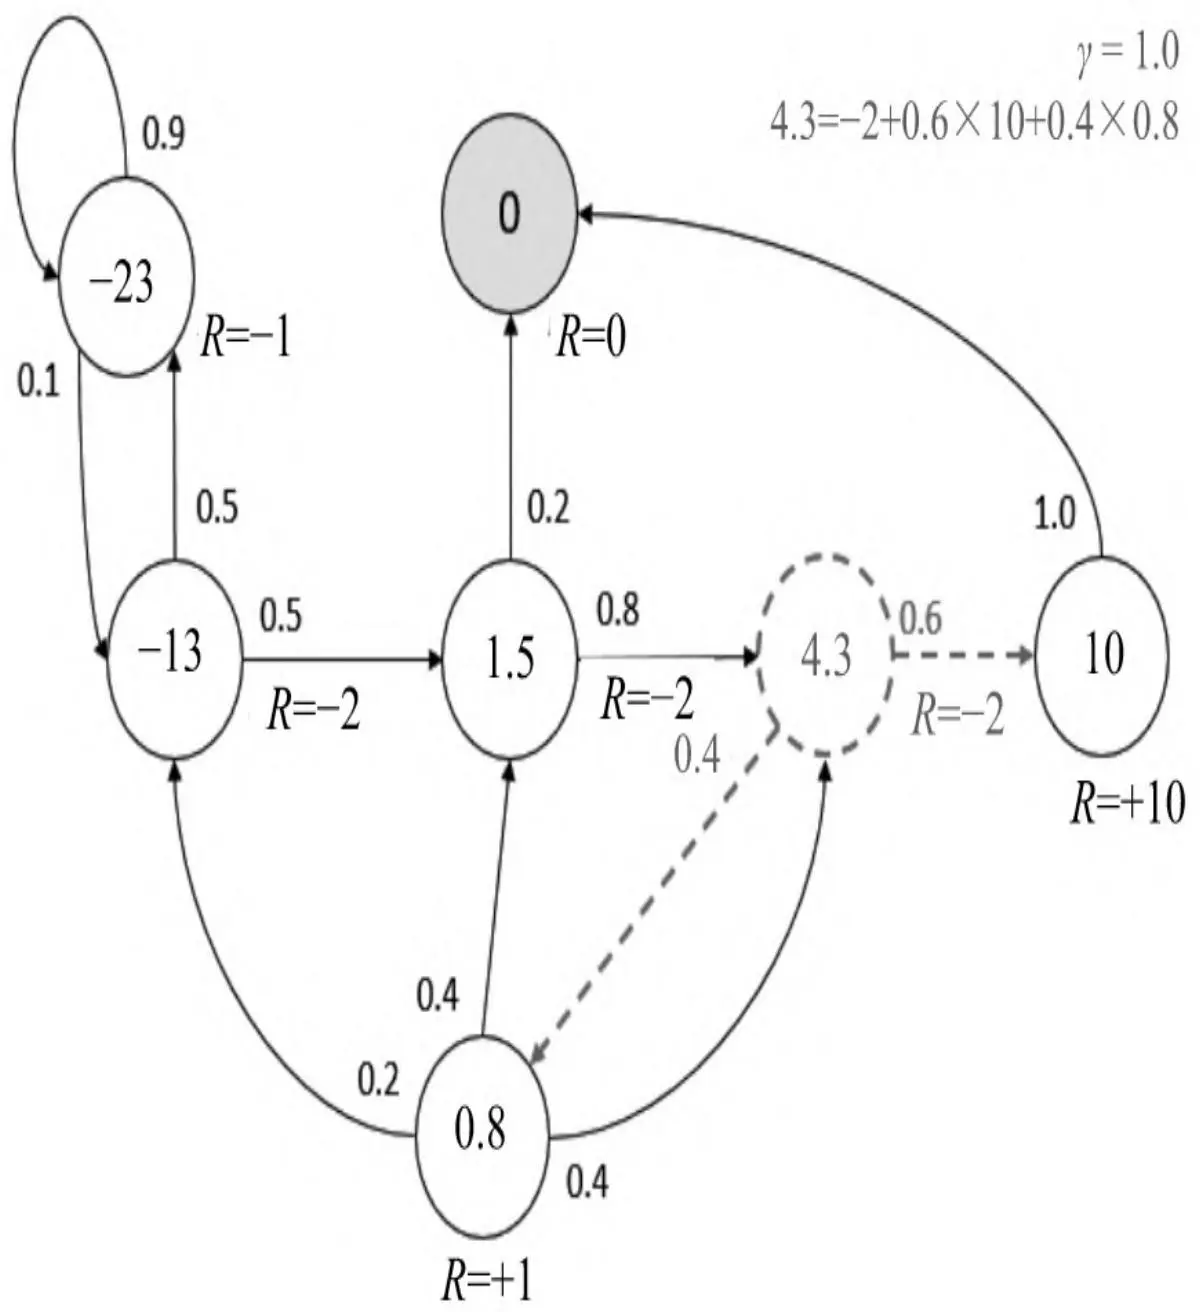
图2.3 学生马尔可夫奖励过程的价值
上述贝尔曼方程可以写成如下矩阵的形式:
$$ \boldsymbol{v} = \boldsymbol{R} + \gamma \boldsymbol{P} \boldsymbol{v} \tag{2.7} $$即
$$ \left[ \begin{array}{c} v (1) \\ \vdots \\ v (n) \end{array} \right] = \left[ \begin{array}{c} R_{1} \\ \vdots \\ R_{n} \end{array} \right] + \gamma \left[ \begin{array}{c c c} P_{11} & \dots & P_{1 n} \\ \vdots & & \vdots \\ P_{n 1} & \dots & P_{n n} \end{array} \right] \left[ \begin{array}{c} v (1) \\ \vdots \\ v (n) \end{array} \right] \tag{2.8} $$理论上,该方程可以直接求解:
$$ \begin{array}{l} \boldsymbol{v} = \boldsymbol{R} + \gamma \boldsymbol{P v} \\ \left(1 - \gamma \boldsymbol{P}\right) \boldsymbol{v} = \boldsymbol{R} \\ \boldsymbol{v} = (1 - \gamma \boldsymbol{P}) ^{- 1} \boldsymbol{R} \\ \end{array} $$计算这类问题的时间复杂度是 ,其中n是状态的数量。这意味着,对于学生马尔可夫奖励过程这类状态数比较少的小规模问题,直接求解是可行的;如果涉及的状态数量较多,那么这种解法就不现实了。本书的后续章节会陆续介绍其他行之有效的求解方法。
在强化学习问题中,如果个体知道了经历过的每一个状态的价值,就可以比较一个状态所有可能的后续状态价值的大小,从而采取行为,将拥有最大价值的那个(些)后续状态作为自己的下一个目标状态,如此一步步朝着拥有最高价值的状态进行转换。从第1章的内容我们知道,个体需要采取一定的行为才能实现状态的转换,而状态转换又与环境动力学有关,这意味着虽然很多时候个体期望自己的行为能够到达个体自己预想的下一个价值较高的状态,但是行为集合以及环境的动力学特征限制了个体,使个体并不一定能顺利实现如此的状态转换。此时对于个体来说,与其“纠结”于不能通过一个行为直接到达的价值较高的目标状态,不如退而求其次,转而思考在当前状态下所有可能采取的行为中,哪一个行为最有意义、最有价值。要进一步解释这个问题,需要引入马尔可夫决策过程、行为、策略等概念。
2.3 马尔可夫决策过程#
马尔可夫奖励过程并不能直接用来指导解决强化学习问题,因为它不涉及个体行为的选择,所以有必要引入马尔可夫决策过程。马尔可夫决策过程(Markov Decision Process,MDP)是一个由 $\scriptstyle 1 < S , A , P , R , \gamma >$ 构成的元组,其中:
·S是一个有限状态集。 ·A是一个有限行为集。 ·P是集合中基于行为的状态转移概率矩阵: $P_{s s^{\prime}} ^{a} = \mathbb{E} \bigl [ R_{t + 1} | S_{t} = s , A_{t} = a \bigr ]$ 。 ·R是基于状态和行为的奖励函数: $R_{s} ^{a} = \mathbb{E} \left[ R_{t + 1} \ | \ S_{i} = s , A_{t} = a \right]$ 。 ·γ是一个衰减因子: $\gamma \in [ 0 , 1 ]$ 。
图2.4给出了学生马尔可夫决策过程的状态转化图,依然用空心圆圈表示状态,同时增加了一类黑色实心圆圈来表示个体的行为。根据马尔可夫决策过程的定义,奖励、状态转移概率均与行为直接相关,同一个状态下采取不同的行为得到的奖励是不一样的。此图把Pass和Sleep状态合并成一个终止状态;另外,当个体在状态“第三节课”后选择“泡吧”行为时,将被环境按照动力学特征根据对应状态转移概率分配到另外3个状态。注意,学生马尔可夫决策过程示例虽然与之前的学生马尔可夫奖励过程示例有许多相同的状态,但两者还是有很大差别的,建议将这两个示例完全区分开。
马尔可夫决策过程引入了行为,使得状态转移矩阵和奖励函数与之前的马尔可夫奖励过程有明显的差别。在马尔可夫决策过程中,个体基于自身对当前状态的认识,从行为集中选择一个行为,而个体在实施了其所选定的行为后,其后续状态不由个体的行为直接决定,而是由环境的动力学特征来决定。个体在给定状态下从行为集中选择一个行为的依据称为策略(Policy),用字母π表示。策略π是某一状态下基于行为集合的一个概率分布:
$$ \pi (a | s) = \boldsymbol{P} \left[ A_{t} = a \mid S_{t} = s \right] \tag{2.9} $$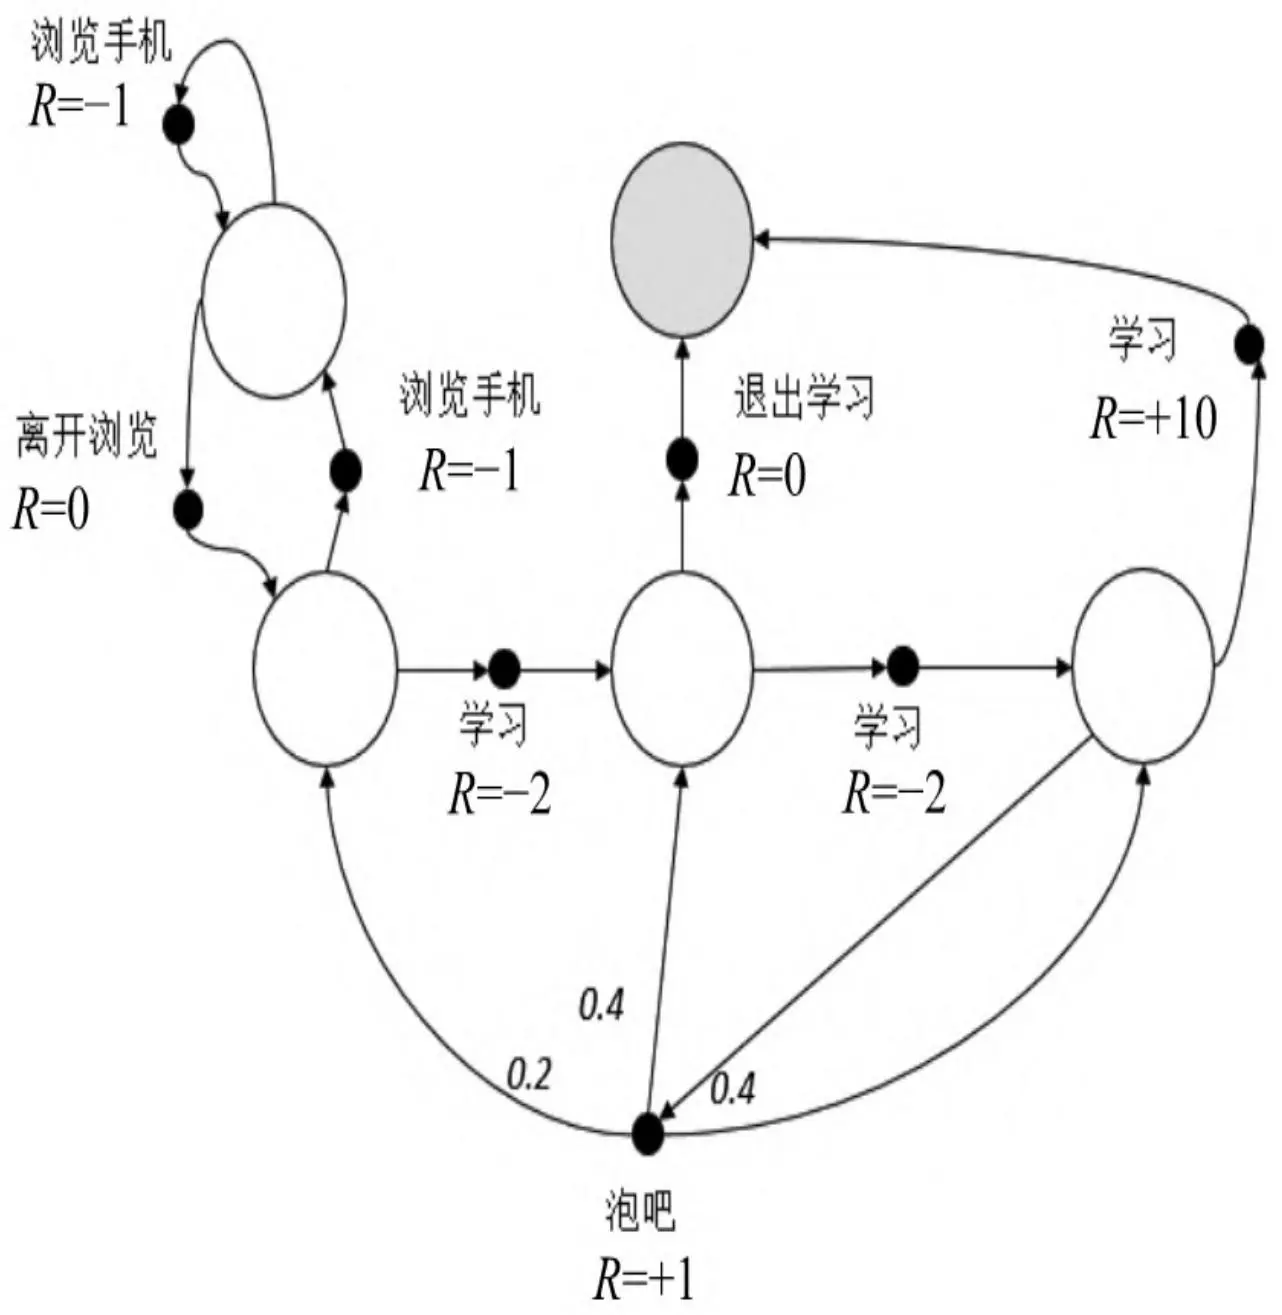
图2.4 学生马尔可夫决策过程
在马尔可夫决策过程中,个体在某一个状态下参照策略就可以产生一个行为,这意味着策略仅与当前状态相关,而与历史状态无关。在一个策略下,个体处于不同的状态可能产生不同的行为;同样在一个策略下,个体处在同一个状态下也可能产生不同的行为。策略描述的是个体的行为产生的机制,虽然产生的行为可能会随状态不同而发生变化,但策略本身是不随状态变化而变化的,是静态的。
随机策略是一个很常用的策略,当个体应用随机策略时,它在某一状态下选择的行为并不确定。借助随机策略,个体可以在同一状态下尝试不同的行为。
当给定一个马尔可夫决策过程 $\text{MDP} < S , A , P , R , \gamma >$ 和一个策略π时,状态序列 $\mathrm{S} _{1} , \mathrm{S} _{2} , \mathrm{S} _{3} , \cdots$ 是一个符合马尔可夫过程 $\langle \mathrm{S} , \mathrm{P} _{\pi} \rangle$ 的采样。类似地,联合状态和奖励的序列 $\mathrm{S} _{1} , \mathrm{S} _{2} , \mathrm{S} _{3}$ ,…是一个符合马尔可夫奖励过程$< S , P_{\pi} , R_{\pi} , \gamma >$ 的采样,并且在这个奖励过程中满足下面的方程:
$$ \boldsymbol{P} _{s, s^{\prime}} ^{\pi} = \sum_{a \in A} \pi (a \mid s) \boldsymbol{P} _{s s^{\prime}} ^{a} \tag{2.10} $$$$ R_{s} ^{\pi} = \sum_{a \in A} \pi (a \mid s) R_{s} ^{a} $$上述公式体现了马尔可夫决策过程中的一个策略对应一个马尔可夫过程和一个马尔可夫奖励过程。不难理解,同一个马尔可夫决策过程,不同的策略会产生不同的马尔可夫(奖励)过程,进而会有不同的状态价值函数。因此,在马尔可夫决策过程中,有必要扩展先前定义的价值函数。
【定义】 价值函数 是在马尔可夫决策过程下基于策略π的状态价值函数,表示从状态s开始,遵循当前策略π时所获得的收获的期望:
$$ v_{\pi} (s) = \mathbb{E} \left[ G_{t} \mid S_{t} = s \right] \tag{2.11} $$同样,由于引入了行为,为了描述同一状态下采取不同行为的价值,我们定义一个基于策略π的行为价值函数 ,表示在遵循策略π时对当前状态s执行某一具体行为a所能得到的收获的期望:
$$ q_{\pi} (s, a) = \mathbb{E} \left[ G_{t} \mid S_{i} = s, A_{t} = a \right] \tag{2.12} $$行为价值(函数)确定的某一个行为的价值都是与某一状态相关的,所以准确地说应该是状态行为对的价值(函数)。为了简洁,本书统一使用行为价值(函数)来表示状态行为对的价值(函数),而状态价值(函数)或价值(函数)多用于表示单纯基于状态的价值(函数)。
定义了基于策略π的状态价值函数和行为价值函数后,依据贝尔曼方程,我们可以得到如下两个贝尔曼期望方程:
$$ v_{\pi} (s) = \mathbb{E} \left[ R_{t + 1} + \gamma v_{\pi} \left(S_{t + 1}\right) \mid S_{t} = s \right] \tag{2.13} $$$$ q_{\pi} (s, a) = \mathbb{E} \left[ R_{t + 1} + \gamma q_{\pi} \left(S_{t + 1}, A_{t + 1}\right) \mid S_{t} = s, A_{t} = a \right] \tag{2.14} $$由于行为是连接马尔可夫决策过程中状态转换的桥梁,因此一个行为的价值与状态的价值关系紧密,具体表现为一个状态的价值可以用该状态下所有行为价值来表达:
$$ v_{\pi} (s) = \sum_{a \in A} \pi (a | s) q_{\pi} (s, a) \tag{2.15} $$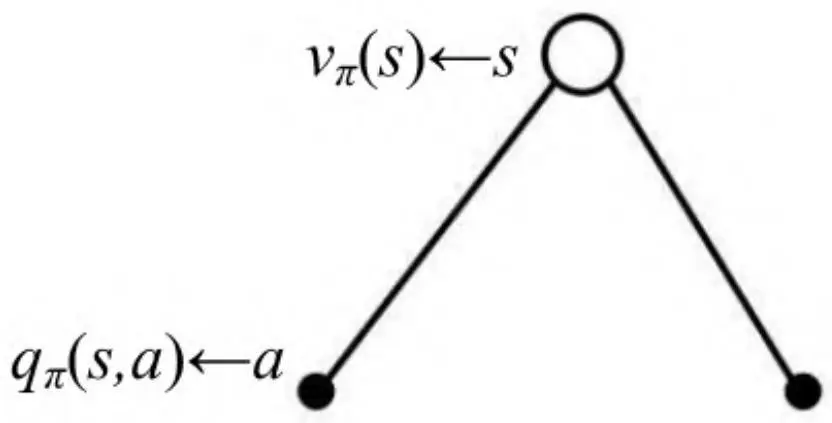
类似地,一个行为的价值可以用该行为所能到达的后续状态的价值来表达:
$$ q_{\pi} (s, a) = R_{s} ^{a} + \gamma \sum_{s^{\prime} \in S} P_{s s^{\prime}} ^{a} v_{\pi} (s^{\prime}) \tag{2.16} $$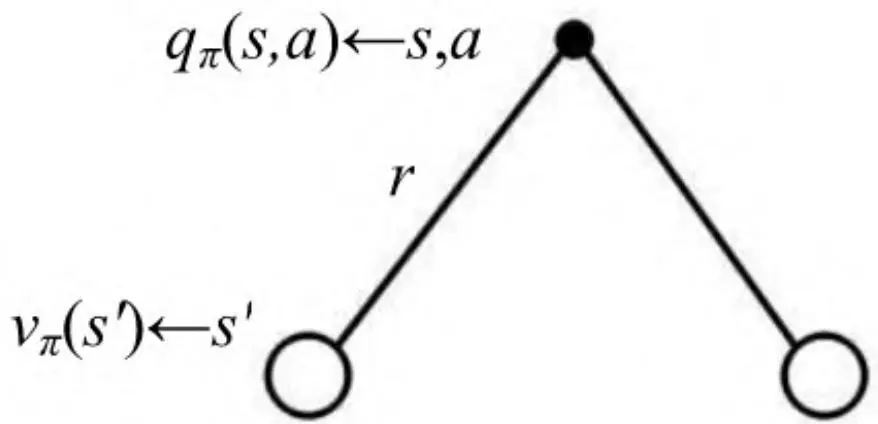
把式(2.15)和式(2.16)组合起来,可以得到下面的结果:
$$ v_{\pi} (s) = \sum_{a \in A} \pi (a | s) \left(R_{s} ^{a} + \gamma \sum_{s^{\prime} \in S} P_{s s^{\prime}} ^{a} v_{\pi} \left(s^{\prime}\right)\right) \tag{2.17} $$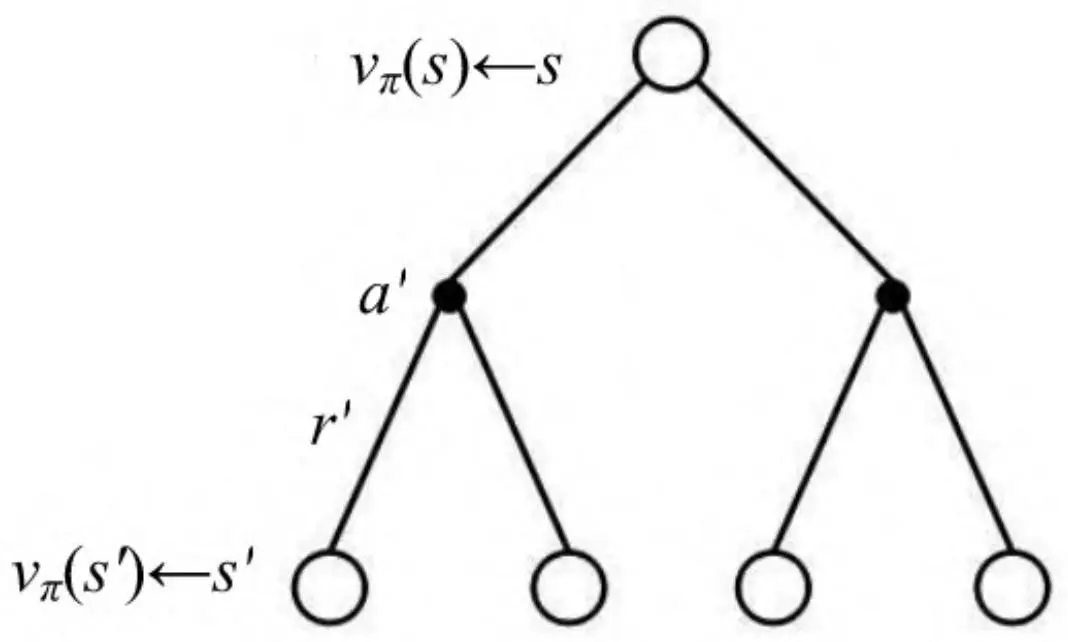
或者
$$ q_{\pi} (s, a) = R_{s} ^{a} + \gamma \sum_{s^{\prime} \in S} P_{s s^{\prime}} ^{a} \sum_{a^{\prime} \in A} \pi (a^{\prime} | s^{\prime}) q_{\pi} (s^{\prime}, a^{\prime}) \tag{2.18} $$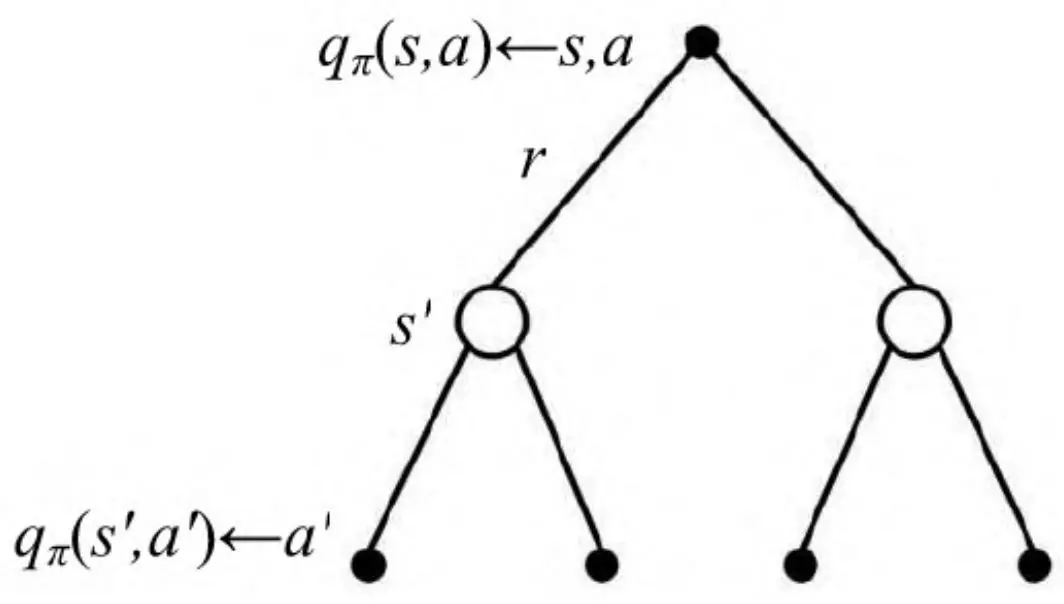
图2.5给出了一个给定策略下计算得到的学生马尔可夫决策过程的价值函数(数值保留至小数点后一位)。每一个状态下都有且仅有两个实质可发生的行为,我们的策略是这两种行为以均等(各0.5)的概率被选择执行,同时衰减因子γ=1。状态“第三节课”(图中最右侧虚心圆圈所示的状态)在该策略下的价值为7.4,可以由式(2.17)计算得出。
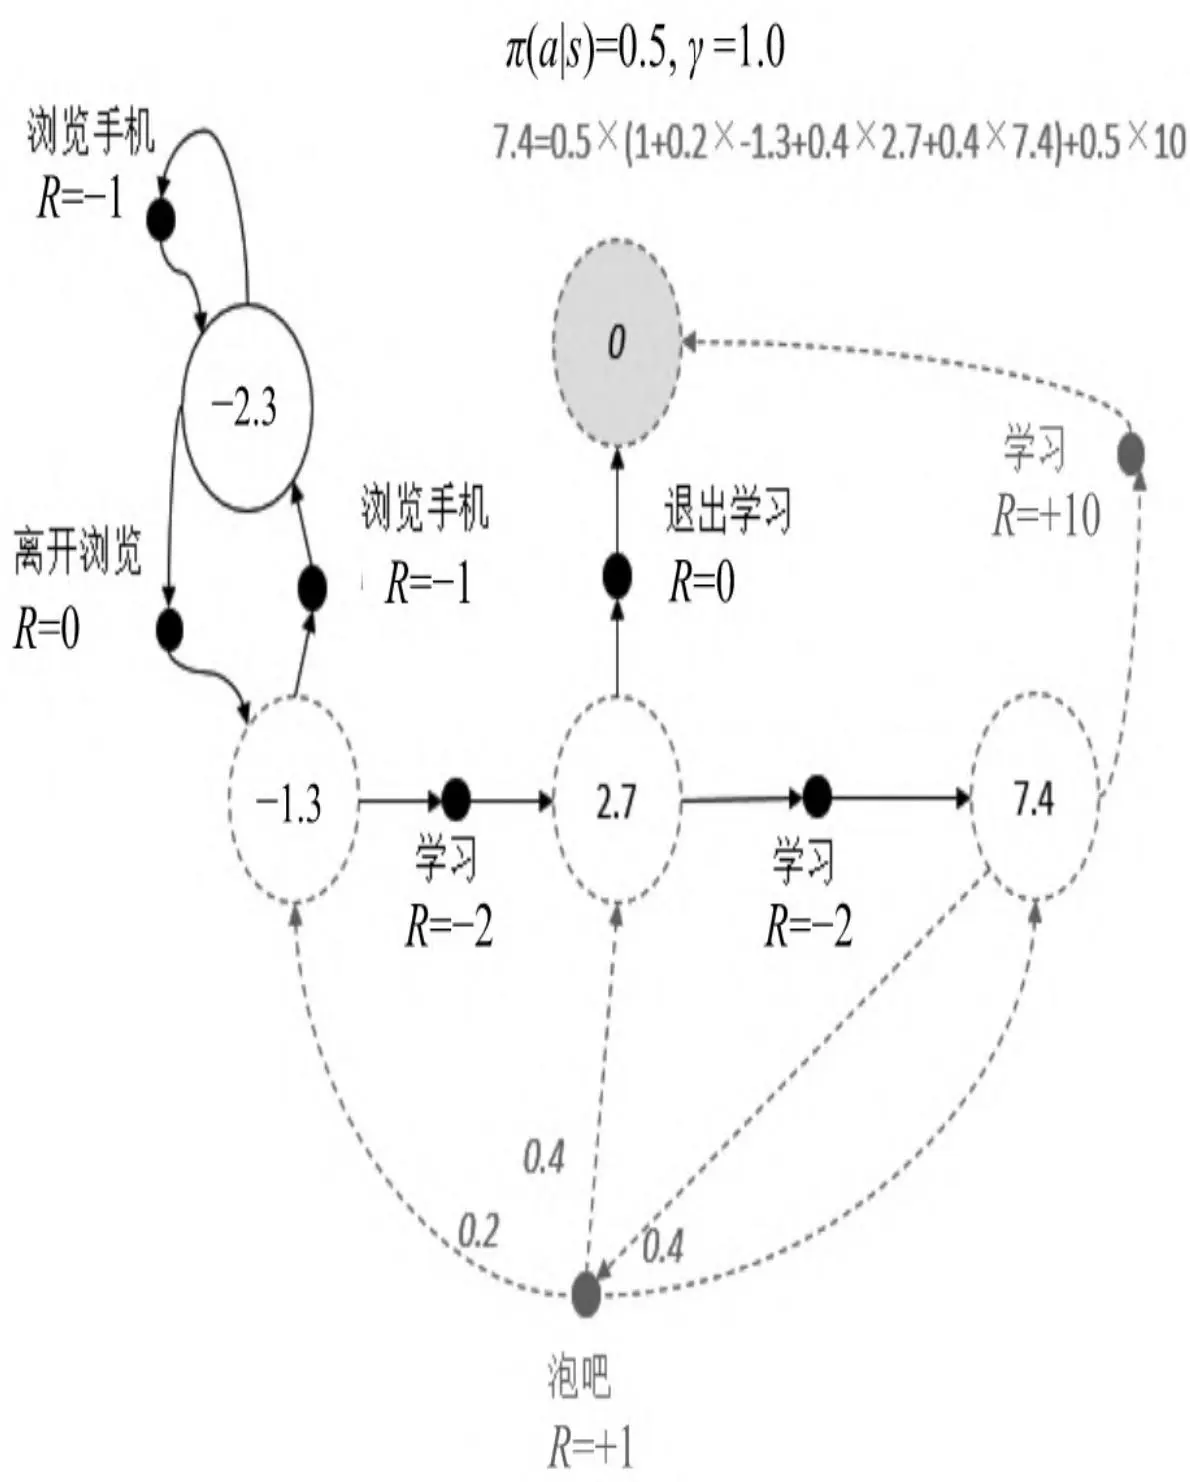
图2.5 基于给定策略的学生马尔可夫决策过程价值函数
给定策略π下的MDP问题可以通过其衍生的MRP和P来求解。不同的策略可以得到不同的价值函数,这些价值函数之间的差别有什么意义?是否存在一个基于某一策略的价值函数,在该策略下每一个状态的价值都比其他策略下该状态的价值高?如果存在,如何找到这样的价值函数?这样的价值函数对应的策略又是什么?为了回答这些问题,我们需要引入最优策略、最优价值函数等概念。
解决强化学习问题意味着要寻找一个最优的策略(让个体在与环境交互过程中获得始终比其他策略都要多的收获),这个最优策略用π表示。一旦找到最优策略π,就意味着该强化学习问题得到了解决。寻找最优策略是一件比较困难的事情,但是可以通过比较两个不同策略的优劣来确定一个较好的策略。
【定义】 最优状态价值函数(Optimal Value Function)是所有策略下产生的众多状态价值函数中的最大者:
$$ v_{*} = \max_{\pi} v_{\pi} (s) \tag{2.19} $$【定义】 最优行为价值函数(Optimal Action-ValueFunction)是所有策略下产生的众多行为价值函数中的最大者:
$$ q_{*} (s, a) = \max_{\pi} q_{\pi} (s, a) \tag{2.20} $$【定义】 策略π优于 $\pi^{\prime} ( \pi \geq \pi^{\prime} )$ ),对于有限状态集里的任意一个状态s,不等式 成立。
可以认为,对于任何马尔可夫决策过程,存在一个最优策略π优于或至少不差于所有其他策略。一个马尔可夫决策过程可能存在不止一个最优策略,但最优策略下的状态价值函数均等同于最优状态价值函数,即 $\nu_{_{\pi} ^{\ast}} ( s ) = \nu_{\ast} ( s )$ 。最优策略下的行为价值函数均等同于最优行为价值函数,即 $q_{\pi^{'}} \left( s , a \right) = q_{*} \left( s , a \right)$ 。
最优策略可以通过最大化最优行为价值函数 $Q_*(s, a)$ )来获得:
$$ \pi^{*} (a \mid s) = \left\{\begin{array}{l l} 1 & a = \underset{a \in A} {\arg \max} q^{*} (s, a) \\ 0 & \text{其他} \end{array} \right. \tag{2.21} $$该式表示,在最优行为价值函数已知时,在某一状态s下,对于行为集里的每一个行为a将对应一个最优行为价值 $\boldsymbol{q} _{*} ( s , a )$ ,最优策略将给予所有最优行为价值中的最大值对应的行为以100%的概率,而其他行为被选择的概率为0,也就是说最优策略在面对每一个状态时将总是选择能够带来最大、最优行为价值的行为。这同时意味着,一旦得到 ,最优策略也就找到了。因此求解强化学习问题就转变为求解最优行为价值函数问题。
拿学生马尔可夫决策过程来说,图2.6用粗虚箭头指出了最优策略,同时也对应了某个状态下的最优行为价值。
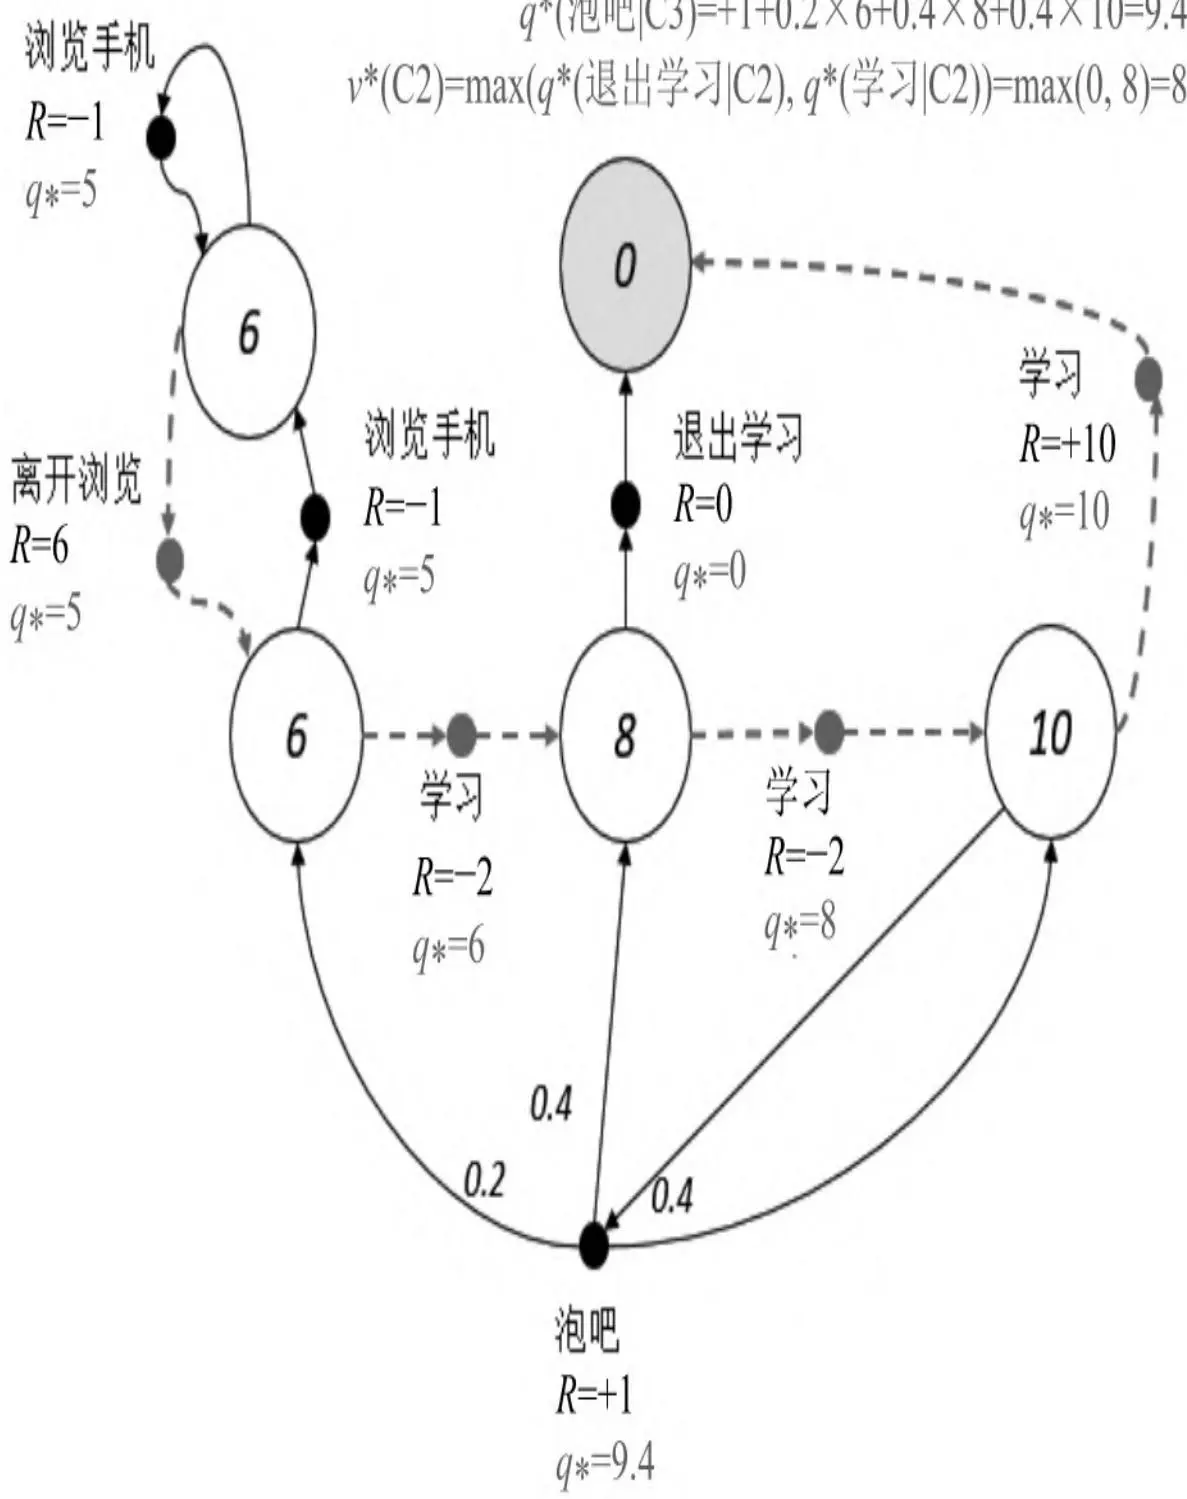
(泡吧C3): +1 + 0.2×6 + 0.4×8 + 0.4×10 = 9.4
图2.6 学生马尔可夫决策过程最优策略
在学生马尔可夫决策过程的例子中,各状态以及相应行为对应的最优价值可以通过回溯法递推计算得到。其中,状态s的最优价值可以由下面的贝尔曼最优方程得到:
$$ v_{*} (s) = \max_{a} q_{*} (s, a) \tag{2.22} $$式(2.22)表示一个状态的最优价值是该状态下所有行为对应的最优行为价值的最大值。这不难理解,对于图2.6学生示例中的状态“第三节课”,可以选择的行为有“学习”和“泡吧”,其对应的最优行为价值分别为10和9.4,因此状态“第三节课”的最优价值就是两者中的最大值10。
由于一个行为的奖励和后续状态并不由个体决定,因此在状态s时选择行为a的最优行为价值将不能使用最大化某一可能的后续状态的价值来计算。它由下面的贝尔曼最优方程得到:
$$ q_{*} (s, a) = R_{s} ^{a} + \gamma \sum_{s^{\prime} \in S} P_{s s^{\prime}} ^{a} v_{*} (s^{\prime}) \tag{2.23} $$式(2.23)表示一个行为的最优价值由两部分组成:一部分是执行该行为后环境给予的确定的即时奖励;另一部分是所有后续可能状态的最优状态价值按发生概率求和,再乘以衰减系数。
同样在学生示例中,考虑学生在“第三节课”选择行为“泡吧”的最优行为价值时,先计入学生采取该行为后得到的即时奖励+1,学生选择了该行为后,并不确定下一个状态是什么,环境根据一定的概率确定学生的后续状态是“第一节课”“第二节课”还是“第三节课”。此时要计算“泡吧”的行为价值势必不能取这3个状态的最大值,而只能取期望值,也就是按照进入各种可能状态的概率来估计总的最优价值,具体表现为:
$$ 6 \times 0. 2 + 8 \times 0. 4 + 10 \times 0. 4 = 8. 4 $$考虑到衰减系数γ=1以及即时奖励为+1,因此在第三节课后采取泡吧行为的最优行为价值为9.4。
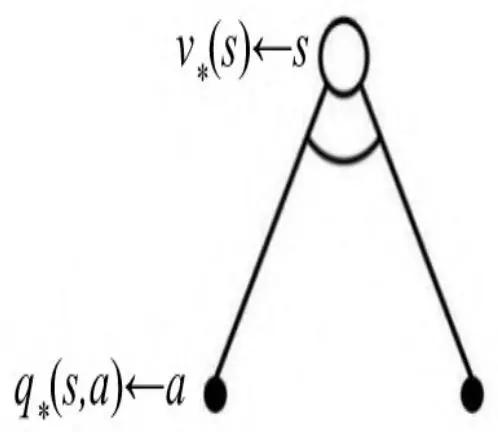
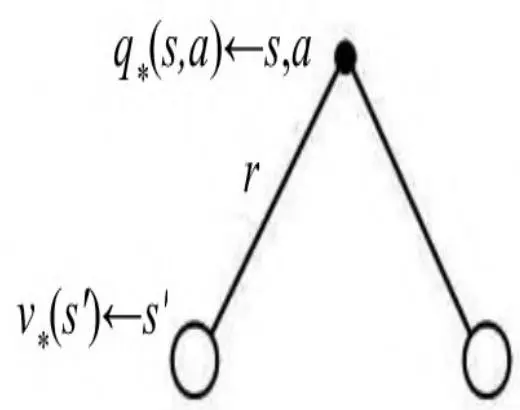
可以看出,某状态的最优价值等同于该状态下所有的行为价值中的最大者,某一行为的最优行为价值可以通过计算该行为可能进入的所有后续状态的最优状态价值来求解。如果把二者联系起来,那么一个状态的最优价值就可以通过计算其后续可能状态的最优价值来求解:
$$ v_{*} (s) = \max_{a} \left(R_{s} ^{a} + \gamma \sum_{s^{\prime} \in S} P_{s s^{\prime}} ^{a} v_{*} (s^{\prime})\right) \tag{2.24} $$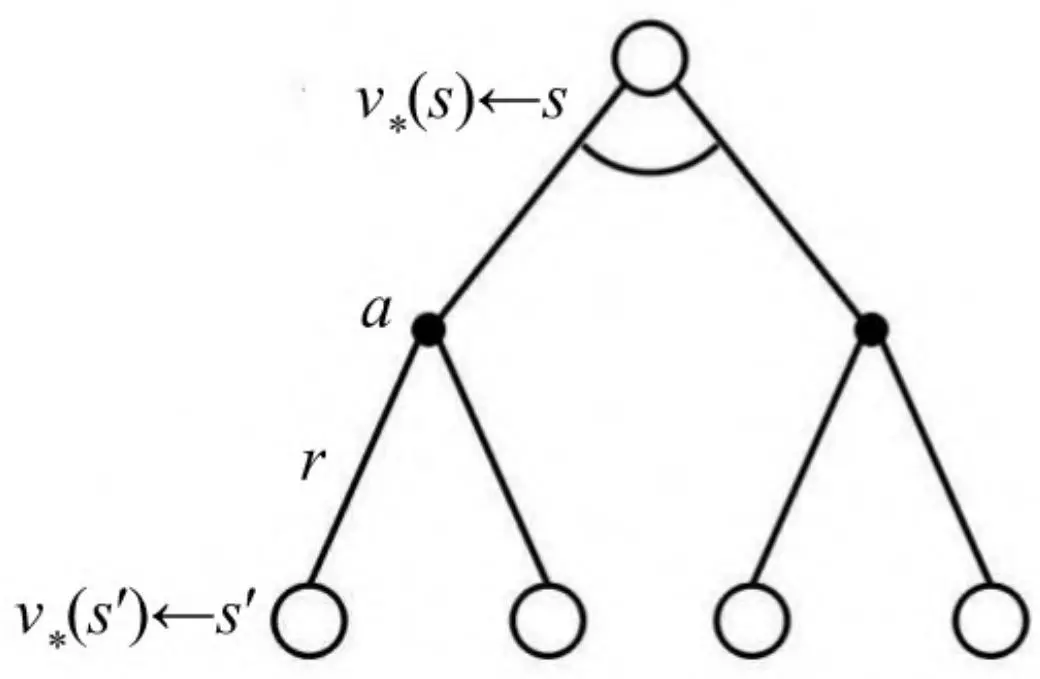
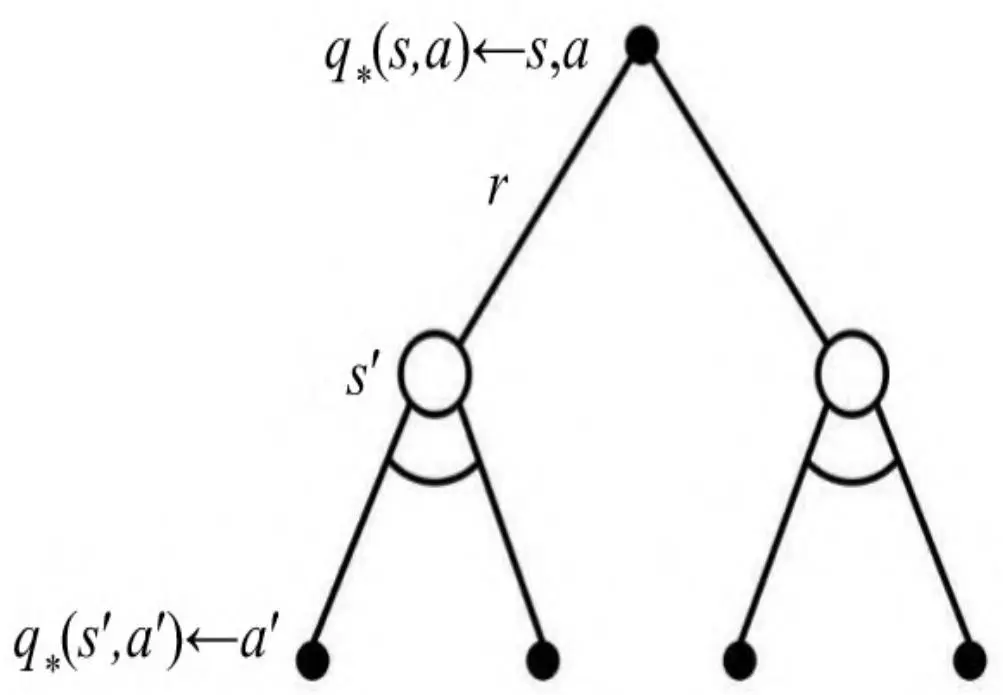
类似地,最优行为价值函数也可以通过计算后续的最优行为价值函数来求解:
$$ q_{*} (s, a) = R_{s} ^{a} + \gamma \sum_{s^{\prime} \in S} P_{s s^{\prime}} ^{a} \max_{a^{\prime}} q_{*} (s^{\prime}, a^{\prime}) \tag{2.25} $$贝尔曼最优方程不是线性方程,无法直接求解,通常采用迭代法来求解,具体有价值迭代、策略迭代、Q学习、Sarsa学习等多种迭代方法,后续几章将陆续介绍。
2.4 编程实践:学生马尔可夫决策示例#
本章的编程实践环节将以学生马尔可夫奖励和决策过程两个示例为核心,通过编写程序并观察程序运行结果来加深对马尔可夫奖励过程、马尔可夫决策过程、收获和价值、贝尔曼期望方程和贝尔曼最优方程等知识的理解。首先我们将讲解如何对一个马尔可夫奖励过程进行建模,随后利用我们建立的模型来计算马尔可夫奖励过程产生的状态序列中某一状态的收获,并通过直接求解线性方程的形式来获得马尔可夫奖励过程的价值函数。在对马尔可夫决策过程进行建模后,我们将编写各种方法实现贝尔曼期望方程给出的基于某一策略下的状态价值和行为价值的关系;同时验证在给出最优价值函数的情况下最优状态价值和最优行为价值之间的关系。
2.4.1 收获和价值的计算#
图2.2给出了定义学生马尔可夫奖励过程所需要的信息。其中,状态集S有7个状态,状态转换概率如果用矩阵的形式则将是一个7×7的矩阵,奖励函数可以用7个标量来表示,分别表示离开某一个状态得到的即时奖励值。在Python中,可以使用列表(List)或字典(Dict)来表示集合数据。在本例中,为了方便计算,我们使用数字索引0~6来表示7个状态,用一个列表嵌套列表的方式来表示状态转移概率矩阵,同时为了方便说明和理解,我们使用两个字典来建立数字对应的状态与其实际状态名的双向映射关系。要实现这些功能,可以这样编写代码:
import numpy as np    # 需要用到NumPy包
num_states = 7
i_to_n = {"0":"C1",    # 索引到状态名的字典
    "1":"C2",
    "2":"C3",
    "3":"Pass",
    "4":"Pub",
    "5":"FB",
    "6":"Sleep",}
n_to_i = {}    # 状态名到索引的字典
for i, name in zip(i_to_n.keys(), i_to_n.values()):
    n_to_i[name] = int(i)

Pss = [
    ## 状态转移概率矩阵
    [0.0, 0.5, 0.0, 0.0, 0.0, 0.5, 0.0],
    [0.0, 0.0, 0.8, 0.0, 0.0, 0.0, 0.2],
    [0.0, 0.0, 0.0, 0.6, 0.4, 0.0, 0.0],
    [0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 1.0],
[0.2, 0.4, 0.4, 0.0, 0.0, 0.0, 0.0],
[0.1, 0.0, 0.0, 0.0, 0.0, 0.9, 0.0],
[0.0, 0.0, 0.0, 0.0, 0.0, 0.0, 1.0]
Pss = np.array(Pss)
rewards = [-2, -2, -2, 10, 1, -1, 0] # 奖励函数,分别与状态对应
gamma = 0.5
衰减因子至此,学生马尔可夫奖励过程就建立了。接下来我们建立一个函数,用来计算一个状态序列中某一状态的收获。由于收获值是针对某一状态序列里某一状态的,因此传递给这个方法的参数需要有一个马尔可夫链、要计算的状态以及衰减系数值。使用式(2.3)来计算,代码如下:
def compute_return(start_index=0, chain=None, gamma=0.5) -
> float:
    '''计算一个马尔可夫奖励过程中某状态的收获值    Args:
    start_index 要计算的状态在链中的位置
    chain 要计算的马尔可夫过程
    gamma 衰减系数
    Returns:
    retrn 收获值
    '''
    retrn, power, gamma = 0.0, 0, gamma
    for i in range(start_index, len(chain)):
    retrn += np.power(gamma, power) *
    rewards[n_to_i[chain[i]]]
    power += 1
    return retrn
我们定义一下正文中以 $S_1$ 为起始状态的几条马尔可夫链,并使用刚才定义的方法来验证最后一条马尔可夫链起始状态的收获值:
chains = [
    ["C1", "C2", "C3", "Pass", "Sleep"],
    ["C1", "FB", "FB", "C1", "C2", "Sleep"],
    ["C1", "C2", "C3", "Pub", "C2", "C3", "Pass",
"Sleep"],
    ["C1", "FB", "FB", "C1", "C2", "C3", "Pub", "C1",
"FB", \
    "FB", "FB", "C1", "C2", "C3", "Pub", "C2", "Sleep"]
]
compute_return(0, chains[3], gamma = 0.5)
将输出: -3.196044921875
也可以修改参数来验证其他收获值。
接下来我们将使用矩阵运算直接求解状态的价值。编写一个计算状态价值的方法,代码如下:
def compute_value(Pss, rewards, gamma = 0.05):
    '''通过求解矩阵方程的形式直接计算状态的价值    Args:
    P状态转移概率矩阵shape(7, 7)
    rewards即时奖励列表
    gamma衰减系数
    Return
    values各状态的价值
    '''
    ## assert(gamma >= 0 and gamma <= 1.0)
    ## 将rewards转为NumPy数组并修改为列向量的形式
    rewards = np.array(rewards).reshape((-1, 1))
    ## np.eye(7, 7)为单位矩阵,inv方法为求矩阵的逆
    values=np.dot(np.linalg.inv(np.eye(7, 7)-gamma*Pss), rewards)
    return values
values = compute_value(Pss, rewards, gamma = 0.99999)
print(values)
将输出:
[[-12.54296219]]
[1.4568013]
[4.32100594]
[10. ]
[0.80253065]
[-22.54274676]
[0.]在利用矩阵的逆直接求解状态价值时,本示例的状态转移概率矩阵 $P_{ss}$ 的设置使得当γ=1时需要计算的矩阵的逆恰好不存在,因而我们给γ一个近似于1的值,计算得到的状态价值取一位小数后与图2.3显示的状态值相同。
2.4.2 验证贝尔曼方程#
本节将使用学生马尔可夫决策过程例子中的数据,如图2.4所示,状态数变成5个,为了方便理解,我们把这5个状态分别命名为“浏览手机中”“第一节课”“第二节课”“第三节课”“休息中”;行为总数也是5个,分别命名为“浏览手机”“学习”“离开浏览”“泡吧”“退出学习”,但具体到某一状态则只有两个可能的行为。与马尔可夫奖励过程不同,马尔可夫决策过程的状态转移概率与奖励函数均与行为相关。本例中多数状态下某行为将以100%的概率到达一个后续状态,但在状态“第三节课”中选择“泡吧”行为除外。在对该马尔可夫决策过程进行建模时,将使用字典来存放这些概率和奖励数据。我们事先已经写好了一些工具方法来操作字典,包括根据状态和行为来生成一个字典的键、显示和读取相关字典内容等,可以在本节的最后找到这些代码。我们要操作的字典除了记录状态转移概率和奖励数据外,还将设置一个记录状态价值的字典以及下文会提及的一个策略字典。具体如下:
导入工具函数:根据状态和行为生成操作相关字典的键,显示字典内容

from utils import str_key, display_dict

设置转移概率、奖励值以及读取它们的方法

from utils import set_prob, set_reward, get_prob, get_reward

设置状态价值、策略概率以及读取它们的方法

from utils import set_value, set_pi, get_value, get_pi构建学生马尔可夫决策过程#
S = ['浏览手机中', '第一节课', '第二节课', '第三节课', '休息中']
A = ['浏览手机', '学习', '离开浏览', '泡吧', '退出学习']
R = {}    # 奖励Rsa字典
P = {}    # 状态转移概率Pss'a字典

gamma = 1.0    # 衰减因子
根据学生马尔可夫决策过程示例的数据设置状态转移概率和奖励,默认概率为1
set_prob(P, S[0], A[0], S[0])    # 浏览手机中-浏览手机->浏览手机中
set_prob(P, S[0], A[2], S[1])    # 浏览手机中-离开浏览->第一节课
set_prob(P, S[1], A[0], S[0])    # 第一节课-浏览手机->浏览手机中
set_prob(P, S[1], A[1], S[2])    # 第一节课-学习->第二节课
set_prob(P, S[2], A[1], S[3])    # 第二节课-学习->第三节课
set_prob(P, S[2], A[4], S[4])    # 第二节课-退出学习->休息中
set_prob(P, S[3], A[1], S[4])    # 第三节课-学习->休息中
set_prob(P, S[3], A[3], S[1], p = 0.2)  # 第三节课-泡吧->第一节课
set_prob(P, S[3], A[3], S[2], p = 0.4)  # 第三节课-泡吧->第二节课
set_prob(P, S[3], A[3], S[3], p = 0.4)  # 第三节课-泡吧->第三节课
set_reward(R, S[0], A[0], -1)    # 浏览手机中-浏览手机->-1
set_reward(R, S[0], A[2], 0)    # 浏览手机中-离开浏览->0
set_reward(R, S[1], A[0], -1)    # 第一节课-浏览手机->-1
set_reward(R, S[1], A[1], -2)    # 第一节课-学习->-2
set_reward(R, S[2], A[1], -2)    # 第二节课-学习->-2
set_reward(R, S[2], A[4], 0)    # 第二节课-退出学习->0
set_reward(R, S[3], A[1], 10)    # 第三节课-学习->10
set_reward(R, S[3], A[3], +1)    # 第三节课-泡吧->-1
MDP = (S, A, R, P, gamma)
至此,描述学生马尔可夫决策过程的模型就建立好了。当该MDP构建好之后,我们可以调用显示字典的方法来查看设置是否正确:
print("----状态转移概率字典(矩阵)信息:----")
display_dict(P)
print("----奖励字典(函数)信息:----")
display_dict(R)
将输出如下结果:
----状态转移概率字典(矩阵)信息:----
第三节课_学习_休息中:1.00
第三节课_泡吧_第三节课:0.40
浏览手机中_浏览手机_浏览手机中:1.00
第一节课_浏览手机_浏览手机中:1.00
第三节课_泡吧_第二节课:0.40
第三节课_泡吧_第一节课:0.20
第一节课_学习_第二节课:1.00
第二节课_学习_第三节课:1.00
第二节课_退出学习_休息中:1.00
浏览手机中_离开浏览_第一节课:1.00
#
----奖励字典(函数)信息:----
第三节课_学习:10.00
第一节课_学习:-2.00
浏览手机中_离开浏览:0.00
第二节课_学习:-2.00
第二节课_退出学习:0.00
第三节课_泡吧:1.00
第一节课_浏览手机:-1.00
浏览手机中_浏览手机:-1.00一个MDP中状态的价值是基于某一给定策略的。要计算或验证该学生马尔可夫决策过程,我们需要先指定一个策略π,这里考虑使用均匀随机策略(Uniform Random Policy),也就是在某状态下所有可能的行为被选择的概率相等,对于每一个状态只有两种可能行为的该学生马尔可夫决策过程来说,每个可选行为的概率均为0.5。初始条件下所有状态的价值均设为0。与状态转移概率和奖励函数一样,策略与价值也各用一个字典来维护。在编写代码时,我们使用Pi(或pi)来代替π。该段代码如下:
S = ['浏览手机中', '第一节课', '第二节课', '第三节课', '休息中']
A = ['浏览手机', '学习', '离开浏览', '泡吧', '退出学习']设置行为策略:pi(a|.) = 0.5
Pi = {}
set_pi(Pi, S[0], A[0], 0.5) # 浏览手机中 - 浏览手机
set_pi(Pi, S[0], A[2], 0.5) # 浏览手机中 - 离开浏览
set_pi(Pi, S[1], A[0], 0.5) # 第一节课 - 浏览手机
set_pi(Pi, S[1], A[1], 0.5) # 第一节课 - 学习
set_pi(Pi, S[2], A[1], 0.5) # 第二节课 - 学习
set_pi(Pi, S[2], A[4], 0.5) # 第二节课 - 退出学习
set_pi(Pi, S[3], A[1], 0.5) # 第三节课 - 学习
set_pi(Pi, S[3], A[3], 0.5) # 第三节课 - 泡吧
print("----状态转移概率字典(矩阵)信息:----")
display_dict(Pi)
初始时价值为空,访问时会返回0
print("----状态转移概率字典(矩阵)信息:----")
V = {}
display_dict(V)
将输出如下结果:
----状态转移概率字典(矩阵)信息:----
第二节课_学习:0.50
第三节课_学习:0.50
第二节课_退出学习:0.50
浏览手机中_浏览手机:0.50
第三节课_泡吧:0.50
第一节课_浏览手机:0.50
第一节课_学习:0.50
浏览手机中_离开浏览:0.50
#
----状态转移概率字典(矩阵)信息:----下面我们将编写代码来计算在给定MDP和状态价值函数v的条件下,在状态s时采取了行为a的价值q(s,a),依据是式(2.16)。该计算过程不涉及策略,代码如下:
def compute_q(MDP, V, s, a):
    '''根据给定的MDP,价值函数V,计算状态行为对“s, a”的价值qsa    '''
    S, A, R, P, gamma = MDP
    q_sa = 0
    for s_prime in S:
q_sa += get_prob(P, s, a, s_prime) * get_value(V, s_prime)
q_sa = get_reward(R, s, a) + gamma * q_sa
return q_sa依据式(2.15),我们可以编写如下方法来计算给定策略Pi下某一状态的价值:
def compute_v(MDP, V, Pi, s):
    '''给定MDP下,依据某一策略Pi和当前状态价值函数V来计算某状态s的价值    '''
    S, A, R, P, gamma=MDP
    v_s = 0
    for a in A:
    v_s += get_pi(Pi, s, a) * compute_q(MDP, V, s, a)
return v_s至此,我们就可以验证学生马尔可夫决策过程中基于某一策略下各状态以及各状态行为对的价值了。不过在验证之前,我们先给出在均匀随机策略下该学生马尔可夫决策过程的最终状态函数。下面的两个方法将完成这个功能。在本章中对下面这段代码不做要求,可以在学习第3章内容后再来理解:
根据当前策略使用回溯法来更新状态价值,本章不做要求
def update_V(MDP, V, Pi):
    '''给定一个MDP和一个策略,更新该策略下的价值函数V    '''
    S, _, _, _, _ = MDP
    V_prime = V.copy()
    for s in S:
    ##set_value(V_prime, s, V_S(MDP, V_prime, Pi, s))
V_prime[str_key(s)] = compute_v(MDP, V_prime, Pi,s)
return V_prime
策略评估,得到该策略下最终的状态价值,本章不做要求
def policy_evaluate(MDP, V, Pi, n):
'''使用n次迭代计算来评估一个MDP在给定策略Pi下的状态价值,初始时价值为V '''
for i in range(n):
V = update_V(MDP, V, Pi)
##display_dict(V)
return V
V=policy_evaluate(MDP, V, Pi, 100)
display_dict(V)
将输出如下结果:
第一节课:-1.31
第三节课:7.38
浏览手机中:-2.31
第二节课:2.69
休息中:0.00我们来计算一下在均匀随机策略下状态“第三节课”的最终价值,写入下面的代码:
v = compute_v(MDP, V, Pi, "第三节课")
print("第三节课在当前策略下的最终价值为:{:.2f}".format(v))
将输出如下结果:
第三节课在当前策略下的最终价值为:7.38
可以看出该结果与图2.5所示的结果相同(四舍五入)。读者可以修改代码验证其他状态在该策略下的最终价值。
不同的策略下得到各状态的最终价值并不一样。在最优策略下最优状态价值的计算将遵循式(2.22),此时一个状态的价值将是在该状态下所有行为价值中的最大值。我们编写如下方法来实现计算最优策略下最优状态价值的功能:
def compute_v_from_max_q(MDP, V, s):
    '''根据一个状态下所有可能的行为价值中最大的一个来确定当前状态价值    '''
    S, A, R, P, gamma = MDP
    v_s = -float('inf')
    for a in A:
    qsa = compute_q(MDP, V, s, a)
    if qsa >= v_s:
    v_s = qsa
return v_s下面这段代码实现了在给定MDP下得到最优策略以及对应的最优状态价值的一种办法,同样这段代码可以在学习第3章内容之后再来仔细理解:
def update_V_without_pi(MDP, V):
    '''在不依赖策略的情况下直接通过后续状态的价值来更新状态价值    '''
    S, _, _, _, _ = MDP
    V_prime = V.copy()
    for s in S:
    ##set_value(V_prime, s, compute_v_from_max_q(MDP, V_prime, s))
    V_prime[str_key(s)]=compute_v_from_max_q(MDP, V_prime, s)
    return V_prime

价值迭代,本章不做要求
def value_iterate(MDP, V, n):
'''价值迭代 '''
for i in range(n):
V = update_V_without_pi(MDP, V)
return V
V = {}
通过价值迭代得到最优状态价值
V_star = value_iterate(MDP, V, 4)
display_dict(V_star)
将输出如下结果:
第一节课:6.00
第三节课:10.00
浏览手机中:6.00
第二节课:8.00
休息中:0.00上面的代码输出的各状态的最终价值与图2.6所示的结果相同。有了最优状态价值,我们可以依据式(2.23)计算最优行为价值,不必再为此编写一个方法,之前的方法compute_q就可以完成这个功能。使用下面的代码来验证在状态“第三节课”时选择“泡吧”行为的最优价值:
验证最优行为价值
s, a = "第三节课", "泡吧"
q = compute q(MDP, V star, "第三节课", "泡吧")
print("在状态 {} 选择行为 {} 的最优价值为: {:.2f}".format(s,a,q))
输出结果如下:
在状态“第三节课”选择行为“泡吧”的最优价值为9.40
本章的编程实践到此结束。下面的代码是马尔可夫决策过程一开始导入的方法,保存在与之前代码的同一文件夹下,文件名为
def str_key(*args):
    '''将参数用"_"连接起来作为字典的键,需注意参数本身可能会是元组类型或者列表类型,    比如类似((a,b,c),d)的形式。
    '''
    new_arg = []
    for arg in args:
    if type(arg) in [tuple, list]:
    new_arg += [str(i) for i in arg]
    else:
    new_arg.append(str(arg))
    return "_".join(new_arg)

def set_dict(target_dict, value, *args):
    target_dict[str_key(*args)] = value

def set_prob(P, s, a, s1, p = 1.0):    # 设置概率字典
    set_dict(P, p, s, a, s1)

def get_prob(P, s, a, s1):    #
获取概率值
    return P.get(str_key(s,a,s1), 0)

def set_reward(R, s, a, r):    # 设置奖励值
    set_dict(R, r, s, a)

def get_reward(R, s, a):    # 获取奖励值
    return R.get(str_key(s,a), 0)

def display_dict(target_dict):    # 显示字典内容
    for key in target_dict.keys():
    print("{}: {:.2f}".format(key, target_dict[key]))
    print("")
def set_value(V, s, v):    # 设置价值字典
    set_dict(V, v, s)

def get_value(V, s):    # 获取价值
字典
return V.get(str_key(s), 0)def set_pi(Pi, s, a, p = 0.5):set_dict(Pi, p, s, a)设置策略字典#
def get_pi(Pi, s, a):获取策略#
(概率)值
return Pi.get(str_key(s, a), 0)