第1章 概述#
强化学习的历史最早可以追溯到20世纪50年代在研究关于动物学习心理学时产生的试错学习,同时工业控制领域对强化学习的发展也产生了不小的推动作用。本章简要叙述强化学习的历史,并初步介绍强化学习领域的一些既基本又非常重要的概念,最后简要说明本书的章节组织和一些代码资源。
强化学习的历史#
强化学习的历史可以用两条各自独立但丰富多彩的主线来追溯。其中一条主线源于研究动物学习心理学时产生的试错学习,它贯穿了一些人工智能领域最早期的工作,随后从20世纪80年代延续至今,复兴了强化学习的研究。另一条主线聚焦于研究最优化控制,以及使用价值函数动态规划等算法来寻找问题的解决方案。这两条主线在很长时间里是相对独立发展的,如今的强化学习理论主要是第一条主线的延续。
对于第二条主线,最优化控制这一术语最早出现在20世纪50年代,它探讨如何设计一个控制系统来衡量一个随时间变化的动态系统的行为。理查德·贝尔曼曾提出使用“状态”和“价值函数”等概念构建贝尔曼方程,并且通过动态规划算法来求解这个方程,以此来求解动态系统的最优化控制问题。贝尔曼也提出了最优化控制的离散随机版本:马尔可夫决策过程(Markov Decision Process,MDP)。RonHoward提出了解决MDP问题的策略迭代方法。这些概念对于理解现今的强化学习算法都是至关重要的。动态规划算法在很长时期内被认为是解决随机最优化问题的唯一可行算法,尽管该算法的时间复杂度会随着系统状态数量的增多呈指数级增长,但还是比其他一些算法高效。本书也会介绍用动态规划算法来解决强化学习的问题。
回到第一条主线:试错学习。试错学习的精髓在于那些能够带来好结果的行为在后续决策中更容易被采纳,而那些曾经带来不好结果的行为则倾向于避免被选择。最早提出这一思想的学者Thorndike将其命名为“效果法则”(Law of Effect),它描述了在选择行为的倾向性上强化事件的效果。这一法则包含试错学习中两个重要的方面:第一个方面是“选择”,指尝试各种可能的行为并且通过比较各种行为的后果从中进行选择;第二个方面是“联想”,强调选择的行为与特定场景是呼应的。换句话说,效果法则的两个方面分别相当于“探索”和“记忆”:前者指的是从每一个状态下的众多可选行为中尝试选择其中一个,后者指的是要记住在特定场景下最有效的行为。效果法则的这两个方面是强化学习算法中必不可少的两个概念。
“强化学习”术语最早出现在20世纪60年代的文献中,其中受关注最多的是Minsky的一篇论文“Steps Toward Artificial Intelligence”。在这篇论文中,作者讨论了与强化学习相关的几个问题,其中包括“信用分配问题”,即导致最后成功的前期各个行为对这一成功结果的贡献程度。这是强化学习领域所要解决的一个极其重要的问题。
在强化学习的发展过程中,一些研究人员模糊了强化学习和监督式学习的界限并带来了一些困惑,比如把强化学习中的奖励和惩罚与监督式学习中的样本标签进行对应,把试错学习过程同提供正反两种标签的监督式学习样本联系起来。这些联系忽略了试错学习的精髓:
“选择”和“联想”。这些困惑导致在20世纪60年代到70年代强化学习的进展不大。
除了“最优化控制”和“试错学习”这两条主线,强化学习的发展历史上还有一条线索,即“时序差分学习”(Temporal-DifferenceLearning)。这条线索主要是受到心理学中研究动物学习的一些启发,特别是“次级强化子”(Secondary Reinforcer)的影响。它为强化学习提供了一个独特、新颖同时又十分重要的方法。Sutton等人将时序差分学习进行了推广,并提出了TD(λ)算法。本书也会介绍“时序差分学习”方法的基本思想。
自20世纪80年代起,强化学习迎来了一次快速发展的时期。Actor-Critic架构于1981年被提出。整合了试错学习和最优化控制的Q学习算法于1989年被提出。进入21世纪后,深度学习技术的发展给强化学习算法带来了新的生命,两者的结合很好地解决了诸如“围棋”之类极其复杂的问题。
1.2 强化学习的基本概念#
强化学习主要研究这样一类问题:具有一定思考和行为能力的个体(Agent)在与其所处的环境(Environment)进行交互的过程中,通过学习策略达到收获最大化或实现特定的目标。其中,“个体”处在“环境”中,在某时刻可以有一个对自身的认识,这可以表示成个体自身在该时刻的状态(State)。个体在某时刻可以向环境实施一个行为(Action),环境会因为这一行为做出相应的改变并给予个体一定形式的反馈,个体接收到这个反馈后可以建立“自身状态”“所施行为”及“所得反馈”之间的联系,作为自身记忆的一部分给后续的决策提供参考。个体在不同状态下向环境施加的各种不同行为则构成了个体与环境交互的“策略”(Policy)。个体策略的构建与个体的目的密切相关。环境给予个体的反馈通常是一个数值(由一个标量确定的数值),表达环境对于个体的奖励或惩罚的程度,可称之为“奖励”(Reward)。个体构建策略的目的就是要争取通过与环境的交互而获得尽可能多的累积奖励值。
举个例子,图1.1是一个由7×10的格子组成的矩形区域,我们可以认为该矩形区域构成了一个环境,可称之为“格子世界”环境。格子世界是一个二维世界,可以用一个二维坐标系统来描述格子世界中每一个格子位置的坐标。假设最左下角的格子位置为(0,0),那么格子世界中镶边的白色格子的位置可以用(7,3)来表示。在(0,3)位置用一个小球代表一个可以在格子世界中移动的个体。小球在任意一个时刻可以往上、下、左、右4个方向移动一格,构成小球在格子世界中可能的行为集合。格子世界这个环境有其特定的动力学特征,严格规定了小球的运动方式(环境规则):小球采取朝某一个方向的移动行为不会导致它越过格子世界的边界,环境将允许小球到达它移动方向上相邻的格子;如果小球移动的下一个位置会超出格子世界的边界,那么环境将让小球停留在当前的格子内。以小球采取“向右移动”这一行为为例,只要小球没有在格子世界最右侧的边界格子中,环境就允许它向右移动一格到达新的格子,如果小球已经在格子世界最右侧的边界格子中,那么环境将让它保持在最右侧的这个边界格子中不动。现在我们提出一个问题:希望个体能够通过最少的移动次数从起始位置(0,3)移动到目标位置(7,3)。为此,我们设定一个奖惩系统:对于任何没有到达目标位置的每一次移动行为,我们都会给小球一个数值为-1的奖励(或者说是数值为1的惩罚),如果小球到达了目标位置,我们一次性给予一定正数的奖励。如此,我们的问题就转化为希望小球在到达目标位置时获得的累积奖励最大。
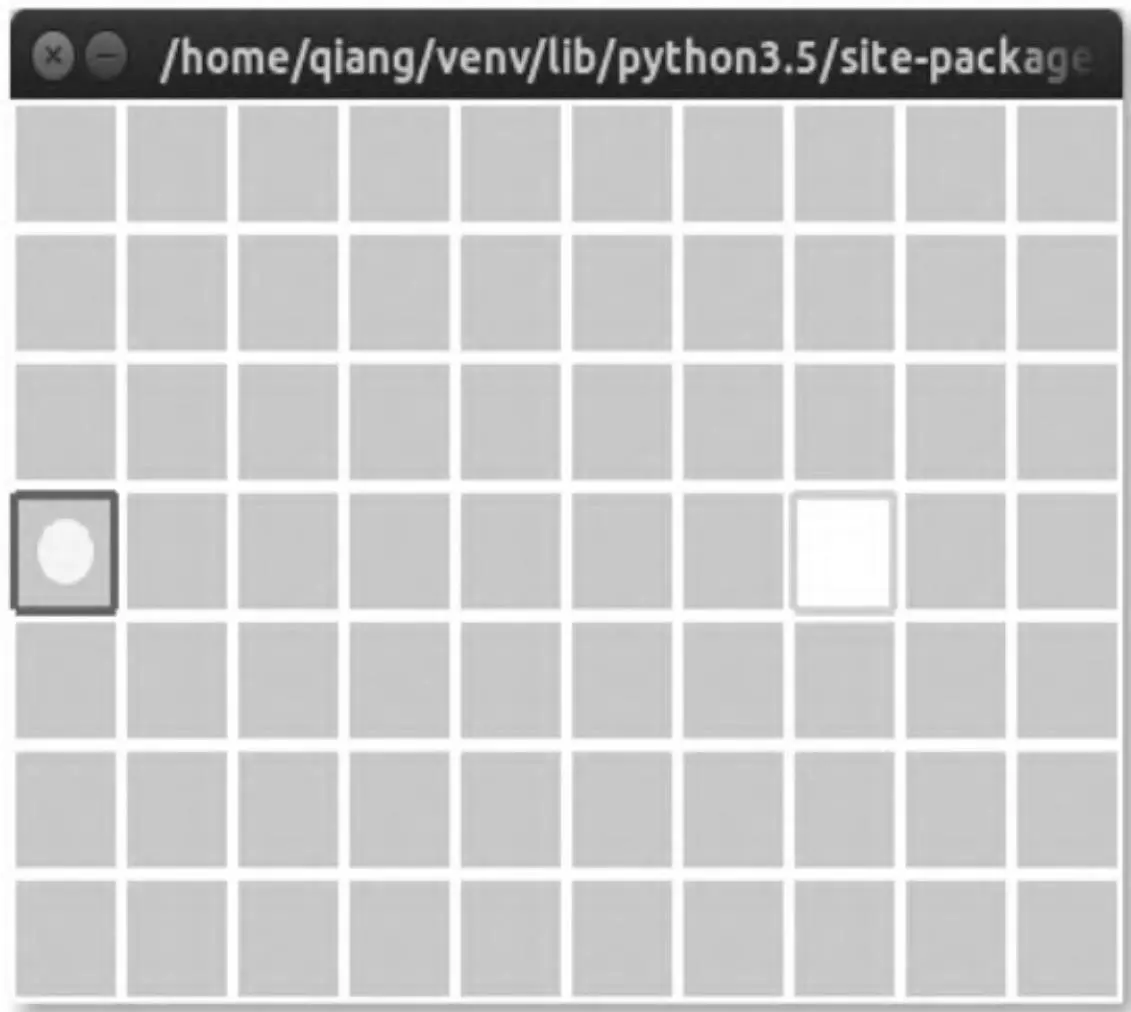
图1.1 “格子世界”环境
看起来这是一个非常简单的问题。根据描述的格子世界规则和小球的可选行为,只要小球一直朝着右侧移动7次就能以最少的移动次数到达目标位置。确实如此,持续向右移动7次是这个问题的最优解,因为读者清楚地知道格子世界的整个构造,而且格子世界的规则也非常简单。如果从小球的角度来看,又会是什么样的情形呢?通常情况下,开始时小球对这个格子世界一无所知,它只知道自己置身于格子世界的某一个位置,可能并不知道它所在位置的坐标信息(这取决于格子世界是否愿意提供给小球坐标信息)。假设格子世界不将位置信息告知小球,而只是告诉小球每一个位置对应的是一个一个数字所组成的代号,也就是说小球在进入一个新的格子时只知道这个格子的代号,并且在与格子世界进行交互的初期只能判断出自己之前是否曾进入这个格子,而无法知道所经过的格子之间的相对位置关系。例如,我们可以从每一个格子的位置(x,y)信息得到由单个数字x+10y所表达的信息并提供给小球,甚至可以仅提供给小球所在格子坐标中的一维信息。也就是说,小球无法完整地观测到自身的位置信息,只能观测到环境允许它观测到的信息。在这种情况下,小球要想以最短的步数从起始位置移动到目标位置就不那么容易了。那么它应该如何做呢?
使用强化学习算法来求解这个问题,我们会用到试错学习的两个方面:第一,小球可以从4个行为中选择其中一个;第二,小球要能记住自己在某个状态下实施某一行为后从格子世界得到的反馈,包括小球对实施行为前后的位置观测、小球从格子世界得到的即时奖励反馈。小球对自己所处的不同位置有一个价值评估,在新的位置上,小球要利用自己的记忆和对状态的价值评估来逐渐地优化自己的策略,以便实施更高效的行为,朝着目标格子前进。至于具体如何实现这一算法,我们将在后续的章节介绍。
从上述例子中,我们可以抽象出一些基本概念。个体可以结合自身在某时刻所获得的奖励值来评估这一状态(State)的价值(Value),并通过选择某一行为来让自身处在价值更高的状态。这种从状态到价值的映射可以用状态价值函数(State Value Function)来表示。个体也可以评估在某一状态下采取各种不同可能行为的价值,进而选取那些能够在该状态下带来较大价值的行为。这种针对某一状态下某一行为的价值评估可以用状态行为价值函数(State-Action Value Function)来描述,简称行为价值函数。状态(或行为)价值函数是个体对未来奖励的预测,用来衡量个体在某一个状态(或某一状态行为组合)下的好坏程度并指导后续行为的选择。
环境有一套描述自己的规则,称为环境的动力学特征(Dynamics)。个体能从环境得到的信息取决于环境开放给个体的信息,当环境把描述自身的所有信息都开放给个体时,我们认为对于该个体来说环境是完全可观测的(Fully Observable)。当环境仅开放部分信息给个体时,我们认为对于该个体而言环境是部分可观测的(Partial Observable)。环境永远不会开放自身的动力学特征给个体,仅提供个体可观测的信息以及个体在实施每一次行为后给予个体的奖励信息。一些个体可以通过观测及奖励信息对环境的动力学特征进行建模,而后根据建模得到的模型(Model)来决定个体的行为。个体建立的模型可以很接近环境的动力学特征,也可以与环境的动力学特征有较大差别,这取决于个体在已掌握信息下的建模水平。一个完整的模型通常会预测个体在实施某一行为后的下一个状态以及个体可能从环境得到的即时奖励值。
为了便于理解环境的动力学特征和个体构建的模型之间的关系,我们可以用人类认识宇宙的过程来做个类比:宇宙相当于环境,人类相当于个体。宇宙以什么样的规律运行取决于宇宙自身的动力学特征,人类可能永远无法完全弄清楚。但是几百年来,从早期的“地心说”到随后的“日心说”、从牛顿的三大定律到爱因斯坦的相对论等都是人类建立的试图解释宇宙动力学特征的模型。牛顿的三大定律没有爱因斯坦的相对论完善准确,这是因为人类的认识在进步,同时人类的观测水平在进步,人类构建的认识宇宙的模型也在不断发展。
在强化学习中,策略(Policy)与生活中所说的策略的含义十分接近。用数学的语言来描述,策略是从个体状态到行为的一个映射(Mapping)。如果一种策略在一个确定的状态下能够产生一个确定的行为,那么这种策略就可以称为确定性策略(DeterministicPolicy)。相反,如果某一种策略在确定状态下不能产生一个确定的行为,而是提供各种可能行为的概率,那么这种策略就可以称为随机性策略(Stochastic Policy)。这两种策略均有各自的应用场景。
在求解强化学习问题时,个体通常会建立策略、模型、价值函数这三个组件中的一个或多个,通过与环境的交互来积累经历,形成记忆,并从这些记忆中提取经历,不断地试错学习来优化自身的策略、模型或价值函数,逐渐逼近问题的最优解。根据个体建立的组件的特点,我们可以将强化学习中的个体进行如下分类:
- 仅基于价值函数:这样的个体有对状态价值的估计函数,但是没有直接的策略函数,策略函数由价值函数间接得到。
- 仅直接基于策略:在这样的个体中,行为直接由策略函数产生,个体并不维护一个对各状态价值的估计函数。
- 演员-评判家(Actor-Critic)类型:这样的个体既有价值函数也有策略函数,两者相互结合解决问题。
此外,根据个体是否建立一个针对环境动力学的模型,可将其分为两大类:
- 不基于模型的个体:这类个体并不试图了解环境如何工作,而仅聚焦于价值和策略函数,或者二者之一。
- 基于模型的个体:个体尝试建立一个描述环境运作过程的模型,以此来指导价值或策略函数的更新。
以上两种分类方式相结合可以形成多种多样的组合方式,这里不再详述。
个体通过与环境进行交互,逐渐改善其行为的过程称为学习(Learning)过程。当个体对于环境如何工作有了一定的认识,在与环境进行实际的交互前,模拟分析个体与环境交互情况的过程称为规划(Planning)过程。一个常用的强化问题解决思路是让个体先学习环境如何工作,在具备了一定的认识环境的能力后,利用这个能力进行一定的规划工作,两者相互结合来解决问题,这其实与人类解决实际问题的思路是比较一致的。
当具备一定智能水平的个体在继续与环境进行交互时,它也可能会遇到一些困惑。比如,个体处于某一状态时,它会根据自身学习所得的能力来决策产生一个建议的行为,而舍弃其他的可选行为。这种方式似乎是明智的,但又隐藏着很大的风险。个体如何能确定自己产生的建议行为就一定是而且总是最优的行为呢?无法确定。首先这要求个体必须在同一个状态下尝试过相当多次的非最优行为,否则个体推荐的最优行为就是不可靠的,但是尝试过多的非最优行为需要相当多次的学习过程,而且会降低个体的学习效率,这通常是不现实的。此外,环境本身及其动力学特征可能也不是一成不变的,一旦发生变化,那么先前个体得到的最优行为可能就不再是环境变化后的最优行为了。这种困惑的背后其实是关于个体的探索(Exploration)与利用(Exploitation)之间的矛盾。个体通常要在偏好探索和偏好利用之间取得一个平衡。偏好探索指的是,个体在与环境进行交互的过程中,会偏好于从不是自身认为最优的其他可选行为中选取一个并作用于环境;偏好利用则相反,这样的个体更倾向于选择实施自身认为最优的行为。举个生活中的例子:你去某个餐饮一条街就餐,偏好探索意味着你对自己之前没去过的新餐厅感兴趣,很可能最终会去一家以前没有去过的新餐厅体验,或者选择以前去过但感觉不好的餐厅,再去看看这个餐厅有没有什么积极的变化;偏好利用意味着你更愿意去那个以往去过且体验最佳的餐厅。很显然,这两种做法是一对矛盾,但对解决强化学习问题非常重要。没有探索,个体就没有机会体验可能发生的变化,进而无法找到可靠的最优解;没有利用则意味着个体始终处在各种选择过程中,无法固定到最优的一个结果中。本书将在后续多个章节中穿插介绍如何平衡探索与利用,并在第9章对平衡探索和利用进行理论分析。
在强化学习中还有一些概念也比较常用,比如预测(Prediction)和控制(Control)。这些概念与实际生活中的概念比较接近。预测指的是在给定一个策略下,个体对未来进行一个评价,也可以认为是求解给定策略下的价值函数问题,它间接衡量在一个给定策略下个体表现的优劣程度。控制指的是试图寻找一个最优策略来最大化奖励,即最优化个体的表现。
深度强化学习(Deep Reinforcement Learning)指的是将深度学习相关的算法融入强化学习算法中,两者相互结合来解决规模较大的实际问题。“规模较大”既可以指状态(或可选行为)数目很多,也可以指状态(或行为)不是离散的值而是一段连续的区间。即使在当今计算能力和内存空间都十分强大的计算环境下,不结合深度学习技术,也无法解决那些诸如“围棋”博弈问题等规模很大的实际问题。深度学习技术可以用来对各种函数进行符合要求的近似,继而减少计算消耗或内存的使用,为解决大规模实际问题提供可能。
如果把强化学习与监督式机器学习进行对比,我们不难有如下认识:强化学习没有监督数据,只有奖励信号;强化学习中的奖励信号不一定是实时的,很可能是延后的,甚至延后很多,当然通过设计可以认为强化学习的奖励是实时的,对于那些缺少有意义的实时奖励环境,我们可以认为其实时奖励的数值为0;强化学习中时间(序列)是一个很重要的因素,同时个体在某一时刻的行为会导致环境的响应并影响到个体的将来。
理解强化学习中的这些基本概念对于快速进入强化学习的学习、深刻理解强化学习相关理论和算法意义重大。本章只是简单介绍了这些概念,后续章节将会逐一详细地介绍这些概念以及相关的理论和算法,读者可以在学习具体的理论和算法过程中加深对这些概念的理解。
1.3 章节组织#
本书一共分为10章。第1章主要讲述强化学习的历史、基本概念以及编程环境等。在随后的第2~10章中,将先介绍理论,再通过编程示例来展开详细讨论。其中,第2~5章讲解强化学习的基本理论,并以第5章作为整个内容的核心。从第6章开始陆续引入深度学习技术、基于策略梯度的强化学习算法、基于模型的学习和规划以及对“探索和利用”的探讨。第10章讲解综合了各种算法的Alpha Zero算法的技术原理和实践。
1.4 编程环境与代码资源#
本书以Python作为编程语言,使用PyTorch和Gym等库。为了便于读者阅读,一些核心的代码将被列入每一章的实践部分,并配以文字解释。完整的代码可以参考GitHub中的内容,地址为https://github.com/qqiang00/reinforce/tree/master/reinforce/codes_for_book。