第13章 · 并行化#
计算机硬件的最新趋势使得现代计算机成为并行计算机;也就是说,当今计算机的能力取决于处理器的数量。1 为了使用这些强大的机器,我们必须将算法任务分解成多个部分,并将其分配给大量的处理器。在许多情况下,这需要对算法进行重要的修改。在本章中,我们将讨论关于并行化算法的几个基本概念,并在环路/团簇识别的情境下加以说明。
13.1 并行架构#
并行计算中的关键问题是计算机内存的分布。换句话说,即可用内存的数量及其访问速度。内存按层次结构组织:L1 缓存、L2 缓存、主存等等,它们都具有不同的访问速度。访问速度还取决于计算单元与内存块之间的物理距离。2
讨论如何考虑所有机器细节来微调计算机程序,显然超出了本书的范围。因此,在下文中,我们将重点讨论两种常见架构类型的并行计算机(图13.1):共享内存架构和分布式内存架构。在两种情况下,我们都假设并行计算机有 $N_{p}$ 个处理器。3
在当今大多数并行计算机中,每个本地内存块只能被物理上离它最近的本地处理器块中的少量处理器直接访问。要访问一个远程内存块,一个处理器必须与另一个能直接访问该块的处理器进行通信。从某种意义上说,共享内存架构是本地处理器块的一个模型。或者,它也可以被视为整个计算机系统的一个模型,其中通信成本可以忽略不计。在这个模型中,我们不必考虑处理器之间的通信过程。我们简单地假设所有处理器都在读取和写入同一块内存,并且每个处理器都能立即知道另一个处理器向内存写入的内容。另一方面,分布式内存架构是一种模型,其中每个处理器独占访问其所拥有的内存块,并且要让一个处理器获取写入另一个处理器内存的信息,该信息的所有者必须明确地将其内存内容发送给它。因为当今的高性能计算机兼具这两种架构的特点,所以可能同时使用两种不同的并行化方法,这一过程称为混合并行化。
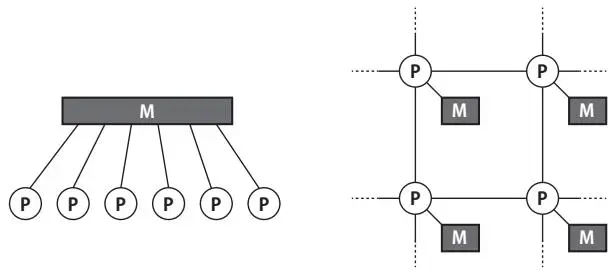
图13.1 共享内存模型(左)和分布式内存模型(右)。带有 $\ddot{P}$ 的圆圈代表处理器,带有 $\dot{\Omega}$ 和 $M$ 的矩形代表内存。
13.2 共享内存计算机上的单自旋更新#
让我们从一个简单的问题开始:在共享内存计算机上并行化伊辛链(第4.2节)的单自旋更新算法。至于内存大小,我们假设可用内存是无限大的,这并非不切实际,因为蒙特卡洛模拟通常受计算限制,而非内存限制。因此,我们可以假设整个晶格的自旋构型信息都适合放入共享内存。
最自然的任务分割方法是将自旋集合划分为 $N_{p}$ 个子集 $\Omega_{1} , \Omega_{2} , \ldots , \Omega_{N_{p}}$,并将每个子集分配给一个处理器(算法42)。设 M 为 $\Omega_{i}$ 的大小,即 $M \equiv N / N_{p}$,其中 N 是自旋总数。第 p 个处理器执行算法6,但使用的是 $\Omega_{p}$ 中自旋的某种固定顺序,而不是随机选取。新自旋状态相对于选定自旋 $s_{i}$ 的状态的概率满足细致平衡条件。
实际上,图13.1中的模型过于简化。在并行计算中,更实际的做法是假设总内存被组织成多个块,每个块分配给一个处理器。一个处理器只能直接访问其自身分配到的块。在这种观点下,共享内存模型对应于每个处理器都可以访问所有块。在实际并行化算法时,我们必须考虑通信成本,这通常会导致算法设计上的显著差异。
由于环算法和团簇算法(第4.4节和第4.5节)在其蒙特卡洛更新中涉及非局域性,因此并行化这些算法比并行化单自旋更新更具挑战性。然而,用于识别环或团簇的底层算法——并查集(Union-Find)算法——可以有效地并行化。并查集算法维护一组不相交的集合(即环或团簇),并支持两种操作:查找(Find)和合并(Union)。在并行环境中,查找和合并操作必须小心处理,以避免竞争条件。一种常见的方法是通过图着色技术来分解问题,使得不同颜色的节点可以独立地更新。
算法42 伊辛模型的单自旋更新:共享内存计算机上第p个处理器的任务。(在并行计算机上容易出错。)
输入: 块p中的自旋构型,$\{s_{i} ~ = ~ \pm 1 \} ~ ( i ~ \in ~ \Omega_{p} )$,以及相邻自旋的值。
for $k = 1 , 2 , \ldots , M ( \equiv N / N_{p} )$ do 设i为$\Omega_{p}$的第k个成员; 根据概率选择,将$s_{i}$更改为新状态; end for 返回块$p$中更新后的自旋构型。
只要这些操作互不干扰,算法42就能给出正确结果(在统计误差范围内)。然而,由于这种独立性条件通常不成立,朴素的并行化可能会产生错误的结果。当一个处理器(例如$P_{1}$)试图更新其域内的自旋$s_{i}$时,它需要关于$s_{i}$周围自旋的信息。但是,某个相邻自旋(例如$s_{j}$)可能属于另一个不同的处理器(例如$P_{2}$)。处理器$P_{1}$在算法42描述的更新周期开始时获取关于$s_{j}$的信息。问题在于,这个信息在所述周期在所有处理器上完成并互相通信之前不会被更新。因此,当$P_{1}$开始处理$s_{i}$时,$s_{j}$的值可能已经被$P_{2}$改变了。举一个简单的例子,假设我们有一个仅包含两个铁磁耦合伊辛自旋的小系统。假设我们将每个自旋分配给两个处理器中的一个,并使用算法6中的Metropolis更新来应用算法42,该算法在翻转会降低能量时总是翻转自旋。会发生什么?一旦这些自旋在某个时刻变成反平行,它们将永远保持反平行!4
为了避免这个问题,5我们必须仔细安排$\Omega_{p}$中自旋的检查顺序,并确保处理器得到适当的同步。对于一维伊辛模型,我们将刚才描述的较为通用的算法替换为算法43,如图13.2所示。这个新过程确保了相邻自旋永远不会同时被更新。在图中,被同一处理器覆盖的实心圆的更新顺序可能会影响效率,但不应导致系统误差。在每一步结束时,我们同步所有处理器以避免混淆空心圆和实心圆;也就是说,我们让处理器等待,直到所有处理器都到达算法中的同一点。6 扩展到更高维度是显而易见的:我们将每个处理器的域分割成几个子域(域分解),使得两个相邻的自旋不会同时被检查。
算法43 一维伊辛模型的单自旋更新:共享内存计算机上第p个处理器的任务。(即使当M > 1时也无错误。)
输入: 块$p$中的自旋构型,$s_{i} = \pm 1 \ : ( M ( p - 1 ) + 1 \leq i \leq M p )$,以及相邻自旋的值。
for k = 1, 2, 3, . . . , M/2 do i ← M( p − 1) + k ; 更新$s_i$;例如,通过Metropolis算法 end for 同步;等待其他处理器完成其任务 for k = M/2 + 1, M/2 + 2, . . . , M do i ← M( p − 1) + k ; 更新$s_i$; end for 同步; 返回块p中更新后的自旋构型。
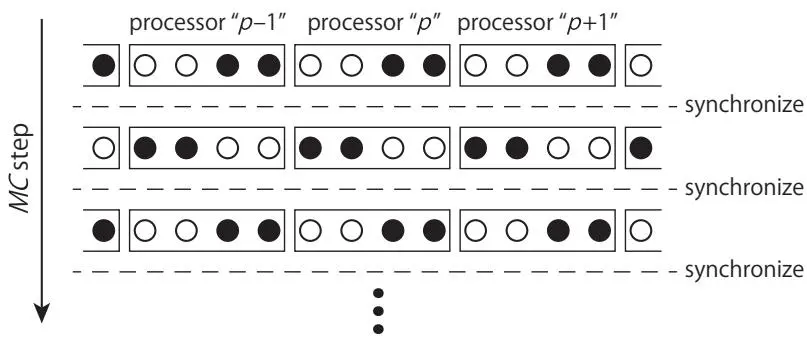
图13.2 并行化的单自旋更新。在此示例中,每个处理器负责四个自旋,即M = 4。在每一步中,仅更新由空心圆表示的自旋,从而使每个处理器可以独立执行其任务。在每一步结束时,所有处理器都被同步,对于分布式内存机器,边界自旋的值被传递给相邻的处理器。
算法44 一维伊辛模型的单自旋更新:分布式内存计算机上第$p$个处理器的任务。
输入:块$p$中的自旋构型,$s_{i} = \pm 1 \ : \left( M ( p - 1 ) + 1 \leq i \leq M p \right)$
将$s_{M p}$发送给第$( p + 1 )$个处理器,并从第$( p \mathrm{~ - ~} 1 )$个处理器接收$s_{M ( p {-} 1 )}$;
for $k = 1 , 2 , 3 , \dots , M / 2$ do
$i = M ( p - 1 ) + k$
更新$s_{i}$;
end for
同步;
将$s_{M ( p {-} 1 ) + 1}$发送给第$( p - 1 )$个处理器,并从第$( p + 1 )$个处理器接收$s_{M p + 1}$;
for $k = M / 2 + 1 , M / 2 + 2 , \ldots , M$ do
$i = M ( p - 1 ) + k$
更新$s_{i}$;
end for
同步;
返回块$p$中更新后的自旋构型。
13.3 分布式内存计算机上的单自旋更新#
在分布式内存计算模型中,一个处理器可能并不具备执行其任务所需的全部信息。因此,它必须向其他处理器(通常是其相邻处理器)请求缺失的信息。在伊辛模型示例中,当处理器试图更新其域边界上的自旋时,它缺乏必要的信息。因此,在继续执行任务之前,它必须向其邻居发出请求。所有其他处理器也是如此。从算法44可以看出,这些请求产生了频繁的信息交换。
因此,现在我们必须特别关注通信开销。粗略地说,如果处理器间通信所需的时间短于每个处理器执行其运算所需的时间,我们就说该过程是良好平衡的(well balanced),因为只要这个条件成立,我们就可以从增加处理器数量中受益。7
让我们考虑当问题规模(在当前情况下即自旋数N)增加,而处理器数量保持不变时的计算性能。此时分配给每个处理器的子系统的规模与问题规模成正比。在伊辛链示例中,通信时间始终为$\mathcal{O}(1)$,因为每个处理器只发送和接收两个自旋。另一方面,每个处理器执行的运算次数与$M = N / N_{p}$成正比。因此,处理器间通信时间与每个处理器内运算时间的比例为$R = \mathcal{O} ( M^{- 1} )$。很容易将此估计推广到更高维度。此时,M是每个处理器域的尺度,例如,它是一个d维超立方体。那么,每个处理器必须发送和接收边界上的自旋值,其面积量级为$M^{d - 1}$。因此通信时间与$M^{d - 1}$成正比。运算时间再次与一个处理器所覆盖的自旋数成正比,即$M^{d}$。因此,通信与运算的比例为
$$ R = \mathcal{O} ( M^{- 1} ) $$无论维数如何。由此我们可以得出结论,只要分解足够粗粒化,处理器间的通信时间就可以忽略不计。8 反之,如果每个域的大小过小,则相对通信开销会很大,我们就无法从增加处理器数量中获益。简言之,大型计算机只有处理大规模问题时才有效率。这一结论也适用于其他基于域分解的并行算法。
13.4 环/团簇更新与并查集算法#
现在我们考虑环/团簇算法(loop/cluster algorithm)。回顾一下,它包含两个步骤:图的赋值(graph assignment)和团簇翻转(cluster flips)。我们的目标是将时空分割成$N_{p}$个区域,并为每个区域分配一个处理器。因此,每个处理器拥有关于其所分配区域的完整信息,例如顶点的时空位置、由扭结界定的给定片段的局部状态,以及区域边界上的状态。
我们首先考虑图赋值步骤的并行化。如果时空分解仅是时间上的,并且没有边界在空间上分隔两个区域,则不存在处理器间通信,因为图元的两个端点(在时间上是局域的)总是属于同一个区域。另一方面,当分解并非纯粹是时间上的时,我们可能不得不将一个图元放置在两个区域(例如A和B)的边界上。在这种情况下,我们必须将关于区域B边界附近局部状态的信息传递给负责区域A的处理器。然后,A处理器计算新顶点的时空位置,并将此信息发送回B处理器。因此,处理器间通信量与A和B之间的顶点数量成正比,而顶点数量又与分隔它们的空间边界的长度成正比。
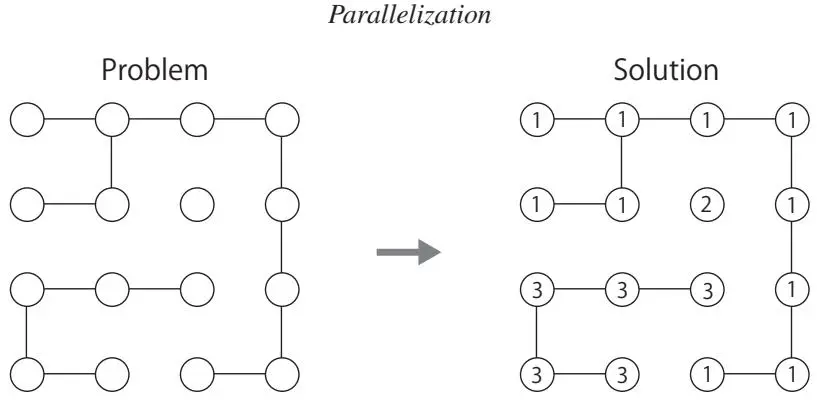
图13.3 团簇识别问题。
现在我们考虑环/团簇自旋翻转的并行化,由于团簇识别的非局域性,这要复杂得多。因为我们将使用图操作算法来进行这种识别,所以我们采用图论的术语。由于困难的本质不依赖于它是经典模型还是量子模型,为了描述清晰起见,我们考虑经典模型。在这种情况下,一个顶点是一个点,一条边是连接两点的线。
为了更新自旋,我们需要识别团簇。更具体地说,我们的任务是获得一个数组,例如$p$,它定义了从顶点编号到团簇编号的映射。例如,$p(3) = 5$ 意味着顶点3属于团簇5。团簇编号满足:$p(\nu_a) = p(\nu_b)$ 当且仅当顶点$\nu_a$和$\nu_b$通过一系列边相连(图13.3)。在伊辛模型的团簇算法中,一旦我们获得这样的数组,我们只需生成代表$n_c$个团簇自旋值的一位随机数$b(1), b(2), \dots, b(n_c)$,并将$b(p(\nu))$赋值给每个顶点$\nu$作为其新的自旋值,从而更新自旋变量。
我们首先讨论这种并查集算法(union-find algorithm)的串行版本(Hoshen and Kopelman, 1976)。为了根据给定的边列表构建数组$p(\nu)$,我们生长一片森林9,使得每棵树对应一个待识别的团簇。树的每个组件(根节点、分支节点或叶节点)对应一个顶点。在我们下面讨论的嫁接操作期间,$p(\nu)$始终是一个指向“父”顶点的指针,即沿着通往根节点的路径上的下一个顶点。我们假设顶点是顺序编号的,并且其数量是固定的。
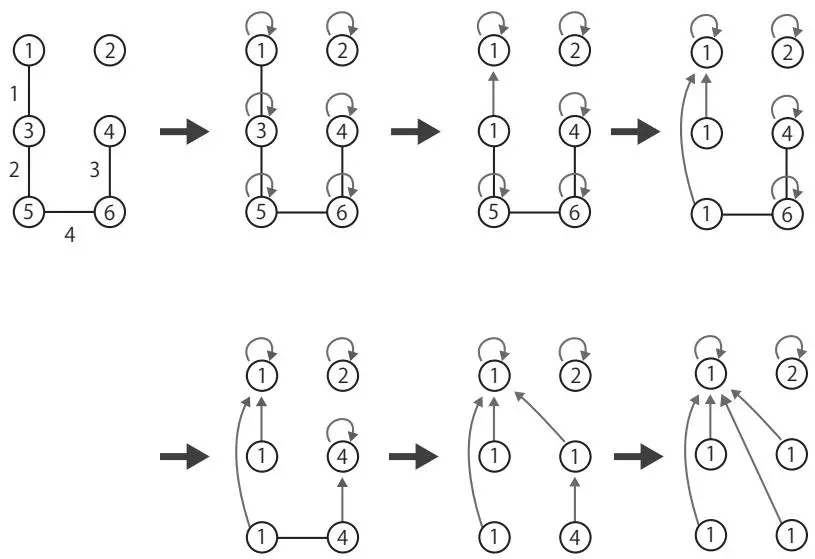
图13.4 用于并查集问题的“嫁接”算法(算法45)。圆圈中的数字是算法中的$p(\nu)$。边按被检查的顺序编号。
在初始状态中,每个顶点都是一棵树的根(图13.4的第二幅图)。换句话说,我们有N棵高度为零的树。我们通过逐个输入关于边的信息来使这些树生长。
假设一条边$e$是未检查边列表中的第一条,它连接两个顶点$\nu_{a}$和$\nu_{b}$,即$e = ( \nu_{a} , \nu_{b} )$。那么我们从$\nu_{a}$开始,沿着分支追溯,直到到达树的根,记为$r_{a}$。我们对$\nu_{b}$重复相同的过程,到达根$r_{b}$。如果$r_{a}$和$r_{b}$不同,则$\nu_{a}$和$\nu_{b}$位于不同的树上。在这种情况下,必须将一棵树嫁接到另一棵树上。如果$r_{a}$的顶点编号小于$r_{b}$的编号,我们将树b嫁接到树a上,作为一条直接连接到树a根的分支。否则,我们以相同方式将树a嫁接到树b上。从这个过程可以明显看出,在检查完所有边之后,树和团簇之间必然存在一一对应关系。换句话说,任何由一系列边连接的两个顶点都属于同一棵树。一旦所有树构建完成,我们从每个顶点开始,沿着分支追溯到根,然后将该根顶点的编号赋给起始顶点,作为它的团簇编号。这个过程总结在算法45中。
执行算法45过程所需操作次数的理论上限是$\mathcal{O} ( N_{E}^{2} )$,其中$N_{E}$是边的数量。最坏情况是一种类型的边列表:(100, 99), (99, 98), (98, 97), . . . , (2, 1)。这里顺序很重要:如果按此顺序检查边,在嫁接阶段结束时数组$p ( \nu )$的内容是$p ( 1 ) = 1 , p ( 2 ) = 1 , p ( 3 ) = 2 , p ( 4 ) = 3 , \ldots , p ( 100 ) = 99 $。然后,在高度缩减阶段,我们需要沿着这个序列追溯回其根。根据检查顶点的顺序,总操作次数会变化。最坏情况发生在按降序检查顶点时,即100, 99, . . . , 2, 1。当我们从顶点100开始,需要99次替换操作才能找到该顶点的根是1。然后,$p(100)$被设为1。接下来我们从顶点99开始,经过98次替换结束任务。这些操作的计算复杂度为$\mathcal{O} ( N_{V} N_{E} )$,其中$N_{V}$是顶点数量。因为在凝聚态物理的大多数应用中$O ( N_{V} ) = O ( N_{E} )$,所以我们得到计算复杂度为$\mathcal{O} ( N_{E}^{2} )$。这个代价可能会完全抵消环回/团簇程序的优势。
算法45 Hoshen-Kopelman 并查集算法(串行)。 输入:边列表$\left\{( \nu_{a} , \nu_{b} ) \right\}$ 对于每个顶点v 执行 $p ( \nu ) \leftarrow \nu ; \quad \triangleright$ 初始时,每个顶点指向自身。 结束循环 对于每条边$e = ( \nu_{a} , \nu_{b} )$ 执行 $r_{a} \gets \mathrm{Root} ( \nu_{a} )$; $r_{b} \gets \mathrm{Root} ( \nu_{b} )$; 如果 $r_{a} < r_{b}$ 则 $p ( r_{b} ) \leftarrow r_{a}$; 否则 $p ( r_{a} ) \gets r_{b}$; 结束条件判断 结束循环 对于每个顶点 v 执行 r ← Root(v); $p ( \nu ) \leftarrow r$; 结束循环 返回 $p$。 函数 Root(v) $u \leftarrow \nu$; 当 $p ( u ) \neq u$ 时执行 $u \gets p ( u )$; 结束循环 返回 u。 函数结束
算法46 改进的并查集算法(串行)。 输入:边列表$\left\{( \nu_{a} , \nu_{b} ) \right\}$ 对于每个顶点v 执行 $p ( \nu ) \leftarrow \nu$; $w ( \nu ) \leftarrow 1$; 结束循环 对于每条边$e = ( \nu_{a} , \nu_{b} )$ 执行 $r_{a} \gets \mathrm{Root} ( \nu_{a} )$ $r_{b} \gets \mathrm{Root} ( \nu_{b} )$ 如果 $w ( r_{a} ) \ge w ( r_{b} )$ 则 $r_{0} \leftarrow r_{a}$; $r_{1} \leftarrow r_{b}$; 否则 $r_{0} \leftarrow r_{b}$; $r_{1} \leftarrow r_{a}$; 结束条件判断 $w ( r_{0} ) \gets w ( r_{0} ) + w ( r_{1} )$; 更新权重 $p ( r_{1} ) \leftarrow r_{0} ; \quad \triangleright$ 将小树嫁接到大树上 Compress $( \nu_{a} , r_{0} )$; 压缩一棵树 Compress $( \nu_{b} , r_{0} )$; 压缩另一棵树 结束循环 对于每个顶点 v 执行 $r \leftarrow \mathrm{Root} ( \nu )$; Compress $( \nu , r )$ 结束循环 返回 $p$。 函数 Root(v) $u \leftarrow \nu$; 当 $p ( u ) \neq u$ 时执行 $u \gets p ( u )$; 结束循环 返回 u。 函数结束 函数 Compress(v,r) $u \leftarrow \nu$ 当 $p ( u ) \neq u$ 时执行 $s \gets p ( u )$; $p ( u ) \leftarrow r$; $u \leftarrow s$; 结束循环 返回 函数结束
为了降低计算成本,我们做出了两项改进(Aho 等人,1983)。其一是为树引入一个权重 w(v),定义为树中包含的顶点数量,并且在嫁接时,总是将权重较小的树嫁接到权重较大的树上。其二是频繁地降低树的高度。改进后的算法即算法 46。其复杂度为 $\mathcal{O} ( ( N_{E} + N ) \lg N )$(Aho 等人,1983),其中 lg X 是反阿克曼函数(inverse Ackerman function),其增长非常缓慢。粗略地说,它是指需要取多少次 $\log_{2}$ X 才能得到 1,例如,$\lg 1 = 0 , \lg 2 = 1 , \lg 2^{2} = 2 , \lg 2^{2^{2}} = 3 , \lg 2^{2^{2^{2}}} = 4 ,$ 等等。在实际应用中,我们可以将其视为一个常数。
13.5 共享内存计算机的并查集算法#
现在我们讨论如何使用 Todo 等人(2012)提出的方案来实现并查集算法的共享内存并行化。它将边集合分割成更小的子集,并将每个子集分配给一个处理器。首先,让我们设想每个处理器只是简单地使用算法 45 或算法 46 执行其任务。显然,我们无法控制边被检查的顺序。乍一看,这似乎无关紧要,因为如果所有边都被考虑到了,最终结果(聚类)不应依赖于顺序。然而,确保所有边都被正确处理并非易事。
为了说明这一点,让我们考虑一个由六个顶点组成的图。假设顶点 4、5 和 6 的根分别是 1、2 和 3(图 13.5),并且处理器 A 和 B 正准备分别处理边 (4, 6) 和 (5, 6)。我们可能预期的事件序列如下:
(A1) 处理器 A 找到 6 的根为 3。 (A2) 处理器 A 找到 4 的根为 1。 (A3) 处理器 A 将 p(3) 改为 1。 (B1) 处理器 B 找到 6 的根为 1。 (B2) 处理器 B 找到 5 的根为 2。 (B3) 处理器 B 将 p(2) 改为 1。
结果是一个单一的团簇,如图 13.5 左侧所示。然而,事件的顺序未必如此。以下情况同样可能发生:
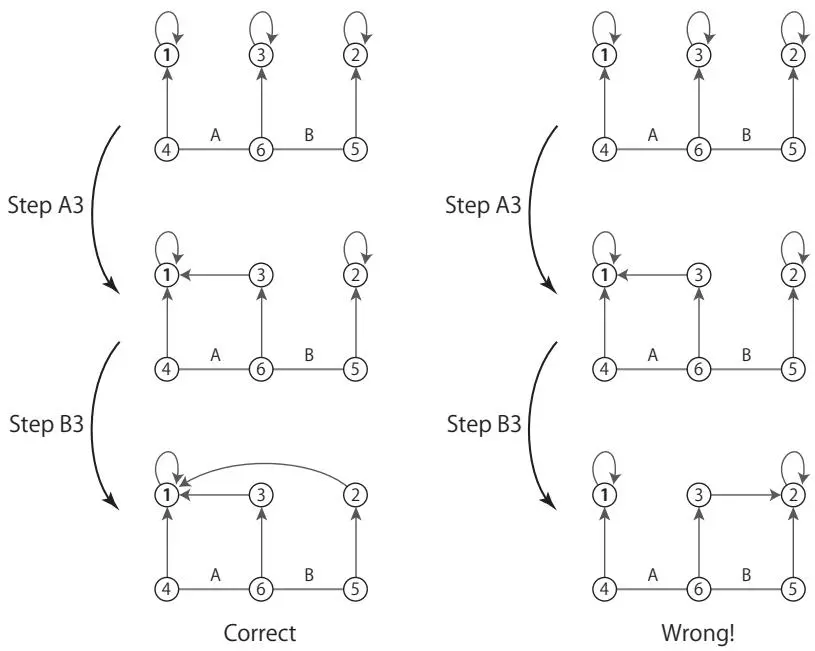
图 13.5 并查集算法中的非线程安全操作。
(A1) 处理器 A 找到 6 的根为 3。 (B1) 处理器 B 找到 6 的根为 3。 (A2) 处理器 A 找到 4 的根为 1。 (B2) 处理器 B 找到 5 的根为 2。 (A3) 处理器 A 将 p(3) 改为 1。 (B3) 处理器 B 将 p(3) 改为 2。
显然,关于边 (4, 6) 的信息丢失了,如图 13.5 右侧所示。发生这种情况是因为在后一个过程的 (B3) 处,处理器 B 在嫁接树时使用了关于顶点 6 所在树的过时信息。如果没有其他边后来重新连接这两个团簇,结果将是错误的。
为了防止这种信息丢失,每当一个处理器试图将根 $r_{a}$ 嫁接到另一个根 $r_{b}$ 时,它必须首先锁定它们,以便在第一个处理器完成嫁接之前,没有其他处理器可以更改 $p ( r_{a} )$ 或 $p ( r_{b} )$。算法 47 展示了修改算法的一种方式,其中被锁定的顶点 v 由 $p ( \nu )$ 的负值编码。函数“Lock”的实现必须确保以 if p(v) = v then 开头的 if 子句中的操作作为一个单一步骤执行。如果不这样做,来自其他处理器的中断可能导致第一次操作(比较,$p ( \nu ) = \nu$)和第二次操作(替换,$p ( \nu ) - \nu$)中的 $p ( \nu )$ 互不相同,从而导致错误。虽然避免这种中断的策略可能取决于机器,但我们可以使用一条比较并交换原子(不可中断)指令来实现,该指令在单条指令中完成比较和交换(Todo 等人,2012)。
算法47 共享内存计算机上并查集算法中处理器的任务。 省略部分与算法46相同。 输入:边列表子集 $\overline{{E_{p} \equiv \{( \nu_{a} , \nu_{b} ) \}}}$ · · · 初始化部分省略 · · · 对于每条边 $e \in E_{p}$ 执行 $r_{a} \gets \mathrm{Root} ( \nu_{a} )$ ; $r_{b} \gets \mathrm{Root} ( \nu_{b} )$ 循环 $q_{a} \gets \mathrm{Lock} ( r_{a} )$ ; $q_{b} \gets \mathrm{Lock} ( r_{b} )$ 如果 $q_{a} = \cdots \mathrm{success}^{39}$ 且 $q_{b} = \cdots$ “success” 则 跳出; 否则 如果 $q_{a} = *$ “success” 则 Unlock $( r_{a} )$ ; 结束如果 如果 $q_{b} = \cdots$ “success” 则 Unlock $( r_{b} )$ 结束如果 $r_{a} \gets \mathrm{Root} ( r_{a} )$ ; $r_{b} \gets$ Root $( r_{b} )$ 结束如果 结束循环 · · · 嫁接部分省略 · · Unlock $\left( r_{a} \right)$ ; Unlock $( r_{b} )$ ; 结束循环 · · · 树压缩部分省略 · · 返回 p 函数 Lock(v) 以下if子句必须作为单一操作执行。 如果 $p ( \nu ) = \nu$ 则 $p ( \nu ) - \nu$ ; 返回 “success” ; // 锁定成功 结束如果 返回 “failure” ; // 锁定失败 函数 Unlock(v) $p ( \nu ) - p ( \nu )$ ; 返回
13.6 分布式内存计算机的并查集算法#
现在我们讨论用于分布式内存计算机的并查集算法的并行化。尽管大多数图操作算法假设没有特定的空间结构,但空间维度的有限性对于下面讨论的算法至关重要。从这个意义上说,该算法并非适用于所有并查集应用。我们稍微推广了Todo等人(2012)的思想,并且也描述了团簇的识别,而不是回路的识别。
在该算法中,时空被分割成多个域,每个处理器分配到一个时空域。处理器的任务是为其域内的所有v(记为$\Omega_{0}$)获取团簇编号$p ( \nu )$。它首先使用仅包含$\Omega_{0}$内边的信息,通过前面讨论的算法之一开始团簇识别。完成后,域$\Omega_{0}$的团簇识别在$\Omega_{0}$内部是完整的。(当如果没有区域B以外的边,分配给A中所有顶点的团簇编号都正确时,我们说“域A的团簇识别在$B^{\prime \prime}$内部是完整的”。)然后,处理器考虑邻近区域(例如$\Omega_{1}$)内的边,以及$\Omega_{0}$和$\Omega_{1}$边界上的边,并更新团簇编号表。结果是$\Omega_{0}$在$\Omega_{0} \cup \Omega_{1}$内完整的团簇编号表。通过这种方式,处理器不断将用于边的域加倍,直到$\Omega_{0}$的团簇编号表在整个空间$\Omega_{\mathrm{whole}}$内都是完整的。
每个处理器都掌握其初始域内顶点、当前域边界上的顶点,以及包含一个或多个边界顶点的树的根节点的信息。更具体地说,与处理器相关的本地内存存储了$\Omega_{0} \cup \partial \Omega \cup \mathcal{R} ( \partial \Omega )$中顶点的$p ( \nu )$和$w ( \nu )$,其中$\Omega_{0}$是处理器原始域,$\Omega$和$\partial \Omega$分别是当前域及其边界,而$\mathcal{R} ( \partial \Omega )$是与$\partial \Omega$有非零重合部分的树的根节点集合。连接当前域与其他域的边的信息,以及域内边的信息,也存储在内存中。然而,后者仅在第一次迭代时需要。每个处理器在算法45、46或47中使用这些信息。
最初,每个处理器利用 $\Omega_{0}$ 内部边和顶点的信息,通过应用算法46来识别团簇。12 然而,这种团簇识别显然是不完整的,因为域内不相连的两个顶点可能通过域外的路径连接。为了考虑这些外部路径,处理器(以下称为 $P_{0}$ )必须从其他处理器获取信息。为此,它选择一个最近邻处理器,比如 $P_{1}$ ,并索取信息。但它并不需要 $P_{1}$ 拥有的所有信息。$P_{0}$ 的任务是仅找到 $\Omega_{0}$ 内顶点的团簇编号,而任何外部路径都必须经过一个边界顶点。因此,对于 $P_{0}$ 来说,只需获取位于 $P_{0}$ 域和 $P_{1}$ 域之间边界上的顶点的指针 $p ( \nu )$ 和权重 $w ( \nu )$ ,以及这些顶点所在根的相应信息即可。一旦 $P_{0}$ 获得这些信息,它就检查连接两个域的边,并按照算法46的规定嫁接树。完成后,在 $\Omega_{0} \cup \Omega_{1}$ 范围内(其中 $\Omega_{1}$ 是 $P_{1}$ 的原始域),$\Omega_{0}$ 的团簇识别就完成了。我们以层次化的方式重复此过程,直到每个处理器覆盖的域变成整个系统。
组织这种层次结构有几种方法。这里,我们考虑一种由“蜗牛”模式(图13.6)表示的方法。一个处理器 $P_{0}$ 首先完成 $\Omega_{0}$ (图中最深色的方块)内的团簇识别。同样,所有其他处理器也完成各自的任务。然后,$P_{0}$ 向其在x方向的最近邻 $P_{1}$ 索取边界顶点的团簇编号。利用这些信息,$P_{0}$ 完成现在面积扩大一倍(最深色方块和次深色方块的并集)的域内的团簇识别。再次,所有其他处理器也进行同样的操作。接下来,$P_{0}$ 向其在y方向的最近邻 $P_{2}$ 索取信息。此时,该邻居拥有扩大后域(最深色方块上方的水平矩形)的边界信息。结果,$P_{0}$ 在两个方向都扩大了初始方块一倍的方形区域内完成了团簇识别。在第三步中,$P_{0}$ 从位于相对于原始方块位置 (-2, 0)(以原始方块大小为单位的)邻居 $P_{3}$ 获取信息。此后,它与其他位于 $( 0 , - 2 )$ 、 $( 4 , 0 )$ 、 $( 0 , 4 )$ 、 $( - 8 , 0 )$ 、 $( 0 , - 8 )$ 等位置的处理器重复此过程。总的来说,在 d 维空间中,这个序列将是 $e_{1} , e_{2} , \ldots , e_{d} , - 2 e_{1} , - 2 e_{2} , \ldots , - 2 e_{d} , 4 e_{1} , 4 e_{2} , \ldots , 4 e_{d} , . .$ ,其中 $\boldsymbol{e}_{\mu}$ 是 $\mu$ 方向上的单位晶格矢量。
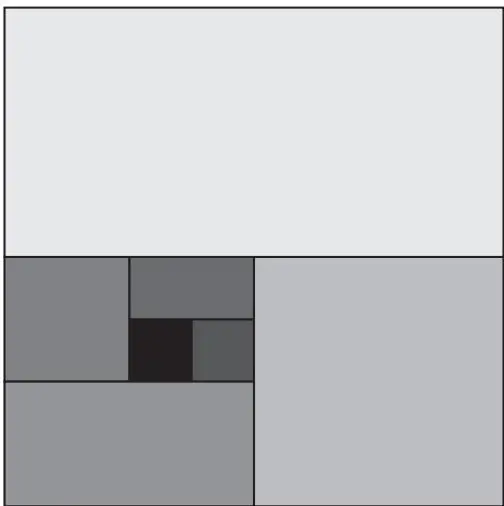
图13.6 一个处理器覆盖的域。最深色且最小的方块表示它最初覆盖的域。随着操作进行一步,域扩大一倍,在此域内完成团簇识别。
在这种“蜗牛”安排中,如果待识别的团簇很小,处理器会在其域覆盖整个系统之前就完成任务,因为一旦处理器覆盖了所有与 $\Omega_{0}$ 重叠的团簇,$\Omega_{0}$ 中顶点的团簇编号就会被正确分配,即使处理器继续搜索,也不会发生进一步变化。当典型团簇尺寸远小于整个系统时(这在无序状态下很常见),这一优势可能非常显著。具体来说,如果最大团簇尺寸为 $\xi$ ,则所有处理器在域的大小达到 4ξ 时就会停止。
13.7 回到未来#
在第1章中,我们谈到,在通常被认为是首次使用“蒙特卡洛方法”这一术语的出版物中,Metropolis 和 Ulam (1949) 阐述了这种新方法的哲学,并指出它能够做到我们今天所说的“打破维数灾难”——这常常限制了复杂问题偏微分方程的有效数值求解。在这篇里程碑式的出版物中,通常被忽略的一点是,他们提到蒙特卡洛方法是并行计算的理想选择,这一观察比科学家们开始思考并行计算机早了数十年,而且仅在那个如今已成为标准的冯·诺依曼架构被提出两年之后。这个评论很可能指的是最简单但无疑也是最有效的并行化方式,即自然并行化:我们给每个处理器各自的输入(至少是各自的随机数种子)和相同的可执行程序。每个处理器独立运行该程序,当所有处理器完成后,我们收集各自的输出。该可执行程序可以是本书中讨论的任何蒙特卡洛算法:单自旋更新、团簇更新、虫洞更新、行列式方法、变分蒙特卡洛等等。我们在本章省略了对自然并行化的讨论,主要是因为它太自然了。然而,我们在此强调,自然并行化是蒙特卡洛方法的一大优势。13
Ulam 和 Metropolis 所谈论的蒙特卡洛方法,是 Ulam 和冯·诺依曼在几年前提出的,用于模拟辐射通过裂变材料时的扩散-碰撞输运。正如我们在第1章中提到的,Ulam 和冯·诺依曼使用马尔可夫链来预测辐射的分布,这需要从一个事先未知的平稳分布中进行采样。而在1953年,Metropolis 等人提出了 Metropolis 算法,这是他们如今著名的另一种形式的蒙特卡洛方法,它从一个事先已知的平稳分布中进行采样。Marshall Rosenbluth (2003) 在回忆 Metropolis 算法的发展时提到,他们当时正在研究固体的熔化,最自然的模拟方式是跟踪相互作用粒子在牛顿定律作用下的动力学。然而,他们可用的计算机——Metropolis 的 MANIAC——的内存和速度都太有限,无法在大量的微小时间步长内跟踪足够数量的粒子,因此他们必须另寻他法。由于他们只对平衡性质感兴趣,他们决定利用统计力学和系综平均,而不是跟踪详细的运动学。如果 Metropolis 的计算机(最早采用冯·诺依曼架构制造的计算机之一)更先进一些,他们可能就发明了分子动力学,而不是 Metropolis 算法!
随着时间的推移,蒙特卡洛算法的基本特征变化不大,而我们用来运行它们的计算机硬件却发生了巨大变化。事实上,在未来,蒙特卡洛方法仍将打破维数灾难,仍将具有自然并行化的能力,并且仍然只需要相对适中的核心内存。我们也知道,它通常通过采取相对局部的步骤来采样相空间,这在许多情况下促进了处理器的异步化。它需要传递的消息很少,而且这些传递通常是局部的。
如果蒙特卡洛模拟的主要障碍是统计噪声,并且这个噪声问题不是指数级困难的,那么自然并行化就能消除它,并且是应该采用的方法。然而,在某些情况下,例如,如果计算自相关时间太长而无法等待系统松弛到其平衡分布,或者系统太大而无法在单个处理器的内存中存储整个构型,那么我们就需要超越自然并行化的方法。14 在本章中,我们给出了一个此类非平凡并行化的例子,它针对一类流行的经典和量子蒙特卡洛算法中的一个非常重要的任务。特别是,本章讨论的环回/团簇算法的最终并行化方法是在自然并行化基础上的一步提升。其他类型算法的并行化是目前活跃的研究课题(例如,关于虫洞算法并行化,参见 Masaki-Kato et al. (2014))。
本章新增术语:
正如我们文中所述,大型计算机只有处理大型问题时才高效。下一代大型计算机的愿景是拥有数量级更多的处理器,但每个处理器的速度并不比今天快多少。为这些计算机编写并行代码是计算物理学面临的挑战,但蒙特卡洛方法固有的优势,以及非平凡并行化算法的发展,使得蒙特卡洛方法在百亿亿次计算时代来临之际得以广泛应用。我们将如何使用蒙特卡洛方法会不断演进。我们将如何实现其并行化也会随之改变。但始终重要的是,识别出能够通过改进算法或更强大的计算平台成功解决的合适问题。