第12章 · 解析延拓#
动力学信息的存在是有限温度量子蒙特卡洛模拟区别于经典模拟的一个特征。现在我们将讨论提取这些信息的数值方法,这些方法借用了概率论中一个称为贝叶斯统计推断(Bayesian statistical inference)领域的技术和概念。这些技术和概念的使用为解析延拓(analytic continuation)这个极为困难的问题提供了解决方案,即将量子蒙特卡洛模拟估计出的虚时格林函数在数值上延拓到实时轴。Baym和Mermin(1961)证明了这些函数之间存在唯一的映射关系。然而,利用模拟中不完整且带有噪声的数据在数值上执行这一映射,会使得问题变成没有唯一解的问题,从而变成根据某个合理准则寻找"最佳"解的问题。我们并非在虚时和实时格林函数之间执行解析延拓来获得实时动力学,而是估计这些格林函数共有的、与实验相关的谱密度函数(spectral density function)。我们将介绍三种"最佳"解,并强调使模拟数据与数值方法的假设相一致是找到这些最佳解的关键步骤。
12.1 预备说明#
本章的标题"解析延拓"有些不同寻常,因为它描述的是我们希望完成的任务,而非我们用来完成任务的方法。如果使用方法名称来命名,标题可能会是"使用熵先验的贝叶斯统计推断"。更短的标题可以是"最大熵方法"。我们希望在本章结束时读者会同意,使用短标题可能过于轻率,而较长的标题则包含了有意义的内容。
我们想要完成的任务是求解积分方程
$$ G ( \tau ) = \int_{- \infty}^{\infty} d \omega K ( \tau , \omega ) A \left( \omega \right) , \quad K ( \tau , \omega ) = \frac{e^{- \tau \omega}} {1 \pm e^{- \beta \omega}}\tag{12.1} $$利用 $G ( \tau )$ 的量子蒙特卡洛估计来求解 $A ( \omega )$。我们将在下一节(第12.2节)回顾该方程的来源。目前,只需说明 $G ( \tau )$ 是某种动力学(虚时)多体关联函数,而该方程是多体理论中一个标准结果,将此关联函数与称为谱密度的 $A ( \omega )$ 联系起来。我们还在下一节讨论到,求解该方程相当于对动力学关联进行从 $\tau \to i t$ 的解析延拓。
求解这个线性积分方程看似简单,因为对 $\tau$ 和 $\omega$ 进行离散化将其简化为一个线性方程组
$$ G_{i} = \sum_{j} K_{i j} A_{j} . $$由于已知量的数目不一定等于未知量的数目,因此必须找到 $A_{i}$ 的最小二乘解。这样的计算很容易实现。问题在于,这种解析延拓的求解方法几乎总是无法产生可接受的解。
数十年来,类似的任务一直被认为是主要的计算挑战。核 $K ( \tau , \omega )$ 的指数特性使得求解解析延拓问题类似于参数化一个双核放射性衰变问题
$$ n ( t ) = a_{1} e^{- \lambda_{1} t} + a_{2} e^{- \lambda_{2} t} , $$其中 $n ( t )$ 是衰变数作为时间 t 的函数。正如 Acton (1970) 所热烈讨论的那样,这是一个不适定问题,因为即使是极其精确、间隔很小的测量中微小的变化也会导致拟合值 $a_{1} , a_{2} , \lambda_{1}$ 和 $\lambda_{2}$ 发生较大变化。另一方面,如果我们知道 $\lambda_{1}$ 和 $\lambda_{2}$(原子核的衰变率),就可以轻松获得 $a_{1}$ 和 $a_{2}$(原子核的相对比例)的良好估计。
为放射性衰变及类似问题获得合理解的一种常见方法是对最小二乘解进行正则化。在数学和统计学中,特别是在机器学习和反问题中,正则化指的是向解中添加额外信息,以帮助解决不适定问题或避免最小二乘问题过拟合。在当前情况下,我们同时面临这两类问题,我们将"正则化"理解为在数据拟合中添加一个或多个约束。如果添加一个约束,我们最大化
$$ \chi^{2} ( A ) = \lambda R ( A ) - {\frac{1} {2}} \sum_{i} \bigg ( G_{i} - \sum_{j} K_{i j} A_{j} \bigg )^{2} , $$其中 λ 是拉格朗日乘子,$R ( A )$ 是未知量的某个函数。
我们通常尝试使用与预期解已知性质一致的函数 R。这样做会将部分先验知识引入拟合中。例如,我们可能知道 $A ( \omega )$ 是光滑的,因此我们可能希望约束解,使其对 $\omega$ 的一阶导数是连续的。正如我们在下一节(第 12.2 节)中讨论的,在解析延拓(analytic continuation)问题中,我们至少知道 $A ( \omega )$ 是非负的,并且其对 $\omega$ 的积分是有限的(即,我们知道该积分满足一个物理求和规则)。对于一个物理解,我们需要考虑这两条先验信息。λ 的大小控制着这条先验信息施加在解上的强度。固定 λ 的数值使其不会不理想地偏置解本身往往就是一个问题。
我们选择求解 (12.1),并使用我们从贝叶斯统计推断(Bayesian statistical inference)的角度已知的关于 $A ( \omega )$ 的先验信息。我们将在第 12.3 节讨论这种统计方法。正如我们将看到的,要使用这种方法,我们需要将我们的问题重新表述为概率论的语言。在当前情况下,这种重新表述有一种可能的求解方法,即最大化一个非归一化的概率函数,该函数形式如下:
$$ \exp \left( \lambda R ( A ) - \frac{1} {2} \sum_{i} \left( G_{i} - \sum_{j} K_{i j} A_{j} \right)^{2} \right) , $$这等价于最大化指数中的自变量。因此,在这一分析层次上,贝叶斯方法等价于正则化最小二乘法的解。然而,寻找概率函数的最大值(众数),即寻找正则化最小二乘解,往往是不够的。最终,我们提出了一种方法,用于估计相对于该概率的均值解。
贝叶斯推断方法中的一个组成部分是选择所谓的先验概率(prior probability),它替代了正则化器。它代表了我们在数据之前对解的信念。我们使用熵先验(entropic prior):谱密度的非负性和有界性——我们最少的先验信息——使我们能够将其视为概率密度,因此它具有相关的信息论熵(第2.7节)。此外,这个准正则化器(quasiregularizer)施加在解上的特征是有据可查的。例如,在没有数据的情况下,改变任意一个 $A_{i}$ 并不需要特定的一个或多个剩余的 $A_{i}$ 发生变化,除了维持求和规则所需的变化(第12.3节)。实际上,只有当数据或其他先验知识强制执行时,这种先验概率才会在解中引入结构。我们甚至可以超越标准正则化,发展出一种方法来确定拉格朗日乘子(Lagrange multiplier)(第12.4节)。基于贝叶斯的分析还揭示,积分核只向数据“揭示”少数几个有效(隐式)参数。这些参数不是 $A_{i}$,而是作为这些有效参数的函数的 $A_{i}$(第12.5节)。
我们首先讨论动力学关联函数的一般性质,以及将它们与谱密度和谱密度的求和规则联系起来的积分核。然后讨论贝叶斯统计推断的基本原理。我们面临一个非线性优化问题,但由于只需确定少数几个隐变量,我们可以使用一种方法,以可忽略的计算成本找到该优化问题的解。附录O详细介绍了这种方法。
12.2 动力学关联函数#
热平衡系统中的涨落由形如 $\langle C ( t ) B ( 0 ) \rangle$ 的时间关联函数表征,其中B和C是算符。线性响应理论(Negele and Orland, 1988)告诉我们,系统对这些算符的动力学响应由推迟格林函数(retarded Green's function)描述(取 $\hbar = 1$ )_:
$$ i G_{R} ( t > 0 ) = \Big \langle \big [ \boldsymbol{C} ( t ) , \boldsymbol{B} ( 0 ) \big ]_{\pm} \Big \rangle ,\tag{12.2} $$其中尖括号表示热平均,算符 $C ( t )$ 和 $B ( 0 )$ 处于海森堡绘景中。对易子的符号由算符B和C(在薛定谔绘景中)是满足费米子(+)还是玻色子(−)对易关系决定。
与该格林函数相关联的谱密度 $A ( \omega )$ 满足(Negele and Orland, 1988):
$$ G_{R} ( \omega + i \eta ) = \int_{- \infty}^{\infty} d \omega^{\prime} \frac{A ( \omega^{\prime} )} {\omega - \omega^{\prime} + i \eta} , 0 < \eta \ll 1 ,\tag{12.3} $$其中 $G_{R} ( t )$ 的频率傅里叶变换定义为:
$$ G_{R} ( \omega ) = \frac{1} {2 \pi} \int_{0}^{\infty} d t e^{i \omega t} G_{R} ( t ) .\tag{12.4} $$因此,知道 $A ( \omega )$ 就能得到实时间和频率依赖的推迟格林函数:将 $A ( \omega )$ 代入 (12.3) 给出 $G_{R} ( \omega )$,然后通过逆傅里叶变换得到:
$$ G_{R} ( t ) = \int_{\infty}^{\infty} d \omega e^{- i \omega t} G_{R} ( \omega ) . $$有限温度蒙特卡洛模拟计算虚时格林函数1:
$$ G ( \tau ) = \langle C ( \tau ) B ( 0 ) \rangle , \quad 0 \leq \tau < \beta .\tag{12.5} $$由于这种格林函数在虚时上是反周期(费米子)或周期(玻色子)的,即 $G ( \tau ) = \mp G ( \tau + \beta )$,其中 $\beta$ 是逆温度,该关联函数的傅里叶变换是:
$$ \hat{G} ( i \omega_{n} ) = \int_{0}^{\beta} d \tau e^{i \omega_{n} \tau} G ( \tau ) ,\tag{12.6} $$其中 $\omega_{n}$ 是松原(Matsubara)频率,对于费米子算符等于 $( 2 n + 1 ) \pi / \beta$,对于玻色子算符等于 $2 n \pi / \beta$。
知道 $A(\omega)$ 后,便可得到虚时和依赖松原频率的格林函数:将 $A ( \omega )$ 代入
$$ \hat{G} ( i \omega_{n} ) = \int_{- \infty}^{\infty} d \omega^{\prime} \frac{A ( \omega^{\prime} )} {i \omega_{n} - \omega^{\prime}}\tag{12.7} $$得到 $\hat{G} ( i \omega_{n} )$。然后,逆变换
$$ G ( \tau ) = \frac{1} {\beta} \sum_{n} e^{- i \omega_{n} \tau} \hat{G} ( i \omega_{n} ) $$给出 $G ( \tau )$。我们看到,(12.7) 中的 $\hat{G} ( i \omega_{n} )$ 和 (12.3) 中的 $G_{R} ( \omega + i \eta )$ 互为解析延拓:$i \omega_{n} \leftrightarrow \omega + i \eta$。这种延拓将实时间和虚时间的格林函数联系了起来。
如果将 (12.7) 代入逆变换,则得到
$$ G ( \tau ) = \int_{- \infty}^{\infty} d \omega \frac{e^{- \tau \omega}} {1 \pm e^{- \beta \omega}} A ( \omega ) .\tag{12.8} $$这是本章的基本方程。给定来自有限温度模拟的蒙特卡洛估计值 $G ( \tau )$,我们希望求解该方程得到 $A(\omega)$。有了 $A ( \omega )$,我们就知道了 $G_{R} ( t )$(Bonca 和 Gubernatis, 1993b)。
大多数情况下,我们不会一直走到 $G_{R} ( t )$,而是止步于 $A ( \omega )$。我们止步于 $A(\omega)$,是因为系统在实验上有趣的性质,例如光导率、核磁共振弛豫时间、动态自旋结构因子等,都与各种谱密度相关。这些函数给出了相互作用如何改变哈密顿量本征态性质的图像。通常,它们直接提供了关于准粒子和集体模式存在的信息(例如,Kawashima 等人, 1996)。从模拟中提取这类信息的工具显然提升了模拟的价值。
给定 $G ( \tau )$,求解 (12.1) 得到 $A ( \omega )$ 是极其困难的。困难在于积分方程的核,
$$ K ( \tau , \omega ) = \frac{e^{- \tau \omega}} {1 \pm e^{- \beta \omega}} ,\tag{12.9} $$在大正频率和大负频率处变得指数级小。在正问题中,“给定 A,G 是什么?”这种效应抑制了 $G ( \tau )$ 对 $A ( \omega )$ 中大 $|\omega|$ 特征的敏感性。在逆问题中,“给定 G,A 是什么?”$A ( \omega )$ 中大 $|\omega|$ 的特征依赖于 $G ( \tau )$ 的细微特征,而这些特征会被噪声和不完整性所破坏。简而言之,利用不完整且有噪声的数据,我们试图提取数据不敏感的 A 的特征。许多不同的谱密度都能同样好地拟合数据。
通常,一个哈密顿量会有几个有趣的谱密度。为了说明,我们现在讨论单杂质(自旋简并)安德森模型的两个这样的密度
$$ H = \sum_{k \sigma} \epsilon_{k} n_{k \sigma} + \sum_{k \sigma} \left( V_{k} c_{k \sigma}^{\dagger} d_{\sigma} + V_{k}^{*} d_{\sigma}^{\dagger} c_{k \sigma} \right) + \varepsilon_{d} \sum_{\sigma} d_{\sigma}^{\dagger} d_{\sigma} + U n_{d \uparrow} n_{d \downarrow} , $$其中 $\epsilon_{k}$ 是动量为 $k$ 的电子在导带中的能量,$V_{k}$ 是杂质轨道与导带杂化的强度,U 是两个电子同时占据杂质轨道时库仑排斥的强度。
特别令人感兴趣的是与杂质轨道相关的谱密度。如果对于自旋为 $\sigma$ 的电子有 $G^{\sigma} ( \tau ) = \langle \mathcal{T} d_{\sigma}^{\dagger} ( \tau ) d_{\sigma} ( 0 ) \rangle$,且 $A_{\sigma} ( \omega )$ 是相应的谱密度,那么定义 $\begin{array} {r} {G ( \tau ) = \frac{1} {2} \sum_{\sigma} G^{\sigma} ( \tau )} \end{array}$ 和 $A ( \omega ) = \textstyle{\frac{1} {2}} \sum_{\sigma} A_{\sigma} ( \omega )$ 会很方便。于是,由于 $d_{\sigma}^{\dagger}$ 和 $d_{\sigma}$ 满足费米子反对易关系,
$$ G ( \tau ) = \int_{- \infty}^{\infty} d \omega \frac{e^{- \tau \omega}} {1 + e^{- \beta \omega}} A ( \omega ) . $$我们还可以证明 $A ( \omega ) \geq 0$ 并满足求和规则(Negele 和 Orland, 1988)
$$ \int_{- \infty}^{\infty} d \omega A \left( \omega \right) = 1 . $$对称安德森杂质模型描述的是能带相对于 $E_{\mathrm{Fermi}} = 0$ 对称且 $\textstyle{\varepsilon_{d} = - {\frac{1} {2}} U}$ 的情形。在这种情况下,$A ( \omega ) =$ $A ( - \omega )$,我们的积分方程变为 $( 0 \leq \tau < \beta )$
$$ G ( \tau ) = \frac{1} {2} \int_{0}^{\infty} d \omega \frac{e^{- \tau \omega} + e^{- ( \beta - \tau ) \omega}} {1 + e^{- \beta \omega}} A ( \omega ) , $$其中新的核为
$$ K ( \tau , \omega ) = \frac{1} {2} \frac{e^{- \tau \omega} + e^{- ( \beta - \tau ) \omega}} {1 + e^{- \beta \omega}} $$求和规则变为
$$ \int_{0}^{\infty} d \omega A \left( \omega \right) = \frac{1} {2} . $$新的核是 $\omega$ 的偶函数。
另一个值得关注的量是双粒子格林函数 $( 0 \leq \tau < \beta )$
$$ \chi ( \tau ) = \left. d_{\uparrow}^{\dag} ( \tau ) d_{\downarrow} ( \tau ) d_{\uparrow}^{\dag} ( 0 ) d_{\downarrow} ( 0 ) \right. = \frac{1} {\pi} \int_{- \infty}^{\infty} d \omega \frac{e^{- \tau \omega}} {1 - e^{- \beta \omega}} \mathrm{Im} \chi ( \omega ) . $$因为 $d_{\uparrow}^{\dagger} d_{\downarrow}$ 与自身对易,所以其核是玻色型的。对于这个格林函数,谱密度 $\mathrm{sign} ( \omega ) \mathrm{Im} \chi ( \omega ) \geq 0$ 是横向磁化率,它满足求和规则
$$ {\frac{1} {\pi}} \int_{- \infty}^{\infty} d \omega{\frac{\mathrm{Im} \chi \left( \omega \right)} {\omega}} = \chi ( T ) . $$$\chi ( T )$ 是温度 $T$ 下的磁化率。另一个令人关注的量是
$$ {\frac{1} {T_{1} T}} = K \operatorname*{lim}_{\omega \to 0} {\frac{\mathrm{Im} \chi ( \omega )} {\omega}} , $$其中 $K$ 是某个依赖于杂质核与 $d$ 电子自旋之间耦合细节的常数。$T_{1}$ 是核磁弛豫时间。由于 $\mathrm{Im}\chi(\omega)$ 是频率的奇函数,使用反对称化的核
$$ K ( \tau , \omega ) = \frac{1} {2} \frac{e^{- \tau \omega} - e^{- ( \beta - \tau ) \omega}} {1 - e^{- \beta \omega}} $$可将问题限制在正频率的领域内。
正如我们即将讨论的,我们选择积分方程 (12.1)“最佳”解的程序是基于信息论的。增加包含的信息量通常会提高解的质量。对称性是一种精确的信息。在我们最终要描述的数值方法中,像前面例子那样对核进行对称化处理是非常重要的。
12.3 贝叶斯统计推断#
贝叶斯方法的核心是使用概率论,并随之使用贝叶斯定理。我们在第2.1节中讨论过这个定理。回顾一下,
如果我们有两组事件,$X = ( X_{1} , X_{2} , \ldots , X_{m} )$ 和 $Y = ( Y_{1} , Y_{2} , . . . , Y_{n} )$,并为它们分配了概率,那么贝叶斯定理指出(第 2.1 节)
$$ P ( X | Y ) = \frac{P ( Y | X ) P ( X )} {P ( Y )} . $$我们按如下方式使用这个定理:给定的哈密顿量确定了 $A ( \omega )$ 因此,由模拟产生的 $G ( \tau )$ 数据(我们现在将其记为 $\bar{G} ( \tau )$)是以 $A ( \omega )$ 为条件的。然而,我们需要的是以数据 $\bar{G} ( \tau )$ 为条件的 $A ( \omega )$ 因此,
$$ P ( A | \bar{G} ) = \frac{P ( \bar{G} | A ) P ( A )} {P ( \bar{G} )} .\tag{12.10} $$从贝叶斯角度看,给定数据下谱密度的概率,即 $P ( A | \bar{G} )$,正是这个问题的解。与任何其他概率函数一样,我们将其中的大量信息简化为更少的特征量,例如众数、均值、方差等。获得谱密度的概率是具有建设性的,因为面对无限多种可能的解,我们已定量地为各个选项分配了置信度。现在我们可以研究这些选项,并决定如何合理地将某个结果指定为“最优”解。例如,如果概率 $P ( A | \bar{G} )$ 在函数空间 $A ( \omega )$ 中只有一个尖锐的峰值,那么我们可以合理地取这个最可能的 $A ( \omega )$(即 $P ( A | \bar{G} )$ 的众数)作为我们的解。事实上,随着数据量的增加,我们先验地预期会出现这种情况。如果只有一个峰值,但它是偏斜且宽的,那么选择一个平均谱密度,例如 $\textstyle \int{\mathcal{D}} A A P ( A | {\bar{G}} )$,似乎是合理的。另一方面,一个多峰的 $P ( A | \bar{G} )$ 则需要根据具体情况进行专门分析。
贝叶斯定理中出现的各种概率都有名称。$A$ 的概率,即 $P ( A )$,称为先验概率。它表示在数据出现之前(逻辑上,而非时间上的“之前”)$A$ 的概率。数据以及我们可能添加到问题中的其他信息的任务,就是将 $A$ 从这种先验知识中“拉”出来。给定谱密度下数据的概率,即 $P ( {\bar{G}} | A )$,称为似然函数;而给定数据下谱密度的概率,$P ( A | \bar{G} )$,称为后验概率。最后,数据的概率 $P ( \bar{G} )$ 称为证据。证据用于归一化后验概率。为说明这一点,我们对等式两边关于 $A$ 进行泛函积分
$$ P ( A | \bar{G} ) P ( \bar{G} ) = P ( \bar{G} | A ) P ( A ) $$。因为 $\begin{array} {r} {\int{\mathcal{D}} A P ( A | \bar{G} ) = 1} \end{array}$,所以
$$ P ( {\bar{G}} ) = \int{\mathcal{D}} A P ( {\bar{G}} | A ) P ( A ) . $$将这个结果与 (12.10) 式比较,可以确定当我们将后验概率构建为似然函数和先验概率的乘积时(这正是我们所做的),证据就是后验概率的归一化因子。因此,证据以及后验概率都依赖于似然函数和先验概率。
现在我们开始定义对先验概率和似然函数的具体选择。在定义先验概率时,我们诉诸最概然分布理论和最大熵原理,因此首先讨论这两个重要概念。
12.3.1 最大熵原理#
薛定谔推崇最概然分布理论,认为它是推导统计力学基础分布函数的一种简单而统一的方法(Schrodinger, 1952)。为说明他的观点,他考虑在 $N$ 个全同独立系统构成的系综中寻找能量 $E$ 的分布,每个系统都处于众多可能的能量状态 $\varepsilon_{i}$ 之一。定义 $n_{i}$ 为处于状态 $i$ 的系统数目,则具有该组占据数 $( n_{1} , n_{2} , . . . , n_{i} , . . . )$ 的可能状态数目为
$$ \Omega ( n_{1} , n_{2} , \ldots , n_{i} , \ldots ) = {\frac{N !} {n_{1} ! n_{2} ! n_{3} ! \cdot \cdot \cdot n_{i} ! \cdot \cdot \cdot}} . $$给定系综的能量为 $E_{:}$,$n_{i}$ 必须满足约束 $\textstyle \sum_{i} n_{i} = N$ 和 $\textstyle \sum_{i} \varepsilon_{i} n_{i} = E$。在寻找下式的最大值时
$$ \ln \Omega - \lambda \sum_{i} n_{i} - \mu \sum_{i} \varepsilon_{i} n_{i} , $$其中 $\lambda$ 和 $\mu$ 是拉格朗日乘子,他假设 $N$ 和 $n_{i}$ 都很大,然后利用斯特林公式
$$ \ln n ! \approx n \ln n - n ,\tag{12.11} $$他证明了处于状态 $i$ 的概率 $p_{i}$ 为
$$ p_{i} = {\frac{n_{i}} {N}} = {\frac{e^{- \mu \varepsilon_{i}}} {\sum_{i} e^{- \mu \varepsilon_{i}}}} . $$热力学一致性要求 $\mu = 1 / k T$。在 $N$ 和 $n_{i}$ 很大的极限下,微正则熵 $S = k$ ln $\Omega$ 变为
$$ S = - k N \sum_{i} p_{i} \ln p_{i} .\tag{12.12} $$因此,每个系统的熵为 $S / N = - k \textstyle \sum_{i} p_{i}$ ln $p_{i}$。
用信息论方法指派概率密度的原理,即最大熵原理,是最大化一个受约束的熵。它类似于薛定谔使用最概然分布理论的方法。然而,它并不诉诸于计数状态和大数定律来定义熵,而是依据一组小的公理(Shore 和 Johnson, 1980)。泛函
$$ S = - \int d x p ( x ) \ln \bigg ( \frac{p ( x )} {m ( x )} \bigg ) ,\tag{12.13} $$被证明满足这些公理,仅差一个整体常数。这些公理要求熵泛函应
• 具有唯一性
• 具有坐标不变性
• 具有系统独立性
• 具有子集独立性。
它们定义了熵的特性。坐标不变性指在变量变换下的不变性。系统独立性意味着,用单独分布还是用联合分布来表述关于独立系统的独立信息,其结果应相同。最后,子集独立性表明,用条件密度还是用完整系统密度来处理一个独立子集,其结果应相同。
对于离散概率,信息论的熵公理表明,仅差一个正的常数因子,熵表达式为
$$ S = - \sum_{i} p_{i} \log{\left( \frac{p_{i}} {m_{i}} \right)} .\tag{12.14} $$这个表达式看似是 (12.13) 的自然离散化。实际上,还需要一个第五公理(Shore 和 Johnson, 1983)。熵泛函应
• 具有逻辑一致性,
即,在没有额外信息的情况下,最大化离散概率的熵 (12.14) 必须得到 $p_{i} = m_{i}$。
对于连续分布也存在类似结果。在熵泛函 (12.13) 中,$p ( x )$ 是一个概率分布,而 $m(x)$ 是保证变量变换下不变性所需的测度。2 如果我们想在约束 $\textstyle \int d x p ( x ) = 1$ 下最大化 (12.13),我们将从
$$ Q = \lambda_{0} \left[ \int d x p ( x ) - 1 \right] - \int d x p ( x ) \ln{\left( \frac{p ( x )} {m ( x )} \right)} . $$开始。然后,要求 $p$ 的任意变分 $\delta p$ 引起的 $Q$ 的变分 $\delta Q$ 为零,
$$ \delta Q = - \int d x \delta p ( x ) \left[ \ln \left( \frac{p ( x )} {m ( x )} \right) + 1 - \lambda_{0} \right] = 0 , $$意味着 $p ( x ) = m ( x ) e^{- ( 1 - \lambda_{0} )}$。对等式两边关于 $x$ 积分,利用 $p ( x )$ 的归一化条件,并为了方便假设 $m ( x )$ 的积分为一,可得 $\exp [ - ( 1 - \lambda_{0} ) ] = 1$,即 $\lambda_{0} = 1$。因此,$p ( x ) = m ( x )$。这样,我们可以将 $m ( x )$ 视为代表我们对 $p ( x )$ 的先验知识,即在使用数据之前的知识。在贝叶斯分析中,这个勒贝格测度(Lebesgue measure)有时被称为默认模型。最后一个公理说,在没有其他信息的情况下,我们必须恢复我们的先验信息。
关于 $m_{i}$ (以及 $m ( x )$) 的深入理解,可重新审视薛定谔问题,但现在将总能量数限制为 M,并为每个能量分配一个概率 $m_{i}$。对于一组测度 $( m_{1} , m_{2} , \dots , m_{M} )$,为方便起见,假设它们已归一化,
$$ 1 = ( m_{1} + m_{2} + \cdot \cdot \cdot + m_{M} )^{N} = \sum_{{\underset{m_{1} + m_{2} + \cdots + m_{M} = 1} {m_{1} , m_{2} , \ldots , m_{M}}} \atop{m_{1} + m_{2} + \cdots + m_{M} = 1}} \frac{N !} {n_{1} ! n_{2} ! \cdot \cdot \cdot n_{M} !} m_{1}^{n_{1}} m_{2}^{n_{2}} \cdot \cdot \cdot m_{M}^{n_{M}} .\tag{12.15} $$因此,在给定 $( m_{1} , m_{2} , \dots , m_{M} )$ 的条件下,一组特定的占据数 $( n_{1} , n_{2} , \ldots , n_{M} )$ 的概率为
$$ P \left( n_{1} , n_{2} , . . . , n_{M} \vert m_{1} , m_{2} , . . . , m_{M} \right) = \frac{N !} {n_{1} ! n_{2} ! \cdot \cdot \cdot n_{M} !} m_{1}^{n_{1}} m_{2}^{n_{2}} \cdot \cdot \cdot m_{M}^{n_{M}} .\tag{12.16} $$对于大的 N 和 $n_{i}$,
$$ \ln P = - N \sum_{i} p_{i} \ln \left( \frac{p_{i}} {m_{i}} \right) = S ,\tag{12.17} $$其中 $p_{i} = n_{i} / N$。我们注意到,只要 $m_{i}$ 为零,$p_{i}$ 必须为零。
最大熵原理指出,为了基于部分信息分配概率,我们应在已知关于概率的任何信息的约束下最大化熵。这样得到的是与该约束一致的、信息量最小的概率。
该原理的一个标志性应用是预测一组变量 ${\boldsymbol x} = ( x_{1} , x_{2} , \ldots , x_{N} )$ 的联合概率,每个变量的取值范围为 $- \infty$ 到 $\infty$,其均值和协方差矩阵(第3.24节)为
$$ \langle x_{k} \rangle = \int d x x_{k} p ( x ) , $$$$ C_{i j} = \langle ( x_{i} - \langle x_{i} \rangle ) \left( x_{j} - \langle x_{j} \rangle \right) \rangle . $$直接分析可得
$$ p ( x | \{\langle x \rangle \} , C ) = e^{- \frac{1} {2} \delta x^{T} C^{- 1} \delta x} / \sqrt{\operatorname*{det} ( 2 \pi C )} , $$其中偏差向量 δx 是 $( x_{1} - \langle x_{1} \rangle , \ldots , x_{N} - \langle x_{N} \rangle )^{T}$。我们将结果表示为条件概率,因为从逻辑上讲,推导过程以预先知道均值和协方差矩阵为条件。我们指出,如果变量的取值范围不是 $-\infty$ 到 $\infty$,则需要通过数值积分来计算归一化常数。虽然预测的概率具有高斯分布的函数形式,但它们更应该是与高斯函数成比例的函数。
总的来说,最大熵原理有助于建议概率的函数形式。在下一小节中,我们将这个多元高斯分布作为似然函数,但我们并不援引最大熵原理。熵是我们为先验概率所做选择的一部分。我们的积分方程的解涉及最大化对数似然与最大化熵之间的竞争。
12.3.2 似然函数与先验概率#
我们现在讨论对似然函数和先验概率的选择。对于似然函数,我们从非常一般的形式开始:
$$ P ( \bar{G} | A ) = e^{- \mathcal{L} ( \bar{G} , A )} / Z \mathcal{L} , $$其中 $\mathcal{L} ( \bar{G} , A )$ 是某个正函数,$Z_{\mathcal{L}}$ 是归一化常数。现在我们需要更具体地确定 $\mathcal{L} ( \bar{G} , A )$ 的函数形式。
我们希望所选的 $\mathcal{L}$ 与模拟生成的数据兼容。如果 $\bar{G}_{i}^{( j )}$ 是模拟中第 j 个构型下 $G_{i}$ 的值,那么模拟最终会给出均值的估计
$$ \bar{G}_{i} = \frac{1} {M} \sum_{j = 1}^{M} \bar{G}_{i}^{( j )}\tag{12.18} $$和协方差矩阵(3.24)的估计
$$ C_{i k} = \frac{1} {M ( M - 1 )} \sum_{j = 1}^{M} \left( \bar{G}_{i}^{( j )} - \bar{G}_{i} \right) \left( \bar{G}_{k}^{( j )} - \bar{G}_{k} \right) .\tag{12.19} $$考虑到数据由均值和协方差表示,自然而方便地取
$$ {\mathcal{L}} ( {\bar{G}} , A ) = {\textstyle \frac{1} {2}} \chi^{2} ( {\bar{G}} , A ) ,\tag{12.20} $$其中
$$ \chi^{2} ( \bar{G} , A ) = \sum_{i , j = 1}^{L} \left( \bar{G}_{i} - G_{i} \right) \left[ C^{- 1} \right]_{i j} \left( \bar{G}_{i} - G_{i} \right) ,\tag{12.21} $$其中 $G_{i}$ 是给定 A 下 $G ( \tau )$ 在 $\tau_{i}$ 处的精确值。采用这种 ${\mathcal{L}}$ 的选择后,归一化常数 $Z_{\mathcal{L}}$ 为 $( 2 \pi )^{N / 2} {\sqrt{\operatorname*{det} C}}$。
这一选择与简单最小二乘和正则化最小二乘问题的选择相同。那里的讨论隐含地假设某个高斯过程生成了数据,从而定义了均值和协方差。在我们的情形中,蒙特卡洛模拟生成了数据,我们据此计算均值和协方差。如果我们使用足够大量的统计独立信息计算它们,那么根据中心极限定理,均值服从高斯分布,其宽度由协方差矩阵定义。
方程 (12.17) 暗示了我们先验概率的选择:它表明,在没有其他信息的情况下,给定一组占据数的概率与熵的指数成正比。与其诉诸组合学论证,我们可以转而使用信息论论证来导出熵的函数形式,并将同样的指数形式用作先验概率。事实上,在统计推断中,当赋予概率并需要保持其正性时,最常见的先验概率选择是熵先验 (entropic prior):
$$ P ( A ) = e^{\alpha S ( A )} / Z_{S} ( \alpha ) ,\tag{12.22} $$其中 α 设定熵贡献的尺度,而 $Z_{S} ( \alpha )$ 是归一化常数。一般而言,α 是先验未知的。
选择熵先验有哲学上的理由。然而,我们的主要理由是实用的:它是保持解的正性和归一化的便捷选择。另一个理由是它带来的附加值:我们用建立熵形式的那组公理所规定的已知特征来约束我们的解。实际上,由于熵的加性,这种先验概率仅在数据或其他先验知识强制要求结构时,才会在解中引入结构。最后,我们喜欢这样一个事实:默认模型 (default model) 是将我们的先验信息融入解的一种显式机制。对于大多数物理问题,都存在各种近似或精确结果,我们可以将其用作默认模型。
似然函数和先验概率的这些选择使我们能够写出联合分布
$$ P ( A , {\bar{G}} ) = P ( {\bar{G}} | A ) P ( A ) = {\frac{e^{\alpha S - {\mathcal{L}}}} {Z_{\mathcal{L}} Z_{S} ( \alpha )}} .\tag{12.23} $$贝叶斯定理中剩下的两个概率是后验概率和证据 (evidence)。我们对似然函数和先验概率的选择决定了二者。我们现在任务是讨论这些选择如何影响我们对该积分方程的“最优”解的选择。
12.3.3 “最优”解#
我们讨论寻找解的三种方法。选择了似然函数 (12.20) 和先验概率 (12.22) 后,我们可以根据证据将后验概率写为
$$ P ( A | \bar{G} ) = \frac{P ( A , \bar{G} )} {P ( \bar{G} )} = \frac{e^{Q ( A )}} {Z_{\mathcal{L}} Z_{S} ( \alpha )} ,\tag{12.24} $$其中
$$ \begin{array} {r} {Q ( A ) = \alpha S ( A ) - \frac{1} {2} \chi^{2} ( A ) .} \end{array}\tag{12.25} $$有了这个后验概率,我们现在陈述第一个最优解:忽略与$A$无关的证据,将给定数据$\bar{G}$时最可能的谱密度$A$作为我们的解。我们通过最大化$Q(A)$来找到它,而$Q(A)$反过来又最大化后验概率。我们称之为受约束的拟合(constrained fit),因为它本质上是一个正则化的最小二乘拟合,正则化函数是熵。这个解依赖于$\alpha$。我们选择$\alpha$使得$\chi^{2}=N$,其中$N$是$\bar{G}_{i}$的数目。这种选择$\alpha$的方法基本上是临时性的,通常倾向于欠拟合。由此产生的过程通常被称为历史最大熵方法(historic maximum entropy method)。
在这个分析层次上,我们清楚地看到了拟合与推断之间的对偶性。我们可以将受约束的拟合视为最小化$\chi^{2}$,这对应于选择$A_{i}$参数以在熵约束下尽可能紧密地拟合数据。或者,我们可以将这个解视为在数据约束下最大化熵,从而将最少的信息引入解中。
选择$\alpha$的另一种方法是使用贝叶斯分析来指导选择。我们将解决积分方程的第二种方法称为贝叶斯受约束拟合(Bayesian constrained fit)。更常见的是,它被称为经典最大熵方法(classic maximum entropy method)。
在开始发展这种替代方法时,我们首先注意到我们的先验概率是以$\alpha$为条件的,并将(12.23)写为
$$ P ( A , {\bar{G}} | \alpha ) = P ( {\bar{G}} | A ) P ( A | \alpha ) = {\frac{e^{Q}} {Z_{\mathcal{L}} Z_{S} ( \alpha )}} .\tag{12.26} $$注意,(12.26)中的似然函数由物理动力学决定,因此不以$\alpha$为条件,$\alpha$被引入来缩放熵对熵先验的贡献。然后我们定义一个新的联合概率
$$ P ( A , {\bar{G}} , \alpha ) = P ( A , {\bar{G}} | \alpha ) P ( \alpha ) = P ( \alpha ) {\frac{e^{Q}} {Z_{\mathcal{L}} Z_{S} ( \alpha )}}\tag{12.27} $$和新的后验概率
$$ P ( A , \alpha | \bar{G} ) = \frac{P ( \alpha )} {P ( \bar{G} )} \frac{e^{Q}} {Z_{\mathcal{L}} Z_{S} ( \alpha )} . $$引入了一个新的概率 $P ( \alpha )$,即$\alpha$的概率。这个数通常被选为常数或所谓的Jeffery先验(Jeffery's prior),$P ( \alpha ) ~ \propto ~ 1 / \alpha$ (Sivia and Skilling, 2006)。Jeffery 认为,分配给尺度设定参数的概率应该使得$p ( x ) d x = p ( c x ) d ( c x )$。由于$d ( c x ) = c d x$,这个要求简化为$p ( x ) = c p ( c x )$,这只有通过$p ( x ) \ \propto \ 1 / x$才能满足。归一化需要对$x$的范围进行相应的限制。在实践中,一个良好的解对于将$P ( \alpha )$选为常数或$1 / \alpha$是相当不敏感的。对于固定的$\alpha$,我们注意到新的后验概率的最大值仍然出现在$Q$的最大值处。
为了寻找$\alpha$的“最佳”值,我们写出
$$ P ( A | \bar{G} ) = \int d \alpha P ( A , \alpha | \bar{G} ) = \int d \alpha P ( A | \alpha , \bar{G} ) P ( \alpha | \bar{G} ) . $$如果数据点数量很大并且与推断问题紧密相连,那么合理地预期这些大量数据会显著限制单个参数$\alpha$的可能取值,使得$P ( \alpha | \bar{G} )$在某个值$\alpha = {\hat{\alpha}}$处尖锐地峰值;也就是说,$P ( \alpha | \hat{G} ) \approx \delta ( \alpha - \hat{\alpha} )$。后验概率变为
$$ P ( A | \bar{G} ) \approx P ( A | \bar{G} , \hat{\alpha} ) . $$对于积分方程的第二个解,我们找到$P ( \alpha | \bar{G} )$达到峰值的$\alpha$值$\hat{\alpha}$,然后对于这个$\alpha$值,找到使$Q$最大化的$A$作为解。这两个步骤定义了贝叶斯受约束拟合。我们注意到这个解不等同于求解
$$ {\frac{\partial P ( A , \alpha | {\bar{G}} )} {\partial A}} = 0 , \quad{\frac{\partial P ( A , \alpha | {\bar{G}} )} {\partial \alpha}} = 0 . $$这些方程同时确定了A和$\alpha$。
在第12.4节中,我们讨论了如何估计$P ( \alpha | \bar{G} )$并找到$\hat{\alpha}$。这里我们推导这个概率的形式。首先,我们从联合概率(12.27)中对A进行边缘化:
$$ P ( \alpha , \bar{G} ) = \int{\mathcal{D} A} P ( A , \alpha , \bar{G} ) . $$然后,利用$P ( \alpha , \bar{G} ) = P ( \alpha | \bar{G} ) P ( \bar{G} )$和(12.27),我们得到
$$ P ( \alpha | \bar{G} ) = \frac{P ( \alpha )} {P ( \bar{G} )} \int \mathcal{D} A \frac{e^{Q}} {Z_{\mathcal{L}} Z_{S}} .\tag{12.28} $$参数$\alpha$被称为讨厌参数(nuisance parameter),通常处理讨厌参数的最佳方法是将其从问题中积分掉(边缘化),并使用$P ( A | \bar{G} )$而不是$P ( A , \alpha | \bar{G} )$。事实上,我们对该问题的第三种解法正是这样做的。我们将这种方法称为平均谱方法(average spectrum method)。过去,为了表彰其来源,它被称为Bryan方法(Bryan, 1990)。名称的改变强调了该解法的本质是平均值而非众数。这种本质常常被忽略。
对于这第三种方法,我们首先从下式找到$\hat{A}_{\alpha}$
$$ \left. \frac{\partial Q} {\partial A} \right| _{A = \hat{A}_{\alpha}} = 0 , $$也就是说,我们得到作为$\alpha$函数的受约束拟合,然后我们选择由下式定义的平均值作为解
$$ \langle A \rangle = \int d \alpha \hat{A}_{\alpha} P ( \alpha | \bar{G} ) , $$其中$P ( \alpha | \bar{G} )$由(12.28)给出。我们需要这个解,因为$P ( \alpha | \bar{G} )$有时不是尖锐地峰化,而是宽峰且偏斜的。
所有三种方法都需要找到对于固定的$\alpha$值使$Q ( A )$最大的A,其中两种方法需要知道$P ( \alpha | \bar{G} )$的一些信息。在下一节中,我们将详细讨论$Q ( A )$最大值的性质,并给出$P ( \alpha | \bar{G} )$的一个近似。在进入那一节之前,我们首先对证据(evidence)说几句。
在我们的求解方法中存在两种证据,$P ( \bar{G} )$和$P ( {\bar{G}} | \alpha )$。我们现在推导两者的形式表达式。首先,利用
$$ P ( {\bar{G}} | \alpha ) = {\frac{P ( \alpha | {\bar{G}} ) P ( {\bar{G}} )} {P ( \alpha )}} $$和(12.28),我们立即得到
$$ P ( \bar{G} | \alpha ) = \int{\mathcal{D}} A {\frac{e^{Q}} {Z_{\mathcal{L}} Z_{S}}} .\tag{12.29} $$接下来,对(12.28)两边关于α积分得到
$$ P ( \bar{G} ) = \int d \alpha P ( \alpha ) \int{\mathcal{D}} A \frac{e^{Q}} {Z_{\mathcal{L}} Z_{S}} . $$从这两个结果可以看出,条件证据 $P ( {\bar{G}} | \alpha )$ 对于证据 $P ( \bar{G} )$ 和 $P ( \alpha | \bar{G} )$ 都至关重要。幸运的是,我们后验概率 $P ( A | \bar{G} )$ 的证据 $P ( \bar{G} )$ 是条件证据 $P ( {\bar{G}} | \alpha )$ 关于概率 $P ( \alpha )$ 的期望值。与此相关的是关于如何判断证据是否显著的一些评论。
如果我们接受的解依赖于后验概率的众数,那么证据 $P ( \bar{G} )$ 作为归一化因子,在解中不起作用,因为它与拟合参数 $\alpha$ 和 $A$ 的值没有显式依赖关系。约束拟合和贝叶斯约束拟合都属于这种情况。然而,如果我们的解是对 $A$ 和 $\alpha$ 的平均,那么证据就起着至关重要的作用。条件证据在贝叶斯约束拟合和平均谱方法中发挥作用。
12.4 分析细节与奥卡姆因子#
对于固定的 $\alpha$,寻找 $Q$ (12.25) 关于 $A$ 的最大值,这是我们所有三种方法的核心,原则上很简单,因为似然函数和熵先验都是 $A_{i}$ 的凹函数,因此存在唯一的极大值。在实践中,寻找最大值可能很困难,因为它可能不尖锐。似然函数的凹性是众所周知的:协方差矩阵是正定的,因此我们总可以将数据变换到该矩阵为对角线的坐标系。然后,在似然函数中,曲率张量是对角的,其正矩阵元素等于协方差矩阵的正特征值。熵对 $Q$ 贡献的凹性也很容易建立。通过直接计算,
$$ {\frac{\partial^{2} S} {\partial A_{i} \partial A_{j}}} = - {\frac{\delta_{i j}} {A_{i}}} = - {\frac{\delta_{i j}} {\sqrt{A_{i} A_{j}}}} . $$因此,熵的曲率等于 $\sqrt{A_{i} A_{j}} \delta_{i j}$。
$Q$ 在这个极大值附近的性质决定了求解的难易程度。为了描述这个极大值,方便的做法是将偏差,即 $\delta \hat{A_{i}} = A_{i} - \hat{A_{i}}$,变换到熵曲率平坦的新变量 $X_{i}$ 空间。新坐标系满足
$$ \frac{\partial A_{j}} {\partial X_{i}} = \sqrt{A_{j}} \delta_{i j} .\tag{12.30} $$通过此变量变换,
$$ \begin{array} {r} {Q ( A , \alpha ) \approx Q ( \hat{A}_{\alpha} ) - \frac{1} {2} \displaystyle \sum_{i j} \delta X_{i} \Gamma_{i j} \delta X_{j} ,} \end{array} $$其中 $\Gamma$ 是一个正定矩阵 $\Gamma_{i j} = \alpha \delta_{i j} + \Lambda_{i j}$,且有
$$ \Lambda_{i j} = \left[ \sqrt{A_{i}} \frac{\partial^{2} \mathcal{L}} {\partial A_{i} \partial A_{j}} \sqrt{A_{j}} \right]_{A = \hat{A}_{\alpha}} $$以及
$$ \frac{\partial^{2} \mathcal{L}} {\partial A_{i} \partial A_{j}} = \left[ K^{T} \cdot C^{- 1} \cdot K \right]_{i j} = \sum_{k l} K_{k i} \left[ C^{- 1} \right]_{k l} K_{l j} . $$此处,$K_{i j}$ 是积分方程核的时频离散化。在新坐标系中,$\Gamma$ 控制着 $Q$ 在极大值附近的曲率。如果 $\Gamma$ 的特征值很小,曲率就很平坦。平坦的曲率使得寻找极大值变得复杂,并导致结果存在相当大的不确定性。$X_{i}$ 的协方差是不确定性的一种度量,
$$ \left. {\delta X_{i} \delta X_{j}} \right. = \int{\mathcal{D} X \delta X_{i} \delta X_{j} P \big ( A | \bar{G} \big ) \approx \left[ {\Gamma^{- 1}} \right]_{i j}} . $$在 $\Gamma$ 为对角线的坐标系中,$\left. \delta X_{i} \delta X_{j} \right. \to \left. \delta X_{i}^{2} \right. \delta_{i j} = \delta_{i j} / \gamma_{i}$,其中 $\gamma_{i}$ 是 $\Gamma$ 的特征值。类似地,我们得到
$$ \left. \delta A_{i} \delta A_{j} \right. \approx \left[ \sqrt{\hat{A}} \Gamma^{- 1} \sqrt{\hat{A}} \right]_{i j} = \sqrt{\hat{A}_{i}} \left[ \Gamma^{- 1} \right]_{i j} \sqrt{\hat{A}_{j}} .\tag{12.31} $$因此,Γ 的小特征值会导致结果方差很大。我们还注意到,以 $\sqrt{A_{i}}$ 作为问题 (12.30) 的度量会得到 $\mathcal{D} A = \prod_{i} d A_{i} / \sqrt{A_{i}}$,并且通过变量变换,${\mathcal{D}} A \to{\mathcal{D}} X = \prod_{i} d X_{i}$。
现在,我们明确分析中所需的归一化因子。从物理上看,当 $A ( \omega )$ 的取值范围在 0 到 1 之间时,不同虚时的格林函数值也落在另一组边界之间。例如,如果 $G ( \tau )$ 描述特定自旋的费米子,其值就在 0 到 1 之间。因此,归一化积分乍看起来需要数值计算。然而,如果数据误差足够小,使得似然函数指数尖锐峰化,即该指数在积分区间内迅速衰减,我们就可以将积分限扩展到整个空间,然后解析地计算积分:如果
$$ Z_{\mathcal{L}} = \int{\mathcal{D}} {\bar{G}} e^{- {\frac{1} {2}} x^{2}} = \int \prod_{i} d {\bar{G}}_{i} e^{- {\frac{1} {2}} x^{2}} $$且
$$ \chi^{2} = \sum_{i , j = 1}^{L} \left( \bar{G}_{i} - G_{i} \right) \left[ C^{- 1} \right]_{i j} \left( \bar{G}_{j} - G_{j} \right) , $$那么,当积分限扩展到整个空间时,我们得到
$$ Z_{\mathcal{L}} = ( 2 \pi )^{L / 2} \sqrt{\operatorname*{det} C} . $$因此,我们的似然函数正是之前假设的归一化高斯分布。
这个看似多余的推导说明了中心极限定理的一个重要观点:尽管给定分布(例如 [0, 1] 上的均匀分布)的随机变量取值范围是有限的,但大量这些变量平均值的允许范围却是从 $-\infty$ 到 $\infty$。随着求和项数的增加,平均值落在原始范围之外的概率变得微乎其微。
对于先验概率的归一化因子,即 $Z_{S} ( \alpha )$,情况有所不同。我们需要通过类似的分析推导出一个近似表达式。我们从
$$ Z_{S} ( \alpha ) = \int{\mathcal{D}} A e^{\alpha S} = \prod_{i} \int{\frac{d A_{i}} {\sqrt{A_{i}}}} e^{\alpha S_{i}} , $$开始,其中 $S_{i} = A_{i} \ln ( A_{i} / m_{i} )$。接下来,我们将指数近似为以 $A_{i} = m_{i}$ 为中心的高斯分布,将积分范围扩展到整个空间,并得到
$$ \int \frac{d A_{i}} {\sqrt{A_{i}}} e^{\alpha S_{i}} \approx \int d X e^{- \alpha X^{2} / 2} = \sqrt{2 \pi / \alpha} . $$因此,
$$ Z_{S} \left( \alpha \right) \approx \left( \frac{2 \pi} {\alpha} \right)^{N / 2} = \frac{( 2 \pi )^{N / 2}} {\sqrt{\operatorname*{det} \alpha I}} ,\tag{12.32} $$其中 I 是 $N \times N$ 的单位矩阵。可以肯定的是,在其最大值附近,熵函数可以很好地用二次函数近似。该最大值附近的宽度由 $\alpha > 0$ 的大小控制,并且当 α 很大时,先验分布的峰值最为尖锐。
现在我们推导条件证据(conditional evidence)$P ( \bar{G} | \alpha )$ 的近似表达式:
$$ P ( \bar{G} | \alpha ) = \int{\mathcal{D}} A \frac{e^{Q}} {Z_{\mathcal{L}} Z_{S} ( \alpha )} . $$有了它,我们所需的 $P ( \alpha | \bar{G} )$ 和 $P ( \bar{G} )$ 表达式就很容易得出。我们只需将被积函数近似为以 $Q$ 的最大值为中心的高斯形式:
$$ \begin{array} {c} {{P ( \bar{G} | \alpha ) \approx \displaystyle \frac{e^{\mathcal{Q} ( \hat{A}_{\alpha} )}} {Z_{\mathcal{L}} Z_{S} ( \alpha )} \int \mathcal{D} X e^{- \frac{1} {2} \delta X^{T} \cdot ( \alpha I + \Lambda ) \cdot \delta X}}} \\ {{= \displaystyle \frac{e^{\mathcal{Q} ( \hat{A}_{\alpha} )}} {Z_{\mathcal{L}} Z_{S} ( \alpha )} \displaystyle \frac{( 2 \pi )^{N / 2}} {\sqrt{\operatorname*{det} [ \alpha I + \Lambda ( \hat{A}_{\alpha} ) ]}} .}} \end{array}\tag{12.33} $$如果 Q 附近的峰值足够尖锐,这一近似应该是足够好的。
对于贝叶斯约束拟合,我们需要关于 α 最大化 $P ( \alpha | \bar{G} )$。该函数就是 $P ( \alpha ) P ( {\bar{G}} | \alpha ) / P ( {\bar{G}} )$。由于 $P ( \bar{G} )$ 与 α 无关,我们从 $P ( \alpha ) P ( {\bar{G}} | \alpha )$ 的最大值来寻找 $P ( \alpha | \bar{G} )$ 的最大值。通常,$P ( \alpha )$ 的常见选择是无特征的。我们实际需要的是 $P ( {\bar{G}} | \alpha )$ 作为 α 函数的最大值。利用 (12.33),条件 ∂ ln $P ( \bar{G} | \alpha ) / \partial \alpha = 0$ 导致
$$
- 2 \hat{\alpha} S ( \hat{A}_{\hat{\alpha}} ) = \mathrm{Tr} \left[ \Lambda ( \alpha I + \Lambda )^{- 1} \right] - \mathrm{Tr} \left[ \frac{d \ln \Lambda} {d \ln \alpha} \Lambda ( \alpha I + \Lambda )^{- 1} \right] . $$
对数导数预期很小。无论如何,我们将其从该表达式中去掉。贝叶斯约束拟合的定义方程变为
$$ N_{\mathrm{good}} \equiv - 2 \hat{\alpha} S ( \hat{A}_{\hat{\alpha}} ) = \operatorname{Tr} \left[ \Lambda ( \alpha I + \Lambda )^{- 1} \right] = \sum_{i} \frac{\lambda_{i}} {\alpha + \lambda_{i}} ,\tag{12.34} $$其中 $\lambda_{i}$ 是 $\Lambda$ 的特征值。量 $- 2 \hat{\alpha} S ( \hat{A}_{\hat{\alpha}} )$ 被称为 $N_{\mathrm{good}}$,它衡量解相对于默认模型的偏移量(如果解就是默认模型,熵将为零)。当一个 $\lambda_{i}$ 远大于 α 时,它对 $N_{\mathrm{good}}$ 贡献为 1。当它远小于 α 时,贡献为零。因此,$N_{\mathrm{good}}$ 衡量解中“好”信息的数量,并且是解中结构数量的便利指标。
当 $N_{\mathrm{good}}$ 很大时,预计 $P ( \alpha | \bar{G} )$ 具有尖锐的峰值。不幸的是,解析延拓拟合问题高度不适定的典型特征是 $N_{\mathrm{good}} \ll N$,其中 $N_{\mathrm{good}}$ 通常在 5 到 10 之间。当这个品质因数很小时,我们只能指望参数化少数几个峰的位置和宽度。
虽然贝叶斯约束拟合通常能给出可接受的结果,但平均谱方法通常与数据中的信息更加一致。同样,该解为
$$ \langle A \rangle = \int{\mathcal{D}} A d \alpha A ( \alpha ) P ( A , \alpha | {\bar{G}} ) \approx \int d \alpha{\hat{A}}_{\alpha} P ( \alpha | {\bar{G}} ) ,\tag{12.35} $$其中对 α 的积分是数值进行的。如果 $P ( \alpha | \bar { G } )$ 是尖锐峰值的,则平均谱解再现了贝叶斯约束拟合,并且在没有数据时返回模型。要获得平均谱结果,我们需要归一化的 $P ( \alpha | \bar { G } )$。做法是:使用 (12.33) 计算 $P ( { \bar { G } } | \alpha )$,对于若干离散的 α 值评估 $P ( \alpha ) P ( { \bar { G } } | \alpha )$,然后计算该曲线下的面积。该面积就是归一化因子。将 $P ( \alpha ) P ( { \bar { G } } | \alpha )$ 的值除以该因子,即得到 $P ( \alpha | \bar { G } )$。
我们在上一小节末尾评论了证据何时显著。我们在本小节结尾就证据的重要性做一些评论。为此,我们首先讨论条件证据与所谓奥卡姆因子(Ockham factor)之间的关系。利用 (12.32),条件证据
$$ P ( \bar{G} | \alpha ) = \frac{e^{Q ( \hat{A}_{\alpha} )}} {Z_{\mathcal{L}}} \frac{( 2 \pi )^{N / 2}} {Z_{S} ( \alpha ) \sqrt{\operatorname*{det} [ \alpha I + \Lambda ]}} \approx \underbrace{e^{\alpha S ( \hat{A} )} \frac{e^{- \mathcal{L} ( \hat{A}_{\alpha} )}} {Z_{\mathcal{L}}}}_{\mathrm{b e s t ~ f i t}} \underbrace{\sqrt{\frac{\operatorname*{det} [ \alpha I ]} {\operatorname*{det} [ \alpha I + \Lambda ]}}}_{\mathrm{O c k h a m ~ f a c t o r}}\tag{12.36} $$近似是两个因子的乘积。一个来自后验概率的众数,代表约束最小二乘拟合;另一个修正拟合结果。从这个角度来看,对于给定的 α,最大值源自拟合谱密度值与好数据之间的竞争——小 α 倾向于前者,而由于奥卡姆因子,大 α 倾向于默认模型。当数据被紧密拟合时,众数代表一个包含许多参数的解,而奥卡姆因子则偏好更少的参数。正如我们所示,证据是条件证据的期望值,而且由于常见的 $P ( \alpha )$ 选择(即便不是平坦的)也缺乏特征,因此完整证据继承了奥卡姆特性。证据有助于在数据拟合精度与拟合参数数量之间建立平衡。
在图 12.1 中,我们示意性地描绘了奥卡姆因子。在获得数据之前,我们对解的认识由先验概率表示。它在参数空间中的某个体积 $\Delta A$ 内承认一个可能的解,因此大致等于 $1 / \Delta A$ 。有了数据后,似然函数将解限制在以众数为中心的某个更小体积 δA 内。一般来说,如果我们的先验信息在参数空间的大范围内容纳解,那么只有先验的一小部分对证据有贡献。通常,随着我们增加参数数量,会使 δA 变小,同时使 $\Delta A$ 变大。奥卡姆因子 $\delta A / \Delta A$ 表达了一种惩罚,用于惩罚为了获得良好拟合而使用过多参数。简而言之,证据包含一个奥卡姆因子,它偏好比最小二乘解更简单的物理模型,这符合奥卡姆数世纪前提出的原则:人应始终选择以尽可能少的成因、因子或变量进行解释。证据有助于避免“参数足够多就能拟合任何东西”的综合征。
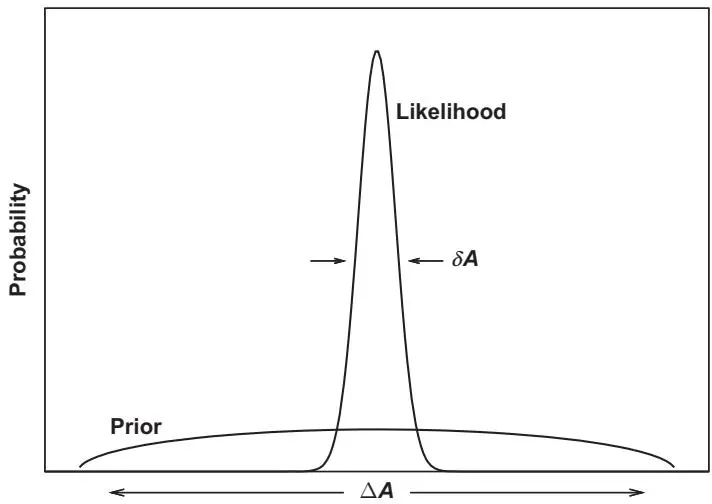
图 12.1 奥卡姆因子的示意图。该因子惩罚那些在参数空间中“浪费”体积的结果。证据 $P ( {\bar{G}} ) = \int P(\bar{G}|A)P(A) dA \approx P(\bar{G}|\hat{A})\delta A / \Delta A$ = 最大似然 × 奥卡姆因子。
12.5 实际考量#
我们现在讨论与使用贝叶斯熵方法生成积分方程 (12.1) 解相关的几个实际问题。该方法的三个基本步骤各自需要特殊考量。这些步骤是:
- 验证数据与似然函数的假设一致
- 求解积分方程
- 评估解的接受度。
Jarrell 和 Gubernatis(1996)对无限维周期安德森模型进行了这些步骤的详细案例研究。Jarrell 等人 (2008) 给出了稍作更新的版本。在此,我们重点介绍这些研究的要点。
- 验证数据与似然函数的假设一致包含两部分。首先是确定用于计算协方差矩阵的数据统计独立。在此,我们需要消除从一个蒙特卡罗步骤到另一个步骤之间数据存在的相关性。其次是处理在给定蒙特卡罗步骤内数据之间存在的相关性。在此,我们通过对角化协方差矩阵来消除这些相关性。
数据由两类测量值组成:平均值 (12.18) 和协方差矩阵 (12.19)。与其他均值蒙特卡洛估计一样,$\bar{G}_{i}$ 的估计不受连续蒙特卡罗步骤之间相关性的影响。另一方面,与其他不确定性的蒙特卡洛估计一样,协方差矩阵元素的估计则受到影响。为了生成正确估计协方差所需的假定统计独立的测量值,我们使用分块均值法,重点关注协方差矩阵的对角元素。如第 3 章第 3.4 节所述,我们将数据流分解为越来越大的数据块,直到块平均值达到统计独立。
“验证数据”的一个困难在于,许多 $\bar{G}_{i}$ 的估计值往往具有非零的偏度和峰度。例如,与单杂质安德森模型谱密度相关的格林函数 $G ( \tau )$ 的涨落,在 $\tau$ 接近 0 时上限为 1,在 $\tau$ 接近 $\beta / 2$ 且 $\beta$ 较大时下限为零。显然,减少这些格林函数元关联分块平均值的涨落比其他元更具挑战性。如果我们回想上一小节关于中心极限定理的讨论,就能开始理解其中的原因。中心极限定理将高斯分布定位在随机变量的均值处。如果该变量有界且其均值接近边界,则需要更大的方差缩减,才能使均值附近的分布呈现出较强的高斯形状。在当前情况下,增加分块大小最终会促使协方差矩阵的大部分对角元素展现出统计独立性和高斯分布的特征。
关注 $\mathbf{C}$ 的对角元素以确立统计独立性,与其说是一种富有洞察力的统计方法,不如说是一种实用方法。然而,这并非等同于舍弃 $\mathbf{C}$ 的非对角元素。舍弃非对角元素会消除不同 $\tau$ 值测量值之间的关联,但会导致由 $\mathbf{C}$ 度量的独立信息的误差估计不佳。
在分块大小合理确定后,增加分块数量有助于正定协方差矩阵的正确计算。在此,我们感兴趣的是对角化该矩阵,以便将 $\chi^{2}$ 转换为误差的标准估计形式,
$$ \chi^{2} = \sum_{i , j = 1}^{L} ( \bar{G}_{i} - G_{i} ) \bigl [ C^{- 1} \bigr ]_{i j} ( \bar{G}_{j} - G_{j} ) \to \sum_{i = 1}^{L} {( \bar{G}_{i}^{\prime} - {G_{i}^{\prime}} )}^{2} / \sigma_{i}^{2} ,\tag{12.37} $$用于不相关的测量值。如果 $\mathbf{C}$ 通过相似变换 $C = S \Sigma S^{T}$ 对角化,则 $G^{\prime} = S G$ 且 $\bar{G}^{\prime} = S \bar{G}^{\prime}$ 。如果统计独立的分块数量不足,$\mathbf{C}$ 的特征值(即 $\sigma_{i}^{2}$)在从高到低排序时,会在某个索引值处急剧下降。小的特征值不如大的特征值准确。为了防止这种断裂,似乎需要 $N_{\mathrm{blocks}} ~ > ~ 2 L$ 。产生足够多且足够大的分块定义了量子蒙特卡洛方法的数值任务。
- 在数据合格后,我们转向方法的第二步,现在寻求积分方程的解。我们首先需要讨论其离散化。尽管我们的问题 (12.1) 是分配一个准概率密度 $A(\omega)$,但当我们对问题进行离散化时,就将其转化为分配概率的问题。有时,非均匀离散化是有利的,可以将计算工作集中在峰值附近,而不是在频率变化平缓、缺乏特征的区域。在离散化时,给一个区间内的密度分配一个平均值,类似于给每个区间分配一个不同的概率。我们需要以这样一种方式做到这一点:如果我们从均匀网格改为对数网格,则保持熵形式不变(回忆第二公理)。
离散化后,我们有一个线性方程组,需要利用一组离散 $\tau$ 值 $(\tau_{1} , \tau_{2} , \dots , \tau_{L})$ 上的 $\bar{G} ( \tau )$ 值,求解一组离散 $\omega$ 值 $(\omega_{1} , \omega_{2} , \ldots , \omega_{N})$ 上的 $A ( \omega )$ 值。该方程组为
$$ \bar{G}_{i} = \sum_{j = 1}^{N} K_{i j} A_{j} , i = 1 , \ldots , M ,\tag{12.38} $$其中 $\bar{G}_{i} = \bar{G} ( \tau_{i} )$,$K_{i j} = K ( \tau_{i} , \omega_{j} )$,而 $A_{i} ~ = ~ A ( \omega_{i} ) \Delta \omega_{i}$。类似地,我们定义 $m_{i} = m ( \omega_{i} ) \Delta \omega_{i}$。借助后两个定义,$A_{i}$ 表示位于区间 $( \omega_{i} , \omega_{i} + \Delta \omega_{i} )$ 的概率,问题也恰当地从寻找概率密度转变为分配概率。
第12.3.3节讨论的三种解法都需要最大化
$$ \begin{array} {l} {{\displaystyle Q ( A ) = Q ( A_{1} , A_{2} , \dots , A_{N} )}} \\ {{\mathrm{}}} \\ {{\mathrm{} = \alpha S ( A_{1} , A_{2} , \dots , A_{N} ) - \displaystyle \frac{1} {2} \sum_{i = 1}^{L} \left( \displaystyle \frac{\bar{G}_{i} - \sum_{j = 1}^{N} K_{i j} A_{j}} {\sigma_{i}} \right)^{2}}} \end{array}\tag{12.39} $$对于给定的 $\alpha$ 值。(为表示方便,我们省略了 $\bar{G}_{i}$ 上的撇号。)每种解法的核心策略如图12.2所示。实线等值线是 $\chi^{2}$ 失配函数的值,虚线等值线是等熵值。对于较大的 $\alpha$ 值,解由默认模型主导,拟合数据的效果可能较差;而对于较小的 $\alpha$ 值,解由最小二乘拟合主导,拟合通常较紧密。我们从较大的 $\alpha$ 值开始,尝试采取小步长,逐步减小数据失配并增加熵(即,使解远离默认模型)。失配函数和熵的凹性保证了解的唯一性。我们通过将 $Q$ 重新表述为降低问题复杂度的形式,然后使用 Levenberg-Marquardt 算法(Golub and Loan,1989;Press et al.,2007)进行最大化。该算法的详细描述见附录O。这里我们概述整个流程的要点。
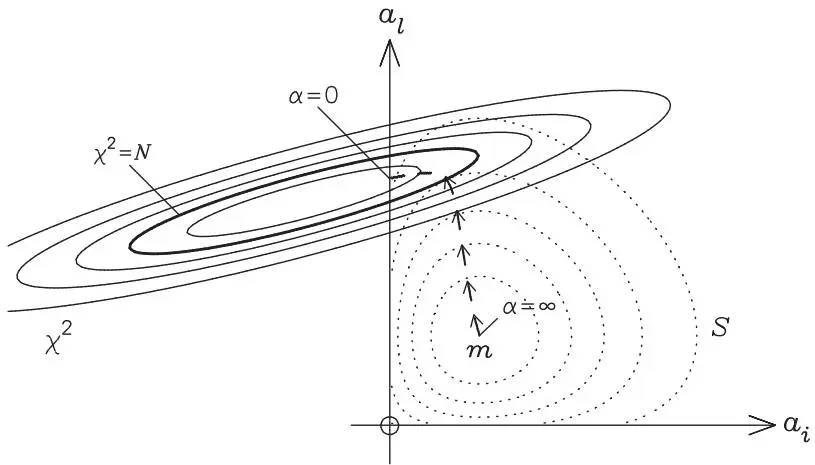
图12.2 解轨迹的示意图。它从默认模型 m 开始,沿着 $\alpha$ 的小步长方向移动,力求在尽可能保持熵 S 较大的同时减小 $\chi^{2}$(摘自 Sivia and Skilling (2006))。
一方面,寻找 Q 的最大值很简单,因为它是唯一的;但另一方面,它又很棘手,因为最大值较为平缓。这种平缓性反映了 $N_{\mathrm{good}} \ll N$。然而,最大化方法并非直接应用于原始参数 $A_{i}$,而是应用于问题变换到所谓的主子空间(dominant subspace)后衍生出的少量新参数 $u_{i}$。
通常,可能有大约一千个 $\bar{G}_{i}$ 值,而 $A_{i}$ 的个数是这个数量的几倍。如果我们对核函数转置进行奇异值分解(singular value decomposition)(Golub and Loan,1989;Press et al.,2007),即 $K^{T} = U \cdot D \cdot V^{T}$,其中 U 是 $L \times N$ 正交矩阵,D 是 $N \times N$ 对角矩阵,V 是 $N \times N$ 正交矩阵,那么我们会发现 D 的大部分对角元素(即按从大到小排列的奇异值 $d_{i}^{2}$)会失去全部或几乎全部的数值精度。假设 s 是保留下来的精确奇异值的个数,那么标准做法是使用分解 $K^{T} = \bar{U} \cdot \bar{D} \cdot \bar{V}^{T}$,其中 $\bar{U}$ 是 $L \times s$ 矩阵,通过只保留原始 U 矩阵的前 s 列得到;$\bar{D}$ 是 $s \times s$ 对角矩阵,通过只保留原始 D 的前 s 行和前 s 列得到;$\bar{V}$ 是 $N \times s$ 矩阵,通过只保留原始 V 的前 s 列得到。s 的值通常小于 10。
借助这种分解,有
$$ {\bar{G}} = K \cdot A \to ( {\bar{U}}^{T} \cdot{\bar{G}} ) = {\bar{D}} \cdot ( {\bar{V}}^{T} \cdot A ) .\tag{12.40} $$虽然此表达式并不代表具体实施步骤,但它确实表明,核的严重病态性将搜索空间的有效维数(即全局最大值的潜在参数空间)降低至 s 或更小。这就是主子空间(dominant subspace)。它还表明,该空间中“良好”参数的数量也为 s,即 $( V^{T} \cdot A )$ 的元素个数。Levenberg-Marquardt 方法(牛顿法的一个变体)应用于这个维数主要由核的主子空间维数决定的更小空间中。参考 Bryan (1990),我们采用如下参数化的谱函数:
$$ A_{i} = m_{i} \exp \left( \sum_{j = 1}^{s} \bar{U}_{i j} u_{j} \right)\tag{12.41} $$并且 $Q$ 相对于 s 个参数 $u_{i}$ 进行最大化。由于主子空间的维数很小,对于给定的 $\alpha$ 值,该最大化过程执行得很快。
我们可以使用此数值过程来寻找给定 $\alpha$ 下 $Q$ 的最大值,通过对 $\frac{1} {2} \chi ( \alpha ) - N$ 应用二分法(bisection technique)来获得约束拟合(历史最大熵解)。我们只需从可接受的小 $\alpha$ 值和大 $\alpha$ 值及其中点值开始,然后连续对半分割区间,直到定位到包含 $\scriptstyle{\frac{1}{2}} \chi^{2} - N = 0$ 的区间。收敛速度很快。贝叶斯约束拟合(经典最大熵)需要在使 $P ( \alpha | \bar{G} )$ (12.33) 最大化的 $\alpha$ 值处求 $Q$ 的最大值。将此最大值的线性搜索(Press 等人,2007)与最大化 $Q$ 的过程结合起来是直接的。平均谱方法需要数值计算一个积分。辛普森法则(Simpson's rule)效果很好。
为了便于讨论,在算法 41 中,我们给出了计算过程的简化描述。说其简化,是因为它不显式计算三种解中的任何一种,而是计算求解它们所需的信息。生成的信息是:对于给定 $\alpha$ 值,使 $Q ( \alpha )$ 最大化的 $A ( \alpha )$,失配统计量 $\chi^{2} ( \alpha )$,以及与 $A(\alpha)$ 相关的概率 $P ( \alpha | \bar{G} )$。通过 $\chi^{2} ( \alpha )$ 关于 $\alpha$ 的曲线图,可以简单估计使 $\chi^{2} \approx N$ 的 $\alpha$ 值。类似地,通过 $P ( \alpha | \bar{G} )$ 关于 $\alpha$ 的曲线图,可以估计使条件概率最大化的 $\hat{\alpha}$。然后,从这个表格中读取约束贝叶斯解 $A ( \hat{\alpha} )$。有了这些表格,估算积分 (12.35) 也变得直接。然而,这种简化的求解方法不能替代上一段中提到的那些过程。
算法 41 核心解析延拓。 输入:输入 $\bar{G}_{i} , C_{i j} , K_{i j} , A_{i} , m_{i} .$ 和 $\omega_{i}$。指定 $P ( \alpha )$ 对角化 C 并将 $\bar{G}$ 和 $K^{T}$ 变换到此基; 对 $K$ 执行奇异值分解并确定主子空间的大小。将 $\bar{G}$ 变换到此基 (12.40); 求解 (12.41) 以获得一组初始参数 $u_{i}$; 选择一个大的起始 $\alpha$,一个递减量 $\Delta \alpha .$,以及 α 值的数量 N; for $i = 1$ to $N$ do 找出使 Q(α) 最大化的 $u_{i}$ (附录 O); 根据 (12.41) 计算 $A_{i} ( \alpha )$ 计算 $\chi^{2} ( \alpha )$ 计算 $P ( \alpha | \bar{G} )$ α $ \alpha - \Delta \alpha$ end for 返回 $A_{i} ( \alpha ) , \chi^{2} ( \alpha )$ 和 $P ( \alpha | \bar{G} )$ 作为 $\alpha$ 的函数。
在算法中,我们看到最初的步骤是输入在分析的“数据鉴定”步骤中生成的信息,并将其变换以供最小化过程使用。我们首先定义一个 $\tau$ 和 $\omega$ 值的网格来离散化积分方程 (12.38),注意核中可能存在的对称性。同一个网格将 $A(\omega)$ 和 $m ( \omega )$ 离散化为该网格上区间上的概率。我们还需要选择先验概率 $P ( \alpha )$,通常是平坦先验(flat prior)或杰弗里斯先验(Jeffrey's prior)。
判定数据质量的关键在于准确估计协方差矩阵 (C)。最大化算法的第一步是将 (C) 对角化,然后将格林函数数据和核变换到该空间。接下来,通过奇异值分解对变换后核的转置进行分解,并确定主子空间的维数 (s)。由此分解得到的矩阵 (\bar{U})(用于 (12.41) 中),结合对 (A) 的初始猜测和默认模型的选择,为算法提供了一个起点 (u),该算法针对一系列递减的 (\alpha) 值最大化 (Q(\alpha))。附录 O 描述了一种专门形式的 Levenberg-Marquardt 方法来实现这一点。它与牛顿法在变分蒙特卡洛方法(第 9.3 节)中用于优化试探波函数的方法类似,但更复杂,因为它利用了问题的不适定性使得有效参数空间远小于被拟合参数数量这一事实。一旦找到最大化 (Q) 的 (u),就可以简单地找到相应的 (A) 并计算 (\chi^{2}(\alpha)) 和 (P(\alpha|\bar{G}))。该 (u) 值被用作求解更小 (\alpha) 值时的起点。算法会返回保存的 (\alpha)、(A_{i}(\alpha))、(\chi^{2}(\alpha)) 和 (P(\alpha|\bar{G})) 值。
计算所有这三种解为平均谱结果的置信度提供了一个比较基础。我们还可以做其他几件事。一是研究如果使用更少或更多统计独立的测量值,解会如何变化。另一是减少所使用的 (\tau) 值的数量。虚时格林函数是非常平滑的 U 形曲线。这种行为意味着连续的 (\tau) 值是相关的。自然的倾向是通过增加 (\tau) 值的数量来改善解。然而,由于相关性,增加 (\tau) 值的数量只会缓慢地为解添加新信息。
- 在解相对于数值输入的质量稳定之后,我们过程的第三步也是最后一步是评估解相对于默认模型的敏感性的可接受性,并估计其误差。结果是否具有默认模型中不存在的特征,或者是否缺少这样的特征?如果使用更多或更少的数据,情况会如何变化?如果结果和模型具有相同的特征,那么使用更多或更少的数据结果会如何变化?好的解对模型的选择表现出相对的独立性。如果我们改变模型,结果会如何变化?例如,如果模型是位于谱中可能预期出现单一峰位置的高斯分布,我们可以探究如果我们改变该高斯分布的峰值位置和宽度,结果会有多大变化。平坦默认模型是我们对先验知识所做的最少承诺。如果我们从一个更具物理动机的模型切换到一个平坦模型,会有什么差异?我们是否认为这些差异是显著的?虽然默认模型可以用于表示我们对解的先验知识状态,但信息量过多的模型(例如,精确解)可能会适得其反。在没有数据的情况下,解默认为模型。数据将解从模型推向与数据一致的众多可能结果之一。如果数据不支持模型的细节(或精确解),结果可能难以接受。
我们可以进行一种有限形式的误差估计。我们需要放弃“误差棒”的概念。由于我们不知道点之间的相关程度,我们无法估计与 (A_{i}) 单个值相关的误差,3 但我们可以估计在某个频率区间上积分的函数 (f(\omega)A(\omega)) 的误差。我们回顾后验概率 (12.24) 和谱密度协方差 (12.31) 的定义。利用这个协方差,我们可以通过下式计算与测量值 [ F = \int d\omega f(\omega) A(\omega) ] 相关的误差,其中 (f(\omega)) 是某个频率函数: [ \left. F^{2} \right. = \int \int d\omega d\omega^{\prime} f(\omega) f(\omega^{\prime}) \left. \delta A(\omega) \delta A(\omega^{\prime}) \right. .\tag{12.42} ]
这是从二次近似推导出来的:$P \left( A | {\bar{G}} \right) \propto e^{- {\frac{1} {2}} \delta A^{T} {\cdot} \nabla \nabla Q {\cdot} \delta A}$ 。在列文伯格-马夸尔特极大化收敛后,我们可以很容易地从Hessian矩阵的逆(附录O,(O.3))来近似估计期望值 $\langle \delta A \delta A \rangle$ 。如果函数 $f ( \omega )$ 为单位函数,那么我们就可以估计与 $A ( \omega )$ 各区域相关的误差。这对于确立解的峰值和肩台的置信度很有用。
12.6 评注#
诚然,我们的讨论一直是抽象的。正如我们所指出的,几篇综述对此类方法进行了详细的案例研究(Jarrell 和 Gubernatis, 1996; Jarrell 等人, 2008)。我们的意图是为这些方法的基础提供更多细节,并强调其中的假设和近似。
在讲述中,我们选择了用不同于其原始表述的名称来描述这三种基于贝叶斯公式的解。通常,“最大熵方法”一词被用于所有这三种方法,掩盖了它们之间的差异,并使得实际使用的是哪一种变得模糊不清。这三种解的历史发展是一个渐进序列,旨在完善对参数 $\alpha$ 的处理。从一个角度来看,$\alpha$ 是一个拉格朗日乘子,而在几乎所有受约束的最小二乘问题中,确定这样的乘子都是一个挑战。我们使用术语“平均谱方法”在精神上与多位作者提出的平均谱方法相似,但在细节上有所不同,例如 Syljuasen (2008) 提出的解为:
$$ \langle A \rangle = \frac{\int{\mathcal{D}} A A P ( A | {\bar{G}} )} {\int{\mathcal{D}} A P ( A | {\bar{G}} )} . $$通常,这些方案中的平均值通过蒙特卡洛评估积分来计算,并使用不同的策略(有时是特设的策略)来确定α。Fuchs等人(2010)对其中许多问题进行了综述和讨论。在许多方面,更广泛的问题在于更好地估计证据。我们对它进行了近似。通过蒙特卡洛(或其他方法)进行这种估计是贝叶斯分析中的一个活跃研究课题(Friel and Wyse, 2012)。嵌套抽样方法已在某些学术界得到广泛使用(Sivia and Skilling, 2006,第9章)。
文献中还可以找到所述三种解决方案的其他变体和替代方案。限于篇幅,此处无法对其逐一评述和评估。总体而言,这些出版物旨在解决该过程感知到的复杂性、其产生平滑结果的趋势,以及在处理多峰结构和高频峰值方面的困难。显然,所描述的过程并非绝对,但需要谨慎区分它们与针对更具体问题或带有捷径和误解的替代方案。毫无疑问,这些求解过程并非黑盒子;也就是说,将量子蒙特卡洛输出直接输入其中任何一个都不会自动产生可接受的结果。在某种意义上,这三个过程都是假设,可通过改进输入(量子蒙特卡洛数据和先验信息)、近似和假设来检验。希望刚刚完成的讨论能够提供理解和洞察力,以评估过去并促进未来的进步。
上述分析对多个被积函数进行了高斯近似,从而得到了积分的精确表达式。主要目的是深入理解导致求解困难的原因。其结果是能够开发出一种在极少的计算机时间内运行的算法。所提出的解析延拓蒙特卡洛方法没有这些近似,但所需的计算机时间占了生成量子蒙特卡洛数据所需时间的很大一部分。如果高斯近似失效,那么数值算法可能产生不可靠的结果,而蒙特卡洛解决方案是唯一的希望。我们注意到,在另一个领域,针对一个完全不同的问题,已有这些近似失效的报告(Skilling, 1998)。
贝叶斯方法和最大熵原理已被用于多种量子蒙特卡洛场景,其目的不仅仅是寻找谱密度。我们注意到该方法在提取热力学量(Huscroft et al., 2000)、基态能隙(Cafferel and Ceperley, 1992)和激发态(Blume et al., 1997, 1998)中的应用。关于存在符号问题时解析延拓的讨论见Jarrell et al. (2008)。
推荐阅读#
M. Jarrell and J. E. Gubernatis, “Bayesian inference and the analytic continuation of imaginary-time quantum Monte Carlo data,” Phys. Rept. 269, 133 (1996).
D. S. Sivia and J. Skilling, Data Analysis: A Bayesian Tutorial (Oxford University Press, 2006).
习题#
12.1 在归一化和均值已知的约束下,通过最大化熵会得到什么分布函数?回忆一下,如果约束条件还包括方差,则会得到高斯分布。
12.2 通过最大化熵 ${\boldsymbol{S}} =$ $- \textstyle \sum_{i = 1}^{6} p_{i}$ log $p_{i}$,并满足约束条件 $\textstyle \sum_{i = 1}^{6} p_{i} = 1$ 和 $\textstyle \sum_{i = 1}^{6} i p_{i} = 3.5$,为骰子的每个面分配一个概率 $p_{i}$。后者是当六个面等概率出现时,面值的平均值。
- 如果均值变为 $3.5 \pm 0.5$,解会如何变化?
- 任何对均值的先验知识是否都会使所有 $p_{i}$ 大致为 $1/6$?
12.3 构造一个具有两个显著峰值的离散概率 $p = ( p_{1} , p_{2} , . . . , p_{N} )$,并将默认模型 $m = ( m_{1} , \ldots , m_{N} )$ 设置成与之相等。固定 $m$ 不变,对 $p$ 的指标进行排列,并研究当排列后 $p$ 中的峰值位置相对于 $m$ 中的峰值位置移动时,$\begin{array} {r} {S = - \sum_{i} p_{i} \ln ( p_{i} / m_{i} )} \end{array}$ 的值如何变化。注意,$S^{\prime} = - \textstyle \sum_{i} p_{i}$ ln $p_{i}$ 对于排列是不变的,并且当 $p = m$ 时,$S$ 取最小值。
12.4 考虑反问题
$$ \left( \begin{array} {c} {11} \\ {2} \end{array} \right) = \left( \begin{array} {c c} {10} & {1} \\ {1} & {0.1} \end{array} \right) \left( \begin{array} {c} {x_{1}} \\ {x_{2}} \end{array} \right) , $$其中 $x_{1}$ 和 $x_{2}$ 已知为正数,但未归一化,并且 $x_{1}$ 的标准差为0.01,而 $x_{2}$ 的标准差为1。使用平坦的默认模型,将 $x_{1}$ 和 $x_{2}$ 的精确值与通过二次近似 $S$ 获得的、最大化 $\begin{array} {r} {Q = \alpha S - \frac{1} {2} \chi^{2}} \end{array}$(作为 $\alpha$ 的函数)的值进行比较。二次近似将最大化问题简化为线性问题。使用二次先验概率的方法称为吉洪诺夫正则化(Tikhonov regularization)。
12.5 使用 $S$ 的精确表达式重复上述问题。
12.6 证明熵的另一种表达式
$$ S ( A ) = \sum_{i} \bigg [ A_{i} - m_{i} - A_{i} \log \bigg ( \frac{A_{i}} {m_{i}} \bigg ) \bigg ] ,\tag{12.43} $$允许放宽对 $A_{i}$ 和 $m_{i}$ 的归一化条件。
12.7 证明多元高斯分布的熵为 $\scriptstyle{\frac{1} {2}} \ln [ ( 2 \pi e )^{N}$ det C]。
12.8 三分之一的袋鼠有蓝眼睛,四分之一的袋鼠是左撇子。仅基于这些信息,既是蓝眼睛又是左撇子的袋鼠比例是多少(Gull and Skilling, 1984)?仅凭这些信息无法得出唯一答案。基于在可用信息的约束下,使用 $( 1 ) - \textstyle \sum_{i} p_{i}$ 和 $( 2 ) - \textstyle \sum_{i} p_{i}^{2}$ 来约束问题,选择一个答案。我们事先不知道惯用手和眼睛颜色之间存在相关性,因此合理地期望,对于给定的眼睛颜色,左撇子和右撇子袋鼠的概率相等。哪种函数形式不会引入不属于先验信息的相关性?现在用 $(1) \ \textstyle \sum_{i} \log p_{i}$ 和 (2) $\sum_{i} {\sqrt{p_{i}}}$ 进行约束。相关性如何变化?