第10章 · 幂方法#
用于寻找基态的量子蒙特卡洛版本的幂方法有不同名称,包括投影子方法(projector method)、扩散蒙特卡洛(diffusion Monte Carlo)和格林函数蒙特卡洛(Green’s function Monte Carlo)。这些量子蒙特卡洛方法主要是对经典问题方法的采纳。我们总结了确定性幂方法的基础,详述了蒙特卡洛幂方法的关键特征,并将这些概念置于量子基态计算的背景中。我们通过概述允许计算少数激发态的幂方法来结束本章。在激发态计算中,我们会遇到符号问题,这将在第11章中更详细地讨论。本章的方法和技术非常通用,最适用于玻色子系统,以及不遭受符号问题的费米子系统和量子自旋系统。
10.1 确定性直接和逆幂方法#
幂方法已有超过一个世纪的历史。作为一种确定性方法,它最初与收缩技术(deflation technique)结合(Meyer, 2000; Stewart, 2001b),作为计算小矩阵所有特征值和特征向量的一种方法。如今,其确定性用途主要限于涉及非常大、稀疏矩阵的特殊应用。其中许多应用是研究量子晶格模型,因为相应的哈密顿矩阵通常非常稀疏。在这些应用中,我们最初或许可以在计算机内存中存储相对较少的非零矩阵元素以及所有向量。很快,由于现在无疑已熟悉的、决定哈密顿矩阵阶数从而决定向量大小的基态数量呈指数增长,我们达到了计算机内存限制只允许存储几个向量的点,并且需要即时计算矩阵元素。当我们遇到的问题甚至无法存储一个向量的所有分量时,幂方法作为蒙特卡洛过程的表达式是我们唯一的选择。借助它,我们可以计算少数极值特征值,即少数最大或最小特征值。
该方法的数学基础很简单。我们已经在第2.4.2节简要讨论过。如果$\{( \lambda_{i} , \vert i \rangle ) , i = 1 , 2 , \ldots , N \}$是A的特征对集合,特征值排序为$| \lambda_{1} | > | \lambda_{2} | \geq \cdot \cdot \cdot \geq | \lambda_{N} |$,并且态$| \phi \rangle$的形式为$\begin{array} {r} {| \phi \rangle = \sum_{i} w_{i}^{0} | i \rangle} \end{array}$,那么对于算子或矩阵A
$$ A^{n} | \phi \rangle = \lambda_{1}^{n} \left[ w_{1}^{0} | 1 \rangle + \sum_{i = 2}^{N} \left( \frac{\lambda_{i}} {\lambda_{1}} \right)^{n} w_{i}^{0} | i \rangle \right] .\tag{10.1} $$通过使n足够大,我们从$| \phi \rangle$中投影出占优态|1>,因为当$n \to \infty$时$( \lambda_{i > 1} / \lambda_{1} )^{n} \to 0$。给定初始态$| \phi \rangle$和算子A,幂方法(Meyer, 2000; Stewart, 2001b)通过迭代以下步骤达到大n的极限:
$$ \begin{array} {l} {| \psi \rangle = A | \phi \rangle ,} \\ {| \phi \rangle = | \psi \rangle / \| \psi \| .} \end{array}\tag{10.2} $$收敛后,A 的占优特征对 $( \lambda_{1} , | 1 \rangle )$ 即为 $( \| \psi \| , | \phi \rangle )$。任何范数选择均可。例如,我们常使用 $\begin{array} {r} {\| \phi \| _{\infty} = \sum_{i} | w_{i}^{0} |} \end{array}$ 。该方法假设初始态与占优态有重叠,即 $w_{1}^{0} \neq 0$ 。收敛到占优态的速度由 $| \lambda_{2} | / | \lambda_{1} |$ 控制。
为了后续与我们的蒙特卡洛幂法进行比较,我们在算法33中给出了一个更详细的确定性方法。通常的做法是平移特征值谱的原点,用 $A - \sigma I$ 代替 A 进行迭代。此时收敛到离 $\sigma$ 最远的特征值,即最大或最小的特征值。选择 $\sigma$ 就相当于对这两个特征值中哪一个是我们想要的目标进行良好猜测。加入平移后,收敛速度变为 $| \lambda_{2} - \sigma | / | \lambda_{1} - \sigma |$ 或 $| \lambda_{N - 1} - \sigma | / | \lambda_{N} - \sigma |$ 。猜测越接近精确答案,收敛越快。
算法33 平移幂法。 输入: 矩阵 A,平移 σ,收敛准则 ,初始态 $| \phi \rangle$ norm = ||A|| ; |φ ← |φ/ ||φ|| ; 重复 |ψ = A|φ ; λ = <φ|ψ> ; |r = |ψ − λ|φ ; |φ ← |ψ − σ |φ ; |φ ← |φ/ ||φ|| ; 直至 ||r|| ≤ (norm). 返回特征对 (λ, |φ).
如上所述,算法33通过每一步调整占优特征值的估计,并每一步减小残差态 $| r \rangle = | \psi \rangle - \langle \psi | \phi \rangle | \phi \rangle$ 的范数,部分地掩盖了瑞利商(Rayleigh quotient)(9.4) 的使用。瑞利商提供了比基于范数的估计更精确的特征值估计。在变分蒙特卡洛方法(第9.1节)中,我们使用了相同的商和残差来提供特征值的上界。这里,我们驱动的迭代不是走向一个界限,而是精确答案。
第二种幂法是逆幂法(inverse power method)(Meyer, 2000; Stewart, 2001b)。该方法中,使用某个初始态 $| \phi \rangle$ 和平移矩阵 $A - \sigma I$,我们迭代
$$ \begin{array} {l} {| \psi \rangle = ( A - \sigma I )^{- 1} | \phi \rangle ,} \\ {| \phi \rangle = | \psi \rangle / \| \psi \| .} \end{array}\tag{10.3} $$与直接幂法一样,迭代收敛到一个占优特征对,但这次是 $( A - \sigma I )^{- 1}$ 的占优特征对,即 $A - \sigma I$ 的特征值最接近零的那个特征对。
由于知道 $A - \sigma I$ 的逆等价于知道问题的解,我们转而迭代以下步骤:
$$ {\begin{array} {r l} & {{\mathrm{S o l v e ~}} ( A - \sigma I ) | \psi \rangle = | \phi \rangle ,} \\ & {| \phi \rangle = | \psi \rangle / \| \psi \| .} \end{array}}\tag{10.4} $$这似乎同样有问题,因为每次迭代的第一步都需要求解一个线性方程组。然而,求解线性系统比求逆矩阵更高效也更稳定。
算法34给出了逆幂法的详细版本。它在每个迭代步骤中使用相同的基态能量初始较好估计。我们通常采用带部分主元的高斯消去法(Stewart, 2001a)来求解线性方程组。该方法的第一步,也是最消耗计算时间的步骤,是对矩阵 $A - \sigma I$ . 进行 LU 分解(Stewart, 2001a)。通过固定我们的猜测值 $\sigma .$ ,我们只需分解矩阵一次,并且可以在迭代循环之外完成。然后,在循环中,我们通过计算量较小的前代和回代方法(Stewart, 2001a)来求解线性系统。
算法34 移位逆幂法。 输入:矩阵 A,移位 σ ,收敛准则 ,非零初态 |φ。 范数 = ||A||; 对 A − σ I 执行 LU 分解; 重复 求解 (A − σ I)|ψ = |φ; |ϕ = |ψ / ||ψ||; |χ = |φ / ||ψ||; μ = <ϕ|χ> ; λ = σ + μ; |r = |χ − μ|ϕ; |φ = |ϕ; 直到 ||r|| ≤ (范数)。 返回特征对 (λ, |φ)。
10.2 蒙特卡罗幂法#
刚刚结束的对幂法的讨论描述了标准的确定性实现。我们表示为 |i 的向量可以是某个经典单位向量或某个量子基态。类似地,A 可以是矩阵或算子。
确定性幂法的核心计算是对于稠密或稀疏矩阵以及稠密向量的常规矩阵-向量乘法。蒙特卡罗幂法在那些我们能够即时生成(希望是稀疏的)矩阵元素的情况下最为有用。在这些实现中,我们在一个迭代步骤间传递的不是所有的向量分量,而是其中的一个子集,我们称之为游走子(walker)。一个游走子是一个属性元组,至少包含(权重,状态),其中“状态”是指定某个基向量的标签。将分量子集看作一个游走子堆栈是很有用的。换句话说,我们让堆栈以这样一种方式表示一个向量,即该表示在游走子数量趋于无穷时是渐进精确的。在模拟过程中,我们从一个堆栈中弹出(pop)游走子,并将它们推入(push)到一个新堆栈或原来的堆栈中。将符号 $w_{i}$ 解释为不仅仅是向量的第 i 个分量,而且还是处于标记为 i 的状态下的游走子 i 的权重,这变得很方便。使用堆栈数据结构便于阐述,但对于实现并非必需。
确定性幂法的计算和内存瓶颈是向量与矩阵的乘法。在蒙特卡罗幂法中,我们用蒙特卡罗估计来替代精确的(确定性)乘法。每个蒙特卡罗步骤(一次矩阵-向量乘法)都会生成结果向量分量的一组样本。然后,迭代根据这个样本生成另一个样本,其方式是,通过对多个步骤和足够数量的游走子进行迭代平均,来估计完整的乘法。
用蒙特卡罗程序替代这些乘法需要将特征值的估计替换为与我们确定性使用的估计量不同的估计量,并添加额外的程序以使采样高效。在本节中,我们仅描述通过蒙特卡罗采样进行乘法和求解线性系统的方法。在下一节(第10.3节)中,我们将讨论效率问题。当这部分讨论完成后,我们将转向采用矩阵-向量乘法采样的基本类型的量子蒙特卡罗幂法(第10.4节)。然后,在本节之后的几节中,我们将通过讨论基态能量、关联函数以及激发态的估计量来完成对量子幂法的讨论。
10.2.1 蒙特卡罗直接幂法#
此时,我们回顾第2.4.2节中关于马尔可夫链蒙特卡洛 (Markov chain Monte Carlo) 的讨论。通过马尔可夫链采样是一种蒙特卡罗幂法。在马尔可夫链蒙特卡洛中,我们投影到一个平稳分布 (stationary distribution),该分布是定义该链的随机矩阵 (stochastic matrix) 的右特征向量。由于该矩阵是随机的,我们知道其占优特征值 (dominating eigenvalue) 为1。在细致平衡 (detailed balance) 算法中,我们预先指定了平稳分布,这相当于设计一个随机矩阵,使得该分布是其右特征向量。现在我们关注的问题中,无法使用细致平衡,因为我们想要估计一个先验未知的特征值,并同时计算其他量相对一个未知平稳分布的平均值,即相对于我们矩阵的未知右特征向量的平均值。我们仍然需要构造一个转移概率矩阵 (transition probability matrix)。
如果矩阵 $A$ 没有负矩阵元,构造转移概率矩阵是直接的。为简化符号,我们现在将移位项 $\sigma I$ 吸收进 $A$ 的定义中。即使 $A$ 的所有元素 $A_{i j}$ 都是非负的,$A$ 的矩阵表示通常也不会得到一个随机矩阵。然而,我们总是可以定义一个随机矩阵 $P$ 的元素 $P_{i j}$,使其与 $A$ 的元素 $A_{i j}$ 通过以下方式关联1:
$$ A_{i j} = w_{i j} P_{i j} , $$其中 $\sum_{i} P_{i j} = 1$,$P_{i j} = 0$ 仅当 $A_{i j} \geq 0$,且 $w_{i j} > 0$。
我们如何选择 $P_{i j}$ 以及如何从中采样?$P_{i j}$ 和 $w_{i j}$ 常见且有效的选择2是3:
$$ P_{i j} = \frac{A_{i j}} {\sum_{i} A_{i j}} , \quad w_{i j} = \sum_{i^{\prime}} A_{i^{\prime} j} \text{(与} i \text{无关)} . $$通常,$w_{i j}$ 被称为权重转移乘数 (weight transfer multiplier)。一个明显的假设是,从给定状态 $| j \rangle$,我们可以确定(或查找)所有可能的 $P_{i j}$ 值。为了对 $P_{i j}$ 进行采样——在直接幂法中,我们将其视为从状态 $| j \rangle$ 到状态 $| i \rangle$ 的转移概率——我们使用第2.3节中的采样概念。例如,如果从给定状态 $| j \rangle$ 出发,可能的状态 $| i \rangle$ 数量相对较少,我们可以计算累积概率并使用算法1或2来选择新的状态 $| i \rangle$。如果从任何给定状态出发的可用状态数量很大,那么诸如缝合算法 (sewing algorithm)(Booth and Gubernatis, 2009a)等其他技术可能有用。另一种方法是将 $A$ 表示为稀疏矩阵的乘积,例如 $A = B_{L} B_{L - 1} \cdot \cdot \cdot B_{1}$,然后分 $L$ 个阶段对转移矩阵进行采样。
为了通过蒙特卡罗采样 (Monte Carlo sampling) 估计矩阵-向量乘法
$$ | \psi \rangle = A^{n} | \phi \rangle $$我们假设初始状态为 $| \phi \rangle = \sum_{i} w_{i}^{0} | i \rangle$,其中 $w_{i}^{0} > 0$ 且 $\sum_{i} w_{i}^{0} = 1$。那么,经过 $n$ 次乘法后,
$$ | \psi \rangle = \sum_{i_{1} , . . . , i_{n}} A | i_{n} \rangle \langle i_{n} | A | i_{n - 1} \rangle \cdot \cdot \cdot \langle i_{2} | A | i_{1} \rangle w_{i_{1}}^{0}\tag{10.5} $$因此,$| \Psi \rangle = \sum_{i} \langle i | \psi \rangle | i \rangle = \sum_{i} w_{i} | i \rangle$ 的第 $i$ 个分量简单地就是
$$ w_{i} = \sum_{i_{1} , i_{1} , . . . , i_{n}} A_{i i_{n}} A_{i_{n} i_{n - 1}} \cdot \cdot \cdot A_{i_{2} i_{1}} w_{i_{1}}^{0} > 0 .\tag{10.6} $$我们可以将最后一个方程重写为
$$ w_{i} = \sum_{i_{1} , i_{2} , \ldots , i_{n}} w_{i i_{n}} w_{i_{n} i_{n - 1}} \cdot \cdot \cdot w_{i_{2} i_{1}} w_{i_{1}}^{0} P_{i i_{n}} P_{i_{n} i_{n - 1}} \cdot \cdot \cdot P_{i_{2} i_{1}} ,\tag{10.7} $$这使得我们可以将 $w_{i}$ 解释为
$$ w_{i i_{n}} w_{i_{n} i_{n - 1}} \cdot \cdot \cdot w_{i_{2} i_{1}} w_{i_{1}}^{0}\tag{10.8} $$相对于联合概率 (joint probability)
$$ P ( i , i_{n} , i_{n - 1} , \ldots , i_{1} ) = P_{i i_{n}} P_{i_{n} i_{n - 1}} \cdot \cdot \cdot P_{i_{2} i_{1}} .\tag{10.9} $$的期望值 (expectation value)。
这个联合分布自然具有马尔可夫因子化分解的性质。$w_{i}$ 的正性使人们不仅将其视为某个基{|i⟩}下$| \psi \rangle$的分量,也将其视为权重。
若我们将初始状态的第$i_{1}$个分量视为一个随机游走者,那么我们可以将和式(10.7)中每一项的指标集合$\{i , i_{n} , i_{n-1} , \ldots , i_{1} \}$解释为定义了一条权重路径$\gamma$(长度为$n$),该游走者通过这条路径在概率空间中行走,并将求和解释为对所有可能路径的求和,表示如下
$$ w_{i} = {\langle w_{i} ( \gamma ) \rangle}_{\gamma} , $$其中$w_{i} ( \gamma )$ 是(10.8),即沿着特定路径$\gamma^{4}$的权重转移乘积累积。蒙特卡罗任务是为主要游走者采样重要路径。
我们通过一个游走者集合来逐步采样这些路径。第一步,我们从由$w^{0}$定义的分布中采样M个随机游走者,这可能导致一个游走者群体中某个状态被多次表示。接下来,我们逐一处理这个样本中的每个游走者。如果该游走者处于状态$| j \rangle$,其当前权重为$w_{j}$,那么我们从$P_{i j}$中采样一个新状态$| i \rangle$,并将该游走者以权重$w_{i} = w_{i j} w_{j}$转移到状态|i⟩(将游走者推入一个新堆栈)。在处理完整个游走者群体(即原始堆栈中的所有游走者)后,我们完成了一个步骤,然后在新游走者群体(新堆栈)上重复此过程。根据设计,游走者数量为$M \ll N$,其中N是基的维数。
图10.1左侧的两个面板示意性地展示了确定性幂法中的矩阵-向量乘法步骤与通过采样执行的矩阵-向量乘法步骤之间的区别。图中,一列圆圈表示系统中所有可能的状态。当准确执行矩阵-向量乘法时,旧状态可能贡献给多个新状态,而一个新状态可能接收来自多个旧状态的贡献。矩阵的具体元素决定了新旧状态之间的连接方式。当通过蒙特卡罗方法执行矩阵-向量乘法步骤时,旧状态的一个样本通常以一对一的方式贡献给新状态的一个样本。根据其定义方式,$P$和A的非零元素具有相同的$i j$指标对,但在给定步骤中,我们不会使用所有这些非零元素。群体规模比可用状态的数量小几个数量级。由于这些规模很小,两个或多个旧状态贡献给同一个新状态的情况很少发生。
算法35详细描述了在直接幂法的蒙特卡罗实现中执行一次扫描(一次矩阵-向量乘法采样步骤)的一种方法。蒙特卡罗幂法的其他部分实际上与任何其他蒙特卡罗方法相同:我们初始化并执行若干步,直到达到平衡。在平衡阶段,我们在步进过程中定期进行测量。收集到足够数量的测量结果后,我们停止。
算法35 蒙特卡罗矩阵-向量乘法。 输入:游走者堆栈W以及计算(或查找)转移概率和权重转移矩阵P及w的过程。 初始化一个新堆栈$W^{\prime}$ 重复 从W中弹出一个游走者(处于状态|k⟩,权重为$w_{k}$); 从Pik中采样i; 更新权重wi = wikwk; 将一个处于状态|i⟩、权重为w的游走者推入$W^{\prime}$; 直到W为空。 返回$W^{\prime}$。
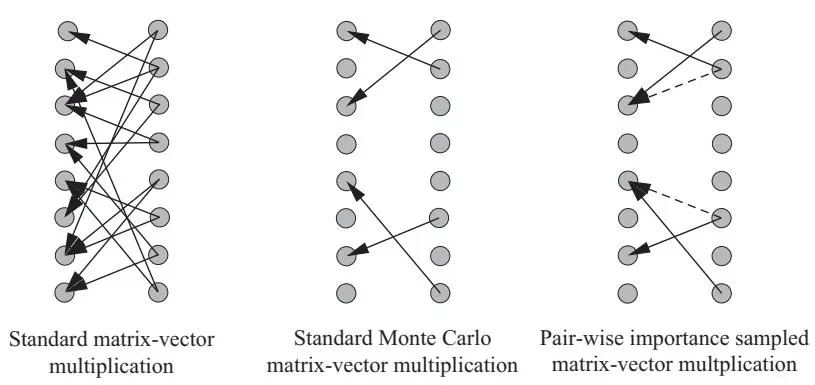
图10.1 矩阵-向量乘法。一列空心圆圈表示系统中的可能状态。当准确执行时,每个旧状态贡献给多个新状态,且一个新状态接收来自多个旧状态的贡献。当通过蒙特卡罗方法执行时,旧状态的一个样本贡献给新状态的一个样本,通常以一对一的方式进行。右侧面板在第10.6.2节中被引用。
我们监测蒙特卡洛幂法收敛到平稳的方式与任何其他马尔可夫链蒙特卡洛模拟相同。与确定性幂法不同,我们不显式监测残差范数的减小作为收敛度量(如同在确定性方法中所做的那样),因为我们只有向量分量的样本,缺乏足够信息计算两个不同向量的内积和向量减法。我们监测特征值估计量的收敛性。第10.5节将讨论特征值的估计量。我们注意到,蒙特卡洛算法需要在平衡阶段和测量阶段都引入一种新步骤:偶尔进行随机重构(stochastically reconfigure)。第10.3节将对此作进一步说明。
10.2.2 蒙特卡洛逆幂法#
现在我们转向在移位逆幂法的蒙特卡洛实现中求解线性方程组。为简化符号,我们再次将 $\sigma I$ 项吸收到 A 的定义中,但将 (10.4) 中的第一个方程改写为
$$ \left| \psi \right. = ( I - A ) \left| \psi \right. + \left| \phi \right. . $$引入额外定义 $B = I - A$,并在某个基矢下表示态和算子 B,例如 $\begin{array} {r} {| \psi \rangle = \sum_{i} w_{i} | i \rangle} \end{array}$,感兴趣的方程为
$$ w_{i} = w_{i}^{0} + \sum_{j} B_{i j} w_{j} . $$对该方程进行迭代,得到诺伊曼级数(Neumann series)
$$ w_{i} = w_{i}^{0} + \sum_{j} B_{i j} w_{j}^{0} + \sum_{j k} B_{i j} B_{j k} w_{k}^{0} + \sum_{j k l} B_{i j} B_{j k} B_{k l} w_{l}^{0} + \cdots ,\tag{10.10} $$我们将其更紧凑地重写为
$$ w_{i} = \sum_{k = 1}^{\infty} \sum_{i_{1}} \cdot \cdot \cdot \sum_{i_{k}} \delta_{i i_{k}} B_{i_{k} i_{k - 1}} \cdot \cdot \cdot B_{i_{2} i_{1}} w_{i_{1}}^{0} .\tag{10.11} $$在蒙特卡洛采样 (10.11) 中的任务比 (10.7) 更具挑战性。我们可以采用类似 (10.7) 的方式执行乘法,但需要增加一种方法对幂级数的项数进行“采样”。停止概率是实现此目的的手段。
为继续讨论,我们注意到,如果 B 的矩阵范数满足 $\| B \| < 1$,则诺伊曼级数收敛。矩阵范数的例子有 (Meyer, 2000)
$$ \| B \| _{1} = \operatorname*{max}_{i} \bigg ( \sum_{j} \big | B_{i j} \big | \bigg ) , \quad \| B \| _{\infty} = \operatorname*{max}_{i} \bigg ( \sum_{j} \big | B_{i j} \big | \bigg ) .\tag{10.12} $$矩阵范数小于1意味着矩阵的谱半径小于1。矩阵的谱半径定义了复平面上以原点为圆心的一个圆,矩阵的所有特征值都位于该圆上或内部。如果 B 的谱半径超过1,则需要对 B 进行缩放。
假设 $0 \leq B_{i j}$ 且 $\begin{array} {r} {0 < \sum_{j} B_{i j} < 1} \end{array}$,接下来我们定义
$$ B_{i j} = w_{i j} P_{i j} , \quad \sum_{i} P_{i j} = 1 - p_{j} , $$并将 (10.11) 重写为
$$ w_{i} = \sum_{k = 1}^{\infty} \sum_{i_{1}} \cdot \cdot \cdot \sum_{i_{k}} \delta_{i i_{k}} W_{k} p_{i_{k}} P_{i_{k} i_{k - 1}} \cdot \cdot \cdot P_{i_{2} i_{1}} ,\tag{10.13} $$其中
$$ W_{k} ( \gamma ) = w_{i_{k} i_{k - 1}} \cdot \cdot \cdot w_{i_{2} i_{1}} w_{i_{1}}^{0} / p_{i_{k}} .\tag{10.14} $$这里再次,$P_{i j}$ 是游走者从状态 $| j \rangle$ 转移到状态 $| i \rangle$ 的概率;不过,其第 i 行之和比1小 $p_{j}$。该量是在状态 $| j \rangle$ 停止的概率。
有几点需要注意。首先,要求 B 矩阵的所有元素非负,这是假设所考虑的问题没有符号问题。假设该矩阵的谱半径小于1以确保级数收敛,则意味着 $\textstyle \sum_{i} B_{i j} \ < \ 1$。此时,我们对 $P_{i j}$ 的选择完全可以就是 $B_{i j}$ 本身,这样权重传递乘子 $w_{i j}$ 的定义就为1。我们并不显式地将其设为1,而是保留它以希望对产生的程序结构有所启发。最后,我们将解解释为所有可能游走路径上的以下期望值:
$$ w_{i} = \langle W_{i} ( \gamma ) \rangle_{\gamma} .\tag{10.15} $$根据上述定义,我们按以下方式对 (10.13) 进行采样:同样逐步采样路径。第一步,我们从由 $w^{0}$ 定义的分布中生成 $M$ 个随机游走者(random walkers)。接下来,逐个处理该样本中的每个游走者。如果游走者处于状态 $| j \rangle$,当前权重为 $w_{j}$ 且 $p_{j} < \xi$,则我们采样 $P_{i j}$ 以获得新状态 $| i \rangle$,将游走者转移到状态 $| i \rangle$,通过 $w_{i} = w_{i j} w_{j}$ 更新其权重,然后重复此步骤。如果 $p_{j} > \xi$,我们将游走者的权重更新为 $w_{j} = w_{j} / p_{j}$,将游走者推入新堆栈(new stack),并终止其行走。然后,我们从原始堆栈中弹出一个新的游走者,重新开始整个过程。处理完整个游走者群体(即原始堆栈中的所有游走者)后,我们完成了一步,然后对新游走者群体(新堆栈)重复此过程。
上述过程以一种蒙特卡洛方法(Monte Carlo method)进行采样,该方法用于求解移位逆幂法(inverse shifted power method)中的线性方程组。对于蒙特卡洛直接移位幂法(Monte Carlo direct shifted power method)的讨论,我们需要添加随机重构(stochastically reconfigure)游走者并估计特征值的步骤。我们将在以下小节中讨论这两个主题。
另一种采样 (10.11) 的方法是从将其重写为以下形式开始:
$$ w_{i} = \sum_{k = 1}^{\infty} \sum_{i_{1}} \cdot \cdot \cdot \sum_{i_{k}} \mathcal{W}_{k} p_{i_{k}} P_{i_{k} i_{k - 1}} \cdot \cdot \cdot P_{i_{2} i_{1}} ,\tag{10.16} $$其中
$$ \mathcal{W}_{k} ( \gamma ) = \sum_{m = 1}^{k} W_{m} \delta_{i i_{m}} .\tag{10.17} $$现在我们的解变为
$$ w_{i} = \langle \mathcal{W}_{i} ( \gamma ) \rangle_{\gamma} . $$根据 Spanier 和 Gelbard (1969) 的工作,我们可以证明这个期望值与之前的 (10.15) 等价:
$$ \begin{array} {r l r} {\langle \mathcal{W}_{i} ( \gamma ) \rangle_{\gamma} = \displaystyle \sum_{k = 1}^{\infty} \sum_{i_{1}} \cdots \sum_{i_{k}} \left( \displaystyle \sum_{m = 1}^{k} W_{m} \delta_{i_{m}} \right) p_{i_{k}} P_{i_{i k - 1}} \cdots P_{i_{21}}} & \\ {= \displaystyle \sum_{m = 1}^{\infty} \displaystyle \sum_{k_{m}} \sum_{i_{1}} \cdots \sum_{k} W_{m} \delta_{i_{m}} p_{i_{k}} P_{i_{i k - 1}} \cdots P_{i_{2 i 1}}} & \\ {= \displaystyle \sum_{m = 1}^{\infty} \sum_{i_{1}} \cdots \sum_{k} W_{m} \delta_{i_{m}} P_{i_{m - 1}} \cdots P_{i_{2 i 1}}} & \\ {\displaystyle} & {\qquad \times \left\{p_{i_{m}} + \sum_{i_{m + 1}} p_{i_{m + 1}} P_{i_{m + 1}} + \sum_{i_{m + 2}} \sum_{k \in \mathcal{I}} p_{i_{m + 2}} P_{i_{m + 1}} P_{i_{m + 1} i_{m}} + \cdots \right\} .} \end{array} $$现在我们使用关系式
$$ p_{i_{m + 1}} = 1 - \sum_{i_{m + 2}} P_{i_{m + 2} i_{m + 1}} $$将花括号内的项压缩为 $1 - \operatorname*{lim}_{t \to \infty} P^{t}$,其中 $P^{t}$ 是转移矩阵的 t 次幂。由于 $P$ 的谱半径小于1,$\scriptstyle \operatorname*{lim}_{t \to \infty} P^{t} = 0$,因此我们可以将花括号内的项替换为1。表达式的其余部分与(10.13)相同。
(10.16)和(10.17)表明:在每一步中,我们克隆游走者,通过除以当前状态的停止概率来更新其权重,并将其推入新堆栈。然后让游走者执行下一步,直到实际终止被采样。简而言之,我们随着游走者的步进,累加对方程组解的贡献。有时,这种采样方式比前一种更高效。算法36详细描述了执行此过程的一种方法。
算法36 蒙特卡洛线性方程组求解器。
输入:游走者堆栈W以及停止概率和转移概率p与$P$.
初始化堆栈$W^{\prime}$;
重复
   从W中弹出一个游走者(处于状态$| k \rangle$,权重为$w_{k}$);
   抽取$\zeta$;
   当$\zeta < 1 - p_{k}$时循环
       设置$w \gets w_{k} / p_{k}$;
       将一个处于状态|k且权重为w的游走者推入$W^{\prime}$;
       根据$P_{m k}$采样m;
       设置$w_{m} = w_{m k} w_{k}$;
       设置$k = m$;
       抽取$\zeta$;
   结束循环
直到W为空。
返回$W^{\prime}$。
算法35在第二种蒙特卡洛方法中执行采样,该方法求解移位逆幂法中的线性方程组。与我们讨论直接移位蒙特卡洛幂法和求解线性方程组的第一种蒙特卡洛方法一样,我们需要添加一些步骤来随机重构游走者并估计特征值。
第二种采样方式是期望值方法(method of expected values)的一个实例(Spanier和Gelbard, 1969;Kalos和Whitlock, 1986)。期望值法是一种常见的降低平均值蒙特卡洛估计方差的方法。它指出,在某些条件下,精确完成部分估计,而不是让蒙特卡洛估计,可以降低整个结果的方差。在当前情况下,不是在游走者停止时记录其对解的贡献,而是观察到沿路径的每一步它都可能已经停止。我们在沿路径的每一步记录预期平均会发生的事情。
我们注意到,当确定性地使用幂法时,要求A(或线性系统问题中的B)没有负矩阵元素是不必要的。在蒙特卡洛幂法中,无论是直接法还是逆法,当$A_{i j}$为负时,在需要使用它来定义转移概率时,我们使用$A_{i j}$的绝对值,其符号会乘以权重转移因子$w_{i j}$。如果A没有负矩阵元素,则Perron-Frobenius定理(第2.4.2节;Meyer, 2000)适用,该定理指出,占优特征值必定是实数且为正,其在此基下的特征向量分量也必定是实数且为正。
在我们的算法中,我们将游走者推入堆栈,而不尝试合并那些处于相同状态的游走者。通常,它们处于相同状态是罕见事件。如果所有游走者都具有正权重,则它们会相长地合并。从某种意义上说,合并它们并没有太多好处。如果它们具有混合符号,则会相消地合并。在这种情况下,如果不合并它们,我们可能会失去重要的抵消效应。通常,我们必须添加一个额外的过程来处理混合符号的游走者。在第10.6节中,我们讨论了一种这样的方法,该方法最初是为格林函数蒙特卡洛方法(第10.4节)开发的,并已成功用于激发态计算。符号问题不仅仅是费米子问题,甚至不仅仅是量子问题。
10.3 随机重构#
在定义随机重构(stochastic reconfiguration)的含义之前,上述蒙特卡洛算法是不完整的。5 这个短语包含几个相互交织的概念。一个是确保遍历性,另一个是提高效率,第三个是方便计算。
问题在于,对游走子权重的连续更新会导致这些权重的取值产生很大差异:有些游走子会发展出非常大的权重,而另一些则变得非常小。少数几个大权重的游走子会导致仅仅通过少数几个状态来代表许多可能的状态。为了确保采样的遍历性,我们需要保证所有重要的状态都能被恰当访问。实现这一点的一种方法是,偶尔将一个大权重的游走子分割成若干个共享原权重的小权重游走子,从而限制任何单个游走子的权重累积。每个小权重游走子随后会沿着与原游走子不同的路径前进。这种分裂和终止会改变游走子种群的大小。因此,我们还需要确保种群不会变得过大或过小,这就需要一套控制种群规模的方法。控制任务和效率提升任务通常被整合到一个过程中。我们将这些有助于实现上述目标的蒙特卡洛技术的组合称为随机重构(stochastic reconfiguration)。它们会改变当前构型中游走子的构成。随机地、偶尔地进行这种重构,可以减少最终估算结果中出现不期望偏差的可能性。
随机重构程序分为两类。一类是逐一处理游走子,另一类是同时处理整个种群。对于直接幂算法,在迭代步骤结束时偶尔对整个种群进行重构是很自然的。在反幂法中,自然的方式是跟踪单个游走子直到其终止。因此,这里的游走子控制通常是个别且即时进行的。
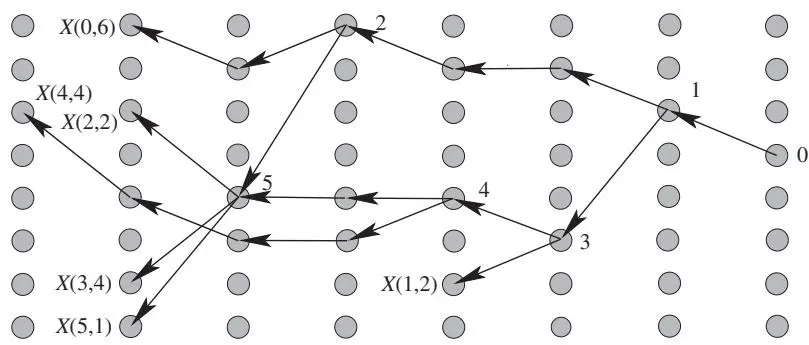
图 10.2 即时重构。一列圆圈表示系统中的可能状态,每一列表示幂方法一步之后的状态,方向从右向左。只考虑一个游走子。该游走子从标记为零的事件开始。在非零事件编号处发生分支,产生由该事件编号标记的新游走子。簿记符号 X(m, n) 标记一次游走的结束:m 是起始事件编号,n 是从起始点到终止点的步数。
图 10.2 和图 10.3 展示了这两种程序。在图 10.2 中,单个游走子从标记为零的事件开始。在每个其他编号的事件处发生分支,产生由该事件编号标记的新游走子。符号 X(m, n) 标记一次游走的结束。这里,m 是起始事件编号,n 是从起始事件到终止点的步数。由于分支是逐个追踪的,来自不同分支的游走子可能占据同一个状态,就像它们在标记为事件 5 的状态那样,但这种占据不是同时发生的。当初始游走子及其所有衍生的游走子都终止后,程序会转向初始样本中的下一个游走子。
在图 10.3 中,一组游走子同时开始。为了说明方便,我们假设每一步都通过任意分裂来进行重构。每一步,游走子的权重都会改变(这种改变在图中未示出),结果导致一些游走子终止,另一些则发生分支。在种群重构期间,不同的游走子可能同时占据同一个状态。如果它们的权重都是正的,那么重构通常不会考虑这一点。如果权重正负混合,那么将这些游走子合并为一个权重为处于同一状态的所有游走子权重之和的游走子是有利的。
一种经典的即时游走子控制程序称为轮盘赌(roulette)。它有一个预设的存活权重 $w_{s}$ 和一个截止权重 $w_{l} < w_{s}$。如果一个游走子的权重 $w$ 低于 $w_{l}$,那么如果 $\zeta < w / w_{s}$,则该游走子被保留,但其权重被提升为 $w_{s}$。否则,该游走子被终止。
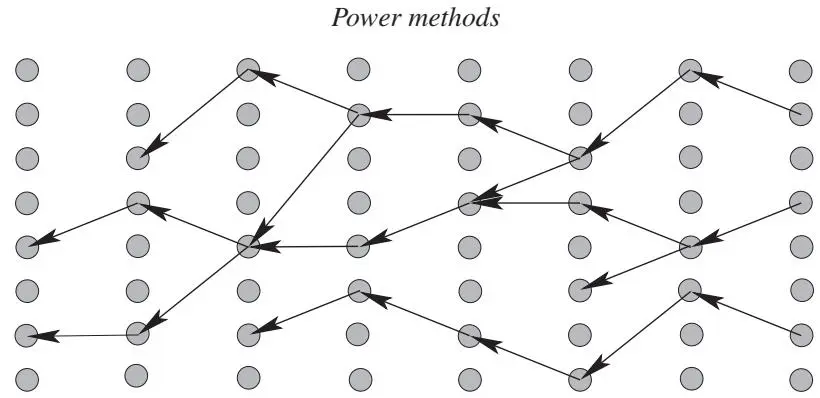
图10.3 群体重构。一列圆圈代表系统中的可能状态,每列代表经过一个幂方法步骤后的状态,方向从右向左。为便于说明,每一步都进行重构。此过程改变群体中每个游走子的权重,导致一些游走子分支,另一些终止。多个游走子可能占据同一状态。
第二种常用的方法似乎没有名称,但我们称其为分支。它解决权重过大和过小的问题。对于此过程,我们计算 $m = \operatorname{integer} ( w + \zeta )$,其中 $\zeta$ 是 [0, 1] 上的随机数。在权重上加 $\zeta$ 可以减少截断为整数可能引起的任何偏差。如果 $m = 0$,则终止该游走子。否则,将其复制分裂 m 次,每个副本被赋予权重 $w / m$。
第三种方法称为权重窗口(weight window),它以需要调整多个参数为代价,提供了更好的控制(Booth,2009)。该方法结合了轮盘赌和分支。权重窗口设置了一个下限、存活权重(survival weight)和上限,使得 $w_{l} ~ < ~ w_{s} ~ < ~ w_{u}$,且 $w_{u} ~ \ge ~ 2 w_{l}$。通常,$w_{u} ~ = ~ 5 w_{l}$,$w_{s} ~ = ~ 3 w_{l}$。只要游走子的权重在权重窗口 $[ w_{l} , w_{u} ]$ 内,我们就不做任何操作。如果游走子的权重低于 $w_{l}$,则对其执行轮盘赌。如果它高于 $w_{u}$,则通过找到最小整数 m 使得 $w / m$ 落在权重窗口内,并分裂该游走子 m 次。一般来说,应优先选择此方法而非分支,因为它能保持总权重不变,而分支会引入权重波动,仅能平均保持总权重不变。算法37详细说明了权重窗口算法。
在任何将游走子分裂为 m 个游走子的即时过程中,$m - 1$ 个具有当前状态和修改后权重的游走子被推回当前游走子列表。剩下的那个游走子以其新权重继续行走。当其行走终止时,就开始一个新的行走,使用一个等待中的游走子。当原始游走子和衍生游走子的堆栈耗尽时,一次完整迭代结束。重要的一点是,由于游走子群体是对诺伊曼级数的求和,因此没有必要基于其权重低于某个预定值或超出步数限制而任意终止游走子。执行这两种终止中的任何一种都会引入偏差。刚才描述的过程以一种至少能平均保持其权重的方式随机地终止游走子。
算法37 权重窗口。 输入:状态为 $|i\rangle$ 且权重为 w 的游走子,游走子堆栈 W,以及上限和下限截止权重 $w_{u}$ 和 $w_{l}$,存活权重 $w_{s}$ 如果 w $> w_{u}$,则 设 m = floor $( w / w_{u} )$; $w = w_{s}$; 将 m − 1 个状态为 $|i\rangle$ 且权重为 w 的游走子压入 W; 否则如果 $w < w_{l}$,则 设 $p = w / w_{s}$; 如果 $\zeta < p$,则 $w = w_{s}$ 将一个状态为 $|i\rangle$ 且权重为 w 的游走子压入 W; 否则 $w = 0$ 结束条件 结束条件 返回该游走子和 W。
我们可以一次性对整个游走子群体应用即时技术。但这样做可能会在群体规模和总权重上产生较大的突然变动。相反,我们使用几种便捷技术之一来随机重构整个游走子群体,并将群体重置为固定大小。最简单的方法是有放回抽样。在此方法中,偶而(但通常在迭代步骤之后)我们创建游走子权重的累积分布函数(CDF),$\begin{array} {r} {C_{i} ~ = ~ \sum_{j = 1}^{i} w_{j}} \end{array}$,然后从中进行有放回抽样,抽取 M 个游走子及其附属的权重和状态。权重小的游走子被选中的概率低,而权重大的游走子则可能被选中多次。
另一种方法是分层抽样(stratified sampling)(Spanier 和 Gelbard, 1969;Kalos 和 Whitlock, 1986)。我们同样构建游走子权重的累积分布。完成之后,将其0到1的范围划分为若干层,例如基于权重的百分位数或游走子的比例。然后,从每一层有放回地抽取固定数量的游走子,使得所有层的总和达到所需的数量。例如,如果我们想要M个样本,可以将累积分布的[0, 1]范围划分为M个等长区间,然后从每个区间抽取一个样本。
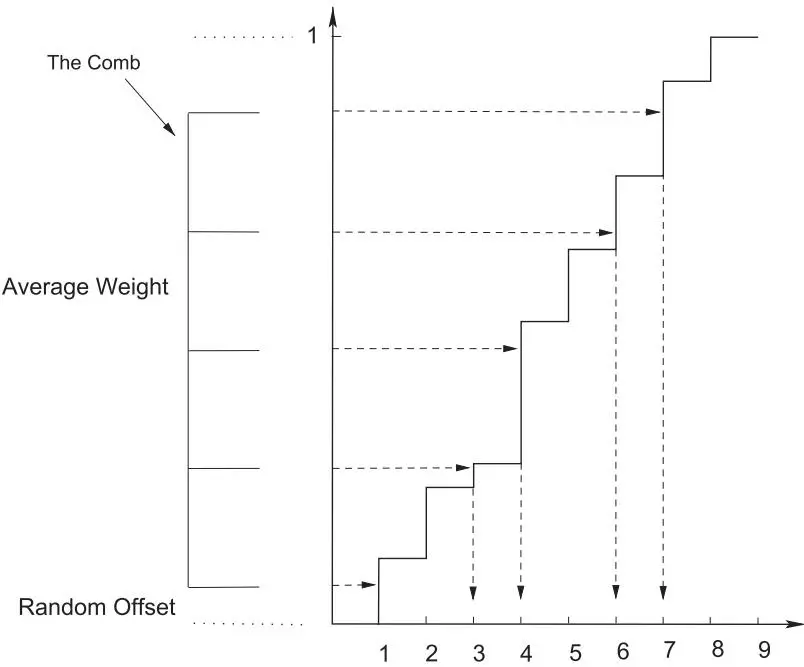
图10.4 梳子。此图展示了梳齿间距(平均权重)相等的梳子。主图是原始九个游走子的累积分布函数 $C_i$。梳子相对于累积分布函数随机偏移一个随机量。用梳子采样时,每个游走子得到平均权重(即齿间距)。这里共有五个游走子。游走子被选中的次数由落在累积分布函数区间内的齿数决定。在本例中,原始游走子1、3、4、6和7各被选中一次,其余未被选中。
还有另一种方法是梳子(the comb)(例如 Booth, 2009;Booth 和 Gubernatis, 2009b)。它保持重配置前后的总权重不变,消除了波动,并且只使用一个随机数(图10.4)。每个被选中的游走子具有相同的权重。如果我们有M个游走子,希望得到N个,其中M可能大于或小于N,则公共权重的值为 $\begin{array} {r} {w_{\mathrm{平均}} = \sum_{i = 1}^{M} w_{i} / N} \end{array}$ 。游走子的分裂和终止过程从利用M个游走子的权重形成累积分布 $C_{i}$ 开始。然而,我们指出,累积分布可以即时计算,从而无需存储。我们在算法38中详述了梳子方法。
这三种即时方法和三种种群重构方法都是方差缩减方法。然而,它们在这一目的上的各自有效性可能有很大差异。在方差缩减中,我们力求获得最大的"性价比",即给定计算时间内获得最小的方差。通常,方差缩减的目标是最小化各次测量值围绕其平均值的波动幅度。因此它的目标与种群控制不同。这两个意图常常被混淆。从方差缩减的角度看,消除分支并不总是一个好主意,尽管它对于种群控制很方便。如上所述,分支有利于遍历采样,因此消除它实际上可能是不明智的。类似地,将种群重置为固定大小(即使包含分支)对于种群控制也很方便,但无论是一次调整一个游走子还是一次性全部调整,主要目标都应是通过设置模拟参数来实现迭代间大致恒定的种群传播,从而减少偏差和方差。在描述的每种重配置方法中,重配置前后的可观测量平均值不同。这种波动会增加方差。因此,我们希望尽可能小且尽可能少地进行这些改变。一种方法是减小各游走子权重之间的波动;即,我们可以尝试将它们保持在一个权重窗口内。例如,如果我们采用权重窗口算法进行重配置,那么如果我们能将大部分权重保持在窗口内,就可以从根本上消除分裂和终止操作。
算法38 梳子。
输入: 装有M个游走子的堆栈W以及新堆栈的大小N。
初始化新堆栈 $W^{\prime}$
设置 $C = 0$ ;
设置 $\delta = 1 / M$
计算W中游走子的总权重 $w_{\mathrm{total}}$ ;
设置 $w_{\mathrm{平均}} = w_{\mathrm{total}} / N$ ;
抽取一个随机数 $\zeta \in [ 0 , 1 ]$
设置 $\Delta = \zeta \delta$ ;
重复
从W中弹出一个游走子(权重为w,状态为|i>);
$C \gets C + w$
当 $\Delta > C / w_{\mathrm{total}}$ 时执行
将权重为 $w_{\mathrm{平均}}$、状态为|i>的游走子推入 $W^{\prime}$ ;
$\Delta \gets \Delta + \delta$ ;
结束当
直到W为空。
返回 $W^{\prime} .$
我们注意到,一次性对整个总体进行重构会产生两个后果。其一,模拟不再具有马尔可夫性。重构会在游走子之间引入相关性,因为每个游走子的权重现在取决于总体中的其他游走子。这些相关性会从一个步骤传递到另一个步骤。正是由于这些相关性,我们才强调要“偶尔”进行重构。不应在每次迭代后都执行重构。一次性对整个总体进行重构的另一个后果是,估计值中通常会产生一个与游走子数量成反比的偏差。通常,游走子的数量很大,因此这个偏差很小。如果计算时间可以接受,解决方法就是简单地增加游走子的数量。还存在其他有助于减少对大量游走子需求的方法。Brissenden 和 Garlick (1986) 以及 Gelbard 和 Gu (1994) 的级数方法很容易应用于块平均,并且具有显著的积极效果。
即时重构并不能消除这些后果。这种类型的重构会同时改变总权重和游走子的数量。最根本的需求是在整个模拟过程中保持两者的大小几乎恒定。为达成此目的而进行的调整可能会诱发非马尔可夫行为和偏差。总的来说,对于这两种重构类型,这些不利影响虽然很小,但应予以注意。尽管模拟在数学上看似实现了马尔可夫且无偏的过程和估计,但实际情况往往并不理想。
10.4 格林函数蒙特卡洛方法#
在量子基态计算中,幂法投影到某个算子 A 的占优特征对上。对于 A,格林函数蒙特卡洛方法使用哈密顿量 H 的一个函数,其占优特征值映射到 H 的次占优特征值。使用了三个函数:
- $A = I - \tau ( H - \sigma I )$ ,它对哈密顿量的本征谱进行平移和缩放
- $A = [ I + \tau ( H - \sigma I ) ]^{- 1}$ ,它对平移和缩放后的哈密顿量求逆
- $A = \exp [ - \tau ( H - \sigma I ) ]$ ,它对平移后的哈密顿量取指数。
由于第一种情况使用了特征值的线性映射,我们称之为线性方法。使用指数的格林函数方法称为扩散蒙特卡洛。使用逆算子的方法称为精确格林函数蒙特卡洛。这三种方法通常都简称为格林函数蒙特卡洛。显然,后两个算子的最低阶幂级数展开都会简化为第一个。事实上,正如我们接下来讨论的,这三种方法具有共同的解释,并共享许多技术。
为了发展这种解释,我们从含时薛定谔方程(第1.2节)开始
$$ i \frac{\partial} {\partial t} \mathinner{| {\psi ( t )} \rangle} = H \mathinner{| {\psi ( t )} \rangle} , $$经过代换
$$ | \psi ( t ) \rangle = | \psi \rangle e^{- i t E} $$后,变为特征值方程
$$ H \left| \psi \right. = E \left| \psi \right. ,\tag{10.18} $$称为定态薛定谔方程。与哈密顿量的逆相关联的是一个称为定态格林函数的算子 G,其定义满足
$$ H G = G H = I . $$将 (10.18) 式左乘 G 得到特征值方程
$$ \left| \psi \right. = E G \left| \psi \right. .\tag{10.19} $$如果我们在这个格林函数算子 G 的某个基 $\{| C \rangle \}$ 下表示它,该方程将变为矩阵-向量方程
$$ \langle C | \psi \rangle = E \sum_{C^{\prime}} \langle C | G | C^{\prime} \rangle \langle C^{\prime} | \psi \rangle . $$变换 $i t \tau$ 将含时薛定谔方程转换为虚时薛定谔方程
$$ \frac{\partial} {\partial \tau} \left| \psi ( \tau ) \right. = - H \left| \psi ( \tau ) \right. ,\tag{10.20} $$经过形式积分,该方程产生一个算子,使得能够从一个虚时的状态生成另一时刻的状态,即
$$ \left| \psi ( \tau_{2} ) \right. = e^{- H ( \tau_{2} - \tau_{1} )} \left| \psi ( \tau_{1} ) \right. = G \left( \tau_{2} - \tau_{1} \right) \left| \psi ( \tau_{1} ) \right. . $$这个结果定义了依赖于虚时的格林函数,有时称为虚时传播子。由于隐含的时间平移不变性,我们可以将上式改写为
$$ \left| \psi ( \tau_{2} ) \right. = \underbrace{G \left( \tau \right) G \left( \tau \right) \cdot \cdot \cdot G \left( \tau \right)}_{M \mathrm{个因子}} \left| \psi ( \tau_{1} ) \right. , $$其中 $\tau_{2} - \tau_{1} = M \tau > 0 .$
为了用一个时刻的状态表示另一时刻的状态,我们也可以对虚时导数使用有限差分近似(欧拉法)
$$ \frac{| \psi ( \tau_{1} + \tau ) \rangle - | \psi ( \tau_{1} ) \rangle} {\tau} = - H | \psi ( \tau_{1} ) \rangle $$或
$$ \left| \psi ( \tau_{1} + \tau ) \right. = \left[ I - \tau H \right] \left| \psi ( \tau_{1} ) \right. . $$这些考虑促使我们将这些技术称为"格林函数"方法,尽管这个名称有些误导。我们的目标是计算基态性质,而不是求解运动方程 (10.20) 所表示的初值问题。因此,对于我们称之为线性方法的方法,τ 不必很小。通常,τ 是我们用来重新缩放移位哈密顿量特征值谱的一个参数,以使幂法中所用的矩阵 G 具有非负的矩阵元。对于精确格林函数方法,我们也使用 τ 来缩放移位哈密顿量,使其谱密度小于 1,这是表示逆算符的诺伊曼级数收敛的必要条件。在扩散蒙特卡洛方法中,τ 很小,因为我们使用 Trotter 近似来评估指数。简而言之,在可能的情况下,我们结合使用 τ 和 σ 来创建算符的非负矩阵表示。对于某个基组 {|C},非负性的必要条件是
- 对于 $A = I - \tau ( H - \sigma I ) \colon \langle C | H - \sigma I | C^{\prime} \rangle \leq 0$ 对所有 C 和 $C^{\prime}$ 成立
- 对于 $A = [ I + \tau ( H - \sigma I ) ]^{- 1} \colon \langle C | H - \sigma I | C^{\prime} \rangle \leq 0$ 对所有 $C \neq C^{\prime}$ 成立
- 对于 exp[−τA] 且 $A = ( H - \sigma I ) \colon \langle C | H - \sigma I | C^{\prime} \rangle \leq 0 {\mathrm{~ 对 所 有 ~}} C \neq C^{\prime}$ 成立。
在这三种格林函数方法中,基于逆幂法的精确格林函数方法是最不常用的。我们已经给出了它的基本定义,接下来将重点讨论其他两种方法的更多细节。
10.4.1 线性方法#
线性方法方便且通常易于实现。如上所述,我们希望 $A = I - \tau ( H - \sigma I )$ 在某基组 {|C} 中的矩阵元非负,并且如果 $C \neq C^{\prime}$ 和 $\langle C | H - \sigma I | C^{\prime} \rangle < 0$,我们可以确保这一点。作为如何构造幂法的一个例子,我们将 H 取为横向场中的一向量子伊辛模型 (5.6),并选择自旋构型基 (5.5)。
哈密顿量为
$$ H = H_{0} + H_{1}\tag{10.21} $$其中
$$ H_{0} = - J^{z} \sum_{i = 1}^{N} S_{i}^{z} S_{i + 1}^{z} \quad \mathrm{and} \quad H_{1} = - H^{x} \sum_{i = 1}^{N} S_{i}^{x} .\tag{10.22} $$如前面(第6.5.2节)所述,该模型是严格可解的,因此我们不需要量子蒙特卡洛模拟来理解其性质。从精确解中我们知道,该模型存在一个量子临界点(Sachdev,1999);也就是说,作为横场的函数,它在零温下有一个相变。
为了理解这一相变,我们将 $J^{z}$ 视为能量标度,从而模型的性质成为耦合常数 $g = H^{x} / J^{z}$ 的函数。如果这个常数非常小,我们预计该模型的行为类似于零场伊辛模型,其基态是所有自旋向上或向下的长程有序态。另一方面,如果 $g$ 非常大,自然的基函数不再是 $| C \rangle = | s_{1} \rangle | s_{2} \rangle \cdot \cdot \cdot | s_{N} \rangle$,而是 $| C \rangle = | t_{1} \rangle | t_{2} \rangle \cdot \cdot \cdot | t_{N} \rangle$,其中 $| t_{i} \rangle$ 是 $S_{i}^{x}$ 的本征函数。这些态是 $\begin{array} {r} {| 1 \rangle = \frac{1} {\sqrt{2}} ( | + 1 \rangle + | - 1 \rangle )} \end{array}$ 和 $\begin{array} {r} {| 2 \rangle = \frac{1} {\sqrt{2}} ( | + 1 \rangle -} \end{array}$ $| - 1 \rangle )$,对应的本征值为 $\lambda_{1} = + 1$ 和 $\lambda_{2} = - \bar{1}$。在大耦合常数极限下,$S_{i}^{z}$ 在这两个态之间独立涨落,我们预计基态是所有自旋构型的线性组合,即一个量子顺磁体(Sachdev,1999)。因此,随着 $^{g ,}$ 的变化,基态发生变化。临界点实际上位于 $\begin{array} {r} {g_{c} = \frac{1} {2}} \end{array}$,即 $J^{z} = 2 H^{x}$ 处。
从以上讨论中,我们发现选择的基并不最适合于模型的某一相。因此,我们的基选择不太可能轻易捕捉到该相的物理。我们预计在临界点附近也会遇到困难。
我们首先注意到 $H_{0}$ 在我们的基 $( s_{i , k} = \pm \frac{1} {2} )$ 下是对角的:
$$ \langle C_{i} | H_{0} - \sigma I | C_{j} \rangle = \left[ - \sum_{k} \left( J^{z} s_{i , k} s_{i , k + 1} + \sigma \right) \right] \delta_{i j} .\tag{10.23} $$接下来注意到 $H_{1}$ 是严格非对角的:
$$ \langle C_{i} | H_{1} | C_{j} \rangle \equiv - H^{x} \sum_{k} \delta_{C_{i}^{j k} C_{j}} . $$$H_{1}$ 作用在某态 $| C_{j} \rangle$ 上会产生 $N$ 个态 $| C_{i}^{j k} \rangle$ 的和,其中每个态与 $| C_{j} \rangle$ 仅在一个格点 $k$ 处不同,在该点自旋翻转为 $- s_{j , k}$。因此,当 $H^{x} > 0$ 时,所有非对角矩阵元均为负。从 (10.23) 可以清楚地看出,如果 $\sigma = J^{z}$,我们可以让所有对角元非正。因此,
$$ \langle C_{i} \vert I - \tau \left( H - \sigma I \right) \vert C_{j} \rangle = \sum_{k} w_{j k} \left[ P_{j k} \delta_{C_{i} , C_{j}} + \bar{P}_{j k} \delta_{C_{i}^{j k} , C_{j}} \right] , $$其中
$$ P_{j k} = \left[ 1 + \tau J^{z} \left( s_{j , k} s_{j , k + 1} + 1 \right) \right] / w_{j k} , \quad \bar{P}_{j k} = \tau H^{x} / w_{j k} , $$以及
$$ w_{j k} = 1 + \tau J^{z} \left( s_{j , k} s_{j , k + 1} + 1 \right) + \tau H^{x} . $$通过揭示可能的转移概率 $P$ 和权重乘子 $w$,该结果产生了一种简单的采样策略,可用于算法 35 以生成一次扫描:对于代表自旋构型 $| C_{j} \rangle$ 的游走者,我们随机选择一个格点 $k$,将游走者的权重更新为 $w \gets w w_{j k}$,然后若 $P_{j k} ~ < ~ \zeta$(其中 $\zeta ~ \in ~ [ 0 , 1 ]$),则保持游走者处于当前状态,否则将其跳跃到一个新状态(该状态由旧状态翻转格点 $k$ 处的自旋态形成)。在当前情形下,$\tau > 0$ 是一个自由参数,用于调整采样效率,例如,在耦合常数变化时保持翻转率与非翻转率大致相等。
算法 35 生成不同的状态,每个状态都是一个自旋构型;也就是说,它生成不同的游走者群体。利用这些群体可以进行多种测量(第 10.5 节)。该算法的效果如何?我们尚不清楚。我们构建它主要是为了说明目的。一般来说,很难预测算法的效率。在实现过程中,通常会对效率程度和瓶颈所在有所了解。由于该问题已知精确解,尝试复现它便成为一次学习机会,可以试验所提出的算法并对其加以改进。
10.4.2 扩散蒙特卡洛#
为了说明扩散蒙特卡洛方法,我们再次以横场伊辛模型为例,并继续使用自旋构型基。该方法与线性方法的区别在于,它需要对哈密顿量取指数。为了进行指数化,我们必须使用 Trotter 近似。在当前情况下,我们需要它是因为自旋算符 $S_{i}^{x}$ 和 $S_{j}^{z}$ 在位点 $( i = j )$ 上缺乏对易性,因此自旋-自旋哈密顿量 $H_{0}$ 与自旋场哈密顿量 $H_{1}$ 不对易。哈密顿量 $H$ 的这两部分因此不能同时对角化。相应地,(5.5) 中的状态并不是哈密顿量 (10.21) 的本征态。然而,在此基下,$\langle C^{\prime} | \exp ( - H_{0} / k T ) | C \rangle$ 和 $\langle C^{\prime} | \exp ( - H_{1} / k T ) | C \rangle$ 都很容易求得。与线性方法相比,$\tau$ 必须很小,以确保 Trotter 近似精确。
我们还需要略微不同的技术来对矩阵-向量乘法进行采样,但仍须确保在我们选择的基下,指数函数的矩阵元非负。确保非负性的条件与线性方法相同。然而,该条件确保的是精确指数化结果的正性,而非 Trotter 近似各个部分的正性。每个部分的正性需要单独确定。无论如何,在接下来的讨论中,我们取 $\sigma = J^{z}$。
构造算法的方式有几种不同选择。我们的选择带有一定任意性。首先写出
$$ H - \sigma I = - \sum_{k = 1}^{N} \big [ J^{z} \left( S_{k}^{z} S_{k + 1}^{z} + I \right) + H^{x} S_{k}^{x} \big ] , $$定义项 $h_{k , k + 1}^{( 0 )} = - J^{z} \left( S_{k}^{z} S_{k + 1}^{z} + I \right)$ 和 $h_{k , k + 1}^{( 1 )} = - H^{x} S_{k}^{x}$,然后使用以下形式的 Trotter 近似 (5.13):
$$ e^{- \tau H} \approx \prod_{k} e^{- \frac{1} {2} \tau h_{k , k + 1}^{( 0 )}} e^{- \tau h_{k , k + 1}^{( 1 )}} e^{- \frac{1} {2} \tau h_{k , k + 1}^{( 0 )}} . $$各个因子指数函数的矩阵元很容易计算:
$$ \begin{array} {r l} & {\langle C_{i} | e^{- \frac{1} {2} \tau h_{k , k + 1}^{( 0 )}} | C_{j} \rangle = e^{\frac{1} {2} \tau J^{z} \left( s_{j , k} s_{j , k + 1} + 1 \right)} \delta_{C_{i} C_{j}} ,} \\ & {\langle C_{i} | e^{- \tau h_{k , k + 1}^{( 1 )}} | C_{j} \rangle = \cosh \left( \frac{1} {2} \tau H^{x} \right) \delta_{C_{i} C_{j}} + 2 \sinh \left( \frac{1} {2} \tau H^{x} \right) \delta_{C_{i}^{j k} C_{j}} .} \end{array} $$因此,
$$ \langle C_{i} | e^{- \tau ( H - \sigma I )} | C_{j} \rangle \approx \prod_{k} w_{j k} \Big [ P_{j k} \delta_{C_{i} C_{j}} + \bar{P}_{j k} \delta_{C_{i}^{j k} C_{j}} \Big ] , $$其中
$$ \begin{array} {r} {P_{j k} = e^{\tau J^{z} s_{j , k} s_{j , k + 1}} \cosh \left( \frac{1} {2} \tau H^{x} \right) \big / w_{j k} , \quad \bar{P}_{j k} = 2 \sinh \left( \frac{1} {2} \tau H^{x} \right) \big / w_{j k} ,} \end{array} $$以及
$$ \begin{array} {r} {w_{j k} = e^{\frac{1} {2} \tau J^{z} s_{j , k} s_{j , k + 1}} \cosh \left( \frac{1} {2} \tau H^{x} \right) + 2 \sinh \left( \frac{1} {2} \tau H^{x} \right) .} \end{array} $$由此产生一种采样策略,可纳入算法35。对于代表自旋构型$| C_{j} \rangle$、权重为$w$的行走者,我们选择第一个格点$k = 1$,将行走者的权重更新为$w w w_{j k}$,然后如果$P_{j k} ~ < ~ \zeta$(其中$\zeta \in [0, 1]$),我们将行走者保持在其当前状态,通过$w w$ exp$[- \frac{1} {2} \tau J^{z} s_{j , k} s_{j , k + 1}]$更新其权重;否则将行走者跳跃到一个新状态,该状态由旧状态通过翻转格点$k = 1$处的自旋得到。然后移动到下一个格点$(k = 2)$,重复该过程,直到完成对格点的一次扫描。我们注意到,对于非常小的$\tau$,$P_{j k}$、$\bar{P}_{j k}$和$w_{j k}$简化为线性方法中的形式。此处方法的区别在于,在移动到下一个行走者之前,会依次更新所有行走者在整个格点上的自旋构型。
在算法35中使用上述方法是生成行走者群体形式构型的一种方式。利用这些构型,我们可以进行多种测量。幂法在量子应用中的一个区别是,它们总是通过使用所谓的"重要性采样"(importance sampling)来修改转移概率(进而修改权重乘子)。恰当的重要性采样是一个非常关键的性能问题。
10.4.3 重要性采样#
重要性采样是一种常见的用于减小方差的蒙特卡洛技术。我们首先定义它,然后讨论其在扩散蒙特卡洛方法中的应用。其在线性方法和精确格林函数方法中的应用可以类推。几乎找不到不采用重要性采样的量子蒙特卡洛幂法。我们按照标准路径来介绍这一技术。
假设我们寻求对下式的蒙特卡洛估计:
$$ \langle X \rangle = \int d x X ( x ) f ( x ) ,\tag{10.24} $$其中$f ( x )$是某个不便于采样的概率分布。再假设$g ( x )$是一个更方便的分布。那么,我们不再通过采样$f ( x )$来估计(10.24)得到$\begin{array} {r} {\langle X \rangle = \frac{1} {M} \sum_{i = 1}^{M} X ( x_{i} )} \end{array}$,而是估计
$$ \langle X \rangle = \int d x {\frac{X ( x ) f ( x )} {g ( x )}} g ( x )\tag{10.25} $$通过采样$g ( x )$得到
$$ \langle X \rangle \approx \frac{1} {M} \sum_{i = 1}^{M} \frac{X ( x_{i} ) f ( x_{i} )} {g ( x_{i} )} . $$当采样$g ( x )$时,$X$的方差为
$$ \sigma_{X}^{2} = \int d x \biggl [ \frac{X ( x ) f ( x )} {g ( x )} \biggr ]^{2} g ( x ) - \langle X \rangle^{2} . $$如果我们希望找到那个在归一化约束$\textstyle \int d x g ( x ) = 1$下使得该方差最小的$g ( x )$,那么通过将其代入上式可以直接证明,最优(零方差)重要性函数为
$$ g ( x ) = \frac{X ( x ) f ( x )} {\langle X \rangle} , $$这是一个令人欣慰的结果:如果我们已知答案,即 $\langle X \rangle$,那么蒙特卡洛测量就会直接得到它!更实际的推论是:一个好的重要性函数能减少方差,而一个差的重要性函数反而会增加方差。不幸的是,除了要求 $g(x)$ 应紧密“覆盖” $X(x) f(x)$ 并具有更长的尾部外,很少有好的规则来指导这一函数的选择。
如果我们有一个好的初始态 $|\phi\rangle$(在幂法中更常见的写法是 $\left| \psi_T \right.$),我们可以将这个相同的态用作重要性函数 $\langle C | \psi_G \rangle \equiv \langle C | \psi_T \rangle$。初始态通常来自近似理论或变分蒙特卡洛方法(第9章)。重要性函数 $|\psi_G\rangle$ 常被称为引导函数(guiding function),因为它的使用可以理解为引导行走者走向构型空间中重要的区域。我们假设 $|\psi_G\rangle = \left| \psi_T \right.$。我们还使用这个相同的 $\left| \psi_T \right.$ 通过 $\sigma \equiv E_T = \langle \psi_T | H | \psi_T \rangle / \langle \psi_T | \psi_T \rangle$ 来估计 $\sigma$。
我们通过变换基本迭代步骤 (10.2) 在量子蒙特卡洛幂法中进行重要性采样(importance sampling)
$$ \langle C | \psi \rangle = \sum_{C^{\prime}} \langle C | A | C^{\prime} \rangle \langle C^{\prime} | \phi \rangle $$为
$$ \langle C | \psi_{T} \rangle \langle C | \psi \rangle = \sum_{C^{\prime}} \frac{\langle C | \psi_{T} \rangle \langle C | A | C^{\prime} \rangle} {\langle C^{\prime} | \psi_{T} \rangle} \langle C^{\prime} | \psi_{T} \rangle \langle C^{\prime} | \phi \rangle . $$这是一个相似变换(similarity transformation),$A^{\prime} = S A S^{- 1}$,作用于原始本征方程,其中对角变换矩阵 $S$ 的非零元素为 $\langle C | \psi_{T} \rangle$。本征值不变,但本征态改变。我们现在迭代的是
$$ \langle C | \bar{\psi} \rangle = \sum_{C^{\prime}} \langle C | A | C^{\prime} \rangle \frac{\langle C | \psi_{T} \rangle} {\langle C^{\prime} | \psi_{T} \rangle} \langle C^{\prime} | \bar{\phi} \rangle $$其中比值 $\langle C | \psi_{T} \rangle / \langle C^{\prime} | \psi_{T} \rangle$ 类似于 (10.25) 中的 $f(x) / g(x)$,并成为额外因子贡献给权重转移乘子(weight-transfer multiplier)$w_{C C^{\prime}}$。$\langle C | \bar{\psi} \rangle = \langle C | \psi_{T} \rangle \langle C | \psi \rangle$,$\langle C | \bar{\phi} \rangle = \langle C | \psi_{T} \rangle \langle C | \phi \rangle$。引导函数不一定与初始态相同,但如果初始态是好的,那么它也应该是一个好的引导函数。变分蒙特卡洛的一个用途就是提供这个函数(第9章)。
10.5 测量#
我们现在来讨论先前承诺的测量问题。在扩散蒙特卡洛中,本征值的标准估计量被称为混合估计量(mixed estimator)(Hammond et al., 1994),
$$ E_{0} \leq E_{m} \equiv \frac{\langle \psi_{T} | H | \psi \rangle} {\langle \psi_{T} | \psi \rangle} , $$因为它同时使用了初始态 $\vert \psi_{T} \rangle$ 和投影态 $| \psi \rangle$。显然,当 $| \psi \rangle$ 接近基态时,该表达式给出精确估计。对于任何与 $H$ 对易(commutes)的可观测量,我们都使用这个相同的估计量。对于其他算符,我们使用混合估计量和变分估计量的组合,称为外推估计量(extrapolated estimate)
$$ \langle X \rangle = 2 \frac{\langle \psi_{T} | X | \psi \rangle} {\langle \psi_{T} | \psi \rangle} - \frac{\langle \psi_{T} | X | \psi_{T} \rangle} {\langle \psi_{T} | \psi_{T} \rangle} + \mathcal{O} \left( \Vert \psi_{T} - \psi \Vert^{2} \right) . $$扩散蒙特卡洛方法通常使用一种特殊的基态能量估计量,即增长估计量(growth estimator)(Hammond 等,1994)。如前所述,在幂法中,本征态的范数估计了该特征值。将范数写为 $\begin{array} {r} {N ( \psi ) = \sum_{C} | \langle C | \psi \rangle |} \end{array}$ ,我们注意到,如果从基态(我们假设其为实函数)采样,由于该态无节点,因此 $| \langle C | \psi \rangle | = \langle C | \psi \rangle$ ,并且基态下经过一步迭代产生的新态的范数为
$$ N ( \phi ) = \sum_{c} \langle C | \phi \rangle = e^{- \tau ( E_{0} - E_{T} )} N ( \psi ) . $$然而,在任何 τ 步上的能量实际取值 $E_{\tau}$ 会围绕 $E_{0}$ 波动,因此我们有
$$ N ( \phi ) = \sum_{c} \langle C | \phi \rangle = e^{- \tau ( E_{\tau} - E_{T} )} N ( \psi ) . $$从而,
$$ E_{\tau} = E_{T} - \frac{1} {\tau} \ln \frac{N ( \phi )} {N ( \psi )} $$所以
$$ {\cal E}_{0} \equiv \langle E_{\tau} \rangle . $$测量过程中常用且有效的改进方法是向前行走(forward walking)(Hammond 等,1994)和反向传播(back propagation)(Zhang 等,1997)。为了讨论反向传播,假设我们已将 $| \psi_{T} \rangle$ 在平稳态下传播 n 步,得到 $| \psi \rangle = A^{n} | \psi_{T} \rangle$,并保存了这个态。现在假设我们再进行 $m \ll n$ 步,并保存这 m 个导致新态 $| \psi^{\prime} \rangle$ 的构型。我们不使用下式进行平均计算
$$ \langle \mathcal{O} \rangle = \frac{\langle \psi_{T} \vert \mathcal{O} \vert \psi^{\prime} \rangle} {\langle \psi_{T} \vert \psi^{\prime} \rangle} , $$其中 $| \psi^{\prime} \rangle = A^{m} | \psi \rangle$ ,而是使用
$$ \mathcal O = \frac{\psi_{T} | A^{m} \mathcal O | \psi} {\psi_{T} | A^{m} | \psi} = \frac{\psi_{T}^{\prime} | \mathcal O | \psi} {\psi_{T}^{\prime} | \psi} , $$也就是说,我们不用当前第 ( m + n ) 步的构型进行测量,而是用在第 n 步的过去构型进行测量,并利用中间的构型将 $| \psi_{T} \rangle$ 向基态投影 m 步。我们在基态行列式方法(附录 I)中看到了类似的处理。在那里,我们在虚时长度为 $\beta$ 的投影中的 $\beta / 2$ 点附近进行测量。
如果没有重要性采样,蒙特卡洛计算的估计为
$$ | \psi \rangle = \sum_{C} w_{C} | C \rangle , $$相应地,对于任何可观测量,其混合估计量(mixed estimate)为
$$ \langle \mathcal{O} \rangle = \frac{\sum_{C} w_{C} \langle \psi_{T} | \mathcal{O} | C \rangle} {\sum_{C} w_{C} \langle \psi_{T} | C \rangle} . $$然而,重要性采样返回的权重是 $\bar{w}_{C} = w_{C} \langle \psi_{T} | C \rangle$ 而不是 $w_{C}$ 。用重要性采样后的权重表示,混合估计量变为
$$ \langle \mathcal{O} \rangle = \frac{\sum_{C} w_{C} \langle \psi_{T} | C \rangle \frac{\langle \psi_{T} | \mathcal{O} | C \rangle} {\langle \psi_{T} | C \rangle}} {\sum_{C} w_{C} \langle \psi_{T} | C \rangle} = \frac{\sum_{C} \bar{w}_{C} \frac{\langle \psi_{T} | \mathcal{O} | C \rangle} {\langle \psi_{T} | C \rangle}} {\sum_{C} \bar{w}_{C}} . $$10.6 激发态#
激发态的信息很重要,并且使用幂法通常可以获取少量这样的态。精确计算它们通常很困难。因此,它们很少被计算。我们现在简要讨论两种计算激发态的方法。第一种是已有成功记录的经典方法,另一种是新发展且不太成熟的方法。经典方法(Ceperley 和 Bernu, 1988)称为关联函数量子蒙特卡罗方法(correlation function quantum Monte Carlo method),它从计算激发态的标准变分法出发,并结合了变分和扩散蒙特卡罗方法的特征。这些激发态是同时确定的,而非逐个确定。
10.6.1 关联函数蒙特卡洛#
在确定性变分法中,如果要计算 M 个激发态,我们需要 M 个试探态, $\{| \psi_{T , i} \rangle , i = 1 , 2 , \dots , M \}$ 。如果我们将这些态参数化为某组基态 $\{| \phi_{i} \rangle , i = 1 , 2 , \dotsc , N \geq M \}$ (其中 N 不小于 M)的线性组合,使得
$$ \left| {\psi_{T , i}} \right. = \sum_{j} \left| {\phi_{j}} \right. N_{j i} , $$然后关于矩阵 $N$ 的元素最小化瑞利商,得到广义特征值问题
$$ A | \psi \rangle = \nu S | \psi \rangle , $$其中哈密顿量矩阵和重叠矩阵是 $N \times N$ 矩阵,定义为
$$ A_{i j} = \langle \phi_{i} | H | \phi_{j} \rangle , \quad S_{i j} = \langle \phi_{i} | \phi_{j} \rangle . $$计算得到的特征值 $\nu_{i}$ 穿插在 $A$ 的特征值 $\lambda_{i}$ 之间(9.5);也就是说,存在一组 $A$ 的特征值,使得 $\lambda_{1} \leq \nu_{1} \leq \lambda_{2} \leq \nu_{2} \cdot \cdot \cdot \cdot$(第9.1节)。
在关联函数量子蒙特卡罗方法(第9章)中,我们首先通过变分蒙特卡洛计算或平均场理论生成尽可能好的试探态,然后将它们用于广义特征值问题
$$ {\bar{A}} | \phi \rangle = \nu{\bar{S}} | \phi \rangle , $$其中
$$ \bar{A}_{i j} ( \tau ) = \langle \phi_{i} | A e^{- \tau A} | \phi_{j} \rangle , \quad \bar{S}_{i j} ( \tau ) = \bigl \langle \phi_{i} | e^{- \tau A} | \phi_{j} \bigr \rangle . $$接下来,我们通过添加引导函数 $| \psi_{G} \rangle$ 创建一个采样密度,并将这些矩阵表示为与变分蒙特卡洛方法中哈密顿量矩阵和重叠矩阵类似的形式(第9.3节),
$$ \begin{array} {r l} & {\bar{A}_{i j} ( \tau ) = \displaystyle \sum_{C} \frac{\langle \phi_{i} | e^{- \tau A / 2} | C \rangle} {\langle \psi_{G} | C \rangle} \frac{\langle C | A e^{- \tau A / 2} | \phi_{j} \rangle} {\langle C | \psi_{G} \rangle} \frac{\langle C | \psi_{G} \rangle^{2}} {\textstyle \sum_{C} \langle C | \psi_{G} \rangle^{2}} ,} \\ & {\bar{S}_{i j} ( \tau ) = \displaystyle \sum_{C} \frac{\langle \phi_{i} | e^{- \tau A / 2} | C \rangle} {\langle \psi_{G} | C \rangle} \frac{\langle C | e^{- \tau A / 2} | \phi_{j} \rangle} {\langle C | \psi_{G} \rangle} \frac{\langle C | \psi_{G} \rangle^{2}} {\textstyle \sum_{C} \langle C | \psi_{G} \rangle^{2}} .} \end{array} $$我们需要从由引导函数定义的分布中采样一个构型。然后我们需要对所有基态进行投影,并计算它们在采样构型上的重叠。我们通过扩散蒙特卡罗方法进行投影。当 $\tau \to \infty$ 时,使用 $\bar{A}$ 和 $\bar{S}$ 的蒙特卡罗平均值的广义特征值问题的特征值,趋近于与试探态重叠的激发态的特征值。
在选择变分试探态的基以及引导态时,我们必须使这些态足够通用,以避免无意中遗漏具有所需对称性的激发态。当然,如果我们知道所关心的对称性,我们会调整基和引导函数以包含它们。
原始论文给出了关于该方法有效性的满意细节以及其实现中的有用信息。然而,正如我们在变分蒙特卡罗章节(第9.3节)中所讨论的,现在存在用于优化试探态的更新方法,并且已经理解,虽然广义特征值问题中的哈密顿量矩阵和重叠矩阵应该是对称的,但对称化采样时产生的表达式会破坏变分方法的零方差性质。
10.6.2 修正幂方法#
计算激发态的第二种方法则截然不同。激发态特征向量的分量必须具有混合符号。关联函数量子蒙特卡罗方法从不直接对激发态进行采样。新方法会这样做,因此必须解决符号问题。我们称这种新方法为修正幂方法。与关联函数量子蒙特卡罗方法一样,它需要的初始态数量与要寻找的特征值数量相同,并同时确定几个特征对。为了简化讨论,我们假设我们只寻找两个特征对。推广到多于两个的情况是相当明显的。
这种新方法的一个重要特征是,它收敛到极值态,例如基态和第一激发态,对于基态收敛速度为 $( \lambda_{3} / \lambda_{1} )^{n}$,对于第一激发态收敛速度为 $( \lambda_{3} / \lambda_{2} )^{n}$。(回顾(10.1)式。)收敛到基态和第一激发态的速度更快,因为在收敛过程中,激发态从基态中被减去,反之亦然,而不是仅仅通过迭代被削减("幂消")。修正幂方法明确投影到这两个态。其他态则被"幂消"。详细内容见 Booth (2003a,b),Gubernatis and Booth (2008) 和 Booth and Gubernatis (2009b)。
如果初始态是 $| \phi_{1} \rangle$ 和 $| \phi_{2} \rangle$,修正幂方法的迭代过程为
$$ \begin{array} {r l} & {| \psi_{1} \rangle = A | \phi_{1} \rangle ,} \\ & {| \psi_{2} \rangle = A | \phi_{2} \rangle ,} \\ & {| \phi_{1} \rangle = | \psi_{1} \rangle + \eta_{1} | \psi_{2} \rangle ,} \\ & {| \phi_{2} \rangle = | \psi_{1} \rangle + \eta_{2} | \psi_{2} \rangle ,} \\ & {| \phi_{1} \rangle | \phi_{1} \rangle \Big / \| \phi_{1} \| ,} \\ & {| \phi_{2} \rangle | \phi_{2} \rangle \Big / \| \phi_{2} \| .} \end{array} $$中间的两个方程防止该方法成为两个独立的幂方法。如果迭代是两个独立的幂方法,那么两个初始态都会投影到同一个基态。中间的两个方程使投影以这样一种方式相互依赖:如果一个态(比如 $| \psi_{1} \rangle$)收敛到主导态,则另一个态收敛到次主导态。正是通过这两个方程,$| \psi_{2} \rangle$ 从 $\left| {\psi_{1}} \right.$ 中被减去,反之亦然。声明存在两个数 $\eta_{1}$ 和 $\eta_{2}$ 可以实现这一点。
在中间的两个方程中,我们希望从两个态的线性组合中形成一个最终的特征态。显然 $\eta_{1}$ 和 $\eta_{2}$ 的值不能是任意的。为了找到它们,我们观察到如果 λ 是 A 的一个特征值,且关联特征态的分量为 $\psi_{i}$,那么对于任何非零的 ${\psi_{i}}^{6}$
$$ \lambda = \frac{\sum_{j} A_{i j} \psi_{j}} {\psi_{i}} . $$如果对一个分量成立,那么对于任意分量子集上的求和也有类似的关系。
选择这样的子集有很多种方式,我们称这样的子集为一个区域。对于任意两个区域 $R_{1}$ 和 $R_{2}$,必须有
$$ \lambda = \frac{\sum_{j \in R_{1}} A_{i j} \psi_{j}} {\sum_{i \in R_{1}} \psi_{i}} = \frac{\sum_{j \in R_{2}} A_{i j} \psi_{j}} {\sum_{i \in R_{2}} \psi_{i}} .\tag{10.26} $$现在,如果 $| \psi \rangle = | \psi_{1} \rangle + \eta | \psi_{2} \rangle$ 是一个特征向量,并且我们将这个态代入上述方程,再将等号两侧的分子和分母交叉相乘,就会发现 $\eta$ 必须满足一个二次方程
$$ a \eta^{2} + b \eta + c = 0 , $$其系数是区域和的乘积之和:
$$ \begin{array} {r l} & {a = \displaystyle \sum_{i \in R_{2}} \psi_{1 i} \sum_{i \in R_{1}} \sum_{j} A_{i j} \psi_{2 j} - \displaystyle \sum_{i \in R_{1}} \psi_{2 i} \sum_{i \in R_{2}} \sum_{j} A_{i j} \psi_{1 j} ,} \\ & {b = \displaystyle \sum_{i \in R_{2}} \psi_{2 i} \sum_{i \in R_{1}} \sum_{j} A_{i j} \psi_{1 j} - \displaystyle \sum_{i \in R_{1}} \psi_{2 i} \sum_{i \in R_{2}} \sum_{j} A_{i j} \psi_{1 j}} \\ & {\quad \ + \displaystyle \sum_{i \in R_{2}} \psi_{1 i} \sum_{i \in R_{1}} \sum_{j} A_{i j} \psi_{2 j} - \displaystyle \sum_{i \in R_{1}} \psi_{1 i} \sum_{i \in R_{2}} \sum_{j} A_{i j} \psi_{2 j} ,} \\ & {c = \displaystyle \sum_{i \in R_{2}} \psi_{1 i} \sum_{i \in R_{1}} \sum_{j} A_{i j} \psi_{1 j} - \displaystyle \sum_{i \in R_{1}} \psi_{1 i} \sum_{i \in R_{2}} \sum_{j} A_{i j} \psi_{1 j} .} \end{array} $$在迭代的每一步,我们计算这些系数并求解二次方程的两个根。当两个根均为实数时,7我们使用每个根代入 $| \psi \rangle =$ $| \psi_{1} \rangle + \eta | \psi_{2} \rangle$,利用其中一个区域计算其特征值估计 (10.26),然后将一个根 $\eta_{1}$ 与最大的特征值估计 $\left| {\psi_{1}} \right.$ 相关联,另一个根 $\eta_{2}$ 与次主导态估计相关联。一致地执行此操作将使修正幂方法按照所述方式收敛到主导态和次主导态。通过平移 A 的谱,我们可以强制其收敛到基态和第一激发态。
对于确定性实现而言,无论我们寻求的是矩阵还是连续算子的几个占优特征值,几乎任何区域的选择都有效。此外,矩阵元素或其特征向量分量的混合符号也不会造成太多问题,因为我们精确地执行了矩阵-向量乘法。然而,蒙特卡洛实现使用的向量分量样本很少,会遗漏重要的符号相消,因此我们面临符号问题。
为解决符号问题,我们首先为每个游走者分配一个态和两个权重,这两个权重代表两个特征态的分量。如果矩阵是非负的,则一个权重为正,另一个权重可能为正或负。当游走者数量相对于可用态数量变得非常少时,蒙特卡洛算法将两个符号相反的游走者放入同一个态的可能性很小。因此,我们在蒙特卡洛抽样中添加一些促进这些事件发生的步骤。已经开发了几种实现此目的的方法(Booth 和 Gubernatis, 2009b; Rubenstein 等, 2010; Gubernatis, 2012)。其中一种方法实际上是为连续介质中的量子蒙特卡洛问题开发的(Arnow 等, 1982)。我们现在对其进行描述。
我们使用蒙特卡洛算法来抽样求和 $\sum_{j} A_{i j} x_{j}$。我们首先将这个乘积表示为对索引集合 $\{k\}$ 的求和 $\sum_{j \in \{k \}} A_{i j} x_{j}$,该集合代表当前 M 个游走者的群体,这当然只是可用态的一个小子集。我们不是对 $\{k\}$ 中给定 j 值对应的 i 进行抽样,而是通过以下方式涉及整个群体:
$$ \begin{array} {l} {{\displaystyle \sum_{j \in \{k \}} A_{i j} w_{j} = \sum_{j \in \{k \}} \frac{A_{i j} w_{j}} {j \in \{k \}} \sum_{j \in \{k \}} P_{i j}}} \\ {{\displaystyle \qquad = \sum_{j \in \{k \}} \frac{A_{i j} w_{j}} {\sum_{j \in \{k \}} P_{i j}} \left[ P_{i j_{1}} + P_{i j_{2}} + \cdot \cdot \cdot + P_{i j_{M}} \right] .}} \end{array} $$现在我们从方括号中的项里,从 $P_{i j_{1}}$ 中采样一个 $i_{1}$,得到一个权重为
$$ \sum_{j \in \{k \}} A_{i_{1} j} w_{j} \left/ \sum_{j \in \{k \}} P_{i_{1} j} \right.\tag{10.27} $$的状态 $\left| i_{1} \right.$ 的游走者,并从 $P_{i j_{2}}$ 中采样 $i_{2}$,得到一个权重为
$$ \left. \sum_{j \in \{k \}} A_{i_{2} j} w_{j} \right/ \sum_{j \in \{k \}} P_{i_{2} j} ,\tag{10.28} $$的状态 $| i_{2} \rangle$ 的游走者,依此类推。因此,每个当前游走者贡献多个新游走者,而不是通常每个游走者贡献一个。每个新游走者通常接收来自多个旧游走者的贡献。这种种群数量的增加,提高了相反符号的新游走者共享同一状态的可能性。我们很容易合并同一状态的游走者,从而抵消那些否则会被遗漏的符号。
这种重要性采样过程的规模为 $M^{2}$,且计算成本较高。我们不必一次性使用整个种群,而可以考虑所有游走者对、所有游走者三元组等。通常,超过一定数量的分组收益甚微。或者,我们可能选择仅使用最有可能包含混合符号游走者的子集。我们在图 10.1 的右面板中说明了成对采样。在该图中,连接旧状态与新状态的实线是我们使用标准蒙特卡洛幂方法采样进行采样的连接。该采样定义了新的种群。然后,对于给定的一对旧状态,虚线表示对这对新状态的额外可能贡献。我们根据 (10.27) 修改新状态的权重。
经过主动符号抵消改进的幂方法已成功应用于许多经典问题,目前正开始探索其在量子问题中的应用。更多细节在一系列论文中给出(Gubernatis and Booth, 2008; Booth and Gubernatis, 2009a; Rubenstein et al., 2010; Gubernatis, 2012)。迄今为止,令人惊讶的是,它在没有使用重要性采样的情况下取得了成功。在完全了解其量子蒙特卡洛潜力之前,还有许多工作要做。
Booth 提出了幂方法,用于一次计算一个激发态而无需知道其他本征态,并提出了评估收敛性的方法(Booth, 2003a,b,c, 2010, 2011a,b,c)。
10.7 评论#
正如本章开头所述,这里描述的大多数蒙特卡洛技术最初是为经典问题而开发的。实际上,我们可以轻松地论证,中子穿过易裂变材料的输运问题(启发蒙特卡洛方法发展的最初应用)是连续介质中基态量子蒙特卡洛方法之父。这些核工程问题中的材料通常是分段均匀的。每一段由散射截面表征,散射截面决定了中子的平均自由程以及中子被激发、吸收、散射和裂变的概率。中子输运问题分为两类,称为固定源问题和临界问题。固定源问题对应于求解一个线性方程组,其右侧(已知项)是辐射源。临界问题对应于一个本征值问题。当材料通过裂变产生的中子数与因吸收和逃逸而损失的中子数相等时,系统处于临界状态,占优本征值为1。在次临界系统中,该本征值小于1,而在超临界系统中,它大于1。
在这些输运问题中,中子需要从一个连续空间点移动到另一个点。这种移动相对容易采样。采样的是到下一次碰撞的距离,其概率是指数形式的,路径长度由所穿过材料段的平均自由程的倒数加权。
扩散蒙特卡洛在连续介质中的许多采样方法借鉴自中子输运问题。一个不同之处在于对粒子(游走者)在连续介质中运动的采样。在量子问题中,哈密顿量被指数化。Trotter 近似将这个指数表示为动能指数和势能指数的乘积(第7.1节)。在位置基矢下,后者是对角的。前者使粒子运动,需要计算诸如 $e^{D \nabla^{2}} \psi ( r )$ 的项。我们可以通过 Hubbard-Stratonovich 变换以如下方式执行此操作 (Zhang 等, 1997):
$$ \begin{array} {c} {{e^{D \nabla^{2}} \psi \left( r \right) = \displaystyle \frac{1} {\sqrt{2 \pi}} \int_{- \infty}^{+ \infty} d x e^{- \frac{1} {2} x^{2}} e^{- i \sqrt{D} x \cdot \nabla} \psi \left( r \right)}} \\ {{= \displaystyle \frac{1} {\sqrt{2 \pi}} \int_{- \infty}^{+ \infty} d x e^{- \frac{1} {2} x^{2}} \psi \left( r + \sqrt{D} x \right) .}} \end{array} $$从高斯分布中采样 $x$ 会产生从 $r$ 到 $r + {\sqrt{D}} x$ 的运动,这是一种扩散运动。因此,对于连续介质中的问题,扩散蒙特卡洛提供了一种方便且几乎不可或缺的方法来采样粒子运动。
量子应用与核工程应用之间一个有趣的差异在于 (10.4.3) 意义下的重要性抽样的使用方式。在工程问题中,对于材料不同部分的特定过程,可以使用不同的重要性函数。整个问题过于复杂,无法用一个全局的重要性函数来处理。因此,重点一直放在为困难部分生成方差缩减方法上。通常,在材料的多个部分使用多种技术。
我们讨论的随机重配置方法源于中子输运问题。然而,在量子问题中,我们有方法生成一个全局的重要性函数,例如,通过变分蒙特卡洛方法或平均场理论。因此,对探索多种方差缩减方法的强调较少。通常,整个问题只使用一种随机重配置方法,其目的更多地在于控制粒子群规模。与中子输运模拟中使用的多种技术相比,量子蒙特卡洛幂法模拟中使用的技术显得有些单一。
晶格上的基态量子蒙特卡洛又借鉴了连续介质中基态量子蒙特卡洛模拟的许多技术。在晶格模型中,游走者通常从一个离散态移动到另一个离散态,无论我们是否使用离散的 Hubbard-Stratonovich 变换(第7.1节)。通常,从一个态出发可到达的态数量非常有限。晶格问题的这一特性在某种程度上未被充分利用。虽然扩散蒙特卡洛保持其优势,但线性方法和精确格林函数方法在连续介质中的缺点得到了缓解。为晶格问题设计基态量子蒙特卡洛解决方案有更多选择。精确格林函数方法的优雅性变得难以绕过。
本章中的方法将我们带回到 Fermi 在第 1 章开篇之处。我们说明了虚时薛定谔方程具有一个蒙特卡洛实现形式,即一组游走者(粒子),其中每个游走者独立地进行随机游走,同时其权重在构型空间中的位置上受到哈密顿量中各个部分的乘性作用。在蒙特卡洛模拟中,游走者的权重在虚时中呈指数衰减,衰减率由特征值 $E_{0}$ 和游走者分布 $\langle C | \psi \rangle$ 控制。这个特征对相应于哈密顿量的基态解。