好的,这是根据您的要求,对第4章内容的完整中文翻译,并补充了新增术语表。
第4章 · 经典多体问题的蒙特卡洛方法#
我们对马尔可夫链的讨论,除了提及 Metropolis 算法和热浴算法之外,到目前为止都非常笼统,很少涉及与特定应用相关的问题和机遇。在本章中,我们回顾一下我们的目标是在格点上定义的多体问题,并介绍几个利用这类问题中马尔可夫过程特性的框架。我们在这里考虑经典多体问题,以伊辛模型为代表。我们的讨论将在后续章节中扩展到各种量子多体问题和算法。
4.1 多体相空间#
在格点上研究多体问题的数值困难源于其相空间 $\Omega$ 是许多局部自由度相空间的直积这一事实。通常,每个格点都与一个局部相空间相关联。如果 n 是该相空间的大小,N 是格点数,那么整个系统可用的状态数 $|\Omega|$ 为 $n^{N}$。换句话说,相空间中的状态数随着系统物理尺寸的增长呈指数级增长。例如,在伊辛模型中,每个格点上的伊辛自旋 $s_{i}$ 可以取 ±1 两个值之一,因此整个相空间的状态数为 $2^{N}$。
在第1章中,我们指出这种指数级增长阻碍了确定性解法,这也是我们使用蒙特卡洛方法的原因。指数级大量的状态意味着,枚举所有状态(这需要与相空间大小成比例的计算量)对于具有大量格点的问题来说是不可行的。正如在第2.7节中讨论的那样,蒙特卡洛方法通常从压缩的相空间中采样,从而避免了解整个问题的需要。然而,即使有这种优势,我们能否将计算量降低到可控水平呢?
一个显而易见的要求是我们能够在合理的计算时间内使模拟达到平衡。我们知道马尔可夫过程会收敛到对某个分布进行采样的平稳状态(第2.4节),而对于满足细致平衡的算法,Rosenbluth 定理(第2.6节)保证了单调收敛。然而,正如我们之前指出的,这些定理并没有告诉我们收敛的速度有多快。虽然我们知道收敛率由转移概率矩阵的第二大特征值 $\lambda_{2}$ 控制,但通常我们并不知道这个特征值。
从随机矩阵的性质中我们确实知道 $| \lambda_{2} | < 1$。它与1之间的差距是一个有限的边界,量级为 $\mathcal{O} ( | \Omega | ^{- 1} )$ 或更大(第2.4.2节)。这个边界表征了最慢的弛豫模式,并为第3.3节和3.4节中讨论的计算自相关时间设定了一个上界,
$$ \tau_{\mathrm{comp}} = \frac{- 1} {\log | \lambda_{2} |} \leq \mathcal{O} ( | \Omega | ) , $$⚠ 上次翻译中有以下问题,已修正: 遗漏英文长词 9 处; 可能漏翻部分段落 已重新翻译完整内容。
这意味着重要性采样(例如Metropolis算法和热浴算法所体现的)至少与随机抽样一样好。然而,如果满足这个上界,简单枚举所有状态也同样快速,而且其优点在于结果是精确的。
幸运的是,在许多重要的多体模拟中,$\tau_{\mathrm{comp}}$ 的量级为1,与系统的大小无关。即使在临界点附近,蒙特卡洛模拟的弛豫时间通常也比非临界情况更长,$\tau_{\mathrm{comp}}$ 也只是随系统大小呈多项式变化,而非指数变化。因此,蒙特卡洛模拟已成为解决多体问题的标准技术。
但为什么 $\tau_{\mathrm{comp}}$ 可以与系统大小无关呢?虽然数学上的严格证明超出了本书的范围,但我们可以通过以下思考获得一个粗略的概念:多体问题的转移概率矩阵并非任意的一个马尔可夫矩阵。为了理解这句话的含义,让我们将物理系统划分为许多相同的子系统,每个子系统的大小与整个系统的大小无关,并且假设它们足够大,以至于其性质近似相互独立。那么,整个系统的分布函数就是各子系统分布函数的乘积,因此整个系统的弛豫率由各子系统的弛豫率决定。由于根据假设所有子系统相同,整个系统的马尔可夫链自相关时间就是任何一个子系统的自相关时间,而后者与系统尺寸无关。这种情况适用于大多数多体问题的蒙特卡洛模拟。通常存在一个特征长度尺度,超出该尺度后空间关联不再延伸。如果我们正在模拟连续相变,当我们接近临界点时,关联长度发散正是许多蒙特卡洛模拟中自相关时间变得异常大的原因。其根源在于物理问题本身,而非多体相空间的物理尺寸。
4.2 局部更新#
我们采用伊辛模型作为工作示例,并探索三种不同的蒙特卡洛算法来模拟其性质。如我们在第1章所述,我们可以使用蒙特卡洛模拟来计算基态和有限温度性质。同样,我们也提到,对于伊辛模型,基态性质不如有限温度性质那样有趣。我们将基态蒙特卡洛方法的讨论推迟到其他章节(第9、10和11章)。为了模拟有限温度性质,我们必须从玻尔兹曼分布中采样,这意味着算法满足细致平衡条件就足够了。Metropolis算法在此设定了标准。我们从重新审视该方法开始,讨论其通用性,而不是局限于它在伊辛模型中的具体应用。
我们的目标是从一个分布中采样,该分布的配分函数1
$$ Z = \sum_{C \in \Omega} W ( C )\tag{4.1} $$由非负权重定义:
$$ W ( C ) = \prod_{\langle i j \rangle} w ( s_{i} , s_{j} ) , \qquad w ( s_{i} , s_{j} ) = e^{K s_{i} s_{j}} ,\tag{4.2} $$其中乘积遍及所有近邻格点对,且 $K \equiv J / k T$。我们寻求一种将构型 $C$ 更新为另一构型 $C^{\prime}$ 的过程,其中 $C \equiv ( s_{1} , s_{2} , \ldots , s_{N} )$ 表示含 $N$ 个格点的伊辛模型自旋变量构型。
实现这种采样的简单方法是使用单自旋翻转更新的Metropolis算法。它逐个格点地提议翻转给定格点上的自旋,然后决定接受或拒绝该翻转。其满足细致平衡条件的马尔可夫链转移矩阵 $P ( C^{\prime} | C )$ 是提议概率与接受概率的乘积。具体来说,我们以概率 $1 / N$ 随机选取一个格点,并提议翻转该格点上的自旋。若 $\delta E$ 是该自旋翻转所引起的总能量变化,则该自旋翻转以概率 min(1, exp(−$\delta E/kT$)) 被接受。否则,我们保留(并测量)原构型。该简单算法的流程见算法6,图4.1给出了示意图。
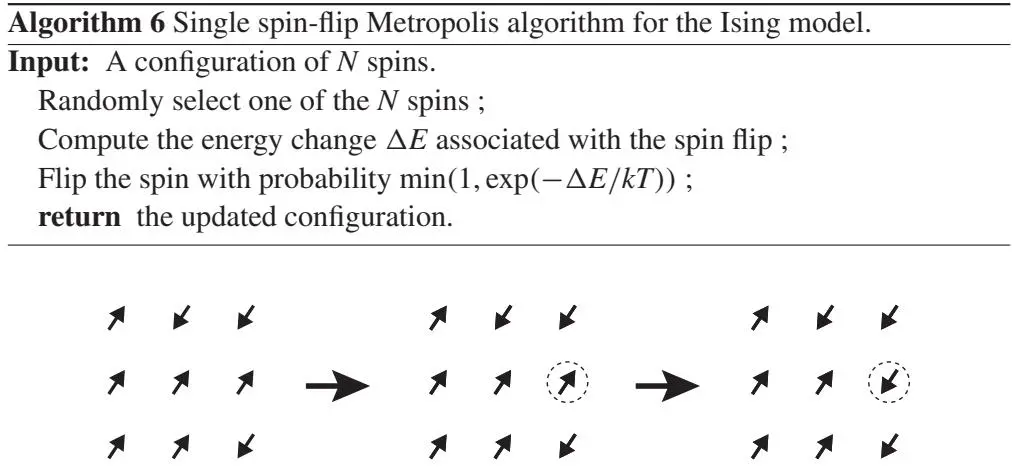
图4.1 伊辛模型单自旋翻转更新中的一个循环。
4.3 两步选择#
单自旋翻转Metropolis算法可以看作一个两步采样过程,步骤如下:
- 以与当前构型无关的某个概率选定一个自旋,
- 以适当的概率选定该自旋的下一状态。
该过程的转移矩阵具有如下形式
$$ P ( C^{\prime} | C ) = \sum_{i = 1}^{N} p_{i} q_{i} ( C^{\prime} | C ) ,\tag{4.3} $$其中 $p_{i}$ 是第一步选中自旋 $s_{i}$ 的概率,$q_{i}$ 是第二步将构型 C 改变为 $C^{\prime}$ 的概率。可以证明(习题4.1),若 $q_{i} ( C^{\prime} | C )$ 满足细致平衡条件,则 $P ( C^{\prime} | C )$ 也满足此条件$^{2}$。由于这一性质,我们可以确定性而非随机性地选择自旋($p_{i} = 1 / N$);也就是说,我们可以对整个格点 $j$ 进行扫描,并在每次更新时使用 $p_{i} = \delta_{i , j}$。
在这个两步过程中,我们不是直接从所有状态的巨大空间中选取下一个状态,而是先限制最终状态的选择范围。更具体地说,如果我们当前处于状态 ${\cal C} = ( 1 , 1 , 1 , 1 , \dots )$,并选定该状态中的第二个自旋作为待翻转候选,那么下一个状态必须从两个状态构成的集合中选取:C 本身和 $C^{\prime} = ( 1 , - 1 , 1 , 1 , . . . )$。因此,在选择第二个自旋的过程中,我们实际上是从相空间的一个二态子集中进行选择。对于所有的初始和最终自旋构型,我们都可以定义这类二态子空间。在伊辛模型的单自旋更新示例中,每一个状态都被此类子空间族的 $N$ 个元素所覆盖,因为待更新的自旋有 $N$ 种选择。
用抽象的语言来说,对于一个覆盖 $\Omega$ 的子空间 $G$ 族 $\mathcal{F}$,单自旋更新马尔可夫过程包含以下步骤:
- 以概率 $P ( G | C )$ 选取一个子空间 $G \in{\mathcal{F}}$
- 以概率 $P ( C^{\prime} | C , G )$ 从 $G$ 中选取新状态 $C^{\prime}$
其中,若 C 不在 G 中,则 $P ( G | C ) = 0$。虽然这些表述是对该过程一种相当形式化的看法,但它们实际上提供了一个简化的视角:我们不是从整个相空间中选取状态,而是先限制子空间,然后从该受限空间中选取状态。正如我们将看到的,后续章节中讨论的几个重要算法都可以归类为此类“两步选择”算法。
我们可以将两步过程的整体转移矩阵视为两个状态之间所有可能路径的和:
$$ P ( C^{\prime} | C ) = \sum_{G} P ( C^{\prime} | C , G ) P ( G | C ) .\tag{4.4} $$因此,如果对于和式中的每一项都满足细致平衡条件,那么整体也满足;即,当以下条件成立时:
$$ P ( C^{\prime} | C , G ) P ( G | C ) W ( C ) = P ( C | C^{\prime} , G ) P ( G | C^{\prime} ) W ( C^{\prime} ) ,\tag{4.5} $$其中 $W ( C )$ 是玻尔兹曼权重(平衡分布)。
4.4 团簇更新#
现在我们探讨两步选择算法的第二个例子,即所谓的团簇算法(cluster algorithms)。这类算法在首次提出时,就明显有别于 Metropolis 或热浴类算法,因为它们涉及无拒绝地翻转自旋的团簇。多年来,人们一直在寻找能执行超出自旋单次更新范围的算法,以缓解模拟中通常遇到的平衡化开销问题,尤其是在连续相变附近;然而,仅仅定义一组局部自旋,即便有好处,通常也微乎其微。在许多应用中,团簇算法的计算自相关时间远短于单自旋算法。有时它们还能减轻符号问题。另一个重要特征是它们可以被并行化(第 13 章),而其他能降低临界慢化的方法往往还不具备这一特性。虽然团簇算法仍是一种两步算法,但其优势在于在问题所涉及物理相关的长度尺度上改变构型,而不是更新定义微观模型的自由度。
算法 7 铁磁伊辛模型的 Swendsen-Wang 团簇算法 输入:当前伊辛构型,$\overline{{K \equiv J / k T}}$ 对每一对相互作用的自旋 $s_{i}$ 和 $s_{j}$ 执行: 以概率 $\delta_{s_{i} , s_{j}} ( 1 - e^{- 2 K} )$ 在它们之间放置一条边 循环结束 对图中每个由连接自旋组成的团簇执行: 以概率 ${\frac{1} {2}} ;$ 翻转团簇中的所有自旋 循环结束 返回:更新后的构型
4.4.1 Swendsen-Wang 算法#
第一个团簇算法由 Swendsen 和 Wang 在 1987 年针对伊辛模型提出(算法 7)。在他们的算法中,一个其边连接两个平行自旋的图,刻画了受限相空间 $G . ^{3}$ 一个图 G 由一个非空顶点集和一个可能为空的边集定义。边表示顶点对之间的无向关系。例如,伊辛模型定义在一个图上:顶点是格点,边是键,指定了自旋相互作用的位点对。
Swendsen-Wang 算法的第一步是构造一个图。这里,图的顶点是格点。边是随机构造的、作为键的子集。第二步,从满足图所施加限制的构型中采样一个构型 C。我们通过翻转“团簇”来完成这个采样,其中团簇是图中由边连接的自旋的集合。
通过增加图的自由度,我们的转移概率矩阵现在具有形式(4.4),从而将证明整个相空间细致平衡条件的任务,转化为展示受限相空间中条件(4.5)的任务。为此,我们引入一组新变量 $\{g_{i j} \}$,表示格点的连接态 $( g_{i j} = 1 )$ 和断开态 $( g_{i j} = 0 )$(即边的有无),并令 G 表示所有 $g_{i j}$ 的集合。我们按如下方式将这些变量与局部相空间的子集关联起来:$g_{i j} = 1$ 与 $( s_{i} , s_{j} ) ~ = ~ ( - 1 , - 1 )$ 或 (1, 1) 相容,而 $g_{i j} ~ = ~ 0$ 与 $( s_{i} , s_{j} ) =$ $( - 1 , - 1 ) , ( - 1 , 1 ) , ( 1 , - 1 )$ 或 (1, 1) 相容。更具体地说,我们将(4.5)中的概率 P(G|C) 写为
$$ P ( G | C ) = \prod_{\langle i j \rangle} P ( g_{i j} | s_{i} , s_{j} ) ,\tag{4.6} $$$$ P ( 1 | s_{i} , s_{j} ) = 1 - P ( 0 | s_{i} , s_{j} ) = \delta_{s_{i} , s_{j}} ( 1 - e^{- 2 K} ) .\tag{4.7} $$现在我们来证明这些条件概率选取的合理性。
我们可以将晶格本身视为一个图,每对相邻格点之间有一条边。在每个格点(顶点)上有一个伊辛自旋变量。让我们在此图上叠加另一张图,该图只在相邻自旋同为向上或同为向下时,才在它们之间放置一条边。叠加的图创建了若干由对齐自旋组成的不连通团簇,然后我们以概率 $\frac{1}{2}$ 翻转每个团簇,从而得到一个新的自旋构型。在本章其余部分,我们将这个叠加图简称为图,并用符号 G 表示。
如果 C 或 $C^{\prime}$ 与 G 不兼容,则 (4.5) 平凡成立,因为方程两边均为零。反之,如果两种状态都属于 $G$,由于算法第二步的随机抛硬币性质,选择最终状态的概率始终为 $1 / 2^{N_{\mathrm{cluster}}}$,与初始或最终状态无关。因此,在 (4.5) 中,有 $P ( C^{\prime} | C , G ) = P ( C | C^{\prime} , G )$。于是,仍需验证的条件是
$$ C , C^{\prime} \in G \Rightarrow P ( G | C ) W ( C ) = P ( G | C^{\prime} ) W ( C^{\prime} ) . $$为证明此式,我们利用 (4.6) 并对该方程两边进行因式分解,得到
$$ \prod_{\langle i j \rangle} P ( g_{i j} | s_{i} , s_{j} ) w ( s_{i} , s_{j} ) = \prod_{\langle i j \rangle} P ( g_{i j} | s_{i}^{\prime} , s_{j}^{\prime} ) w ( s_{i}^{\prime} , s_{j}^{\prime} ) , $$其中 $w ( s_{i} , s_{j} ) = e^{K s_{i} s_{j}}$(参见 (4.2))。利用 (4.7),通过简单观察发现,若自旋对与 $g_{i j}$ 兼容(即 G 施加的约束),则方程两边对应的因子相等:
$$ ( s_{i} , s_{j} ) , ( s_{i}^{\prime} , s_{j}^{\prime} ) \in g_{i j} \Rightarrow P ( g_{i j} | s_{i} , s_{j} ) w ( s_{i} , s_{j} ) = P ( g_{i j} | s_{i}^{\prime} , s_{j}^{\prime} ) w ( s_{i}^{\prime} , s_{j}^{\prime} ) .\tag{4.8} $$具体来说,如果 $g_{i j} = 1$,则 $s_{i} = s_{j}$ 且 $s_{i}^{\prime} = s_{j}^{\prime}$,因此满足 (4.8)。如果 $g_{i j} = 0$,所有自旋构型都与该图兼容,且 $P ( 0 | s_{i} , s_{j} ) w ( s_{i} , s_{j} ) = ( 1 -$ $\delta_{s_{i} , s_{j}} ( 1 - e^{- 2 K} ) ) e^{K s_{i} s_{j}} = e^{K s_{i} s_{j}} - \delta_{s_{i} , s_{j}} ( e^{K} - e^{- K} ) = e^{- K}$,因此 (4.8) 同样成立。这样,我们验证了 Swendsen-Wang 算法的转移概率 (4.6) 满足 (4.5),从而证明了 Swendsen-Wang 算法满足细致平衡。我们在算法7中总结了 Swendsen-Wang 算法,并在图4.2中展示了一个团簇更新周期。
4.4 团簇更新
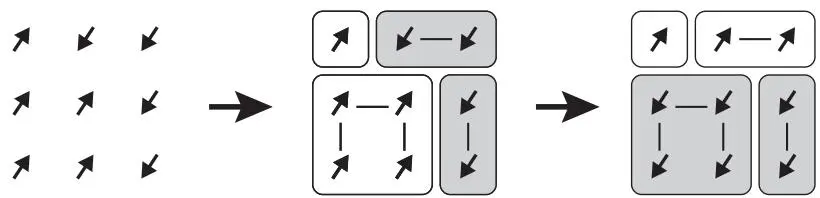
图4.2 Swendsen-Wang 团簇更新伊辛模型的一个周期。
要识别相连自旋构成的团簇,可以使用例如 Hoshen-Kopelman 团簇算法(Hoshen and Kopelman, 1976)。其工作原理如下:对于每个格点,存储一个团簇索引和一个根索引。初始时,团簇索引设为格点索引。通过反复移动到团簇索引中存储的格点,直到团簇索引与格点编号相同(此时该格点即定义为根索引),以此迭代确定一个格点的根索引。如果两个格点通过一条新键连接,则计算它们的根索引,并将这两个格点的团簇索引以及根格点的团簇索引都设为较小的根索引。一旦所有键都插入完毕,每个格点的团簇索引就被设为其根索引。具有相同团簇索引的格点属于同一团簇。该算法的更多细节将在第13.4节中讨论。
蒙特卡洛团簇算法还有一个更简单且更高效的版本,称为 Wolff 算法(Wolff, 1989)。该算法仅构建一个团簇,从一个随机选择的格点开始,并始终翻转它。算法8给出了伪代码。我们将证明 Wolff 算法满足细致平衡留作练习。
4.4.2 图形表示#
将 Swendsen-Wang 团簇算法视为扩展相空间中的一个马尔可夫过程通常很有助益,在该空间中每个状态表示为 $\tilde{C} = ( C , G )$。我们通过使用最初由 Kasteleyn 和 Fortuin(1969)以及 Fortuin 和 Kasteleyn(1972)提出的用于伊辛模型权重的图形分解来实现这一扩展:
$$ e^{K s_{i} s_{j}} = e^{- K} + \delta_{s_{i} , s_{j}} ( e^{K} - e^{- K} ) .\tag{4.9} $$当我们把权重 (4.2) 写成如下形式时,这个非常简单的公式的效用就变得更加明显:
$$ w ( s_{i} , s_{j} ) = e^{K s_{i} s_{j}} = e^{- K} + \delta_{s_{i} , s_{j}} ( e^{K} - e^{- K} ) = \sum_{g_{i j} = 0 , 1} \Delta ( s_{i} , s_{j} | g_{i j} ) \nu ( g_{i j} ) $$其中
$$ \nu ( 0 ) = e^{- K} , \quad \nu ( 1 ) = e^{K} - e^{- K} , \quad \Delta ( s_{i} , s_{j} | 0 ) = 1 , \quad \Delta ( s_{i} , s_{j} | 1 ) = \delta_{s_{i} , s_{j}} . $$算法8 铁磁伊辛模型的 Wolff 算法。 输入:当前伊辛自旋构型,$\overline{{K \equiv J / k T}}$ 随机选择一个格点 i(团簇的根); 对于每个添加的格点 i do 对于每个尚未在团簇上的相互作用格点 j do 如果格点 i 和 j 处的自旋平行,则 以概率 $1 - e^{- 2 K}$ 将 j 添加到团簇中 结束如果 结束对于 结束对于 翻转团簇中的所有自旋; 返回更新后的构型。
将这个关系代入 (4.1) 并使用 (4.2) 得到
$$ Z = \sum_{C} \sum_{G} \Delta ( C , G ) V ( G ) ,\tag{4.10} $$其中 $\begin{array} {r} {V ( G ) \equiv \prod_{\langle i j \rangle} \nu ( g_{i j} )} \end{array}$ 且 $\begin{array} {r} {\Delta ( C , G ) \equiv \prod_{\langle i j \rangle} \Delta ( s_{i} , s_{j} | g_{i j} )} \end{array}$ 是广义克罗内克 δ 表达式,当且仅当图连接的所有自旋彼此平行时取值为1,否则为0。因此,我们将配分函数表示为 $\begin{array} {r} {Z = \sum_{C , G} W ( C , G )} \end{array}$,其中 $W ( C , G ) = \Delta ( C , G ) V ( G )$。
有了这些定义,我们现在将该算法描述为一个两步过程,其特征由转移概率
$$ P_{\mathrm{graph}} ( C^{\prime} , G^{\prime} | C , G ) = P_{\mathrm{graph}} ( G^{\prime} | C ) = {\frac{W ( C , G )} {W ( C )}} $$对于图赋值步骤,以及对于团簇翻转步骤,我们有
$$ P_{\mathrm{{f l i p}}} ( C^{\prime} , G^{\prime} | C , G ) = P_{\mathrm{{f l i p}}} ( C^{\prime} | G ) = {\frac{W ( C^{\prime} , G )} {W ( G )}} $$其中 $\begin{array} {r} {W ( C ) = \sum_{G} W ( C , G^{\prime} )} \end{array}$ 和 $\begin{array} {r} {W ( G ) = \sum_{C} W ( C , G )} \end{array}$
我们还可看到,在 (4.10) 中,对自旋变量进行部分求和很容易,因为因子 $\Delta ( C , G )$ 将状态限制为通过随机团簇翻转生成的状态。如果 $G$ 中有 $N_{c} ( G )$ 个连通团簇,则这样的状态只有 $2^{N_{c} ( G )}$ 个。所有这些状态都具有相同的权重。因此,对自旋变量进行部分求迹仅产生 $2^{N_{c} ( G )}$,于是我们得到
$$ Z = \sum_{\boldsymbol{G}} V ( \boldsymbol{G} ) q^{N_{c} ( \boldsymbol{G} )} ,\tag{4.11} $$对于伊辛模型,$q = 2$。取 $q = 3 , 4 , \dots$,我们得到 q 态 Potts 模型的配分函数。该公式也可用于研究非整数 $q$ 的 q 态 Potts 模型(Blote and Nightingale, 1982)。类似的技术同样适用于 SU(N) 量子海森堡模型(Beach et al., 2009)。
4.4.3 关联函数与团簇大小#
团簇算法相较于单自旋翻转算法具有更短自相关时间的原因在于,团簇算法以物理尺寸与系统固有空间关联长度相当的单元来更新系统状态。例如,在 Swendsen-Wang 算法中,空间关联的典型范围与团簇的平均大小通过以下公式相关联
$$ \langle s_{i} s_{j} \rangle = {\mathrm{Prob}} ( ^{\ast} i {\mathrm{~ 和 ~}} j {\mathrm{~ 处于同一团簇}}^{\prime \prime} ) .\tag{4.12} $$为证明这一点,我们将左侧表示为
$$ \begin{array} {l} {{\displaystyle \langle s_{i} s_{j} \rangle = \sum_{C , G} W ( C , G ) s_{i} s_{j} = \sum_{G} W ( G ) \sum_{C} P ( C | G ) s_{i} s_{j}}} \\ {{\displaystyle ~ = \sum_{G} W ( G ) \chi ( ^{*} i {\text{和}} j {\text{处于同一团簇}}^{\prime \prime} )}} \\ {{\displaystyle ~ = \langle \chi ( ^{*} i {\text{和}} j {\text{处于同一团簇}}^{\prime \prime} ) \rangle_{\mathrm{MC}}}} \end{array} $$其中,若该陈述为真,则 $\chi ( \mathrm{^{* *} s t a t e m e n t^{3}} ) = 1$,否则 $\chi ( \mathrm{^{* *} s t a t e m e n t^{*}} ) = 0$。这直接从最后一个方程(4.12)得出。
方程(4.12)表明,典型团簇的线性尺寸大致正比于空间关联长度。在蒙特卡洛模拟过程中,会出现各种自旋构型。如果系统接近或已经处于平衡态,那么存在许多上自旋和下自旋的团簇,每个团簇中的自旋方向一致。这些团簇的典型尺寸与空间关联长度相当。当我们使用单自旋更新算法时,团簇出现或消失的过程需要很长时间,因为该过程通常涉及边界传播。
图4.3以一维伊辛模型为例展示了这一情况,其中系统通过扭结扩散来弛豫。这种传播方式正是弛豫时间依赖于团簇尺寸(从而依赖于关联长度)的原因。自相关时间实际上正比于关联长度的某次幂(通常接近2,反映了畴壁运动的扩散性质)。而在团簇算法中,只需一个蒙特卡罗步骤就可修改与关联长度尺度相当的空间结构。
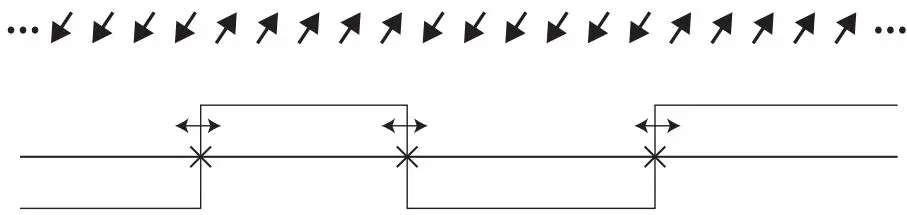
图4.3 一维伊辛模型中单自旋更新通过扭结扩散的弛豫过程
我们注意到,(4.1)和(4.11)中的配分函数具有相同的值,但都将模型的玻尔兹曼分布表达为对两组不同自由度的求和。虽然(4.1)中的自旋构型是模型定义中最明显的自由度,但(4.11)中使用的图在模型接近临界点的物理性质方面是最自然的。如果我们在远离临界点的高温下进行模拟,由于模型的物理性质发生变化,Swendsen-Wang算法会失去其效率优势。此时,团簇构建的计算成本反而成为一个劣势。
4.5 虫洞更新(Worm updates)#
到目前为止,我们看到了两种针对定义在格点上的多体问题的两步蒙特卡洛算法的不同示例:局域更新和团簇更新。对于伊辛模型,由于其由自旋变量定义,自然可以考虑在自旋构型空间 $\Omega \equiv \{C \} = \{( s_{1} , s_{2} , . . . , s_{N} ) \}$ 上定义的马尔可夫过程。然而,通常有可能且通常非常有利的是,将原始问题重新表述为用一组新的自由度定义的问题。我们现在讨论这种问题的重新表述(Prokof'ev 和 Svistunov, 2001)。
我们从伊辛模型的高温级数展开开始,该展开可通过分解局域玻尔兹曼因子并利用简单恒等式 $e^{\pm x} = ( \cosh x ) ( 1 \pm \operatorname{tanh} x )$ 得到,
$$ Z = \sum_{C} \prod_{\langle i j \rangle} e^{K s_{i} s_{j}} \propto \sum_{C} \prod_{\langle i j \rangle} ( 1 + t s_{i} s_{j} ) , $$其中 $t \equiv \operatorname{tanh} K$。在最后一个表达式中,我们忽略了常数因子 (cosh $K )^{N_{\mathrm{bonds}}}$,其中 $N_{\mathrm{bonds}}$ 是晶格中相互作用的自旋对数。通过展开括号,我们得到许多项。每一项对应一个图 G,该图由格点作为顶点和与 $t s_{i} s_{j}$ 相关的边上的键组成。(选择1而非 $t s_{i} s_{j}$ 的边不包含在G中。)由此得到的配分函数公式为
$$ Z = \sum_{C} \sum_{\cal G} t^{| {\cal G} |} \prod_{i} s_{i}^{n_{i} ( G )} .\tag{4.13} $$这里,符号 G 表示在格点上定义的图,|G| 表示 G 中的边数,而 $n_{i} ( G )$ 表示 G 中与顶点 i 相连的边数。
让我们先对 C 求和,再对 G 求和。如果对任意给定的 i,$n_{i} ( G )$ 是奇数,那么对 C 的求和会消去该项,因为 $\textstyle \sum_{s_{i} = \pm 1} s_{i}^{n} = 0$(当 n 为奇数时)。因此,我们可以忽略所有包含“奇”顶点的图。若一个图没有任何奇顶点,我们称之为闭合图。由此,除了一个整体数值常数外,配分函数可以简单地写为
$$ Z = \sum_{G \in \Omega_{0}} t^{| G |} .\tag{4.14} $$现在,相空间 $\Omega_{0}$ 是格点上所有闭合图的集合,我们的任务是构建一个马尔可夫过程,以正比于 $t^{| G |}$ 的频率生成闭合图。注意,(4.11) 和 (4.14) 都将配分函数表示为对图的求和,但这些图的性质截然不同。此外,与之前研究的情况不同,新的相空间 $\Omega_{0}$ 由于“无奇顶点”约束而具有复杂的结构,不能表示为多个局部相空间的简单乘积:我们不能简单地随机选择一对最近邻位点,然后移除或添加连接它们的边来提议一个新状态或闭合图,因为这样操作会产生一个具有两个奇顶点的状态,而这样的状态对配分函数没有贡献。
我们可以做的是,在我们的相空间中允许那些对配分函数没有贡献的“人造”状态。在采样过程中,我们随机生成状态(有些是闭合图,有些是人造状态),但对于测量,我们丢弃所有人工状态,只计数“真实”状态。如果我们让人造状态中的奇顶点最多不超过两个,我们就有很大机会以足够高的频率观察到闭合图。为了维持这个条件,当我们添加一条新边时,我们让它的一端覆盖一个奇顶点;当我们移除一条边时,我们移除一条具有奇端点之一的边。这样,我们将奇顶点的位置移动了一个格距。算法 9 描述了该过程。在此算法中,我们引入两个奇顶点,分别称为头和尾。我们通过将头从当前位置移动到其最近邻位点之一来添加或移除一条边。
允许最多两个奇顶点意味着我们将相空间从零奇顶点空间 $\Omega_{0}$ 扩展到了 $\Omega_{0} \cup \Omega_{2}$,其中 $\Omega_{2}$ 是具有两个奇顶点的图空间。由于 $\Omega_{2}$ 中状态的权重没有先验定义,这变成了我们可以根据自己的方便选择的参数。我们选择一个权重,它不仅覆盖了 $\Omega_{2}$,而且还复现了之前对 $\Omega_{0}$ 权重的定义:
算法 9 伊辛模型的虫洞算法 输入:带或不带虫的高温级数构型。 如果头和尾不存在,则 均匀随机选择一个位点,将头和尾放置在该位点上; 否则如果头与尾在相同位置,则 移除头和尾; 结束条件判断 如果存在头和尾,则 随机选择头运动的方向; 以概率 p 将头朝此方向移动并改变边状态,其中如果边存在则 p = 1,否则 p = t; 结束条件判断 返回更新后的构型。
$$ W ( G ) = a^{\nu ( G )} t^{| G |} . $$这里 a 是一个我们稍后会固定的常数,而 $\nu ( G )$ 是 G 中奇顶点的数量。现在我们的新任务是以权重 $W ( G )$ 生成 $\tilde{\Omega} = \Omega_{0} \cup \Omega_{2}$ 中的图 G。对于一个均匀格点,我们可以通过算法 9 (Prokof'ev and Svistunov, 2001) 来实现。
我们注意到,$\Omega_{2}$ 中的人造状态包括两个奇顶点恰好位于同一位点的情况。除了虚构奇顶点对的位置被定义,并且相对于 $\Omega_{0}$ 中的对应状态贡献了一个权重因子 $a^{2}$ 之外,这种状态与 $\Omega_{0}$ 中的状态相同。算法 9 条件判断中的前两种情况代表了这两种状态之间的转移,例如,$G \in \Omega_{0}$ 和 $G^{\prime} \in \Omega_{2}$。它们之间的细致平衡条件为
$$ {\frac{1} {N}} \times W ( G ) = 1 \times W ( G^{\prime} ) ,\tag{4.15} $$由此可得 $a^{2}$ 应为 $1 / N$。
这个头部创建/湮灭过程的描述相当形式化,主要是为了提醒我们正在使用的相空间结构(特别是 $\Omega_{0}$ 仍然存在)。在实际操作中,我们省略了在 $\Omega_{0}$ 和 $\Omega_{2}$ 之间来回切换的步骤,并将过程简化为算法 10 所述。
现在考虑算法 9 条件判断中的第三种情况,即存在 worm 并且头部与尾部分离。在这种情况下,我们随机移动头部。我们首先随机选择尝试方向,然后以概率 $p = 1$($p = t$)将该头部向该方向移动(如果存在一条边(如果没有边))。之后,我们改变边的状态。假设尝试方向上没有边。那么,运动结束时的状态,例如 $G^{\prime}$,比 G 多一条边,并且由于每条边携带权重 t,我们有 $W ( G^{\prime} ) = t W ( G )$。从初始状态 G 到最终状态 $G^{\prime}$ 的概率流是三个概率的乘积:选择该方向的概率 $1 / z_{i}$,其中 $z_{i}$ 是当前头部所在格点 i 的配位数(coordination number),接受该运动的概率 t 以及该状态的目标概率 $(\propto W ( G ))$。我们以类似的方式表达相反方向的概率流,然后将细致平衡条件写为
算法 10 均匀格点上伊辛模型的 worm 算法(简化版)。 输入:具有头部和尾部的 worm 构型。 if 头部与尾部在同一位置 then 随机选择一个格点,将头部和尾部移动到该位置; end if 随机选择头部运动的方向; 以概率 p 向该方向移动头部,并改变边的状态 (如果边存在则 $p = 1$,否则 $p = t$); 返回更新后的构型。
$$ \frac{1} {z_{i}} \times t \times W ( G ) = \frac{1} {z_{j}} \times 1 \times W ( G^{\prime} ) . $$由于在均匀格点上 $z_{i} = z_{j}$ 是常数,并且如我们之前所述 $W ( G^{\prime} ) = t W ( G )$,因此该等式成立。这样,我们确认了细致平衡。类似地,我们可以确认当头部运动方向上存在一条边时的细致平衡。我们在图 4.4 中展示了 worm 算法的一个循环。
在上述推导中,引入 $\Omega_{2}$ 可能看起来只是一种使整个过程有效的技巧。然而,它在测量两点关联函数方面起着另一个重要且有用的作用。与团簇更新算法一样,在当前框架内计算两点关联函数的方式是理解 worm 更新算法本质特性的关键。在高温级数展开中,两点关联函数为
$$ \left. s_{i} s_{j} \right. = \frac{Z_{i j}} {Z} , \quad Z_{i j} \equiv N \sum_{G \in \Omega_{i j}} W ( G ) , $$where $\Omega_{i j}$ is the set of graphs that have the head and the tail on the sites $i$ and $j$ . The reader can see that the configurations after moving the head in the worm algorithm update process sample the states in $\cup_{i j} \Omega_{i j}$ without additional cost for the measurement. In other words, in the setup of the worm algorithm, we have data of the number of times each pair $(i, j)$ appears in the worm state during the MCMC simulation. From this data, we can compute $Z_{i j} / Z$ with high statistical accuracy.
This is one of the most important characteristics of the worm algorithm: in addition to the spin updates, it can naturally measure the two-point correlation function. It is particularly useful in the study of the critical behavior, where the correlation length is large, because the worm algorithm can directly sample the correlation function between arbitrarily distant spins without requiring the entire system to be equilibrated at each measurement. Additionally, the worm algorithm can be used to compute the correlation length, the susceptibility, and other physical quantities that are related to the two-point correlation function. The efficiency of this algorithm stems from the fact that the head is a local object that moves in configuration space, and each movement of the head generates a sample point for the correlation function.
We conclude this section by mentioning that the worm algorithm can be extended to other models and to more complicated geometries. For example, it can be applied to the $q$-state Potts model, the hard-core model, and the loop gas models. The key ingredient is the existence of a high-temperature series expansion or a similar representation in which the Boltzmann weight factorizes into elementary building blocks that can be interpreted as the building blocks of a graph. In each case, the worm algorithm provides an efficient way to simulate many-body systems, and its ability to measure correlation functions is a powerful tool in the study of phase transitions and critical phenomena.
Finally, let us note that there are several variants of the worm algorithm, such as the directed worm algorithm (directed worm), which is particularly useful in the simulation of quantum systems, and the loop-worm algorithm (loop-worm), which combines the loop algorithm and the worm algorithm to improve efficiency further. All these variants share the same basic idea of using a local excitation to update the configuration and measure correlation functions.