第3章 · 蒙特卡洛采样与马尔可夫链#
3.1 引言#
蒙特卡洛方法表示一大类基于重复随机采样(random sampling)来解决多种数学和物理问题的数值算法。典型问题涉及大和或积分的计算,其革命性思想在于我们并不进行精确枚举/积分,而是生成随机样本,然后将这些样本加起来以近似精确结果。因此,采样(sampling)概念在任何蒙特卡洛方法中都至关重要:其含义就是产生构型(configuration)的随机示例(例如,分布在盒子中的N个经典粒子),这些示例用于对正在考察的精确量(例如,固定温度下的内能)给出准确估计。
蒙特卡洛方法的根源可追溯到恩里科·费米(Enrico Fermi)在20世纪30年代初研究中子扩散时的尝试。他并未发表任何相关成果,但因其提出了一个思想——即不含时薛定谔方程(time-independent Schrödinger equation)可以解释为执行随机游走(random walk)的粒子系统——而获得了赞誉(Metropolis 和 Ulam,1949)。几年后,斯坦尼斯瓦夫·乌拉姆(Stanislaw Ulam)在洛斯阿拉莫斯国家实验室从事核武器项目时,取得了根本性进展。他关于蒙特卡洛方法的初步想法源于一次生病康复期间玩纸牌接龙时出现的疑问。乌拉姆试图根据牌的初始布局来计算获胜的可能性。在进行了穷举组合计算后,他决定采用一种更实用的方法:尝试许多不同的布局,并观察成功的游戏次数。当时,快速计算机的新时代刚刚开始,约翰·冯·诺依曼(John von Neumann)理解了乌拉姆建议的相关性,并提出了一种统计方法来解决可裂变材料中中子扩散的问题。乌拉姆和冯·诺依曼共同开发了包括重要性采样(importance sampling)和拒绝采样(rejection sampling)在内的算法,这些算法是所有现代蒙特卡洛技术的基础。此外,冯·诺依曼意识到使用真正的随机数极其缓慢,因此开发了一种通过所谓平方取中法(middle-square digit method)来获取伪随机数(pseudo-random number)的方法。乌拉姆和冯·诺依曼需要为他们的秘密项目——使用这些随机方法进行的项目——取一个代号。于是,同样在洛斯阿拉莫斯国家实验室工作的尼古拉斯·梅特罗波利斯(Nicholas Metropolis)建议了蒙特卡洛(Monte Carlo)这个名字,这指的是摩纳哥的蒙特卡洛赌场,乌拉姆的叔叔曾在那里赌牌(Metropolis 和 Ulam,1949)。Metropolis(1987)对蒙特卡洛方法的早期岁月进行了精彩的回顾。
尽管蒙特卡洛方法的首次测试是在中子输运的各种问题上进行的,但真正的突破发生在1952年,当时一台名为MANIAC的新型计算机在洛斯阿拉莫斯实验室投入运行(Anderson,1986):梅特罗波利斯与阿里安娜·罗森布鲁斯(Arianna Rosenbluth)、马歇尔·罗森布鲁斯(Marshall Rosenbluth)、奥古斯塔·泰勒(Augusta Teller)和爱德华·泰勒(Edward Teller)共同研究了硬球二维运动的物态方程(Metropolis 等,1957)。他们开发了一种策略来提高描述热平衡系统(即服从玻尔兹曼分布函数(Boltzmann distribution function)的系统)时的计算效率。根据这一策略,如果一个粒子的统计移动导致总能量减少,则接受新构型。相反,如果总能量增加,则新构型仅当通过一个由玻尔兹曼因子(Boltzmann factor)偏置的碰运气游戏时才被接受。否则,新构型保持与旧构型相同。这个基于随机游走的所谓梅特罗波利斯算法(Metropolis algorithm),是计算方法中使用最广泛的数值算法之一,并被列入“对20世纪科学与工程发展与实践影响最大”的十大算法之列(Dongarra 和 Sullivan,2000)。近年来,计算机的快速进步使得在许多科学分支——包括数学、物理学、化学——取得了令人难以置信的成就,但蒙特卡洛方法也经常用于经济科学中预测股票市场的行为。
在本节中,我们论证了使用蒙特卡洛采样计算积分的方法,这是蒙特卡洛方法最简单的应用。事实上,假设我们需要计算以下 d 维积分:
$$ \mathcal{I} = \int \mathbf{dx} F ( \mathbf{x} ) ,\tag{3.1} $$其中 $F ( \mathbf{x} )$ 是 d 分量向量 x 的任意函数。那么,不失一般性,我们总可以将 $F ( \mathbf{x} )$ 分解为一个概率密度 ${\mathcal{P}} ( \mathbf{x} )$(满足 $\mathcal{P} ( \mathbf{x} ) \geq 0$ 且 & dx $\mathcal{P} ( \mathbf{x} ) = 1$)和一个函数 $f ( \mathbf{x} ) = F ( \mathbf{x} ) / \mathcal{P} ( \mathbf{x} )$:
$$ \mathcal{T} = \langle{f ( {\bf{x}} )} \rangle = \int{\bf{dx}} f ( {\bf{x}} ) \mathcal{P} ( {\bf{x}} ) ,\tag{3.2} $$这无非是随机变量 $f ( \mathbf{x} )$ 在分布函数 ${\mathcal{P}} ( {\bf x} )$ 上的期望值,即式 (2.29) 的多维推广。然后,中心极限定理表明,这个确定性的积分等于通过大量采样计算 $f ( \mathbf{x} )$ 平均值得到的随机变量:
$$ \left. f ( \mathbf{x} ) \right. = \int \mathbf{dx} f ( \mathbf{x} ) ~ \mathcal{P} ( \mathbf{x} ) \approx \frac{1} {N} \sum_{i} f ( \mathbf{x}_{i} ) ,\tag{3.3} $$其中右侧求和中的 $\mathbf{x}_{i}$ 值根据概率密度 ${\mathcal{P}} ( \mathbf{x} )$ 分布。事实上,对于大 N,变量:
$$ \bar{f} = \frac{1} {N} \sum_{i} f ( \mathbf{x}_{i} )\tag{3.4} $$服从高斯(正态)分布,其均值等于 $\langle f ( \mathbf{x} ) \rangle$,方差为 $\sigma^{2} / N$,其中 $\sigma^{2} = \langle f^{2} ( \mathbf{x} ) \rangle - \langle f ( \mathbf{x} ) \rangle^{2}$。因此,当 $N \to \infty$ 时,随机变量 $\bar{f}$ 趋向于确定性数值 $\langle f ( \mathbf{x} ) \rangle$(因为涨落以 $1 / \sqrt{N}$ 的速度趋近于零)。这就是式 (3.3) 的含义,其中左侧是确定性数值,右侧是随机变量。
总之,随机计算(数值模拟)的有效性基于这样一个事实:当采样数 N 足够大时,由统计涨落引起的误差趋近于零,这意味着模拟的误差棒可以得到控制。在这一意义上,我们有:
$$ \int \mathrm{d} \mathbf{x} f ( \mathbf{x} ) ~ \mathcal{P} ( \mathbf{x} ) \approx \langle \langle f ( \mathbf{x}_{i} ) \rangle \rangle ,\tag{3.5} $$其中 $\langle \langle \dots \rangle \rangle$ 表示对许多独立样本(根据 $\mathcal{P} ( \mathbf{x} )$ 分布)的统计平均值。我们强调,任何不带误差棒的随机平均值都是完全没有意义的,因为人们无法了解模拟的精度。积分的估计由 ${\bar{f}}$ 给出,而误差棒则可以通过 $\sigma^{2}$ 的估计量(参见式 (2.61))得到:
$$ s^{2} = \frac{1} {N} \sum_{i} \left[ f ( \mathbf{x}_{i} ) - \overline{{f}} \right]^{2} .\tag{3.6} $$随机计算的主要问题在于:(i) 生成按照期望概率密度 ${\mathcal{P}} ( \mathbf{x} )$ 分布的构型 $\mathbf{x}_{i}$,以及 (ii) 对这些构型计算函数 $f ( \mathbf{x}_{i} )$ 的值。
当能够以概率密度 ${\mathcal{P}} ( \mathbf{x} )$ 生成构型时,我们称之为直接采样(direct sampling);在这种情况下,所有构型都是相互独立的。遗憾的是,这仅在少数情况下可行,且仅适用于依赖于少量变量 x 的非常简单概率密度(例如 $d \ : = \ : 1$ 的情况)。在一般情况下,我们无法直接对概率密度进行采样,必须设计间接方法来获得这样的构型。这就是所谓的马尔可夫链(Markov chain)的情形,该命名是为了纪念俄罗斯数学家安德烈·安德烈耶维奇·马尔可夫。在接下来的内容中,我们将详细介绍直接采样和马尔可夫链理论。特别地,尽管马尔可夫链方法非常通用,可应用于多种情况,但直接采样可用于对离散概率进行采样,此时所有可能结果的总数可以枚举并存储在计算机中(但在 $d > 1$ 的情况下,极少用它来对连续变量进行采样)。
3.2 重加权技术与相关采样#
在讨论直接采样之前,我们简要阐述重加权(reweighting)的概念。这个概念允许我们,在已经对 ${\mathcal{P}} ( \mathbf{x} )$ 进行了采样后,仍能获得函数 $f ( \mathbf{x} )$ 关于概率 $\mathcal Q ( {\mathbf x} )$ 的平均值。事实上,假设我们有两个概率 ${\mathcal{P}} ( \mathbf{x} )$ 和 $\mathcal Q ( {\mathbf x} )$,它们分别由其对应的权重 $\mathcal{W}_{p} ( \mathbf{x} )$ 和 $\mathscr{W}_{q} ( \mathbf{x} )$ 定义:
$$ \mathcal{P} ( \mathbf{x} ) = \frac{\mathcal{W}_{p} ( \mathbf{x} )} {\int \mathbf{dx} \mathcal{W}_{p} ( \mathbf{x} )} ,\tag{3.7} $$$$ \mathcal{Q} ( \mathbf{x} ) = \frac{\mathcal{W}_{q} ( \mathbf{x} )} {\int \mathbf{dx} \mathcal{W}_{q} ( \mathbf{x} )} .\tag{3.8} $$那么,从一般原理出发,我们有:
$$ \frac{\int \mathbf{dx} f ( \mathbf{x} ) \mathcal{W}_{q} ( \mathbf{x} )} {\int \mathbf{dx} \mathcal{W}_{q} ( \mathbf{x} )} = \frac{\int \mathbf{dx} f ( \mathbf{x} ) \mathcal{R} ( \mathbf{x} ) \mathcal{W}_{p} ( \mathbf{x} )} {\int \mathbf{dx} \mathcal{R} ( \mathbf{x} ) \mathcal{W}_{p} ( \mathbf{x} )} ,\tag{3.9} $$其中 $\mathcal{R} ( \mathbf{x} ) = \mathcal{W}_{q} ( \mathbf{x} ) / \mathcal{W}_{p} ( \mathbf{x} )$ 是两个权重的比值。因此,对于新概率 $\mathcal Q ( {\mathbf x} )$ 的统计采样可以用对 ${\mathcal{P}} ( \mathbf{x} )$ 的采样来表示:
$$ \langle \langle f ( \mathbf{x} ) \rangle \rangle_{\mathcal{Q}} = \frac{\langle \langle f ( \mathbf{x} ) \mathcal{R} ( \mathbf{x} ) \rangle \rangle_{\mathcal{P}}} {\langle \langle \mathcal{R} ( \mathbf{x} ) \rangle \rangle_{\mathcal{P}}} ,\tag{3.10} $$其中 $\langle \langle \dots \rangle \rangle_{\mathcal{Q}}$ 和 $\langle \langle \dots \rangle \rangle_{\mathcal{P}}$ 分别表示对 $\mathcal Q ( {\mathbf x} )$ 和 ${\mathcal{P}} ( \mathbf{x} )$ 的统计采样。
于是,从 ${\mathcal{P}} ( \mathbf{x} )$ 获得的同一组采样(即构型集 $\left\{{\bf x}_{i} \right\}$)可用于计算对 $\mathcal Q ( {\mathbf x} )$ 的平均。这种方法引出了关联采样(correlated sampling)的概念,因为两个量是用同一组构型来计算的。当然,为了对重加权量 $\langle \langle f ( \mathbf{x} ) \rangle \rangle_{\mathcal{Q}}$ 得到精确的统计(即小的误差棒),两个权重必须相当接近,否则构型 $\left\{\mathbf{x}_{i} \right\}$ 会落在 $\mathcal Q ( {\mathbf x} )$ 很小的区域,因而对最终结果不重要。
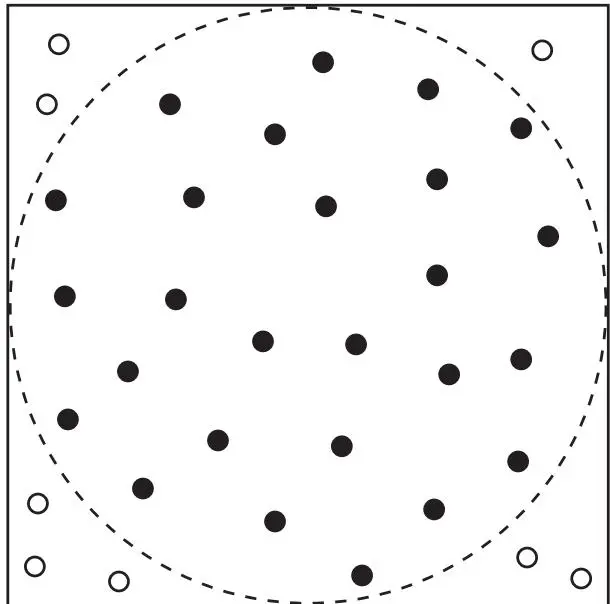
图3.1 计算π的直接采样蒙特卡洛方法。我们在正方形内随机射入子弹,对于大量试验次数 N(即 $N \to \infty$),圆内子弹数与总试验数之比趋近于 π $/ 4$;详见正文。
3.3 直接采样#
为了讨论直接采样(direct sampling)方法,我们先从一个简单例子入手。假设我们想用随机方法来计算 π,那么可以画一个半径为 r 的圆和一个恰好包含该圆的正方形,即边长为 $L = 2 r$,见图3.1。然后,我们向正方形内随机射入子弹,并记录每次试验;每当子弹落在圆内时,就将“命中”数加一。通过记录试验数和命中数,我们可以进行直接采样蒙特卡洛计算:对于大量试验次数 N,命中数与试验数之比趋近于圆与正方形的面积之比:
$$ \frac{\pi} {4} = \frac{\int_{\mathrm{circle}} d x d y} {\int_{\mathrm{square}} d x d y} = \int_{\mathrm{square}} d x d y f ( x , y ) \mathcal{P} ( x , y ) ,\tag{3.11} $$其中
$$ {\mathcal{P}} ( x , y ) = {\frac{1} {\int_{\mathrm{square}} d x d y}} ,\tag{3.12} $$且
$$ f ( x , y ) = {\left\{\begin{array} {l l} {1} & {{\mathrm{~ i f ~}} ( x , y ) {\mathrm{~ i s ~ i n s i d e ~ t h e ~ c i r c l e ,}}} \\ {0} & {{\mathrm{~ o t h e r w i s e .}}} \end{array} \right.}\tag{3.13} $$函数 ${\mathcal{P}} ( x , y )$ 是非负且归一化的,因此它可以很好地表示一个概率函数。向正方形内射子弹意味着生成一对随机数(一个对应 x,另一个对应 y),它们在0到 L 之间均匀分布:
$$ \frac{\pi} {4} \approx \frac{1} {N} \sum_{i} f ( x_{i} , y_{i} ) .\tag{3.14} $$这是我们可以用随机(即蒙特卡洛)方法计算积分的第一个(也是最简单的)例子。一般来说,任何(多维)积分,如式(3.1),原则上都可以通过在整个积分区间内均匀抽取随机数,然后在这些点上计算函数值 $f ( \mathbf{x}_{i} )$ 来进行。然而,如果 $f ( \mathbf{x} )$ 是一个尖锐峰值函数,这种均匀采样的方式效率不高,因为我们会计算许多点 $\mathbf{x}_{i}$,在这些点上函数 f (x) 对积分贡献可忽略,而只有少数点给出有限贡献。在这种情况下,必须采用一些技巧来改进采样过程,我们将在下面讨论。
3.4 重要性采样#
当需要计算的函数 $f ( \mathbf{x} )$ 具有尖锐峰值时,均匀采样效率低下,因为它会浪费大量时间,耗费精力去访问那些对最终结果贡献可忽略的区域。克服这一问题的一个简单方法是考虑所谓的重要性采样(importance sampling)。这一思想非常通用,并用于多种蒙特卡洛计算中。尽管如此,我们可以在一维积分的简单情形下解释它。事实上,假设我们要计算:
$$ {\mathcal{T}} = \int_{a}^{b} d x F ( x ) ,\tag{3.15} $$其中 $F ( x )$ 是一个在 $a$ 和 $b$ 之间某点处有峰值的函数。当我们知道函数 $F ( x )$ 取值较大的相关区域(的近似位置)时,我们就可以在 $[ a , b ]$ 上定义一个概率密度 ${\mathcal{P}} ( x )$(即 ${\mathcal{P}} ( x ) > 0$ 且 $\begin{array} {r} {\int_{a}^{b} d x \mathcal{P} ( x ) = 1 )} \end{array}$ ,该概率密度在这些区域内也取值较大,而在其他区域取值很小。然后,我们可以将原始积分重写为:
$$ {\mathcal{T}} = \int_{a}^{b} d x {\frac{F ( x )} {{\mathcal{P}} ( x )}} {\mathcal{P}} ( x ) .\tag{3.16} $$现在,如果我们能够生成一个按照 ${\mathcal{P}} ( x )$ 分布的随机数,我们就可以计算积分 $\mathcal{T}$ 为:
$$ \mathcal{T} \approx \frac{1} {N} \sum_{i} \frac{F ( x_{i} )} {\mathcal{P} ( x_{i} )} ;\tag{3.17} $$相应的误差棒可以通过下式估算:
$$ s^{2} = \frac{1} {N} \sum_{i} \left[ \frac{F ( x_{i} )} {\mathcal{P} ( x_{i} )} \right]^{2} - \left[ \frac{1} {N} \sum_{i} \frac{F ( x_{i} )} {\mathcal{P} ( x_{i} )} \right]^{2} .\tag{3.18} $$其关键在于,如果 ${\mathcal{P}} ( x )$ 选择得足够接近 $F ( x )$ ,那么统计波动将会被极大降低。实际上,$s^{2}$ 是一个非负数,其最小值 $s^{2} = 0$ 在 $\mathcal{P} ( x ) \propto F ( x )$ 时达到。在这种情况下,蒙特卡洛采样没有波动。必须强调的是,这个极限情况是平凡的,蒙特卡洛方法在此并无用处:如果我们能够提取出按照 $\mathcal{P} ( x ) \propto F ( x )$ 分布的随机数,那么我们就已经解析地完成了这个积分。相反,在实际情况下,只要 ${\mathcal{P}} ( x )$ 与函数 $F ( x )$ 相似,统计波动就会显著降低,从而减少达到给定精度所需的采样次数。
通常,存在一些复杂的算法可以生成长序列的、基本不相关且均匀分布的随机数(或者更准确地说,伪随机数,见附录 $\mathbf{A} $)。因此,如果我们想要生成按照不同概率函数分布的随机数,还需要做一些额外的工作。下面,我们将讨论一些可以完成此任务的简单情形,以及一般情况下的困难。
3.5 离散分布概率采样#
这里,我们将讨论如何对离散概率分布 $P ( k )$ 进行采样,其中 $k = 1 , \ldots , M$ 是互斥事件。一种选择是使用所谓的接受-拒绝方法(或更简单地,仅称为拒绝方法)。这种方法也可用于对连续变量进行采样,并且与我们在 3.3 节中计算 $\pi$ 时说明的方法密切相关。在实践中,我们将概率 $P ( k )$ 的直方图嵌入一个大的矩形板中,然后向其投掷点(假设这些点在板中均匀分布),见图3.2。设 $P_{\mathrm{max}}$ 为 $P ( k )$ 的最大值;然后,我们生成两个均匀分布的随机数:第一个,$r_{1}$ 在 $[ 0 , 1 )$ 区间内,用于得到事件 $k_{r} = \operatorname*{int} ( M \times r_{1} ) + 1$(其中 int(x) 表示 x 的整数部分);第二个,$r_{2}$ 在 $[ 0 , {P_{\mathrm{max}}} )$ 区间内。如果 $r_{2} \ \leq \ P ( k_{r} )$ ,则该次试验成功,输出 $k_{r}$ ;否则,该次试验被拒绝,并生成另一对随机数。显然,得到给定事件 k 的概率与 $P ( k )$ 成正比,因为事件是均匀生成的,但仅在 $r_{2} \le P ( k )$ 时才被接受。
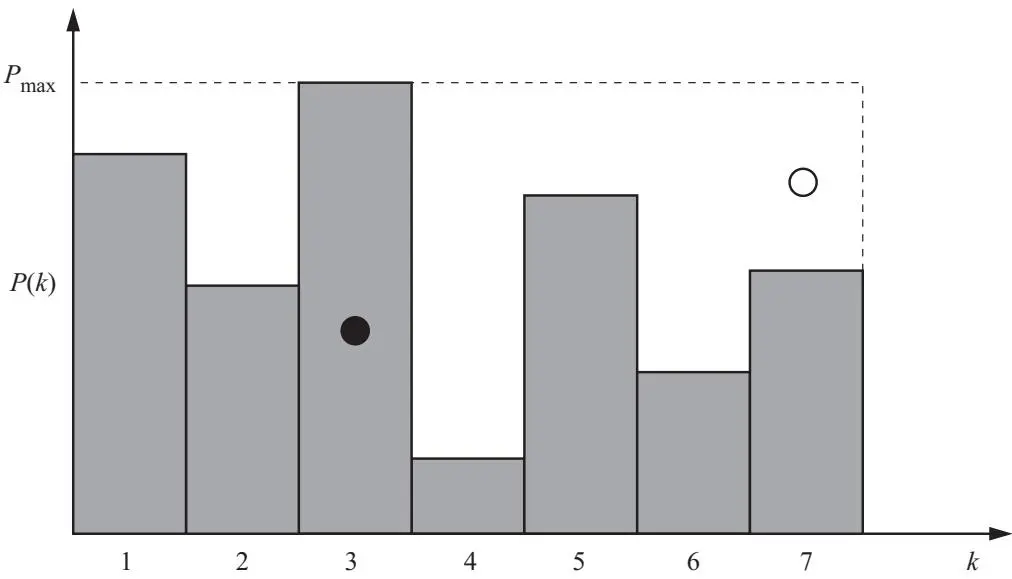
图3.2 用于采样离散概率 $P ( k )$ 的拒绝方法,其中 $k = 1 , \ldots , M$ 是可能的输出结果(此处 $M = 7$)。生成两个均匀分布的随机数:$r_{1}$ 在 [0, 1) 区间内以得到事件 $k_{r} = \operatorname{int} ( M \times r_{1} ) + 1$,$r_{2}$ 在 $[ 0 , P_{\mathrm{max}} )$ 区间内。如果 $r_{2} \le P ( k_{r} )$,则该次试验成功并取 $k_{r}$(实心点选择了 $k_{r} = 3$);否则,该次试验被拒绝(空心点表示被拒绝的 $k_{r} = 4$ 事件),并生成另一对随机数。
这种方法效率并不高,因为有一部分试验会被拒绝,因此无法产生任何输出。不过,被拒绝试验的计算成本并不大,因为它只需要生成两个随机数。从图3.2可以清楚地看出,拒绝概率与 $\begin{array} {r} {\sum_{k} ( P_{\operatorname*{max}} - P_{k} ) = M P_{\operatorname*{max}} - 1} \end{array}$ 成正比,这部分正是矩形板中位于直方图上方区域的面积。在平凡(且无用)的情况下,即所有事件都是等可能的,且 $P_{\mathrm{max}} ~ = ~ 1 / M$,那么所有试验都会被接受。相反,当一个事件的概率远大于其他所有事件时,被拒绝的试验数量会非常大,算法也因而变得非常低效。
事实上,有一种更简单的方法可以实现,而不需要拒绝。为了直观地理解这种方法,我们必须将所有概率排列成一行,形成一系列长度为 $P ( k )$ 的盒子,如图3.3所示。由于 $\textstyle \sum_{k} P ( k ) = 1$,这一行的总长度等于1。然后,只需在 [0, 1) 内生成一个均匀分布的随机数 r,它就能标识行中的某个特定盒子,并决定事件 $k_{r}$,如图3.3所示。更正式地说,$k_{r}$ 的值应满足以下条件:
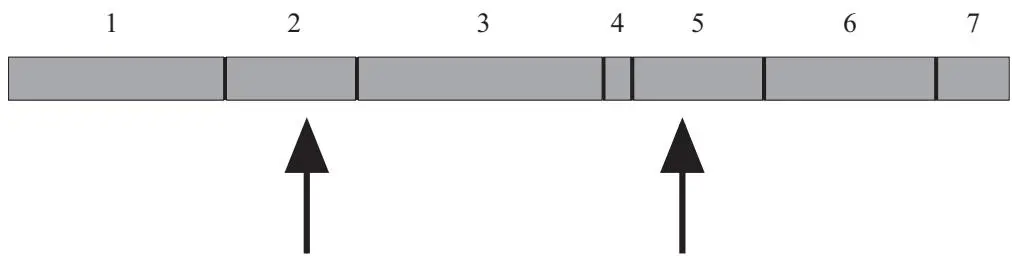
图3.3 对离散概率 $P ( k )$(其中 $k = 1 , \ldots , M$ 为可能的结果,此处 $M = 7$)进行采样的无拒绝方法。只需在 [0, 1) 内生成一个均匀分布的随机数 r,事件 $k_{r}$ 即被选出,使得 $\begin{array} {r} {\sum_{k = 1 , k_{r} - 1} P ( k ) \le} \end{array}$ $\begin{array} {r} {r < \sum_{k = 1 , k_{r}} P ( k )} \end{array}$。两个箭头指示了两次选择事件的过程:分别得到了 $k_{r} = 2$ 和 5 这两个事件。
$$ \sum_{k = 1}^{k_{r} - 1} P ( k ) \leq r < \sum_{k = 1}^{k_{r}} P ( k ) .\tag{3.19} $$显然,在这种情况下,选中某个给定 k 的概率也是 $P ( k )$,因此能够给出正确的结果。
3.6 对连续概率密度进行采样#
现在讨论概率密度为 ${\mathcal{P}} ( x )$ 的连续随机变量的情况。为简单起见,我们考虑只有一个随机变量 x 的一维情形。根据2.4节的讨论,当 x 在 [0, 1) 上均匀分布时(这正是随机数生成器提供给我们的),我们将方程(2.41)应用于此情况,得到:
$$ x = \int_{- \infty}^{y} d s \mathcal{P}_{y} ( s ) .\tag{3.20} $$该方程告诉我们,如果我们希望得到一个遵循给定概率密度 $\mathcal{P}_{y} ( y )$ 分布的随机变量,则必须(i)对 $\mathcal{P}_{y} ( y )$ 进行积分,得到其累积概率 $F ( y )$
$$ F ( y ) = \int_{- \infty}^{y} d s \mathcal{P}_{y} ( s ) ,\tag{3.21} $$然后(ii)抽取一个在 [0, 1) 内均匀分布的随机变量 x,并找到满足 $F ( y ) = x$ 的 y 值;因此,我们必须对 $F ( y )$ 求逆,得到 $y = F^{- 1} ( x )$。从这个意义上说,方程(3.20)本质上就是为离散分布采样而推导出的方程(3.19)的连续版本。对于一般的分布,步骤(i)和(ii)是否能够高效完成并不显而易见。
让我们考虑一个简单例子,它可以解析地求解。假设我们想要根据指数分布生成随机数:
$$ \mathcal{P} ( y ) = \left\{\begin{array} {l l} {A e^{- A y}} & {\mathrm{~ for ~} y \geq 0 ,} \\ {0} & {\mathrm{~ for ~} y < 0 ,} \end{array} \right.\tag{3.22} $$其中 A 是给定的常数。于是,我们得到以下方程:
$$ x = A \int_{0}^{y} d s e^{- A s} = 1 - e^{- A y} ,\tag{3.23} $$该方程可以很容易地对 y 求解,得到:
$$ y = - {\frac{1} {A}} \ln ( 1 - x ) .\tag{3.24} $$在这个简单的例子中,我们能够同时完成积分和求逆。然而,对于一般的概率分布,这并非能以简单方式实现。这里我们展示一个重要情况,不过它可以通过一个简单技巧来解决。假设我们想要生成服从高斯分布的随机数(为简单起见,取 $\mu = 0$ 和 $\sigma = 1$):
$$ \mathcal{P} ( y ) = \frac{1} {\sqrt{2 \pi}} e^{- \frac{y^{2}} {2}} .\tag{3.25} $$在这种情况下,我们需要求解以下方程:
$$ x = {\frac{1} {\sqrt{2 \pi}}} \int_{- \infty}^{y} d s e^{- {\frac{s^{2}} {2}}} .\tag{3.26} $$遗憾的是,该积分没有简单的封闭形式,因此这种方法无法产生有用的结果。不过,有一种方法可以克服这个问题,它被称为Box–Muller技巧。我们首先注意到:
$$ \left\{\frac{1} {\sqrt{2 \pi}} \int_{- \infty}^{+ \infty} d x e^{- \frac{x^{2}} {2}} \right\}^{2} = \frac{1} {2 \pi} \int_{- \infty}^{+ \infty} d x e^{- \frac{x^{2}} {2}} \int_{- \infty}^{+ \infty} d y e^{- \frac{y^{2}} {2}} = 1 .\tag{3.27} $$引入极坐标:
$$ x = \rho \cos \theta ,\tag{3.28} $$$$ y = \rho \sin \theta ,\tag{3.29} $$我们得到:
$$ \frac{1} {2 \pi} \int_{- \infty}^{+ \infty} d x e^{- \frac{x^{2}} {2}} \int_{- \infty}^{+ \infty} d y e^{- \frac{y^{2}} {2}} = \int_{0}^{2 \pi} \frac{d \theta} {2 \pi} \int_{0}^{\infty} d \rho \rho e^{- \frac{\rho^{2}} {2}} .\tag{3.30} $$然后,考虑新变量 $\xi = \rho^{2} / 2$,最终得到:
$$ \frac{1} {2 \pi} \int_{- \infty}^{+ \infty} d x e^{- \frac{x^{2}} {2}} \int_{- \infty}^{+ \infty} d y e^{- \frac{y^{2}} {2}} = \int_{0}^{2 \pi} \frac{d \theta} {2 \pi} \int_{0}^{\infty} d \xi e^{- \xi} .\tag{3.31} $$该方程的意义在于,两个独立的高斯分布变量 $x$ 和 $y$ 等价于另外两个独立变量 $\theta$ 和 $\xi$:前者在 $[0, 2\pi)$ 上均匀分布,后者服从指数分布,参见式 (3.24) 中 $A = 1$ 的情况。因此,通过抽取 $\theta$ 和 $\xi$ 可以轻松获得两个高斯变量:
$$ \theta = 2 \pi r_{1} ,\tag{3.32} $$$$ \xi = - \ln ( 1 - r_{2} ) ,\tag{3.33} $$其中 $r_{1}$ 和 $r_{2}$ 是 $[0, 1)$ 上均匀分布的两个随机变量。最后,给定 $\rho = \sqrt{2 \xi}$,我们得到:
$$ x = \cos ( 2 \pi r_{1} ) \times{\sqrt{- 2 \ \ln ( 1 - r_{2} )}} ,\tag{3.34} $$$$ y = \sin ( 2 \pi r_{1} ) \times \sqrt{- 2 \ \ln ( 1 - r_{2} )} .\tag{3.35} $$这样,就能轻松地从均匀分布的数中得到服从高斯分布的变量。
如前所述,为了获得服从一般概率分布 ${\mathcal{P}} ( x )$ 的随机数,需要执行的步骤并不总是容易完成。在多维情况下尤为如此。无论是在离散情况还是连续情况下,直接采样(direct sampling)通常都不可行。实际上,在离散情况下,由于所有事件必须保存在计算机内存中,事件总数不能太大;而在连续情况下,我们通常会遇到之前讨论过的严重限制,尤其是在多维情形下。因此,必须考虑一种不同的策略。
3.7 马尔可夫链(Markov Chains)#
在下文中,为简化记号,我们只考虑单个随机变量 $x$ 取离散值的情形,其到连续系统的推广是直接的。例如,$\{x\}$ 可能定义了有限格点上多体系统的离散希尔伯特空间:此时,可能构型 $\{x\}$ 的总数很容易超出计算机内存,因此直接采样是不可能的。
对一般概率分布进行采样的想法是构建一个非确定性(即随机)过程,其中构型 $x_{n}$ 根据随机动力学随离散迭代时间 $n$ 演化:
$$ x_{n + 1} = F_{n} ( x_{1} , \ldots , x_{n} , \xi_{n} ) ,\tag{3.36} $$其中 $F_{n}$ 是一个函数,可能依赖于到第 n 步为止的所有先前构型。动力学 (3.36) 的随机性源于 $F_{n}$ 还依赖于一个按照概率密度 $\chi ( \xi_{n} )$ 分布的随机变量 $\xi_{n}$ 。与经典运动方程(即牛顿方程)产生的确定性动力学不同,在随机动力学中,轨迹的概念并未定义,构型 $x_{n}$ 是沿随机过程动态生成的随机变量,并按照随 n 演化的概率分布来分布。这里,关键点在于定义一个合适的函数 $F_{n}$ ,使得构型 $x_{n}$ 将(对于足够大的时间 n)按照我们想要采样的概率分布。这样,我们就能克服无法对概率分布进行直接采样(direct sampling)这一事实。
一个特别简单的例子是所谓的马尔可夫链(Markov chain),其中时间 $n + 1$ 的构型仅依赖于时间 n 的构型:
$$ \boldsymbol{x}_{n + 1} = \boldsymbol{F} ( \boldsymbol{x}_{n} , \boldsymbol{\xi}_{n} ) ,\tag{3.37} $$其中函数 F 被认为是与时间无关的。虽然 $\xi_{n}$ 和 $\xi_{n + 1}$ 是相互独立的随机变量,但 $x_{n} \equiv x$ 和 $x_{n + 1} \equiv x^{\prime}$ 不是独立的;这些变量的联合概率分布可以分解为边际概率和条件概率的乘积,见第 2.2 节:
$$ \mathcal{P}_{\mathrm{joint} , n} ( x^{\prime} , x ) = \omega ( x^{\prime} | x ) \mathcal{P}_{n} ( x ) .\tag{3.38} $$这里,条件概率使得对于所有 x 和 $x^{\prime}$ 有 $\omega ( x^{\prime} | x ) \geq 0$ ,并且满足以下归一化条件:
$$ \sum_{x^{\prime}} \omega ( x^{\prime} | x ) = 1 .\tag{3.39} $$它表示在迭代 n 时具有构型 x 的情况下,$x^{\prime}$ 在 $n + 1$ 时出现的概率;其具体形式取决于函数 $F ( x , \xi )$ 和概率分布 $\chi ( \xi )$ .
我们现在可以推导与马尔可夫链相关联的所谓主方程(Master equation)。确实,变量 $x^{\prime}$ 的边际概率由下式给出:
$$ \mathcal{P}_{n + 1} ( x^{\prime} ) = \sum_{x} \mathcal{P}_{\mathrm{joint} , n} ( x^{\prime} , x ) ,\tag{3.40} $$因此,利用方程 (3.38),我们得到:
$$ \mathcal{P}_{n + 1} ( x^{\prime} ) = \sum_{x} \omega ( x^{\prime} | x ) \mathcal{P}_{n} ( x ) .\tag{3.41} $$这个方程使我们能够计算边际概率 $\mathcal{P}_{n} ( x )$ 作为 n 函数的演化,因为条件概率 $\omega ( x^{\prime} | x )$ 由方程 (3.37) 中的随机动力学决定,并且不依赖于 n。更准确地说,尽管随机变量 x 的实际值无法确定性地知道,但一旦给定初始条件,即 $\mathcal{P}_{0} ( x )$ ,x 的概率分布在每次迭代 n 时是已知的。通过从给定的初始条件开始,迭代求解主方程直到所需的 n 值,可以得到 $\mathcal{P}_{n} ( x )$ 的解。在计算机上模拟马尔可夫链很简单,只需在每次迭代 n 时生成随机数 $\xi$ ,这就是为什么马尔可夫链在蒙特卡洛计算中特别重要的原因。
在详细讨论马尔可夫链的性质以及如何利用它们来采样给定分布函数之前,我们想展示一下这种方法如何应用于计算 $\pi$ ,类似于我们之前展示的直接采样。在这种情况下,我们不是在正方形内随机发射子弹并统计圆内的“命中”次数(见图 3.1),而是想象在正方形内进行随机游走并在我们访问的每个位置放置一颗子弹,见图 3.4。从正方形内的一个随机位置开始,我们在离散时间 n 步移动:例如,时间 $n + 1$ 的新位置可以在一个边长为 $\delta$ 、围绕时间 n 的位置(见图 3.4)的小正方形内随机选择:
$$ \boldsymbol{x}^{\mathrm{new}} = \boldsymbol{x}^{\mathrm{old}} + \xi_{\boldsymbol{x}} ,\tag{3.42} $$$$ y^{\mathrm{new}} = y^{\mathrm{old}} + \xi_{y} ,\tag{3.43} $$其中$\xi_{x}$和$\xi_{y}$是两个独立的随机数,均匀分布在区间$[ - \delta / 2 , \delta / 2 ]$内。在一次长随机游走结束时,圆内子弹数量与总子弹数量的比值将趋近于$\pi / 4$。在这种方法中,显然新位置$( x^{\mathrm{new}} , y^{\mathrm{new}} )$与旧位置$( x^{\mathrm{old}} , y^{\mathrm{old}} )$是相关的,因为新坐标与旧坐标的距离不可能超过$\delta / 2$。特别地,当$\delta$越来越小时,相关性会增强。相比之下,在图3.1的直接采样中,每颗子弹的位置是相互独立的。尽管如此,在这里,对于一个足够长的随机游走,我们均匀地遍历了整个正方形区域,圆内子弹数量与总子弹数量的比值必须正比于圆面积与正方形面积之比,即$\pi / 4$。
这种方法有一个小问题:如果我们的步长将我们带出正方形该怎么办?令人惊讶的是,正确的答案是——当我们在讨论Metropolis算法时会清楚这一点——尝试必须被拒绝(我们不移动),并且一颗子弹必须放在前一颗子弹的上面,表示我们连续两次占据了同一个位置。然后我们再尝试另一次移动,直到成功移动到正方形内部。
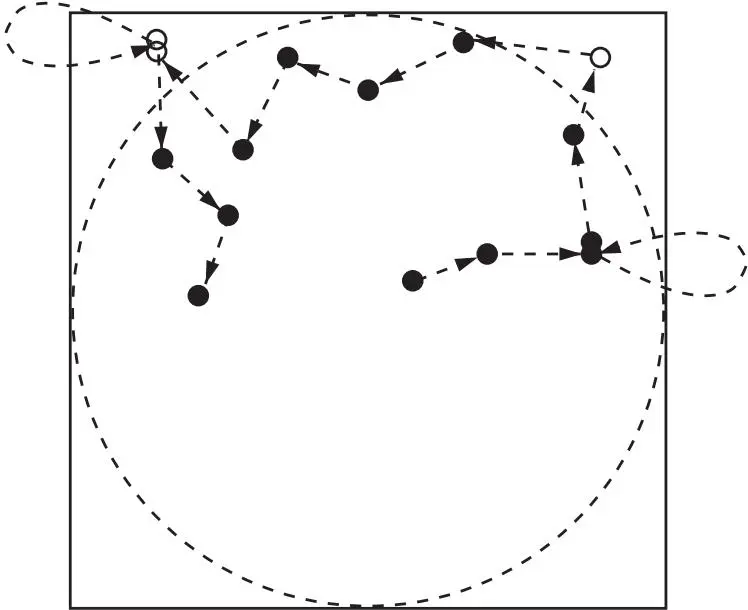
图3.4 用马尔可夫链采样计算π。我们执行一次随机游走并在身后扔下子弹。在时间$n+1$的新位置是在以时间$n$的位置为中心、边长为$\delta$的小正方形内随机选取的。当步数N很大时,圆内子弹数与总尝试次数之比趋近于$\pi / 4$;详见正文。注意,有两个情况(第三步和第十一步)会将子弹带到大方块之外;在这种情况下,该步不执行,并在前一位置放上第二颗子弹。
3.8 细致平衡与趋近平衡#
至此,关于马尔可夫过程的一个自然而重要的问题是,要理解在什么条件下,分布序列$\mathcal{P}_{n} ( x )$会收敛到某个极限(即平衡)分布$\mathcal{P}_{\mathrm{eq}} ( x )$。在下文中,我们将假设对于所有构型$x$,有$\mathcal{P}_{\mathrm{eq}} ( x ) > 0$。实际上,那些$\mathcal{P}_{\mathrm{eq}} ( x ) = 0$的构型对最终结果没有贡献,可以有效地忽略。例如,在经典统计力学中,$\mathcal{P}_{\mathrm{eq}} ( x )$ ∝ $\exp [ - \beta V ( x ) ]$(其中$\beta$是温度的倒数,$V ( x )$是势能),对于所有$V ( x ) < \infty$的构型,$\mathcal{P}_{\mathrm{eq}} ( x ) \neq 0$;那些$V ( x ) = \infty$的构型对配分函数没有贡献。关于马尔可夫链及其趋近平衡的一般理论是一个广阔的研究领域(Norris, 1997),我们不想在此讨论。我们现在要解决的问题是:
- 是否存在一个平稳分布$\mathcal{P}_{\mathrm{eq}} ( x )$?
- 从给定的任意初始分布$\mathcal{P}_{0} ( x )$出发,是否保证收敛到$\mathcal{P}_{\mathrm{eq}} ( x )$?
第一个问题要求满足:
$$ \mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) = \sum_{x} \omega ( x^{\prime} | x ) \mathcal{P}_{\mathrm{eq}} ( x ) .\tag{3.44} $$为了满足这个平稳性要求,满足所谓的细致平衡条件(detailed balance condition)是充分(但不必要)的:
$$ \omega ( x^{\prime} | x ) \mathcal{P}_{\mathrm{eq}} ( x ) = \omega ( x | x^{\prime} ) \mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) .\tag{3.45} $$这一关系表明,经历 $x \to x'$ 过程的数目必须恰好被相同数量的反向过程 $x' \to x$ 所补偿,以维持稳定的平稳条件。很容易证明,细致平衡条件允许主方程存在平稳解。实际上,如果对于某个 $n$,我们有 $\mathcal{P}_{n} ( x ) = \mathcal{P}_{\mathrm{eq}} ( x )$,那么:
$$ \mathcal{P}_{n + 1} ( x^{\prime} ) = \sum_{x} \omega ( x^{\prime} | x ) \mathcal{P}_{\mathrm{eq}} ( x ) = \mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) \sum_{x} \omega ( x | x^{\prime} ) = \mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) ,\tag{3.46} $$其中我们使用了式(3.45)的细致平衡条件和条件概率(3.39)的归一化条件。因此,我们已经证明主方程(3.41)存在平稳解,即不依赖于(离散)时间 $n$ 的解。
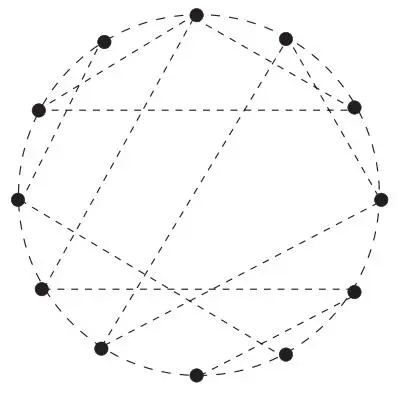
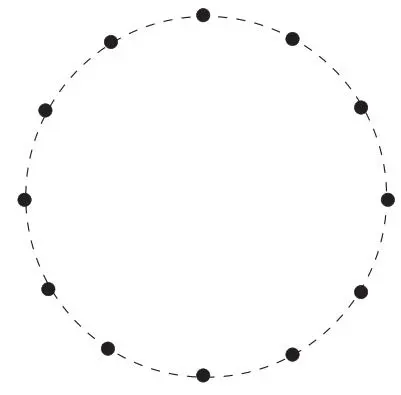
现在,我们希望理解平衡解何时唯一,以及一般初始条件 $\mathcal{P}_{0} ( x )$ 何时收敛到该解。首先,我们需要定义马尔可夫链中周期性的概念。如果返回状态 $x$ 只能在 $k$ 的倍数步内发生,则称状态 $x$ 具有周期 $k$;若 $k = 1$,则该状态称为非周期的:此时返回 $x$ 发生在不规则的时间步上。如果所有状态都是非周期的,则马尔可夫链是非周期的。在图3.5中,我们展示了周期性和非周期性马尔可夫链的两个例子。第二个概念是可约性。如果从状态 $x'$ 出发的马尔可夫链能以非零概率访问状态 $x$,则称状态 $x$ 是从另一个状态 $x'$ 可达的。注意,并不要求两个状态之间存在直接的有限转移概率,只需要它们通过一系列基本步骤相连即可。如果一个马尔可夫链中任何状态都从其他任何状态可达(换句话说,从任何其他状态出发都可能到达任何状态),则称该链是不可约的。最后,如果返回时间有限(即,能够在有限步内返回),则称该状态为正递归的。如果一个马尔可夫链是非周期的并且所有状态都是正递归的,则称该链是遍历的。
 (a)
(b)
图3.5 非周期性(a)和周期性 k = 2 (b)的马尔可夫链示例。虚线表示由条件概率 $\omega ( x^{\prime} | x )$ 控制的允许转移。在(b)中,仅存在最近邻转移;因此,从任何位置出发,只能在偶数步后返回$( \mathrm{i} . \mathrm{e} . , k = 2 )$。
现在让我们讨论第二个问题。首先,转移概率 $\omega ( x^{\prime} | x )$ 可以被视为一个非对称矩阵。然而,在存在式(3.45)的细致平衡条件的情况下,$\omega ( x^{\prime} | x )$ 可以通过相似变换用一个对称矩阵 $H$ 重写:
$$ H_{x , x^{\prime}} = H_{x^{\prime} , x} = \omega \left( x^{\prime} | x \right) \frac{\Upsilon_{0} ( x )} {\Upsilon_{0} ( x^{\prime} )} ,\tag{3.47} $$其中 $H_{x , x^{\prime}} \geq 0$,而 $\Upsilon_{0} ( x ) = \sqrt{\mathcal{P}_{\mathrm{eq}} ( x )}$ 定义了一个向量,其所有分量对所有构型 $x$ 都是严格正值的(参见第3.8节开头)。
第一个观察结果是 $\Upsilon_{0} ( x )$ 是 $H$ 的一个本征态,其本征值为 $\lambda_{0} = 1$。实际上,从前面式(3.47)的定义出发,我们有:
$$ \sum_{x^{\prime}} H_{x , x^{\prime}} \Upsilon_{0} ( x^{\prime} ) = \Upsilon_{0} ( x ) \sum_{x^{\prime}} \omega ( x^{\prime} | x ) = \Upsilon_{0} ( x ) ,\tag{3.48} $$其中我们利用了条件概率的归一化性质。
现在,我们将证明 $\mathbf{H}$ 不存在绝对值大于 $\lambda_{0}$ 的其他本征值,即 $| \lambda_{\alpha} | \leq 1$。为证明此论断,我们考虑 $\mathbf{H}$ 的平方,其显然具有正本征值 $\lambda_{\alpha}^{2}$。这是必要的,以排除存在本征值等于 −1 的可能性,如图 3.5(b) 所示的周期为 $k = 2$ 的情形。接着,我们取具有最大本征值 $\lambda_{\Psi}^{2}$ 的本征向量 $\Psi ( x )$:
$$ \sum_{x^{\prime}} ( H^{2} )_{x , x^{\prime}} \Psi ( x^{\prime} ) = \lambda_{\Psi}^{2} \Psi ( x ) ,\tag{3.49} $$这意味着(假设 $\Psi ( x )$ 已归一化,即 $\textstyle \sum_{x} \Psi^{2} ( x ) = 1$)
$$ \sum_{x , x^{\prime}} \Psi ( x ) ( H^{2} )_{x , x^{\prime}} \Psi ( x^{\prime} ) = \lambda_{\Psi}^{2} .\tag{3.50} $$对两边取绝对值,我们得到:
$$ \lambda_{\Psi}^{2} = \left| \sum_{x , x^{\prime}} \Psi ( x ) ( H^{2} )_{x , x^{\prime}} \Psi ( x^{\prime} ) \right| \leq \sum_{x , x^{\prime}} \left| \Psi ( x ) | ( H^{2} )_{x , x^{\prime}} | \Psi ( x^{\prime} ) \right| .\tag{3.51} $$根据厄米矩阵的极小-极大性质,可知 $\vert \Psi ( x ) \vert$ 也是 $\mathbf{H}^{2}$ 的本征态,且本征值等于 $\lambda_{\Psi}^{2}$。然而,矩阵 $\mathbf{H}^{2}$ 是对称的,因此对应于不同本征值的本征向量必须正交。由于由式 (3.48) 我们有 $\Upsilon_{0} ( x ) = \sqrt{\mathcal{P}_{\mathrm{eq}} ( x )}$ 是 $\mathbf{H}^{2}$ 的一个本征向量,本征值为 $\lambda_{0}^{2} = 1$,那么 $| \Psi ( x ) |$ 不可能与之正交。因此,我们得出结论:$\lambda_{\Psi}^{2} = \lambda_{0}^{2} = 1$。
尽管如此,本征值 $\lambda_{0}^{2} = 1$ 可能不是唯一的,因为对于简并本征值,本征向量不必正交。然而,通过施加 $\mathbf{H}^{2}$ 不可约的要求,可以排除存在简并本征值的可能性。事实上,假设 $\mathbf{H}^{2}$ 的另一个本征态 $\Upsilon_{0}^{\prime} ( x )$ 具有本征值 $\lambda_{0}^{2} = 1$。那么,对于任意常数 α,$\Upsilon_{0} ( x ) + \alpha \Upsilon_{0}^{\prime} ( x )$ 也是具有相同本征值的本征态。此外,根据之前的讨论,$\Phi ( x ) = | \Upsilon_{0} ( x ) + \alpha \Upsilon_{0}^{\prime} ( x ) |$ 也是一个本征态,且可以选取常数 α,使得对于某个特定构型 $x \equiv{\bar{x}}$,有 $\Phi ( \bar{x} ) = 0$。那么,由于 $\Phi ( x )$ 是 $\mathbf{H}^{2}$ 的本征态,我们有:
$$ \sum_{x} ( H^{2} )_{\bar{x} , x} \Phi ( x ) = \lambda_{0}^{2} \Phi ( \bar{x} ) = 0 ,\tag{3.52} $$这直接意味着,对于所有通过 $(H^{2})_{\bar{x},x}$ 与 $\bar{x}$ 相连的构型,都有 $\Phi (x) = 0$,因为 $\Phi (x)$ 非负且 $(H^{2})_{\bar{x},x}$ 严格正。通过将上述条件迭代应用于与 $\bar{x}$ 相连的新构型,我们可以证明所有生成的构型都满足 $\Phi (x) = 0$。不可约性(irreducibility)保证了该过程将覆盖所有构型,且 $\Phi (x) = 0$ 在整个构型空间中得到验证。因此,$\Upsilon_{0}^{\prime} (x)$ 仅仅是 $\Upsilon_{0} (x)$ 的比例倍数,而非不同的本征向量。这一事实表明最大本征值 $\lambda_{0}^{2} = 1$ 是非简并的,特别地,$\lambda_{0} = -1$ 不存在,且 $\lambda_{0} = 1$ 是唯一的。
我们想指出,这一结果与佩龙-弗罗贝尼乌斯定理(Perron-Frobenius theorem, Meyer, 2000)相关,该定理适用于非负且遍历(ergodic)的矩阵,但这类矩阵未必对称。在这种情况下,可以证明最大本征值 $\lambda_{0}$ 是实数、正数且唯一(即所有其他可能为复数的本征值 $\lambda_{i}$ 都满足 $|\lambda_{i}| < \lambda_{0}$)。此外,对应于 $\lambda_{0}$ 的左本征向量的所有分量均为正。
回到对称情形,前述结果意味着任意初始分布 $\mathcal{P}_{0} (x)$ 都将收敛到平稳分布 $\mathcal{P}_{\mathrm{eq}} (x) = \Upsilon_{0}^{2} (x)$。事实上,利用式(3.47),主方程(3.41)可写为:
$$ \mathcal{P}_{n} (x) = \sum_{x^{\prime}} H_{x,x^{\prime}} \frac{\Upsilon_{0}(x)}{\Upsilon_{0}(x^{\prime})} \mathcal{P}_{n-1}(x^{\prime});\tag{3.53} $$然后,通过迭代这一过程(即每一步都将边际概率用前一步的边际概率表示),我们得到 $\mathcal{P}_{n} (x)$ 与初始概率($n=0$ 步)之间的关系:
$$ \mathcal{P}_{n} (x) = \sum_{x^{\prime}} (H^{n})_{x,x^{\prime}} \frac{\Upsilon_{0}(x)}{\Upsilon_{0}(x^{\prime})} \mathcal{P}_{0}(x^{\prime}),\tag{3.54} $$这里矩阵 $H$ 的 $n$ 次幂可按其本征向量展开:
$$ (H^{n})_{x,x^{\prime}} = \sum_{\alpha} \lambda_{\alpha}^{n} \Upsilon_{\alpha}(x^{\prime}) \Upsilon_{\alpha}(x).\tag{3.55} $$将这一展开代入式(3.54)得到:
$$ \begin{array} {r l} & {\mathcal{P}_{n} (x) = \Upsilon_{0}(x) \displaystyle \sum_{\alpha} \lambda_{\alpha}^{n} \Upsilon_{\alpha}(x) \left[ \displaystyle \sum_{x^{\prime}} \frac{\Upsilon_{\alpha}(x^{\prime})}{\Upsilon_{0}(x^{\prime})} \mathcal{P}_{0}(x^{\prime}) \right]} \\ & {\quad \quad \quad = \Upsilon_{0}^{2}(x) \left[ \displaystyle \sum_{x^{\prime}} \mathcal{P}_{0}(x^{\prime}) \right] + \Upsilon_{0}(x) \displaystyle \sum_{\alpha > 0} \lambda_{\alpha}^{n} \Upsilon_{\alpha}(x) \left[ \displaystyle \sum_{x^{\prime}} \frac{\Upsilon_{\alpha}(x^{\prime})}{\Upsilon_{0}(x^{\prime})} \mathcal{P}_{0}(x^{\prime}) \right] .} \end{array}\tag{3.56} $$当 $n$ 很大时,所有 $\alpha > 0$ 的项都指数衰减(因为对于 $\alpha > 0$ 有 $|\lambda_{\alpha}| < 1$),因此上述求和仅剩下第一项。鉴于初始概率分布是归一化的,即 $\begin{array} {r} {\sum_{x^{\prime}} \mathcal{P}_{0}(x^{\prime}) = 1} \end{array}$,我们最终得到概率分布收敛到所需的分布:
$$ \operatorname*{lim}_{n \infty} \mathcal{P}_{n} (x) = \Upsilon_{0}^{2} (x) = \mathcal{P}_{\mathrm{eq}} (x).\tag{3.57} $$在实际应用中,我们可以假设,经过热化时间 $n_{\mathrm{therm}}$ 后,概率分布 $\mathcal{P}_{n} ( x )$ 基本收敛到平衡分布 $\mathcal{P}_{\mathrm{eq}} ( x )$,因此可以使用配置 $x_{n}$(其中 $n > n_{\mathrm{therm}}$)来评估我们感兴趣的物理量。然而,在大多数情况下,后续的配置之间并非相互独立,需要经过有限步数才能降低它们之间的相关性。相关时间就是获得(基本)独立配置所需的时间。相关时间和热化时间是一致的,它们都直接与转移概率 (3.47) 的谱相关。实际上,从描述概率分布趋近平衡的式 (3.56) 可以明显看出,最大特征值(小于 1)决定了马尔可夫步数,该步数是为了遗忘给定状态并获得(基本)独立状态所必需的。
3.9 Metropolis 算法#
在本节中,我们将介绍一种构建条件概率 $\omega ( x^{\prime} | x )$ 的实用方法,该方法满足细致平衡条件 (3.45),使得对于较大的 n 值,配置 $x_{n}$ 根据给定的概率分布 $\mathcal{P}_{\mathrm{eq}} ( x )$ 分布。Metropolis 及其合作者 (Metropolis et al., 1957) 引入了一个非常简单的方案,该方案也非常通用,可以应用于许多不同的情况。后来,W. Keith Hastings (1970) 将所谓的 Metropolis 算法推广到了更一般的情况(通常也使用“Metropolis-Hastings 算法”的名称)。作为第一步,我们将转移概率 $\omega ( x^{\prime} | x )$ 拆分为两部分:
$$ \omega ( x^{\prime} | x ) = T ( x^{\prime} | x ) A ( x^{\prime} | x ) ,\tag{3.58} $$其中 $T ( x^{\prime} | x )$ 定义了一个试探概率(trial probability),它从当前配置 x 提议新配置 $x^{\prime}$,而 $A ( x^{\prime} | x )$ 是接受概率。在 Metropolis 及其合作者的原始工作中,试探概率被假设为对称的,即 $T ( x^{\prime} | x ) = T ( x | x^{\prime} )$。然而,在该算法的推广版本中,只要确保遍历性(ergodicity),$T ( x^{\prime} | x )$ 可以有很大的自由度进行选择。然后,为了定义一个满足细致平衡条件的马尔可夫过程,提议的配置 $x^{\prime}$ 以以下概率被接受:
$$ A ( x^{\prime} | x ) = \mathrm{Min} \left\{1 , \frac{\mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) T ( x | x^{\prime} )} {\mathcal{P}_{\mathrm{eq}} ( x ) T ( x^{\prime} | x )} \right\} .\tag{3.59} $$不失一般性,我们总是可以选择 $T ( x | x ) = 0$,即我们从不提议保持相同的配置。尽管如此,$\omega ( x | x )$ 可以是有限的,因为提议的移动可能被拒绝。$\omega ( x | x )$ 的实际值由归一化条件 $\begin{array} {r} {\sum_{x^{\prime}} \omega ( x^{\prime} | x ) = 1} \end{array}$ 确定。
在大多数情况下(如 Metropolis 及其合作者的原始工作),考虑对称的试探概率 $T ( x^{\prime} | x ) = T ( x | x^{\prime} )$ 是很有用的。在这种情况下,接受概率简化为:
$$ A ( x^{\prime} | x ) = \mathrm{Min} \left\{1 , \frac{\mathcal{P}_{\mathrm{eq}} ( x^{\prime} )} {\mathcal{P}_{\mathrm{eq}} ( x )} \right\} .\tag{3.60} $$证明采用式 (3.59) 的接受概率满足细致平衡条件非常简单。实际上,让我们考虑 x 和 $x^{\prime} \neq x$ 满足 $\mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) T ( x | x^{\prime} ) / [ \mathcal{P}_{\mathrm{eq}} ( x ) T ( x^{\prime} | x ) ] > 1$ 的情况。在这种情况下,我们有:
$$ A ( x^{\prime} | x ) = 1 ,\tag{3.61} $$$$ A ( x | x^{\prime} ) = \frac{\mathcal{P}_{\mathrm{eq}} ( x ) T ( x^{\prime} | x )} {\mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) T ( x | x^{\prime} )} ;\tag{3.62} $$然后,我们可以直接验证细致平衡条件得到满足:
$$ T ( x^{\prime} | x ) A ( x^{\prime} | x ) \mathcal{P}_{\mathrm{eq}} ( x ) = T ( x | x^{\prime} ) A ( x | x^{\prime} ) \mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) .\tag{3.63} $$在相反情况下也可以得到类似的证明,其中 $x$ 和 $x^{\prime}$ 满足 $\mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) T ( x | x^{\prime} ) / [ \mathcal{P}_{\mathrm{eq}} ( x ) T ( x^{\prime} | x ) ] < 1$。
总结一下,如果 $x_{n}$ 是时刻 n 的构型,则马尔可夫链迭代通过两步定义:
- 按照转移概率(transition probability)$T ( x^{\prime} | x_{n} )$ 生成一个构型 $x^{\prime}$ 来提出一次试探移动(propose a move)。
- 接受或拒绝该试探移动。如果一个在 [0, 1) 上均匀分布的随机数 $\eta$ 满足 $\eta < A ( x^{\prime} | x_{n} )$,则移动被接受,新构型 $x_{n + 1}$ 等于 $x^{\prime}$;否则移动被拒绝,保持 $x_{n + 1} = x_{n}$。
Metropolis 算法带来的重要简化包括:
• 只需知道平衡概率分布 $\mathcal{P}_{\mathrm{eq}} ( x )$ 的未归一化形式:实际上,在计算等式 (3.59) 中的接受率 $A ( x^{\prime} | x )$ 时,只需要比值 $\mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) / \mathcal{P}_{\mathrm{eq}} ( x )$。这使我们避免了计算在计算上不可行的归一化因子。
• 转移概率 $T ( x^{\prime} | x )$ 可以选择得非常简单。例如,在一维连续问题中,粒子的新坐标 $x^{\prime}$ 可以通过规则 $x^{\prime} = x + \xi$ 得到,其中 $\xi$ 是在 $[ - a , a ]$ 上均匀分布的随机数,对于 $x - a < x^{\prime} < x + a$,有 $T ( x^{\prime} | x ) = 1 / ( 2 a )$。注意在这种情况下 $T ( x^{\prime} | x ) = T ( x | x^{\prime} )$。
• 每当新构型 $x^{\prime}$ 非常接近旧构型 x 时(例如,对于前一点描述的例子,当 a 足够小时),由于 $\mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) / \mathcal{P}_{\mathrm{eq}} ( x ) \approx 1$,所有移动被接受的概率都很高,拒绝机制作用不大。然而,在这种情况下,沿马尔可夫链生成的构型之间高度相关。相反,提出一个远离旧构型的新构型可能是危险的,因为 $\mathcal{P}_{\mathrm{eq}} ( x^{\prime} ) / \mathcal{P}_{\mathrm{eq}} ( x )$ 可能非常小;不过,一旦被接受,新构型将与前一构型相关性非常弱。减少相关时间的一个良好经验法则是调整试探概率 $T ( x^{\prime} | x )$(例如,在上述例子中增大 a),以使平均接受率约为 0.5,这意味着平均只接受总试探移动的一半。尽管没有理由认为这是最优选择,但它通常提供了一个非常好的选项。
最后,我们回到图 3.4 中给出的例子,其中我们提到,每当执行一步将我们带到大方块外部时,我们必须拒绝该移动,并在前一个弹着点上再放一个弹着点。在 Metropolis 算法中,这一点变得清晰:试探概率 $T ( x^{\prime} | x )$ 在我们当前位置周围边长为 $\delta$ 的小方块内是均匀的;由于 $\mathcal{P}_{\mathrm{eq}} ( x )$ 在大方块内部为常数,外部为零,因此如果试探移动落在大方块内部则总是被接受,而如果落在外部则被拒绝。在这种情况下,新构型与前一构型相同,即 $x_{n + 1} \equiv x_{n}$,因此在计算平均值时它将被计入两次。注意,另一种同样正确的替代方法(alternative procedure)是考虑一种不考虑大方块外部移动的试探概率:在这种情况下,当位置靠近边界时,我们不能使用边长为 δ 的方块,而必须考虑一个小矩形。然而,在这种情况下,我们必须注意,因为试探概率通常不总是对称的,因此必须考虑完整的接受概率式 (3.59)。
3.10 如何估计误差棒(Errorbars)#
这里我们想要详细讨论如何在蒙特卡洛模拟中确定平均值的非线性函数并估计其误差棒。在第2.6节中,我们已经看到如何从一组测量值 $\{x_{i} \}$(其中 $i = 1 , \ldots , N$)估计简单平均值,即 $\mu_{x} = \left. x \right.$,及其误差棒,参见公式(2.56)和(2.58)。同样的方法适用于不同平均值的任意线性组合;然而,在某些情况下,我们需要平均值的非线性函数,例如某个量的涨落 $\langle x^{2} \rangle - \langle x \rangle^{2}$ 或不同矩的组合,如 $1 - \langle{x^{4}} \rangle / 3 \langle{x^{2}} \rangle^{2}$(即所谓的 Binder 累积量(Binder cumulant),用于定位经典统计力学中的相变,在对称相中为零,在对称破缺相中非零)。
这里,我们考虑一个或多个变量平均值的非线性函数 $f ( \mu_{x} , \mu_{y} , \ldots )$。对于上面提到的第一个例子,我们有:
$$ f \left( \mu_{x} , \mu_{y} \right) = \mu_{y} - \mu_{x}^{2} ,\tag{3.64} $$其中 $y = x^{2}$,因此 $\mu_{y} = \langle x^{2} \rangle$。而对于第二个例子:
$$ f ( \mu_{y} , \mu_{z} ) = 1 - \frac{\mu_{z}} {3 \mu_{y}^{2}} ,\tag{3.65} $$其中 $y = x^{2}$ 且 $z = x^{4}$,分别得到 $\mu_{y} = \langle x^{2} \rangle$ 和 $\mu_{z} = \langle x^{4} \rangle$。
根据给定的数据集估计 $f ( \mu_{x} , \mu_{y} , \ldots )$ 的最自然方法是取 $f ( {\overline{{x}}} , {\overline{{y}}} , \dots )$,其中 $\bar{x} \ : = \ : 1 / N \sum_{i} x_{i}$,$\bar{y} = 1 / N \sum_{i} y_{i}$。这确实是正确的方法;然而,对于非线性函数,这种估计存在一个偏差,其量级为 $1 / N$。当然,对于较大的 N 值,偏差远小于量级为 $1 / \sqrt{N}$ 的统计误差,在计算中可以忽略。最重要的是,计算 $f ( {\overline{{x}}} , {\overline{{y}}} , \dots )$ 的误差棒需要一些我们将在下面讨论的特定方法。传统的评估不确定性的方法是考虑误差传播(error propagation),而更直接(且更高效)的方法基于自举法(bootstrap)或刀切法(jackknife)(Young, 2012)。这里,我们首先解释误差传播(实践中很少使用),然后讨论在大多数情况下常用的自举法和刀切法。
3.10.1 误差传播#
下面,为简单起见,我们考虑一个仅依赖于两个期望值的函数,即 $f ( \mu_{x} , \mu_{y} )$。推广到最一般的情况是直接的。为了找到 $\mathbf{\overline{{\Gamma}}} f ( \overline{{x}} , \overline{{y}} )$ 的偏差和误差棒,我们可以将该量在 $f ( \mu_{x} , \mu_{y} )$ 附近展开:
$$ \begin{array} {l} {f ( \overline{{x}} , \overline{{y}} ) \approx f \left( \mu_{x} , \mu_{y} \right) + \left( \partial_{\mu_{x}} f \right) \Delta_{x} + \left( \partial_{\mu_{y}} f \right) \Delta_{y}} \\ {\displaystyle \qquad + \frac{1} {2} \left( \partial_{\mu_{x} , \mu_{x}}^{2} f \right) \Delta_{x}^{2} + \left( \partial_{\mu_{x} , \mu_{y}}^{2} f \right) \Delta_{x} \Delta_{y} + \frac{1} {2} \left( \partial_{\mu_{y} , \mu_{y}}^{2} f \right) \Delta_{y}^{2} ,} \end{array}\tag{3.66} $$其中 $\Delta_{x} = ( \overline{{x}} - \mu_{x} )$,$\Delta_{y} = ( \overline{{y}} - \mu_{y} )$。偏差的主要贡献来自二阶项,因为当过程重复多次时,$\Delta_{x}$ 和 $\Delta_{y}$ 的一阶项平均为零,即 $\langle \Delta_{x} \rangle = \langle \Delta_{y} \rangle = 0$。而二阶项通常具有有限的期望值:
$$ \left. \Delta_{x}^{2} \right. = \langle \overline{{x}}^{2} \rangle - \langle \overline{{x}} \rangle^{2} = \sigma_{\overline{{x}}}^{2} = \frac{\sigma_{x}^{2}} {N} ,\tag{3.67} $$$$ \left. \Delta_{y}^{2} \right. = \langle \overline{{y}}^{2} \rangle - \langle \overline{{y}} \rangle^{2} = \sigma_{\overline{{y}}}^{2} = \frac{\sigma_{y}^{2}} {N} ,\tag{3.68} $$$$ \langle \Delta_{x} \Delta_{y} \rangle = \langle \overline{{xy}} \rangle - \langle \overline{{x}} \rangle \langle \overline{{y}} \rangle = \sigma_{\overline{{x}} y}^{2} = \frac{\sigma_{xy}^{2}} {N} ,\tag{3.69} $$其中我们使用了式 (2.58) 以及 $\sigma_{x}^{2} = \langle x^{2} \rangle - \langle x \rangle^{2} , \sigma_{y}^{2} = \langle y^{2} \rangle - \langle y \rangle^{2}$ 和 $\sigma_{xy}^{2} =$ $\langle x y \rangle - \langle x \rangle \langle y \rangle$。因此,我们有:
$$ \langle f ( \overline{{x}} , \overline{{y}} ) \rangle - f ( \mu_{x} , \mu_{y} ) \approx \frac{1} {2 N} \left[ \left( \partial_{\mu_{x} , \mu_{x}}^{2} f \right) \sigma_{x}^{2} + 2 \left( \partial_{\mu_{x} , \mu_{y}}^{2} f \right) \sigma_{xy}^{2} + \left( \partial_{\mu_{y} , \mu_{y}}^{2} f \right) \sigma_{y}^{2} \right] ,\tag{3.70} $$这表明精确值 $f ( \mu_{x} , \mu_{y} )$ 与其估计值 $f ( \overline{{x}} , \overline{{y}} )$ 之间的差异是 ${\cal O} ( 1 / N )$。请注意,当函数在期望值处为线性时,二阶偏导消失,因此不存在偏倚。通常我们并不关心这一偏倚,因为它远小于与 $1 / \sqrt{N}$ 成正比的统计误差。实际上,与 $f ( \overline{{x}} , \overline{{y}} )$ 相关的误差棒的主要贡献可以通过展开式 (3.66) 轻松计算。那么,方差由下式给出:
$$ \begin{array} {r l r} {{\sigma_{f}^{2} = f^{2} ( \overline{{x}} , \overline{{y}} ) - f ( \overline{{x}} , \overline{{y}} )^{2}}} \\ & {} & {= ( \partial_{\mu_{x}} f )^{2} \Delta_{x}^{2} + 2 ( \partial_{\mu_{x}} f ) ( \partial_{\mu_{y}} f ) \langle \Delta_{x} \Delta_{y} \rangle + ( \partial_{\mu_{y}} f )^{2} \Delta_{y}^{2}} \\ & {} & {= \displaystyle \frac{1} {N} [ ( \partial_{\mu_{x}} f )^{2} \sigma_{x}^{2} + 2 ( \partial_{\mu_{x}} f ) ( \partial_{\mu_{y}} f ) \sigma_{xy}^{2} + ( \partial_{\mu_{y}} f )^{2} \sigma_{y}^{2} ] ,} \end{array}\tag{3.71} $$其中,式 (3.66) 中的所有二阶项在考虑 $\langle f^{2} ( {\overline{{x}}} , {\overline{{y}}} ) \rangle$ 与 $\langle f ( {\overline{{x}}} , {\overline{{y}}} ) \rangle^{2}$ 之差时相互抵消。与往常一样,可以通过用 $s_{x} 、 s_{xy}$ 和 $s_{y}$ 得到的估计值代入 $\sigma_{x}^{2} 、 \sigma_{xy}^{2}$ 和 $\sigma_{\mathrm{y}}^{2}$ 来计算 $\sigma_{f}^{2}$,参见式 (2.63)。这种方法的主要缺点是需要精确计算所有偏导数,同时还要跟踪所有的方差和协方差。下面,我们介绍两种不需要任何解析计算的简单技术。
3.10.2 自助法(Bootstrap Method)#
在自助法中,我们通过从原始数据集(记为 $\{x_{i} \}$,其中 $i = 1 , \ldots , N$)中随机选择数据点,生成 $N_{\mathrm{boot}}$ 个数据集,每个数据集恰好包含 N 个点。在此过程中,每个数据点被选中的概率为 $1 / N$,因此平均每个数据集会出现一次。然而,在新样本中,原始数据集的每个点可能出现多次(也可能根本不出现)。
令 $n_{i , \alpha}$ 表示 $x_{i}$ 在第 α 个自助样本中出现的次数,其中 $\alpha = 1 , \ldots , N_{\mathrm{boot}}$。由于每个自助数据集包含 N 个数据点,我们有以下约束:
$$ \sum_{i = 1}^{N} n_{i , \alpha} = N .\tag{3.72} $$当数据集数量 $N_{\mathrm{boot}}$ 足够大时,它能重现正确的平均值;特别地,我们定义:
$$ [ n_{i} ]_{\mathrm{boot}} = \frac{1} {N_{\mathrm{boot}}} \sum_{\alpha = 1}^{N_{\mathrm{boot}}} n_{i , \alpha} ,\tag{3.73} $$$$ \big [ n_{i}^{2} \big ]_{\mathrm{boot}} = \frac{1} {N_{\mathrm{boot}}} \sum_{\alpha = 1}^{N_{\mathrm{boot}}} n_{i , \alpha}^{2} .\tag{3.74} $$由于 $x_{i}$ 在第 α 个自助样本中出现 $n_{i , \alpha}$ 次的概率由二项分布(binomial probability)给出:
$$ P ( n_{i , \alpha} ) = \frac{N !} {n_{i , \alpha} ! \ ( N - n_{i , \alpha} ) !} p^{n_{i , \alpha}} ( 1 - p )^{N - n_{i , \alpha}} ,\tag{3.75} $$其中 $p = 1 / N$,则均值和方差为:
$$ [ n_{i} ]_{\mathrm{boot}} = N p = 1 ,\tag{3.76} $$$$ \left[ n_{i}^{2} \right]_{\mathrm{boot}} - [ n_{i} ]_{\mathrm{boot}}^{2} = N p ( 1 - p ) = 1 - \frac{1} {N} .\tag{3.77} $$注意到,由于式(3.72)约束的存在,同一自助法数据集中 $i \neq j$ 的 $n_{i , \alpha}$ 和 $n_{j , \alpha}$ 值并非相互独立,而是存在(微小的)相关性(随 $N \to \infty$ 而趋于零)。事实上,对式(3.72)两边平方并在 $N_{\mathrm{boot}}$ 上平均,可得:
$$ \frac{1} {N^{2}} \sum_{i , j} \big [ n_{i} n_{j} \big ]_{\mathrm{boot}} = 1 ,\tag{3.78} $$利用 $[ n_{i} ]_{\mathrm{boot}} = 1$ 的事实,可将其重写为:
$$ {\frac{1} {N^{2}}} \sum_{i , j} \left( \left[ n_{i} n_{j} \right]_{\mathrm{boot}} - \left[ n_{i} \right]_{\mathrm{boot}} \left[ n_{j} \right]_{\mathrm{boot}} \right) = 0 .\tag{3.79} $$将 $i = j$ 的项与其余项(贡献均相同)分离,并利用式(3.77),得到:
$$ \frac{1} {N} \left( 1 - \frac{1} {N} \right) + \left( \frac{N - 1} {N} \right) \left( \left[ n_{i} n_{j} \right]_{\mathrm{boot}} - [ n_{i} ]_{\mathrm{boot}} \left[ n_{j} \right]_{\mathrm{boot}} \right) = 0 ,\tag{3.80} $$最终可得:
$$ \left[ n_{i} n_{j} \right]_{\mathrm{boot}} - \left[ n_{i} \right]_{\mathrm{boot}} \left[ n_{j} \right]_{\mathrm{boot}} = - \frac{1} {N} .\tag{3.81} $$现在我们可以着手计算不同量的平均值。特别地,从简单情况 $\mu = \langle x \rangle$ 开始。对于给定自助法数据集,其平均值为:
$$ x_{\alpha}^{B} = \frac{1} {N} \sum_{i = 1}^{N} n_{i , \alpha} x_{i} .\tag{3.82} $$于是 $\mu$ 的最终自助法估计由下式给出:
$$ \overline{{x^{B}}} = \frac{1} {N_{\mathrm{boot}}} \sum_{\alpha = 1}^{N_{\mathrm{boot}}} x_{\alpha}^{B} = \frac{1} {N} \sum_{i = 1}^{N} \left[ n_{i} \right]_{\mathrm{boot}} x_{i} = \frac{1} {N} \sum_{i = 1}^{N} x_{i} = \overline{{x}} ,\tag{3.83} $$其中使用了式(3.76)。因此,对所有自助法数据集平均得到的结果恰好等于原始数据集 $\{x_{i} \}$ 的平均值。接下来,为了计算方差,我们注意到:
$$ \overline{{( x^{B} )^{2}}} = \frac{1} {N_{\mathrm{boot}}} \sum_{\alpha = 1}^{N_{\mathrm{boot}}} \left( x_{\alpha}^{B} \right)^{2} = \frac{1} {N^{2}} \sum_{i , j} \left[ n_{i} n_{j} \right]_{\mathrm{boot}} x_{i} x_{j} .\tag{3.84} $$利用式(3.77)和式(3.81),得到:
$$ s_{x^{B}}^{2} = {\overline{{( x^{B} )^{2}}}} - \left( {\overline{{x^{B}}}} \right)^{2} = {\frac{1} {N^{2}}} \left( 1 - {\frac{1} {N}} \right) \sum_{i = 1}^{N} x_{i}^{2} - {\frac{1} {N^{3}}} \sum_{i \neq j} x_{i} x_{j} = {\frac{s^{2}} {N}} ,\tag{3.85} $$其中 $s^{2}$ 是式(2.61)定义的方差。因此,期望值为:
$$ \left. {\overline{{x^{B}}}} \right. = \left. {\overline{{x}}} \right. = \mu ,\tag{3.86} $$$$ \left. s_{x^{B}}^{2} \right. = \left( \frac{N - 1} {N^{2}} \right) \sigma^{2} = \left( \frac{N - 1} {N} \right) \sigma_{\overline{{{x}}}}^{2} ,\tag{3.87} $$其中使用了式(2.58)和式(2.63)。总之,方差 $\sigma_{\overline{{x}}}^{2}$ 的自助法估计由 $N / ( N - 1 ) s_{x^{B}}^{2}$ 给出。此过程无需计算式(3.71)中的偏导数;因此,它比直接的误差传播更容易实现。
类似地,我们可以轻松计算 $f ( \mu_{x} , \mu_{y} )$ 的自助法估计:
$$ \begin{array} {r} {f_{\alpha}^{B} = f \left( x_{\alpha}^{B} , y_{\alpha}^{B} \right) .} \end{array}\tag{3.88} $$最终的估计值通过平均自助法数据集得到:
$$ \overline{{f^{B}}} = \frac{1} {N_{\mathrm{boot}}} \sum_{\alpha = 1}^{N_{\mathrm{boot}}} f_{\alpha}^{B} ,\tag{3.89} $$而误差棒则由下式计算:
$$ s_{f^{B}}^{2} = \overline{{{( f^{B} )^{2}}}} - \left( \overline{{{f^{B}}}} \right)^{2} .\tag{3.90} $$事实上,可以证明,通过将 $f_{\alpha}^{B}$ 在 $f ( \mu_{x} , \mu_{y} )$ 附近展开(类似于式(3.66)中的做法):
$$ f_{\alpha}^{B} = f \left( x_{\alpha}^{B} , y_{\alpha}^{B} \right) \approx f ( \mu_{x} , \mu_{y} ) + ( \partial_{\mu_{x}} f ) \Delta_{\alpha , x}^{B} + ( \partial_{\mu_{y}} f ) \Delta_{\alpha , y}^{B} ,\tag{3.91} $$其中 $\Delta_{\alpha , x}^{B} = ( x_{\alpha}^{B} - \mu_{x} )$ 且 $\Delta_{\alpha , y}^{B} = ( y_{\alpha}^{B} - \mu_{y} )$,然后按照公式 (3.83) 和 (3.85) 的步骤,我们得到 $\sigma_{\overline{{f}}}^{2}$ 的自助法估计由 $N / ( N - 1 ) s_{f^{B}}^{2}$ 给出。
自助法(bootstrap method)的缺点在于,单次自助抽样中约有 37% 的数据点未被选中。实际上,在给定自助样本 $\alpha$ 中,某个数据点未被抽取的概率是 $( 1 - 1 / N )^{N}$,当 N 很大时趋近于 $e^{- 1} \approx 0.37$。因此,原始数据集的许多信息未被利用。下面,我们描述一种不存在这个问题的替代方法。
3.10.3 刀切法#
在刀切法(jackknife approach)中,我们将第 i 个估计值定义为原始数据集中除第 i 个点外所有数据的平均值。和之前一样,我们从 $\mu = \langle x \rangle$ 的简单情况开始讨论。此时我们有:
$$ x_{i}^{J} = \frac{1} {N - 1} \sum_{\substack{j = 1 ( j \neq i )}}^{N} x_{j} = \frac{N} {N - 1} \overline{{x}} - \frac{1} {N - 1} x_{i} .\tag{3.92} $$$\mu$ 的最终刀切估计由下式给出:
$$ {\overline{{x^{J}}}} = {\frac{1} {N}} \sum_{i = 1}^{N} x_{i}^{J} = {\frac{N} {N - 1}} {\overline{{x}}} - {\frac{1} {N - 1}} {\overline{{x}}} = {\overline{{x}}} .\tag{3.93} $$为了计算与之相关的误差线,我们注意到:
$$ \overline{{( x^{J} )^{2}}} = \frac{1} {N} \sum_{i = 1}^{N} \left( x_{i}^{J} \right)^{2} = \overline{{x}}^{2} + \frac{1} {( N - 1 )^{2}} \left( \overline{{x^{2}}} - \overline{{x}}^{2} \right) .\tag{3.94} $$方差的刀切估计从下式得到:
$$ s_{x^{J}}^{2} = {\overline{{( x^{J} )^{2}}}} - \left( {\overline{{x^{J}}}} \right)^{2} = {\frac{1} {( N - 1 )^{2}}} \left( {\overline{{x^{2}}}} - {\overline{{x}}}^{2} \right) = {\frac{s^{2}} {( N - 1 )^{2}}} .\tag{3.95} $$公式 (3.93) 的期望值显然是均值 $\mu$,而公式 (3.95) 的期望值是均值的方差除以 $( N - 1 )$:
$$ \langle{\overline{{x^{J}}}} \rangle = \langle{\overline{{x}}} \rangle = \mu ,\tag{3.96} $$$$ \langle s_{x^{J}}^{2} \rangle = \frac{\sigma^{2}} {N ( N - 1 )} = \frac{\sigma_{\overline{{x}}}^{2}} {N - 1} ,\tag{3.97} $$这里我们再次使用了公式 (2.58) 和 (2.63)。总之,方差 $\sigma_{\overline{{x}}}^{2}$ 的刀切估计由 $( N - 1 ) s_{x^{J}}^{2}$ 给出。注意,在刀切法中有一个因子 $( N - 1 )$ 乘在 $s_{x^{J}}^{2}$ 上,这是因为新样本之间高度相关,除了每个样本忽略了恰好一个点之外,它们几乎是相同的。
与自助法中所讨论的类似,刀切技术可用于估计任何期望值函数。我们只需定义:
$$ \begin{array} {r} {f_{i}^{J} = f \left( x_{i}^{J} , y_{i}^{J} \right) .} \end{array}\tag{3.98} $$最终估计通过对刀切数据集取平均得到:
$$ \overline{{f^{J}}} = \frac{1} {N} \sum_{i = 1}^{N} f_{i}^{J} ,\tag{3.99} $$而误差线从下式获得:
$$ s_{f^{J}}^{2} = \overline{{( f^{J} )^{2}}} - \left( \overline{{f^{J}}} \right)^{2} .\tag{3.100} $$同样,将 $f_{i}^{J}$ 在 $f ( \mu_{x} , \mu_{y} )$ 附近展开:
$$ f_{i}^{J} = f \left( x_{i}^{J} , y_{i}^{J} \right) \approx f ( \mu_{x} , \mu_{y} ) + ( \partial_{\mu_{x}} f ) \Delta_{i , x}^{J} + ( \partial_{\mu_{y}} f ) \Delta_{i , y}^{J} ,\tag{3.101} $$其中 $\Delta_{i , x}^{J} = ( x_{i}^{J} - \mu_{x} )$ 且 $\Delta_{i , y}^{J} = ( y_{i}^{J} - \mu_{y} )$,然后按照式(3.93)和式(3.95)的步骤,我们得到方差 $\sigma_{\overline{{f}}}^{2}$ 的刀切估计量为 $( N - 1 ) s_{f^{J}}^{2}$
3.11 相关采样中的误差棒#
现在让我们讨论原始数据集由相关点组成的情况,即集合 $\{x_{i} \}$(其中 $i = 1 , \ldots , N$)不是相互独立的。每当数据集不是通过直接采样而是通过马尔可夫过程产生时,就会出现这种情况。确实,在这种情况下,后续点之间会存在一定程度的关联,因为通常很难接受一个与先前状态完全去相关的新构型。尽管如此,对于相关数据集而言,平均值仍然是对精确均值的一个无偏估计:
$$ \langle \overline{{x}} \rangle = \frac{1} {N} \sum_{i = 1}^{N} \langle x_{i} \rangle = \langle x \rangle ,\tag{3.102} $$因为平均值是数据集 $\{x_{i} \}$ 的线性函数。相比之下,式(2.61)中定义的量 $s^{2}$ 不再是精确方差的无偏估计:
$$ \langle s^{2} \rangle = \frac{1} {N} \sum_{i} \langle x_{i}^{2} \rangle - \frac{1} {N^{2}} \sum_{i , j} \langle x_{i} x_{j} \rangle \neq \left( \frac{N - 1} {N} \right) \sigma_{x}^{2} ,\tag{3.103} $$这是由于 $\langle x_{i} x_{j} \rangle ~ \neq ~ \langle x_{i} \rangle \langle x_{j} \rangle$ 导致的。一般而言,使用 $s^{2}$ 来估计方差会导致低估误差棒。
为了解决这个问题,我们可以采用所谓的分箱技术(binning technique,也称为分块分析)。我们将来自长马尔可夫链的数据集 $\{x_{i} \}$ 分成若干段(即箱),共 $N_{\mathrm{bin}}$ 段,每段长度为 $L_{\mathrm{{bin}}} ~ = ~ N / N_{\mathrm{{bin}}}$。在每个索引为 $j$ 的箱上,$j = 1 , \ldots , {N_{\mathrm{bin}}}$,我们定义局部平均值:
$$ x^{j} = \frac{1} {L_{\mathrm{bin}}} \sum_{i = ( j - 1 ) L_{\mathrm{bin}} + 1}^{j L_{\mathrm{bin}}} x_{i} .\tag{3.104} $$显然,对所有箱取平均等于原始平均值:
$$ \overline{{x^{j}}} = \frac{1} {N_{\mathrm{bin}}} \sum_{j = 1}^{N_{\mathrm{bin}}} x^{j} = \overline{{x}} .\tag{3.105} $$然而,“新的”(分箱后的)变量 $x^{j}$ 的概率分布与 $x_{i}$ 的不同。根据式(3.104)的定义,$x^{j}$ 的方差通常小于 $x_{i}$ 的方差。当原始变量已经相互独立且 $N_{\mathrm{bin}}$ 很大时,这个事实很容易理解:在这种情况下,第2.7节讨论的中心极限定理成立,意味着分箱后变量的方差是原始变量方差的 $1 / L_{\mathrm{bin}}$。在一般情况下,通过增加箱长 $L_{\mathrm{bin}}$,新变量 $x^{j}$ 之间会越来越不相关,最终成为独立的随机变量。事实上,在马尔可夫过程的平衡部分之后(我们假设在 $i = 1$ 步时已完成该过程),平均关联函数:
$$ C ( n - m ) = \langle x_{n} x_{m} \rangle - \langle x_{n} \rangle \langle x_{m} \rangle ,\tag{3.106} $$仅依赖于离散时间差 $n - m$(因为平稳性意味着时间齐次性),并以指数形式趋近于零:$C ( n - m ) \propto e^{- | n - m | / \tau}$,其中 $\tau$(以离散时间步长为单位)是马尔可夫链中的关联时间(correlation time)。
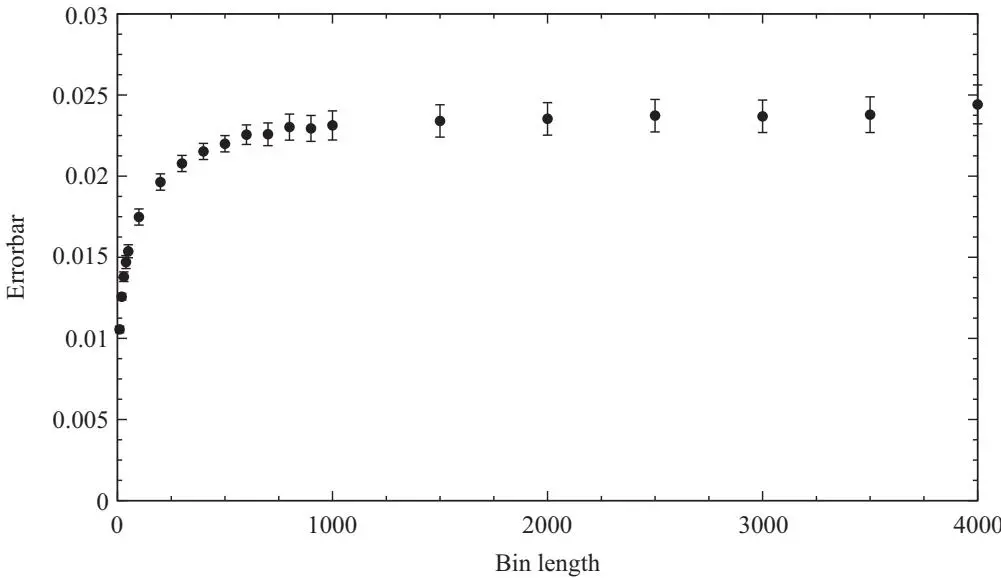
图3:6 在基于马尔可夫链过程的典型模拟中,使用分箱技术估计的误差棒 $s_{\overline{{x}}}$ 随箱长 $L_{\mathrm{bin}}$ 的变化。
因此,如果我们取 $L_{\mathrm{bin}}$ 足够大于 τ,那么不同的箱平均值 $x^{j}$ 可以被合理地视为独立的随机变量,并且方差可以很容易地估计:
$$ s_{\mathrm{bin}}^{2} = \frac{1} {N_{\mathrm{bin}}} \sum_{j = 1}^{N_{\mathrm{bin}}} \left( x^{j} - \overline{{x}} \right)^{2} .\tag{3.107} $$于是,平均值 (3.105) 的方差为:
$$ s_{\overline{{x}}}^{2} = {\frac{s_{\mathrm{bin}}^{2}} {N_{\mathrm{bin}}}} .\tag{3.108} $$平均值的误差棒由 $s_{\overline{{x}}}^{2}$ 的平方根给出。注意,在原始变量已经不相关的情况下,分箱变量缩小的方差(即, $1 / L_{\mathrm{bin}}$ )被其更少的数量(即 $N_{\mathrm{bin}}$ )所补偿,使得分箱过程前后的均值方差相同。在图 3.6 中,我们展示了一个相关测量的典型情况,其中误差棒 $s_{\overline{{x}}}$ 取决于分箱长度,并且在 $L_{\mathrm{bin}}$ 足够大时呈现一个平台值(plateaux)。