第2章 · 概率论#
2.1 引言#
利用经典力学定律,原则上我们可以通过精确知晓初始条件(即所有相关自由度的位置和速度)来对事件做出精确预测。然而,在实践中,有些事件是不可预测的,这本质上是因为我们不可能精确掌握初始条件,而这些条件中的极小误差会随时间呈指数增长,从而使得任何遵循精确运动方程的尝试都失效。当我们抛硬币或掷骰子时,我们不知道事件的结果,但我们可以赋予每个事件一定的概率,例如,抛硬币时正面和反面的概率各为1/2,或者掷骰子时每一面的概率为1/6(假设我们使用的是公正的硬币和骰子)。概率衡量了某个给定事件发生的可能性大小。当然,它基于一种数学方法,将不可预测性转化为某种可预测的东西。
这个想法看似非常简单,但人类却花了几百年才理解它。事实上,自古希腊和罗马帝国时期(以及亚洲,例如印度)的人们就热衷于赌博;然而,却没有人试图理解随机事件与数学规律之间的关系。许多争吵和争端都是通过抛硬币来解决的,结果被视为"天意"的显现。人类的迷信思想构成了用科学(即数学)方法处理随机事件的巨大障碍。最终,经过数百年,迷信被一种更强烈的人类冲动所克服:获取经济利益的欲望。
概率的数学理论诞生于吉罗拉莫·卡尔达诺的研究,他意识到对于等可能事件(如抛硬币或掷骰子),单个事件出现的概率等于所有可能事件总数的倒数(与任何"天意"无关)。因此,抛硬币得到正面的概率是$1/2$(与得到反面的概率相同);掷骰子得到1点的概率是$1/6$,而得到奇数点的概率是$3/6$。卡尔达诺经常缺钱,他通过成为一名技艺高超的赌徒和国际象棋选手来维持生计。他的著作《论赌博游戏》(Liber de ludo aleae)大约写于1560年,但直到1663年才出版,其中包含了概率论最早的系统性论述。
尽管卡尔达诺首次阐述了随机事件,但通向现代概率论最重要的概念飞跃是由布莱兹·帕斯卡和皮埃尔·德·费马在17世纪完成的,当时他们回答了法国一位常客夏瓦利埃·德·梅雷提出的几个问题。当时流行一种游戏,多次掷两个骰子,押注至少出现一次双一(双幺)。夏瓦利埃·德·梅雷想知道需要进行多少次尝试才能使游戏有利可图(即出现双幺的概率大于$1/2$)。另一个问题则更为复杂,奠定了概率论真正的基石。这个问题可以简单地这样说明:有两名玩家(例如,费马和帕斯卡)在抛硬币:正面给费马加一分,反面给帕斯卡加一分。先得到3分的玩家将赢得100法郎的赌注。然而,由于某种原因,两位赌徒必须中断游戏,此时费马有2分,帕斯卡只有1分;那么这100法郎的赌注该如何分配?
让我们简要讨论这些问题的解答。对于第一个问题,直接计算有利事件的概率$P$需要进行繁琐的计算,而评估不利事件的概率$Q$然后取其补数则容易得多,即$P = 1 - Q$。在本例中,掷一次骰子得到双六(成功事件)的概率是$1/36$,而该事件不出现的概率显然是$35/36$。因此,在N次试验中至少得到一次双六的概率是$1 - (35/36)^{N}$,即1减去N次试验中未出现成功事件的概率。当$N = 25$时,至少出现一次双六的概率大于$1/2$,因此押注双六变得有利可图。关于第二个问题,关键在于我们不应关注过去发生了什么,而应关注未来可能发生什么。实际上,以下两种回答都不正确:(a) 费马全部拿走,因为他赢的盘数多于帕斯卡,以及(b) 费马拿走帕斯卡的两倍,因为比分是$2-1$。正确的做法是看如果他们继续比赛,可能的结果是什么。那么,可能的结果有:正-正、正-反、反-正、反-反;只有在最后一种情况下帕斯卡会赢,而在其他三种情况下费马会赢。因此,费马应拿总赌注的$3/4$,帕斯卡只拿$1/4$。今天看来,这个结果或许显而易见;然而在十七世纪,认为未来事件可以用严格的数学方法来处理,这一想法代表了令人难以置信的进步。
概率有几种不同的定义,根植于不同的哲学观点。经典定义可追溯到皮埃尔-西蒙·拉普拉斯(Pierre Simon Laplace),他将某个情况的概率定义为有利事件数与可能事件总数之比,前提是所有事件都是等可能的(equiprobable)。这个定义并不令人满意,因为它本身就需要等可能性的概念。此外,当事件不等可能时,它无法给出定义,并且假设结果是有限的(因此不适用于连续变量)。为克服这些困难,引入了频率主义概率定义(frequentist definition of probability):它定义一个事件的概率为在大数次试验中其相对频率的极限。这种解释需要某个游戏或实验能够在相同物理条件下重复多次。本书采用这一观点。我们假设存在可重复的实验,这些实验在非常相似的初始条件下,会产生不同的事件(用$E_{i}$表示,这是一个布尔变量,当事件i发生时取真,否则取假)。在频率主义定义下,分配给任何事件$E_{i}$的概率由事件$E_{i}$发生的次数$n_{i}$与总试验次数N之比给出,当N变得非常大时:
$$ P ( E_{i} {\mathrm{~ i s ~ t r u e}} ) \equiv P ( i ) = \operatorname*{lim}_{N \infty} {\frac{n_{i}} {N}} ;\tag{2.1} $$显然,概率是一个非负数:
$$ \begin{array} {r} {P ( i ) \geq 0 .} \end{array}\tag{2.2} $$接下来,我们简要概述概率论(theory of probability)。对于这一主题,Gnedenko(2014)的著作给出了清晰而全面的阐述,其中还包括俄罗斯数学家安德雷·尼古拉耶维奇·柯尔莫哥洛夫(Andrey Nikolaevich Kolmogorov)在1933年提出的公理化方法。
2.2 事件与概率#
这里,我们描述事件的一些简单性质。两个事件$E_{i}$和$E_{j}$称为互斥的(mutually exclusive),当且仅当$E_{i}$的发生意味着$E_{j}$不发生,反之亦然。如果$E_{i}$和$E_{j}$互斥,则有:
$$ P ( E_{i} {\mathrm{~ i s ~ t r u e ~ a n d ~}} E_{j} {\mathrm{~ i s ~ t r u e}} ) = 0 ,\tag{2.3} $$$$ P ( E_{i} {\mathrm{~ i s ~ t r u e ~ o r ~}} E_{j} {\mathrm{~ i s ~ t r u e}} ) = P ( i ) + P ( j ) .\tag{2.4} $$实验中不同的结果代表了互斥事件(例如,掷硬币时,正面和反面代表两个互斥事件)。显然,如果所有可能互斥事件的总数为M,那么它们在全部结果空间上的概率之和为:
$$ \sum_{i = 1}^{M} P ( i ) = 1 .\tag{2.5} $$一旦给定实验的所有M个互斥事件都被分类,每次实验的实现都由单个整数i指定,此时事件$E_{i}$成立。因此,我们可以定义一个随机变量(random variable)$X_{i}$,作为与任何可能成功事件$E_{i}$相关联的实值函数。最简单的随机变量是指征随机变量(characteristic random variable)$X_{i}^{[ j ]}$
X_{i}^{[ j ]} = \left{\begin{array} {l l} {{1}} & {{\mathrm{~ 如果~} i = j ( E_{j} \mathrm{~ 成立} )}} \ {{0}} & {{\mathrm{~ 如果~} i \ne j ( E_{j} \mathrm{~ 不成立} )}} \end{array} \right.\tag{2.6}
换句话说,只有当事件$E_{j}$成功时,特征随机变量$X_{i}^{[ j ]}$才非零:例如,如果我们在轮盘赌中押注数字36会出现,那么与赢注相关的成功事件就是36出现,而所有其他数字都会导致输注。另一个随机变量的例子是掷骰子后的实际结果,即出现的点数:
X_{i} = i {\mathrm{如果}} E_{i} {\mathrm{成立}} ,\tag{2.7}
其中$i = 1 , \ldots , 6$
现在我们来讨论复合事件的情况。例如,掷两个骰子是一个可以用$E_{i}^{( 1 )}$和$E_{j}^{( 2 )}$来描述的实验,其中$E_{j}^{( 1 )} ( E_{j}^{( 2 )} )$指第一个(第二个)骰子的可能结果。对于复合事件,概率由不止一个指标标记,特别是两个事件的联合概率(joint probability)$P ( i , j )$定义为:
P_{\text{联合}} ( i , j ) = P ( E_{i}^{( 1 )} {\mathrm{~ 成立 \ 且 }} E_{j}^{( 2 )} {\mathrm{~ 成立 ) .}}\tag{2.8}
为了得到单一变量的概率(比如$E_{i}^{( 1 )}$),根据频率主义概率定义(2.1),我们需要对另一个变量(比如$E_{j}^{( 2 )}$)的所有值求和联合概率。这样,我们得到边际概率(marginal probability):
P_{1} ( i ) = \sum_{j = 1}^{M} P_{\text{联合}} ( i , j ) ,\tag{2.9}
它代表了得到变量$E_{i}^{( 1 )}$的概率,而不关心变量$E_{j}^{( 2 )}$的结果。相反,我们可能对在已知变量$E_{j}^{( 2 )}$结果的情况下得到$E_{i}^{( 1 )}$的概率感兴趣;这就是条件概率(conditional probability)$\omega ( i | j )$:
\omega ( i | j ) = \frac{P_{\text{联合}} ( i , j )} {\sum_{i = 1}^{M} P_{\text{联合}} ( i , j )} ,\tag{2.10}
它是归一化的:
$$ \sum_{i = 1}^{M} \omega ( i | j ) = 1 .\tag{2.11} $$由于$\begin{array} {r} {\sum_{i = 1}^{M} P_{\text{联合}} ( i , j ) = P_{2} ( j )} \end{array}$,我们有:
\omega ( i | j ) = \frac{P_{\text{联合}} ( i , j )} {P_{2} ( j )} ,\tag{2.12}
因此,联合概率可以表示为边际概率$P_{2} ( j )$乘以条件概率$\omega ( i | j )$:
P_{\text{联合}} ( i , j ) = \omega ( i | j ) P_{2} ( j ) .\tag{2.13}
类似地,我们也可以得到:
P_{\text{联合}} ( i , j ) = \omega ( j | i ) P_{1} ( i ) .\tag{2.14}
结合公式 (2.13) 和 (2.14),我们得到贝叶斯公式(Bayes formula):
$$ \omega ( j | i ) P_{1} ( i ) = \omega ( i | j ) P_{2} ( j ) .\tag{2.15} $$当一个随机变量i不依赖于另一个随机变量$j$时,即条件概率$\omega ( i | j )$不依赖于$j$时,我们说i与$j$相互独立(independent);在这种情况下,我们有$P_{1} ( i ) =$ $\begin{array} {r} {\sum_{j = 1}^{M} \omega ( i | j ) P_{2} ( j ) = \omega ( i | j )} \end{array}$,将其代入公式 (2.13) 得到:
P_{\text{联合}} ( i , j ) = P_{1} ( i ) P_{2} ( j ) ;\tag{2.16}
注意,由方程 (2.14) 可知,$P_{2} ( j ) = \omega ( j | i )$,这意味着变量 j 也与 i 相互独立。
上述定义的推广显然也适用于定义在连续统上的随机变量 x,即那些在给定区间内取任意实数值而非仅离散值的变量。在这种情况下,得到某个特定值 x 的概率通常为零,而在有限范围 $(a, b)$ 内找到该随机变量的概率是有限的。具体而言,我们可以考虑 x 小于给定实数 y 的概率:
$$ P ( x \leq y ) = F ( y ) = \int_{- \infty}^{y} d x \mathcal{P} ( x ) ,\tag{2.17} $$这被称为随机变量 x 的累积概率(cumulative probability)。显然 $F ( + \infty ) = 1$ 。概率密度或分布函数 ${\mathcal{P}} ( x )$ 由下式给出:
$$ \mathcal{P} ( x ) = \left. \frac{d F ( y )} {dy} \right| _{y = x} ,\tag{2.18} $$它满足以下性质:
$$ \mathcal{P} ( x ) \geq 0 ,\tag{2.19} $$$$ \int_{- \infty}^{+ \infty} d x \mathcal{P} ( x ) = 1 .\tag{2.20} $$注意,通过采用下式,上述定义也可用于离散随机变量的情况:
$$ \mathcal{P} ( x ) = \sum_{i = 1}^{M} P ( i ) \delta ( x - X_{i} ) .\tag{2.21} $$因此,在后续内容中,我们将采用连续随机变量的形式体系,同时牢记离散情况可通过考虑公式 (2.21) 简单获得。
与之前类似,变量 x 的边际概率(marginal probability)定义为:
$$ {\mathcal P}_{1} ( x ) = \int_{- \infty}^{+ \infty} d y ~ {\mathcal P}_{\mathrm{joint}} ( x , y ) ,\tag{2.22} $$在已知 y 的情况下得到 x 的条件概率(conditional probability)由下式给出:
$$ \omega ( x | y ) = \frac{\mathcal{P}_{\mathrm{joint}} ( x , y )} {\int_{- \infty}^{+ \infty} d x \mathcal{P}_{\mathrm{joint}} ( x , y )} ,\tag{2.23} $$使得:
$$ \mathcal{P}_{\mathrm{joint}} ( x , y ) = \omega ( x | y ) \mathcal{P}_{2} ( y ) = \omega ( y | x ) \mathcal{P}_{1} ( x ) .\tag{2.24} $$2.3 分布的矩:均值与方差#
对于任意随机变量 x,我们可以定义其均值或期望值(expected value):
$$ \mu \equiv \langle x \rangle = \int_{- \infty}^{+ \infty} d x x \mathcal{P} ( x ) .\tag{2.25} $$在频率学派方法中,随机变量的期望值就是同一实验多次重复的平均值。例如,掷骰子时,期望值为 3.5。对于事件 $E_{j}$ 的特征随机变量(characteristic random variable)$X_{i}^{[ j ]}$ ,我们简单有 $\langle X_{i}^{[ j ]} \rangle = P ( j )$ 。更一般地,分布的 n 阶矩(n-th moment)定义为 x 的 n 次幂的期望值:
$$ \langle x^{n} \rangle = \int_{- \infty}^{+ \infty} d x x^{n} {\mathcal{P}} ( x ) .\tag{2.26} $$一阶矩 $\langle x \rangle$ 等于均值 $\mu$ 。二阶矩让我们能够定义一个特别重要的量,即方差(variance):
$$ \sigma^{2} \equiv \langle x^{2} \rangle - \langle x \rangle^{2} = \int_{- \infty}^{+ \infty} d x ( x - \langle x \rangle )^{2} \mathcal{P} ( x ) .\tag{2.27} $$方差是一个非负的量,只有当所有非零概率的事件都给出相同的 x 值时,它才为零。换句话说,每当方差为零,变量的随机性就完全丧失,实验变得完全可预测。方差的平方根是随机变量离散程度的度量,称为标准差(standard deviation)。注意,在连续情况下,方差以及更高阶矩的存在并非是先天保证的。事实上,概率密度 ${\mathcal{P}} ( x )$ 必须在 $x \to \pm \infty$ 时足够快地衰减,才能使相应的积分存在。
在有两个随机变量的情况下,我们可以定义它们的协方差(covariance):
$$ \sigma_{xy}^{2} \equiv \langle x y \rangle - \langle x \rangle \langle y \rangle = \int_{- \infty}^{+ \infty} d x \int_{- \infty}^{+ \infty} d y ( x - \langle x \rangle ) ( y - \langle y \rangle ) \mathcal{P}_{\mathrm{joint}} ( x , y ) ;\tag{2.28} $$这里必须注意,量 $\sigma_{xy}^{2}$ 并不保证为正;尽管如此,与方差类似,我们仍偏好保留带平方的记号。显然,对于两个独立变量,由 $\mathcal{P}_{\mathrm{joint}} ( x , y ) = \mathcal{P}_{x} ( x ) \mathcal{P}_{y} ( y )$ 可得 $\sigma_{xy}^{2} = 0$。
最后,我们还可以考虑另一个随机变量 $y = f ( x )$ 的期望值:
$$ \left. f ( x ) \right. = \int_{- \infty}^{+ \infty} d x f ( x ) {\mathcal{P}} ( x ) .\tag{2.29} $$一个与概率密度 ${\mathcal{P}} ( x )$ 相关的重要量是特征函数(characteristic function) $\phi_{x} ( t )$,它是 $e^{ixt}$ 的期望值,或者说概率密度的傅里叶变换(Fourier transform):
$$ \phi_{x} ( t ) = \langle e^{ixt} \rangle = \int_{- \infty}^{+ \infty} d x e^{ixt} \mathcal{P} ( x ) .\tag{2.30} $$对于小的 $t$,如果二阶矩 $\langle x^{2} \rangle$ 有限,可以将指数展开至 $t$ 的二阶项,得到:
$$ \phi_{x} ( t ) = 1 + i \langle x \rangle t - \frac{\langle x^{2} \rangle} {2} t^{2} + o ( t^{2} ) ,\tag{2.31} $$其中 $o ( t^{2} )$ 是比 $t^{2}$ 更小的项:如果三阶矩也有限,则下一项将正比于 $t^{3}$;而如果 $\langle x^{3} \rangle = \infty$,该项将有一个介于 2 和 3 之间的幂次。反过来,概率密度 $\mathcal{P} ( x )$ 是特征函数的傅里叶变换:
$$ \mathcal{P} ( x ) = \frac{1} {2 \pi} \int_{- \infty}^{+ \infty} d t e^{- i x t} \phi_{x} ( t ) .\tag{2.32} $$在此,我们列出几个重要的分布函数示例。对于离散随机变量,最简单的情况是伯努利分布(Bernoulli distribution),以瑞士科学家雅各布·伯努利(Jacob Bernoulli)命名。在这种情况下,随机变量以"成功"概率 $\mathcal{P}$ 取值 1,以"失败"概率 $\mathcal{Q} = 1 - \mathcal{P}$ 取值 0。它可以用来代表一次抛硬币,其中 1 和 0 分别表示正面和反面。特别地,公平硬币有 $\mathcal{P} = \mathcal{Q} = 1 / 2$。伯努利分布的均值等于 $\mathcal{P}$,方差等于 $\mathcal{PQ}$。其特征函数为 $\phi_{\mathrm{bernulli}} ( t ) = \mathcal{Q} + \mathcal{P} e^{it}$。
另一个例子是二项分布(binomial distribution),它描述了在 $N$ 次独立试验(实验)序列中成功次数的情况,每次试验以概率 $\mathcal{P}$ 成功、以概率 $\mathcal{Q}$ 失败(例如,对伯努利变量进行 $N$ 次试验)。在 $N$ 次试验中获得 $k$ 次成功的概率为:
$$ P_{\mathrm{binomial}} ( k ) = \frac{N !} {k ! \ ( N - k ) !} \mathcal{P}^{k} \mathcal{Q}^{N - k} .\tag{2.33} $$二项分布的均值为 $N \mathcal{P}$,方差为 $N P \mathcal{Q}$。特征函数为 $\phi_{\mathrm{binomial}} ( t ) = [ \phi_{\mathrm{bernulli}} ( t ) ]^{N}$。在 $N \to \infty$ 且 $\mathcal{P} \to 0$、$N \mathcal{P} = \lambda$ 的极限下,$P_{\mathrm{binomial}} ( k )$ 趋近于泊松分布(Poisson distribution):
$$ P_{\mathrm{poisson}} ( k ) = e^{- \lambda} \frac{\lambda^{k}} {k !} ,\tag{2.34} $$它描述了大量试验 $( N \to \infty )$ 中稀有事件 $( \mathcal{P} \to 0 )$ 的概率。泊松分布的均值和方差都等于 $\lambda$。其特征函数为 $\phi_{\mathrm{poisson}} ( t ) = \exp [ \lambda ( e^{it} - 1 ) ]$。
对于连续随机变量,最简单的分布函数是均匀分布(uniform distribution),其中区间 $[a, b]$ 内 $x$ 的所有值等概率出现:
$$ \mathcal{P}_{\mathrm{uniform}} ( x ) = \left\{\begin{array} {l l} {\frac{1} {( b - a )}} & {\mathrm{if} a \leq x \leq b ,} \\ {0} & {\mathrm{otherwise} .} \end{array} \right.\tag{2.35} $$均匀分布的均值为 $(b + a) / 2$,方差为 $(b - a)^{2} / 12$。其特征函数为 $\phi_{\mathrm{uniform}} ( t ) = \left( e^{bt} - e^{at} \right) / [ t ( b - a ) ]$
最后,概率论中扮演核心角色的是高斯(或正态)分布(Gaussian/normal distribution),以德国科学家卡尔·弗里德里希·高斯(Carl Friedrich Gauss)命名:
$$ \mathcal{P}_{\mathrm{gauss}} ( x ) = \frac{1} {\sqrt{2 \pi \sigma^{2}}} e^{- \frac{( x - \mu )^{2}} {2 \sigma^{2}}} ,\tag{2.36} $$其中,$\mu$ 和 $\sigma^{2}$ 分别表示均值和方差。其特征函数(将在后续使用)由下式给出:
$$ \phi_{\mathrm{gauss}} ( t ) = e^{i \mu t} e^{- \frac{t^{2}} {2} \sigma^{2}} .\tag{2.37} $$2.4 随机变量的变换#
在本节中,我们简要展示当对随机变量应用一般变换时,概率密度如何被修改。假设我们有一个随机变量 $x$,并构造另一个随机变量 $y$,它是 $x$ 的函数:
$$ y = f ( x ) ,\tag{2.38} $$为简单起见,我们考虑一个单调函数 $f ( x )$,具有正导数,即 $d f ( x ) / d x > 0$,使得当 $x_{2} > x_{1}$ 时有 $f ( x_{2} ) = y_{2} > f ( x_{1} ) = y_{1}$($d f ( x ) / d x < 0$ 的情况可类似处理);对于非单调函数的一般情况,可以分别考虑函数单调的所有小区间。那么,在给定区间 $x_{1} < x < x_{2}$ 内找到 $x$ 的概率必须等于在区间 $y_{1} < y < y_{2}$ 内找到 $y$ 的概率:
$$ P_{y} ( y_{1} < y < y_{2} ) = P_{x} ( x_{1} < x < x_{2} ) .\tag{2.39} $$然后,对于一个小的区间 $d x = ( x_{2} - x_{1} )$,其中 $d y = d f ( x )$,我们有:
$$ \mathcal{P}_{y} ( y ) d y = \mathcal{P}_{x} ( x ) d x .\tag{2.40} $$该方程给出了 $x$ 和 $y$ 处概率密度值之间的逐点关系,我们可以对两边积分得到:
$$ \int_{- \infty}^{y} d s \mathcal{P}_{y} ( s ) = \int_{- \infty}^{x} d t \mathcal{P}_{x} ( t ) .\tag{2.41} $$这个关系的有用之处在于,一旦我们知道变量 $x$ 的概率密度 $\mathcal{P}_{x} ( x )$,以及 $x$ 与 $y$ 之间的关系——即函数 $f ( x )$,就可以得到变量 $y$ 的概率密度 $\mathcal{P}_{y} ( y )$。注意,当 $d f ( x ) / d x < 0$ 时,唯一的修改来自交换方程(2.41)右侧的积分限。
上述关系的最简单应用是考虑线性变换时:
$$ y = a + b x ;\tag{2.42} $$那么,我们简单地得到:
$$ \mathcal{P}_{y} ( y ) = \frac{1} {b} \mathcal{P}_{x} \left( \frac{y - a} {b} \right) .\tag{2.43} $$因此,我们立即得到:如果随机变量 $x$ 的均值为 $\mu_{x}$,方差为 $\sigma_{x}^{2}$,那么变换后的随机变量 $y$ 的均值 $\mu_{y} = a + b \mu_{x}$,方差 $\sigma_{y}^{2} = b^{2} \sigma_{x}^{2}$。
2.5 切比雪夫不等式#
切比雪夫不等式(Chebyshev's inequality)给出了结果 $x$ 远离均值 $\langle x \rangle$ 时概率的简单界限;精确表述是,分布中超过 $k$ 个标准差距离均值的值不会超过 $1 / k^{2}$:
$$ P \left( | x - \langle x \rangle | > k \sigma \right) \leq \frac{1} {k^{2}} ,\tag{2.44} $$或等价地,取 $\epsilon = k \sigma$:
$$ P \left( | x - \langle x \rangle | > \epsilon \right) \leq \frac{\sigma^{2}} {\epsilon^{2}} .\tag{2.45} $$切比雪夫不等式的证明非常简单。实际上,根据定义:
$$ P \left( | x - \langle x \rangle | > \epsilon \right) = \int_{- \infty}^{\langle x \rangle - \epsilon} d x \mathcal P ( x ) + \int_{\langle x \rangle + \epsilon}^{+ \infty} d x \mathcal P ( x ) ;\tag{2.46} $$在这两个区间 $[ ( x - \langle x \rangle ) / \epsilon ]^{2} \ge 1$ 内,因此我们有:
$$ \begin{array} {r l r} {{P ( | x - \langle x \rangle | > \epsilon ) \le \int_{- \infty}^{\langle x \rangle - \epsilon} d x ( \frac{x - \langle x \rangle} {\epsilon} )^{2} \mathcal{P} ( x ) + \int_{\langle x \rangle + \epsilon}^{+ \infty} d x ( \frac{x - \langle x \rangle} {\epsilon} )^{2} \mathcal{P} ( x )}} \\ & {} & {\le \displaystyle \int_{- \infty}^{+ \infty} d x ( \frac{x - \langle x \rangle} {\epsilon} )^{2} \mathcal{P} ( x ) = \frac{\sigma^{2}} {\epsilon^{2}} . \qquad ( 2.4 \pi )} \end{array}\tag{7} $$切比雪夫界(Chebyshev's bound)非常通用,且不假设概率分布 ${\mathcal{P}} ( x )$ 的具体形式;因此,它对找到大幅波动(即找到远离期望值的事件)的概率给出了相当弱的界限。对于特定分布,可以得到强得多的界限。例如,在表2.1中,我们报告了方程(2.44)的切比雪夫界与方程(2.36)的高斯分布(Gaussian distribution)实际值之间的比较。
表2.1. 随机变量偏离其均值大于k个标准差σ的概率。方程(2.44)的切比雪夫界(左列)与方程(2.36)的高斯分布实际值(右列)比较。
| k | 切比雪夫界 | 高斯值 |
| 1 | 1.0000 | 0.3173 |
| 2 | 0.2500 | 0.0455 |
| 3 | 0.1111 | 0.0027 |
| 4 | 0.0625 | $6.3 \times 10^{- 5}$ |
| 5 | 0.0400 | $5.8 \times 10^{- 7}$ |
| 6 | 0.0278 | $2.0 \times 10^{- 9}$ |
| 7 | 0.0204 | $2.5 \times 10^{- 12}$ |
| 8 | 0.0156 | $1.2 \times 10^{- 15}$ |
2.6 独立随机变量的求和#
这里,我们处理多个独立随机变量 $x_{1} , \ldots , x_{N}$ 的情况,推广第2.2节的论证,联合概率是边缘概率的乘积,即 $\mathcal{P} ( x_{1} , \ldots , x_{N} ) = \mathcal{P}_{1} ( x_{1} ) \ldots \mathcal{P}_{N} ( x_{N} )$ 。然后,考虑这些变量的和作为“新”随机变量通常是有用的。求和(独立同分布随机变量)的主要动机是,当N很大时,即 $N \to \infty$ (Gnedenko and Kolmogorov, 1954),可以得到关于求和分布函数的重要且有性质的性质。让我们从z作为两个随机变量的和开始:
$$ z = x_{1} + x_{2} .\tag{2.48} $$其概率密度简化为:
$$ \mathcal{P}_{z} ( z ) = \int_{- \infty}^{+ \infty} d x_{1} \int_{- \infty}^{+ \infty} d x_{2} \mathcal{P}_{1} ( x_{1} ) \mathcal{P}_{2} ( x_{2} ) \delta ( z - x_{1} - x_{2} ) ,\tag{2.49} $$其中δ函数强制z是 $x_{1}$ 和 $x_{2}$ 的和。因此,通过对 $x_{2}$ 积分,有 $\mathcal{P}_{z} ( z )$ 简化为概率密度的卷积:
$$ {\mathcal{P}}_{z} ( z ) = \int_{- \infty}^{+ \infty} d x_{1} ~ {\mathcal{P}}_{1} ( x_{1} ) ~ {\mathcal{P}}_{2} ( z - x_{1} ) ,\tag{2.50} $$其含义如下:给定值z的概率是通过对所有可能的变量 $x_{1}$ 结果求和(或积分)得到的,即找到 $x_{1}$ 的概率乘以 $x_{2} = z - x_{1}$ 的概率。由方程(2.50),两个独立随机变量 $x_{1}$ 和 $x_{2}$ 之和的特征函数(characteristic function)是这两个特征函数的乘积:
$$ \phi_{z} ( t ) = \phi_{1} ( t ) \phi_{2} ( t ) .\tag{2.51} $$让我们看一些可以轻松获得随机变量之和概率的例子。最简单的情况是两个随机变量在[0, 1]上均匀分布,得到“三角”分布:
$$ \mathcal{P}_{z} ( z ) = \left\{\begin{array} {l l} {0} & {\mathrm{i f ~} z \le 0 ,} \\ {z} & {\mathrm{i f ~} 0 \le z \le 1 ,} \\ {2 - z} & {\mathrm{i f ~} 1 \le z \le 2 ,} \\ {0} & {\mathrm{i f ~} z \ge 2 .} \end{array} \right.\tag{2.52} $$正如预期的那样,求和结果不可能为负或超过2,而最可能的值(同时也是均值)是 $z = 1$ 。这个例子是投掷两枚骰子并考虑其点数之和这一离散情形的连续版本:最可能的点数和是7,而小于2或大于12的结果则不可能出现。
接下来,三个均匀分布随机变量之和 $z = x_{1} + x_{2} + x_{3}$ 的分布可以通过先对其中两个求和得到“三角形”分布,再利用方程(2.50)加入第三个变量来轻松获得。这一过程给出了三个均匀分布变量之和的如下分布:
$$ \mathcal{P}_{z} ( z ) = \left\{\begin{array} {l l} {0} & {\mathrm{if} z \leq 0 ,} \\ {\frac{z^{2}} {2}} & {\mathrm{if} 0 \leq z \leq 1 ,} \\ {\frac{3} {4} - \left( z - \frac{3} {2} \right)^{2}} & {\mathrm{if} 1 \leq z \leq 2 ,} \\ {\frac{( 3 - z )^{2}} {2}} & {\mathrm{if} 2 \leq z \leq 3 ,} \\ {0} & {\mathrm{if} z \geq 3 .} \end{array} \right.\tag{2.53} $$这里,最可能的值是 $z = 3 / 2$ 。这一过程的趋势是清晰的:当相加越来越多的随机变量时,分布的均值和方差都会增加。通常,随机变量之和的概率取决于变量的数量。一个显著的例外是高斯变量,对于它们,两个随机数之和仍然是高斯分布。事实上,利用方程(2.51)和高斯分布特征函数(2.37)的形式,我们有(用 $\mu_{1}$ 和 $\mu_{2}$ 表示均值,用 $\sigma_{1}^{2}$ 和 $\sigma_{2}^{2}$ 表示两个变量的方差):
$$ \phi_{z} ( t ) = e^{i ( \mu_{1} + \mu_{2} ) t} e^{- \frac{t^{2}} {2} ( \sigma_{1}^{2} + \sigma_{2}^{2} )} ,\tag{2.54} $$这正是均值为 $\mu_{z} = \mu_{1} + \mu_{2}$ 、方差为 $\sigma_{z}^{2} = \sigma_{1}^{2} + \sigma_{2}^{2}$ 的高斯变量的特征函数。
如果随机变量具有一般的分布函数,那么它们之和的分布函数形式将非常复杂。值得注意的是,在非常一般的条件下,当独立变量个数 $N$ 变得非常大时,可以得出 $\mathcal{P}_{z} ( z )$ 的一个渐近精确形式。在论证这个基本方面(即中心极限定理 Central Limit Theorem)之前,我们想讨论一些关于随机变量之和的均值与方差的相关问题。鉴于均值和方差都与 $N$ 成正比,通常考虑独立同分布随机变量的平均值会很有用:
$$ \overline{{x}} = \frac{1} {N} \sum_{i} x_{i} .\tag{2.55} $$尽管在一般情况下,很难求出 $\overline{{x}}$ 概率分布的显式形式,但 $\overline{{x}}$ 的均值和方差却很容易计算。实际上,求和中的所有 $N$ 项贡献相同,都等于 $\langle x \rangle$ ,因此得到:
$$ \langle{\overline{{x}}} \rangle = \langle x \rangle ,\tag{2.56} $$也就是说,平均值 $\overline{{x}}$ 的均值等于单次试验的均值。我们想强调,方程(2.56)在随机变量 $x_{i}$ 并非独立的情况下也成立。为了计算 $\overline{{x}}$ 的方差,我们注意到,通过取 $\overline{{x}}^{2}$ 的期望值,可以得到:
$$ \begin{array} {c l c r} {{\displaystyle{\langle \overline{{{x}}}^{2} \rangle = \frac{1} {N^{2}} \sum_{i , j} \langle x_{i} x_{j} \rangle = \frac{1} {N^{2}} \left[ \sum_{i} \langle x_{i}^{2} \rangle + \sum_{i \neq j} \langle x_{i} \rangle \langle x_{j} \rangle \right]}}} \\ {{\displaystyle{= \frac{1} {N^{2}} \left[ N \langle x^{2} \rangle + N ( N - 1 ) \langle x \rangle^{2} \right] ,}}} \end{array}\tag{2.57} $$其中我们利用了变量相互独立的性质,因此对于 $i \neq j$ 有 $\langle x_{i} x_{j} \rangle =$ $\left. x_{i} \right. \left. x_{j} \right.$;那么 $\langle \overline{{x}}^{2} \rangle$ 包含两项贡献:第一项来自 $i = j$ 的项,给出 N 个与 i 无关的项(即 $\langle x_{i}^{2} \rangle = \langle x^{2} \rangle$);第二项来自 $i \neq j$ 的项,给出 $N ( N - 1 )$ 个都相等的项(即 $\langle x_{i} \rangle \langle x_{j} \rangle = \langle x \rangle^{2}$)。因此,x 的方差为:
$$ \sigma_{\overline{{x}}}^{2} = \langle \overline{{x}}^{2} \rangle - \langle \overline{{x}} \rangle^{2} = \frac{\sigma^{2}} {N} ,\tag{2.58} $$其中 $\sigma^{2} = \langle x^{2} \rangle - \langle x \rangle^{2}$ 是单个随机变量 x 的方差。因此,对于大 N 而言,对应于同一实验大量重复取平均的随机变量 x 将具有非常窄的分布函数,因为当 $N \to \infty$ 时 $\sigma_{\overline{{x}}}^{2} \to 0$,且其均值与原始随机变量相同。换句话说,几乎所有可能的平均测量值(每次测量由同一实验的 N 次不同实现构成)给出的 x 值都比单次实验更接近真实均值。这一重要事实可通过将式 (2.45) 的切比雪夫不等式(Chebyshev's inequality)应用于变量 x 而更严格地获得:
$$ P \left( \left| \frac{1} {N} \sum_{i} x_{i} - \langle x \rangle \right| > \epsilon \right) \leq \frac{\sigma_{\bar{x}}^{2}} {\epsilon^{2}} = \frac{\sigma^{2}} {N \epsilon^{2}} ,\tag{2.59} $$这直接给出:
$$ \operatorname*{lim}_{N \to \infty} P \left( \left| \frac{1} {N} \sum_{i} x_{i} - \langle{x} \rangle \right| > \epsilon \right) = 0 .\tag{2.60} $$这一结果正是所谓的弱大数定律(weak law of large numbers),它本质上指出:对于任意非零容限 $\epsilon$,只要 N 足够大,平均值 x 以非常高的概率接近期望值,即落在容限范围内。
式 (2.56) 和 (2.58) 表明,多个独立随机变量的平均给出了真实期望值的无偏且非常精确的估计。由于分布的确切方差 $\sigma^{2}$ 通常未知,因此定义其估计量是有用的,这使我们能够估计式 (2.58) 中的 $\sigma_{\overline{{x}}}^{2}$。为此,我们可以考虑:
$$ s^{2} = \frac{1} {N} \sum_{i} {( x_{i} - \bar{x} )^{2}} = \frac{1} {N} \sum_{i} {x_{i}^{2}} - \left( \frac{1} {N} \sum_{i} {x_{i}} \right)^{2} ,\tag{2.61} $$它也是一个随机变量,且满足:
$$ \langle s^{2} \rangle = \frac{1} {N} \sum_{i} \langle x_{i}^{2} \rangle - \frac{1} {N^{2}} \sum_{i , j} \langle x_{i} x_{j} \rangle ,\tag{2.62} $$当变量 $x_{i}$ 独立同分布时,我们得到:
$$ \langle s^{2} \rangle = \left( 1 - \frac{1} {N} \right) \left( \langle x^{2} \rangle - \langle x \rangle^{2} \right) = \left( \frac{N - 1} {N} \right) \sigma^{2} .\tag{2.63} $$因此,对于 $N \to \infty$,$s^{2}$ 对方差给出了渐近精确的估计。注意,对于任何有限的 $N$ 值,通过取 $N / ( N - 1 ) s^{2}$ 而非 $s^{2}$,可以得到对方差略微更好的估计。
最后,假设随机变量 $x_{i}$ 恰好是给定事件 $E_{j}$ 的特征随机变量,即 $x_{i} \equiv X_{i}^{[ j ]}$。对于这个随机变量,我们已经注意到其均值是事件 $E_{j}$ 的概率,即 $\langle X_{i}^{[ j ]} \rangle \ : = \ : P ( j )$。此外,根据之前的讨论,通过对同一实验的 $N$ 次独立实现取平均得到的随机变量 ${\overline{{x}}}$ 的均值,给出了 $P ( j )$ 的一个估计,其标准差随 $1 / \sqrt{N}$ 递减,参见式 (2.58)。通过增大 $N$,这种不确定度可以任意缩小,因此在 $N \to \infty$ 的极限下,事件 $E_{j}$ 的概率 $P ( j )$ 是一个定义良好的量。这一事实一致地证明了式 (2.1) 定义的合理性,该式是频率主义(frequentist)概率方法的基础。注意,在此框架内,概率的概念与实验的可重复性相关。
2.7 中心极限定理(Central Limit Theorem)#
最后,我们来证明概率论中一个非常重要的定理——所谓的中心极限定理,它给出了大量独立同分布(概率分布为 $\mathcal{P} ( x )$)随机变量 $x_{i}$ 之和的渐近概率分布。该定理的重要性在于,它表明分布函数的渐近形式在非常一般的条件下成立,即无论 ${\mathcal{P}} ( x )$ 的具体形式如何。唯一的要求是方差有限。第一步,我们定义 $y_{i} = x_{i} - \langle{x} \rangle$,它们仍然是独立同分布的随机变量,且根据定义有 $\langle y_{i} \rangle = 0$。然后,我们构造随机变量 $Y \colon$
$$ Y = \frac{1} {\sqrt{N}} \sum_{i} y_{i} = \sqrt{N} ( \overline{{x}} - \langle x \rangle ) ,\tag{2.64} $$该变量的期望值也为零:
$$ \left. Y \right. = 0 .\tag{2.65} $$$Y$ 的特征函数(characteristic function)由下式给出:
$$ \phi_{Y} ( t ) = \left. \exp \left( \frac{it} {\sqrt{N}} \sum_{i} y_{i} \right) \right. = \left. \prod_{i} \exp \left( \frac{it} {\sqrt{N}} y_{i} \right) \right. = \left[ \phi_{y} \left( \frac{t} {\sqrt{N}} \right) \right]^{N} ,\tag{2.66} $$这里我们利用了所有 $y_{i}$ 独立同分布的事实,因此所有项贡献相同的因子。对于较小的 $t$ 值,我们可以利用式 (2.31)(其中 $\mu = 0$)将 $\phi_{y} ( \frac{t} {\sqrt{N}} )$ 展开到二阶:
$$ \phi_{Y} ( t ) = \left[ 1 - \frac{\sigma^{2} t^{2}} {2 N} + o \left( \frac{t^{2}} {N} \right) \right]^{N} .\tag{2.67} $$当考虑随机变量数量非常大时的极限时,我们得到:
$$ \operatorname * {lim}_{N \to \infty} \phi_{Y} ( t ) = \exp \left( - \frac{\sigma^{2}} {2} t^{2} \right) ,\tag{2.68} $$这正是均值为 $\mu = 0$、方差为 $\sigma^{2}$ 的高斯随机变量(Gaussian random variable)的特征函数:
$$ \mathcal{P} ( Y ) = \frac{1} {\sqrt{2 \pi \sigma^{2}}} \exp \left( - \frac{Y^{2}} {2 \sigma^{2}} \right) .\tag{2.69} $$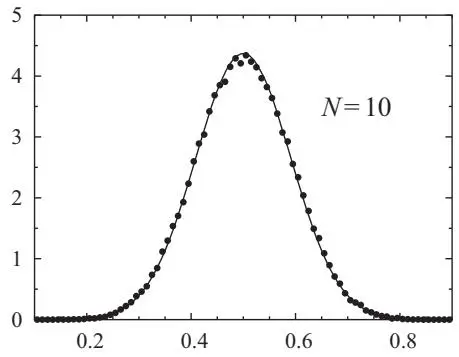
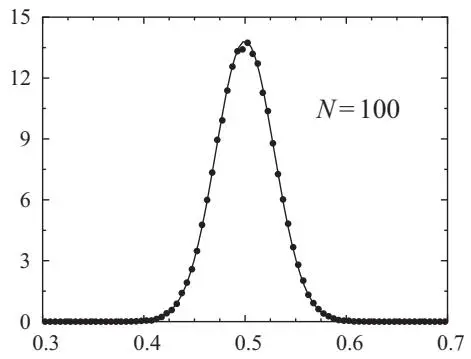
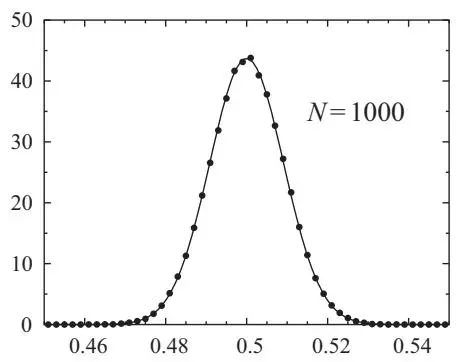
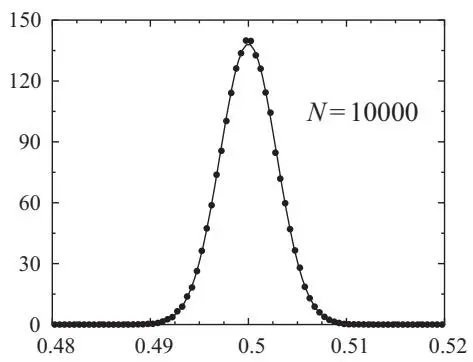
图2.1 对于不同的 $N$ 值,$\bar{x} = 1 / N \textstyle \sum_{i} x_{i}$ 的概率分布,基于 $10^{5}$ 次 ${\overline{{x}}}$ 的实现生成。图中也给出了预期的高斯分布,其 $\mu = 0.5$、$\sigma^{2} = 1 / ( 12 N )$。
利用第2.4节的结果,我们还可以得到 $\overline{{x}} = \left. {x} \right. + Y / \sqrt{N}$ 是一个高斯变量,其均值等于 $\langle x \rangle$,方差等于 $\sigma^{2} / N$:
$$ \mathcal{P} ( \overline{{x}} ) = \sqrt{\frac{N} {2 \pi \sigma^{2}}} \exp \left[ - \frac{N ( \overline{{x}} - \langle x \rangle )^{2}} {2 \sigma^{2}} \right] .\tag{2.70} $$在图2.1中,我们展示了一些例子,其中生成了 $10^{5}$ 个式(2.55)的平均值 $\overline{x}$,这些平均值是通过对N个在[0,1)上均匀分布的随机变量求和得到的。特别地,我们将区间 $[0, 1)$ 划分为L个宽度为 $1/L$ 的小子区间,并计算 $\overline{x}$ 落入给定区间的次数(归一化到总试验次数)。随着N增大,这个量非常迅速地趋近于高斯分布(具有预期的均值和方差),正如中心极限定理(central limit theorem)所预测的那样:当 $N = 10$ 时,该分布与高斯分布基本无法区分。
中心极限定理的重要性在于,原始分布函数 $\mathcal{P}(x)$ 的细节(例如,所有 $n > 2$ 的矩)对平均值的渐近分布函数 $\overline{x}$ 的形式没有贡献,因此该形式是普适的(universal)。最重要的是,对多个随机变量求和会产生一个随机变量,该变量具有与原始变量相同的均值,但其方差要小得多,并且在 $N \to \infty$ 时趋于零。换句话说,随着N的增加,随机变量 $\overline{x}$ 的波动越来越小,最终在 $N \to \infty$ 时变成一个确定性的数。因此,通过对多个随机变量求和来估计均值,远比考虑单个随机变量要精确得多。正如我们将在下一章讨论的那样,中心极限定理是任何蒙特卡洛(Monte Carlo)数值积分方法的核心。
我们强调,式(2.70)的高斯形式在使用时需要谨慎。事实上,式(2.70)仅在其最大值附近成立,即对于 $( \overline{x} - \langle x \rangle ) = O ( \sigma / \sqrt{N} )$ 成立,而在分布的尾部不成立,尾部通常会出现大偏差(large deviations)。中心极限定理的一个扩展由所谓的大偏差理论(large deviations theory)给出,该理论不仅提供了关于小偏差(即 $O ( 1 / \sqrt{N} )$)的信息,还提供了关于远离典型值的罕见事件的信息。
我们希望通过考虑中心极限定理的一个应用来结束这部分内容。我们不取N个随机变量的平均值,而是考虑它们的乘积:
$$ z = \prod_{i = 1}^{N} x_{i} .\tag{2.71} $$$z$ 的平均值和方差都可以在大N极限下推导出来。事实上:
$$ \xi = \ln z = \sum_{i = 1}^{N} \ln x_{i}\tag{2.72} $$是N个随机变量的和,因此当 $N \to \infty$ 时具有高斯分布:
$$ \mathcal{P} ( \xi ) = \sqrt{\frac{1} {2 \pi N \sigma^{2}}} \exp \left[ - \frac{( \xi - \langle \xi \rangle )^{2}} {2 N \sigma^{2}} \right] ,\tag{2.73} $$其中 $\langle \xi \rangle = N \langle \ln x \rangle$ 且 $\sigma^{2} = \langle ( \ln x )^{2} \rangle - \langle \ln x \rangle^{2}$ 。因此,我们得到:
$$ \langle z \rangle = \langle e^{\xi} \rangle \propto \exp \left( \langle \xi \rangle + \frac{N} {2} \sigma^{2} \right) ,\tag{2.74} $$$$ \begin{array} {r} {\langle z^{2} \rangle = \langle e^{2 \xi} \rangle \propto \exp \left( 2 \langle \xi \rangle + 2 N \sigma^{2} \right) ,} \end{array}\tag{2.75} $$这意味着当 $N \to \infty$ 时
$$ \frac{\sqrt{\langle z^{2} \rangle - \langle z \rangle^{2}}} {\langle z \rangle} \approx \exp ( \frac{N} {2} \sigma^{2} ) \to \infty .\tag{2.76} $$因此,与随机变量的和相反,随机变量的积的方差发散速度远快于其期望值。