高性能计算智能与预测技术#
Kesheng Wu 与 Horst D. Simon
22.1 动机#
本章介绍劳伦斯伯克利国家实验室(LBNL)的「计算智能与预测技术」(Computational Intelligence and Forecasting Technologies,CIFT)项目。CIFT 的主要目标是推动高性能计算(HPC)工具和技术在流数据分析中的应用。在注意到 SEC 与 CFTC 将数据量作为延迟五个月才发布 2010 年闪电崩盘(Flash Crash)调查报告的原因之后,LBNL 启动了 CIFT 项目,旨在将 HPC 技术应用于金融数据的管理与分析。对流数据做出及时决策是许多商业应用的需求,例如避免电网即将发生的故障或金融市场中的流动性危机。在所有这些情形中,HPC 工具都非常适合处理复杂的数据依赖关系并提供及时的解决方案。多年来,CIFT 致力于研究多种不同形式的流数据,包括来自道路交通、电网、用电量等方面的数据。以下各节解释 HPC 系统的关键特征,介绍这些系统上使用的若干专用工具,并给出使用这些 HPC 工具进行流数据分析的实例。
22.2 对 2010 年闪电崩盘的监管响应#
2010 年 5 月 6 日约下午 2:45(美国东部夏令时),美国股市的道琼斯工业平均指数经历了近 10% 的暴跌,但几分钟后又收复了大部分跌幅。监管机构花了大约五个月才拿出一份调查报告。在调查该崩盘的国会小组面前,数据量(约 20 TB)被列为长期延迟的主要原因。由于诸如国家能源研究科学计算(NERSC)中心1等 HPC 系统通常在数分钟内就能处理数百 TB 的数据,我们处理来自金融市场的数据应当毫无问题。这促成了 CIFT 项目的建立,其使命是将 HPC 技术与工具应用于金融数据分析。
金融大数据的一个关键特征是它主要由时间序列构成。多年来,CIFT 团队与众多合作者一起开发了分析多种不同形式的数据流和时间序列的技术。本章简要介绍 HPC 系统,包括硬件(22.4 节)和软件(22.5 节),并回顾几个成功的用例(22.6 节)。最后我们总结迄今为止的愿景与工作,并提供给有兴趣的读者联系方式。
22.3 背景#
计算技术的进步使得寻找复杂模式变得容易得多。这种模式发现能力背后是一系列近期的科学突破,例如希格斯玻色子的发现(Aad 等 [2016])和引力波的发现(Abbott 等 [2016])。同样的能力也是许多互联网公司的核心,例如将用户与广告商进行匹配(Zeff 和 Aronson [1999],Yen 等 [2009])。然而,科学与商业中所使用的硬件和软件迥然不同。HPC 工具具有一些关键优势,在多种商业应用中应当是有用的。
为科学家设计的工具通常围绕高性能计算(HPC)平台构建,而为商业应用设计的工具则围绕云计算平台构建。就筛选大量数据以发现有用模式而言,两种方法都被证明行之有效。然而,HPC 系统的招牌应用是大规模模拟,例如用于预报未来几天区域风暴的天气模型(Asanovic 等 [2006])。相比之下,商业云最初是由并发处理大量独立数据对象(数据并行任务)的需求所驱动的。
在我们的工作中,我们主要关注流数据分析,特别是来自监测国家电网和公路系统的传感器网络的高速复杂数据流。这种流式工作负载对 HPC 系统和云系统而言都不是理想选择,下面将予以讨论,但我们认为 HPC 生态系统在应对流数据分析方面比云生态系统能提供更多。
云系统最初是为并行数据任务设计的,在这种任务中可以并发处理大量独立的数据对象。因此系统是为高吞吐量而非实时响应而设计的。然而,许多商业应用需要实时或近实时的响应。例如,电网中的不稳定事件可能在数分钟内发展并演变成灾难;足够快地发现其标志性特征就能避免灾难。类似地,金融研究文献已经识别出新兴流动性事件的迹象;在活跃市场交易时段快速发现这些迹象可以提供防止市场冲击、避免闪电崩盘的选项。在这些情形中,优先考虑快速周转时间的能力至关重要。
数据流按定义是逐步可用的,因此可能没有大量数据对象可供并行处理。通常只有固定数量的最近数据记录可供分析。在这种情况下,利用许多中央处理器(CPU)核心算力的有效方式是将针对单个数据对象(或单个时间步)的分析工作分配到多个 CPU 核心上。HPC 生态系统在此类工作上比云生态系统拥有更先进的工具。
以上是激励我们工作的主要论点。关于 HPC 系统与云系统更深入的比较,我们建议有兴趣的读者参阅 Asanovic 等 [2006]。特别是 Fox 等 [2015] 创建了一套详尽的分类法,用于描述任何应用场景下两者之间的相似性与差异。
简言之,我们相信 HPC 社区在推进流式分析的前沿方面有大量可贡献之处。CIFT 项目正是带着将 LBNL 的 HPC 专长转移到流式商业应用的使命而建立的。我们通过合作、示范和工具开发来推进这一使命。
为评估 HPC 技术的潜在用途,我们花费时间参与了各种应用。这一过程不仅让我们的 HPC 专家接触到多个领域,也使我们有可能筹集资金建立示范设施。
借助这一努力的若干早期支持者的慷慨馈赠,我们建立了一个专用于此项工作的相当规模的计算集群。这台专用计算机(命名为 dirac1)允许用户利用 HPC 系统并亲自评估其应用。
我们还参与了一项工具开发工作,以使 HPC 系统更便于流数据分析使用。在以下各节中,我们将描述专用 CIFT 机器的硬件和软件,以及一些示范和工具开发的努力。亮点包括将数据处理速度提升了 21 倍,并将一个早期预警指标的计算速度提升了 720 倍。
22.4 HPC 硬件#
传说第一代大数据系统是用从大学校园里搜集来的备用计算机组件搭建的。这很可能是个都市传说,但它强调了一个关于 HPC 系统与云系统差异的重要观点。理论上,HPC 系统是用定制的高成本组件构建的,而云系统是用标准的低成本商品组件构建的。实际上,由于全球在 HPC 系统上的投资远小于个人电脑,制造商不可能仅为 HPC 市场生产定制组件。事实是 HPC 系统和云系统一样,很大程度上也是由商品组件组装而成的。然而,由于它们针对的应用不同,组件的选择存在一些差异。
让我们依次描述计算元素、存储系统和网络系统。图 22.1 是一幅高层示意图,描绘了 2010 年前后 Magellan 集群的关键组件(Jackson 等 [2010];Yelick 等 [2011])。计算元素包括 CPU 和图形处理器(GPU)。这些 CPU 和 GPU 几乎在所有情况下都是商业产品。例如,dirac1 上的节点使用一颗 24 核 2.2GHz 的 Intel 处理器,这在云计算系统中很常见。目前,dirac1 不含 GPU。
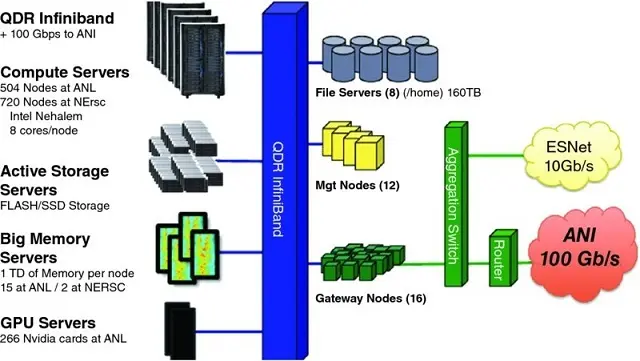
图 22.1 Magellan 集群(约 2010 年)示意图,HPC 计算机集群的一个实例
网络系统由两部分组成:连接集群内部组件的 InfiniBand 网络,以及与外部世界的交换式网络连接。在这个具体示例中,外部连接被标注为「ESNet」和「ANI」。InfiniBand 网络交换机在云计算系统中也很常见。
图 1 中的存储系统同时包含旋转磁盘和闪存存储。这种组合也很常见。不同之处在于,HPC 系统通常将其存储系统集中在计算节点之外,而典型的云计算系统将存储系统分布在计算节点之间。这两种方法各有优劣。例如,集中式存储通常作为全局文件系统输出给所有计算节点,这使得处理存储在文件中的数据更加容易。然而,这需要连接 CPU 和磁盘的高性能网络。相比之下,分布式方法可以使用较低性能的网络,因为每个 CPU 附近都有一些存储。通常,诸如 Google 文件系统(Ghemawat、Gobioff 和 Leung [2003])之类的分布式文件系统会层叠在云计算系统之上,使存储对所有 CPU 可访问。
简言之,当前一代的 HPC 系统和云系统使用的基本上是相同的商业硬件组件。它们的差异主要在于存储系统和网络系统的安排方式。显然,存储系统设计的差异会影响应用性能。然而,云系统的虚拟化层更可能是应用性能差异的更大成因。在下一节中,我们将讨论另一个可能影响更大的因素,即软件工具和库。
虚拟化通常用于云计算环境,以使同一硬件可供多个用户使用,并将一个软件环境与另一个隔离开来。这是云计算环境与 HPC 环境之间最显著的区别之一。在大多数情况下,计算机系统的三个基本组件——CPU、存储和网络——都被虚拟化。这种虚拟化有许多好处。例如,现有应用可以在 CPU 芯片上运行而无需重新编译;许多用户可以共享同一硬件;硬件故障可以通过虚拟化软件加以纠正;失败计算节点上的应用可以更轻松地迁移到另一个节点。然而,这一虚拟化层也带来一些运行时开销,可能降低应用性能。对于时间敏感的应用,这种性能下降可能成为关键问题。
测试表明性能差异可能相当大。接下来,我们简要描述 Jackson 等 [2010] 报告的一项性能研究。图 22.2 显示了使用不同计算机系统时的性能下降。横轴下方的名称是 NERSC 上常用的不同软件包。左边的柱对应商业云,中间的柱对应 Magellan,右边的柱(有时缺失)对应 EC2-Beta-Opt 系统。未优化的商业云实例运行这些软件包比在 NERSC 超级计算机上慢 2 到 10 倍。即使在更昂贵的高性能实例上,也存在明显的减速。
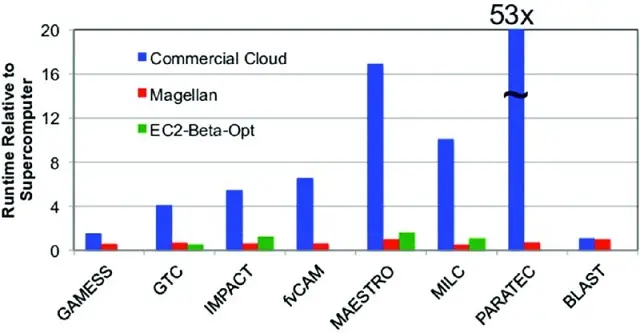
图 22.2 云运行科学应用比 HPC 系统慢得多(约 2010 年)
图 22.3 展示了软件包 PARATEC 导致减速的主要因素研究。在图 2 中,我们看到 PARATEC 在商业云上完成的时间是 HPC 系统的 53 倍。从图 3 中我们观察到,随着核心数(横轴)的增加,所测性能(以 TFLOP/s 计)之间的差异变得更大。特别是,标注为「10G-TCPoEth Vm」的线随着核心数的增长几乎没有上升。这是网络实例使用虚拟化网络(TCP over Ethernet)的情况。它清楚地表明网络虚拟化开销是显著的,甚至到了使云变得无用的地步。
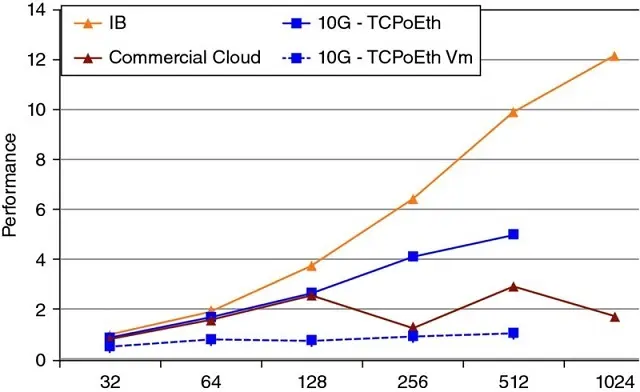
图 22.3 随着核心数增加(横轴),虚拟化开销变得更加显著(约 2010 年)
虚拟化开销的问题已被广泛认识(Chen 等 [2015])。已有大量研究致力于同时解决 I/O 虚拟化开销(Gordon 等 [2012])和网络虚拟化开销(Dong 等 [2012])。随着这些最先进的技术逐步被引入商业产品,我们预计开销未来会降低,但某些开销不可避免地仍将存在。
作为本节的收尾,我们简要触及 HPC 与云的经济学问题。通常,HPC 系统由非营利研究组织和大学运营,而云系统由商业公司提供。利润、客户留存以及许多其他因素都会影响云系统的成本(Armbrust 等 [2010])。2011 年,Magellan 项目报告指出:「成本分析表明,DOE 中心具有成本竞争力,与商业云提供商相比通常便宜 3 到 7 倍」(Yelick 等 [2010])。
一群高能物理学家认为他们的用例非常适合云计算,并对比较研究进行了详细分析(Holzman 等 [2017])。他们的成本比较仍然显示,对于可比的计算任务,商业云产品比专用 HPC 系统大约贵 50%;然而,作者在数据流入和流出方面受到严格限制,以避免可能产生的高昂数据传输费用。对于本书讨论的诸如流数据分析等复杂工作负载,我们预计这种 HPC 成本优势在未来仍将存在。2016 年一项美国国家科学院研究得出了同样的结论:即使是 Amazon 的长期租赁,处理 NSF 预期的科学工作负载也可能比 HPC 系统贵 2 到 3 倍(National Academies of Sciences [2016] 的专栏 6.2)。
22.5 HPC 软件#
讽刺的是,超级计算机的真正威力在于其专用软件。HPC 系统和云系统都有种类繁多的软件包可用。在大多数情况下,同一软件包在两个平台上都可用。因此,我们选择专注于 HPC 系统独有、并具有改进计算智能和预测技术潜力的软件包。
HPC 软件生态系统的一个显著特征是,大量应用软件通过消息传递接口(MPI)自行执行处理器间通信。事实上,大多数科学计算书籍的基石就是 MPI(Kumar 等 [1994],Gropp、Lusk 和 Skjellum [1999])。相应地,我们对 HPC 软件工具的讨论将从 MPI 开始。由于本书依赖于数据处理算法,我们将集中于数据管理工具(Shoshani 和 Rotem [2010])。
22.5.1 消息传递接口#
消息传递接口是一种用于并行计算的通信协议(Gropp、Lusk 和 Skjellum [1999],Snir 等 [1988])。它定义了若干点对点数据交换操作以及一些集合通信操作。MPI 标准是基于构建可移植通信库的若干早期尝试而建立的。来自阿贡国家实验室的早期实现名为 MPICH,具有高性能、可扩展和可移植的特点。这帮助 MPI 在科学用户中获得了广泛接受。
MPI 的成功部分归功于它将语言无关规范(LIS)与语言绑定分离。这使得同一核心函数能提供给许多不同的编程语言,这也促进了它的普及。第一个 MPI 标准规定了 ANSI C 和 Fortran-77 绑定以及 LIS。该规范草案在 1994 年超级计算大会上提交给了用户社区。
促成 MPI 成功的另一个关键因素是 MPICH 采用的开源许可证。该许可证允许厂商获取源代码以生成自己的定制版本,这使得 HPC 系统厂商能够快速生产自己的 MPI 库。时至今日,所有 HPC 系统都支持其计算机上熟悉的 MPI。这种广泛采用也确保了 MPI 将继续是 HPC 系统用户中最受欢迎的通信协议。
22.5.2 分层数据格式 5#
在描述 HPC 硬件组件时,我们注意到 HPC 平台上的存储系统通常与云平台上的不同。相应地,大多数用户用于访问存储系统的软件库也有所不同。这种差异可以追溯到数据概念模型的差异。通常,HPC 应用将数据视为多维数组,因此 HPC 系统上最流行的 I/O 库是为处理多维数组而设计的。这里我们描述使用最广泛的数组格式库 HDF5(Folk 等 [2011])。
HDF5 是 HDF Group 制作的分层格式的第五次迭代2。HDF5 中的基本数据单元是一个数组及其相关信息,如属性、维度和数据类型。它们合在一起被称为一个数据集。数据集可以被分组成更大的单元——组,而组又可以组织成更高层级的组。这种灵活的分层组织允许用户表达数据集之间的复杂关系。
除了用于将用户数据组织成文件的基本库之外,HDF Group 还提供了一套工具以及针对不同应用的 HDF5 专用版本。例如,HDF5 包括一个性能分析工具。NASA 有一个名为 HDF5-EOS 的 HDF5 专用版本,用于来自其地球观测系统(EOS)的数据;而下一代 DNA 测序社区则制作了一个名为 BioHDF 的专用版本,用于其生物信息学数据。
HDF5 为访问 HPC 平台上的存储系统提供了一种高效方式。在测试中,我们已证明使用 HDF5 存储股票市场数据可显著加快分析操作。这主要得益于其高效的压缩/解压算法,能最小化网络流量和 I/O 操作,这也引出我们的下一个观点。
22.5.3 原位处理#
在过去几十年中,CPU 性能大约每 18 个月翻一番(摩尔定律),而磁盘性能每年的增长不到 5%。这种差异导致写出 CPU 内存内容所需的时间越来越长。为解决这个问题,许多研究工作专注于原位(in situ)分析能力(Ayachit 等 [2016])。
在当前一代的处理系统中,可适配 I/O 系统(Adaptable I/O System,ADIOS)是使用最广泛的(Liu 等 [2014])。它采用多种数据传输引擎,允许用户接入 I/O 流并执行分析操作。这很有用,因为无关数据可以在传输过程中被丢弃,从而避免缓慢且庞大的存储。这种原位机制也使其能够非常快速地完成写操作。事实上,它最初因其写入速度而引人注目。此后,ADIOS 开发者与多个非常庞大的团队合作,以改进他们的 I/O 管线和分析能力。
由于 ADIOS 支持流式数据访问,它也与 CIFT 工作高度相关。在多次示范中,配备 ICEE 传输引擎的 ADIOS 能够实时完成分布式流数据分析(Choi 等 [2013])。我们将在下一节描述一个涉及聚变等离子体中「团块」的用例。
总而言之,原位数据处理能力是 HPC 生态系统中另一个非常有用的工具。
22.5.4 融合#
我们前面提到,HPC 硬件市场只是整个计算机硬件市场的一小部分。与整个软件市场相比,HPC 软件市场甚至更小。到目前为止,HPC 软件生态系统主要由若干小型厂商和一些开源贡献者维护。因此,HPC 系统用户面临着迁移到支持更好的云软件系统的巨大压力。这是推动 HPC 软件与云软件融合的重要驱动力(Fox 等 [2015])。
尽管融合似乎不可避免,我们倡导一种保留上述软件工具优势的融合选项。CIFT 项目的动机之一就是寻找一种将这些工具转移到未来计算环境的方法。
22.6 用例#
数据处理是现代科学研究如此重要的一部分,以至于一些研究者将其称为科学的第四范式(Hey、Tansley 和 Tolle [2009])。在经济学中,同样的数据驱动研究活动催生了广受欢迎的行为经济学(Camerer 和 Loewenstein [2011])。近期数据驱动研究的许多进展都基于机器学习应用(Qiu 等 [2016],Rudin 和 Wagstaff [2014])。它们在行星科学和生物信息学等各种领域的成功,引起了来自不同领域研究者的浓厚兴趣。在本节其余部分,我们描述几个将高级数据分析技术应用于不同领域的示例,其中许多用例起源于 CIFT 项目。
22.6.1 超新星搜寻#
在天文学中,诸如宇宙膨胀速度等许多重要事实的确定,是通过测量爆炸的 Ia 型超新星的光来完成的(Bloom 等 [2012])。在夜空中搜寻爆炸超新星的过程被称为天体成像巡天。Palomar 瞬变源工厂(PTF)就是这种巡天的一个例子(Nicholas 等 [2009])。PTF 望远镜扫描夜空,每 45 分钟产生一组图像。新图像与同一片天空之前的观测进行对比,以确定发生了什么变化并对变化进行分类。这类识别和分类任务过去由天文学家手工完成。然而,目前 PTF 望远镜传入的图像数量已经大到无法人工检查。一个用于这些图像处理任务的自动化工作流已被开发并部署在多个不同的计算机中心。
图 22.4 显示了在其爆炸过程中最早被识别出的超新星。2011 年 8 月 23 日,一片天空没有显示这颗恒星的任何迹象,但 8 月 24 日出现了一丝微光。这种快速更替使世界各地的天文学家得以进行详细的后续观测,这对于确定与宇宙膨胀相关的参数非常重要。
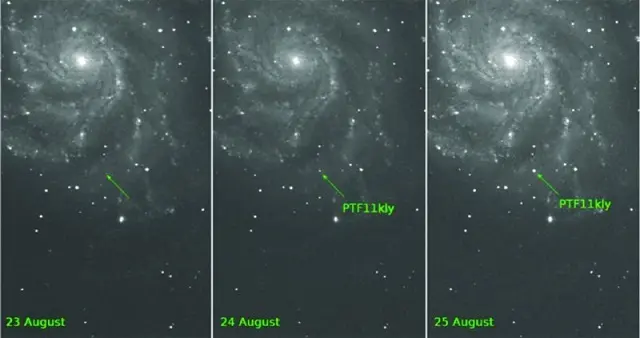
图 22.4 超新星 SN 2011fe 在爆炸首次出现证据后 11 小时即被发现,这得益于对天文观测进行分类的广泛自动化
对这颗超新星的快速识别是自动化工作流机器学习能力的一次重要示范。该工作流处理传入的图像,以提取自上次观测以来发生变化的物体。然后对变化物体进行分类,基于之前的训练确定一个初步类型。由于从快速变化的瞬变源中提取新科学的后续资源十分珍贵,分类不仅需要指出所假定的类型,还要给出分类的似然和置信度。使用在 PTF 数据上训练的分类算法,瞬变源和变星的误标率总体为 3.8%。预计额外的工作将在即将到来的巡天(如大型综合巡天望远镜)中实现更高的准确率。
22.6.2 聚变等离子体中的团块#
物理和气候学等领域的大规模科学探索是涉及各数千名科学家的庞大国际合作。随着这些合作以越来越快的速度产生越来越多的数据,现有的工作流管理系统难以跟上步伐。一个必要的解决方案是在数据到达相对较慢的磁盘存储系统之前对其进行处理、分析、总结和缩减,这一过程被称为中转处理(或飞行中分析)。我们与 ADIOS 开发者合作,实现了 ICEE 传输引擎,以大幅提升协作工作流系统的数据处理能力(Choi 等 [2013])。这一新功能显著改善了分布式工作流的数据流管理。测试表明,ICEE 引擎使若干大型国际合作能够做出近实时的协作决策。这里我们简要描述涉及 KSTAR 的聚变合作。
KSTAR 是一座配备全超导磁体的核聚变反应堆。它位于韩国,但世界各地有许多相关的研究团队。在一次聚变实验的运行期间,一些研究人员在 KSTAR 控制物理装置,而其他人则可能希望通过对该实验先前运行的协作分析来参与,为下一次运行应如何配置装置提供建议。在对实验测量数据进行分析期间,科学家可能会运行模拟或检查以前的模拟来研究参数选择。通常,两次连续运行之间可能有 10 到 30 分钟的间隔,所有协作分析都需要在此时间窗口内完成才能影响下一次运行。
我们用两种不同类型的数据展示了 ICEE 工作流系统的功能:一种是 KSTAR 测量的电子回旋辐射成像(ECEI)数据,另一种是涉及 XGC 建模的合成诊断数据。分布式工作流引擎需要从这两个来源收集数据,提取被称为「团块」(blobs)的特征,跟踪这些团块的运动,预测实验测量中团块的运动,然后就要执行的操作提供建议。图 22.5 显示了 ECEI 数据的处理方式。XGC 模拟数据的工作流与图 22.5 所示的类似,区别在于 XGC 数据位于 NERSC。
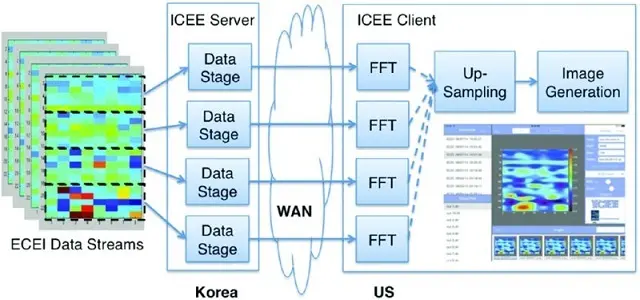
图 22.5 用于研究聚变等离子体动力学的分布式工作流
为了能够实时完成上述分析任务,使用 ADIOS 的 ICEE 传输引擎进行有效的数据管理只是故事的一部分。第二部分是高效地检测团块(Wu 等 [2016])。在这项工作中,我们通过只选择必要的块来减少跨广域网传输的数据量。然后我们识别团块内的所有单元,并将这些单元分组为空间上的连通区域,每个连通区域形成一个团块。我们开发的新算法充分利用 MPI 在节点之间进行通信,并利用同一节点上 CPU 核心之间的共享内存,将工作分配到不同的 CPU 核心上。此外,我们还更新了连通分量标记算法,以正确识别边缘处的团块——这些团块常常被早期的检测算法遗漏。总体而言,我们的算法通过充分利用 HPC 系统中可用的并行性,能够在每个时间步的几毫秒内识别出团块。
22.6.3 日内峰值用电量#
公用事业公司正在部署高级计量基础设施(AMI),以前所未有的空间和时间粒度捕获电力消耗。这一庞大且快速增长的数据流为基于大数据分析平台的预测能力提供了重要的试验场(Kim 等 [2015])。这些前沿的数据科学技术与行为理论相结合,使行为分析能够对用电模式及其潜在驱动因素获得新颖的洞见(Todd 等 [2014])。
由于电力不易存储,其发电必须与消耗相匹配。当需求超过发电能力时就会发生停电,这通常发生在消费者最需要电力的时候。由于增加发电能力既昂贵又需要数年时间,监管机构和公用事业公司设计了多种定价方案,旨在抑制高峰需求期间的非必要消耗。
为了衡量定价政策对峰值需求的有效性,可以分析 AMI 生成的用电数据。我们的工作专注于为行为分析研究提取家庭用电量的基线模型。理想的基线模型应能捕捉家庭用电模式的所有特征,但不包括新的定价方案。建立这样的模型面临诸多挑战。例如,有许多特征可能影响用电量,但没有相关信息被记录,例如空调的温度设定点或购买新电器。其他特征(如户外温度)是已知的,但其影响难以用简单函数捕捉。
我们的工作开发了若干能够满足上述要求的新基线模型。目前,黄金标准基线是一个精心设计的随机对照组。我们证明了新的数据驱动基线能够准确预测对照组的平均用电量。在此评估中,我们使用了一项来自美国某地区精心设计的研究,该地区 5 月至 8 月期间下午和傍晚的用电量最高。虽然这项工作集中于证明新基线模型对群体有效,但我们相信这些新模型在未来对研究单个家庭也是有用的。
我们探索了若干标准的黑盒方法。在机器学习方法中,我们发现梯度树提升(GTB)比其他方法更有效。然而,最准确的 GTB 模型需要滞后变量作为特征(例如一天前和一周前的用电量)。在我们的工作中,我们需要用 T-1 年的数据来建立 T 年和 T+1 年的基线用电量。一天前和一周前的滞后变量会纳入不在 T-1 年中的最近信息。我们尝试修改预测过程,用最近的预测值替代一天前和一周前的实际测量值;然而,我们的测试表明预测误差会随时间累积,导致在夏季大约一个月后的预测不切实际。这种预测误差的累积对于时间序列的连续预测过程是常见的。
为了解决上述问题,我们设计了若干白盒方法,其中最有效的被称为 LTAP,这里予以报告。LTAP 基于这样一个事实:每日的总可变用电量可以用日平均温度的分段线性函数准确描述。这一事实使我们能够预测每日的总用电量。通过进一步假设每个家庭的用电模式在研究期间保持不变,我们能够从每日总用电量中分配各小时的用电值。这种方法被证明是自洽的;即预测过程可以精确重现 T-1 年的用电量,而且对 T 年和 T+1 年对照组的预测都非常接近实际测量值。两个处理组都在高峰需求时段减少了用电量,且主动组的减幅大于被动组。这一观察与其他研究相符。
尽管新的数据驱动基线模型 LTAP 能准确预测对照组的平均用电量,但在预测旨在减少高峰需求时段用电量的新分时定价的影响方面存在一些差异(见图 22.6)。例如,以对照组为基线,主动组在实施新价格的第一年于高峰需求时段平均减少用电 0.277 kWh(约 2 kWh 中的),第二年减少 0.198 kWh。而以 LTAP 为基线,两年的平均减少量都只有 0.164 kWh。部分差异可能源于处理组(尤其是主动组)的自选择偏差——在这些组中,家庭必须明确选择加入才能参与试验。加入主动组的家庭很可能非常适合利用所提议的新定价结构。我们相信 LTAP 基线是解决自选择偏差的一种方法,并计划进行额外的研究来进一步验证这一点。
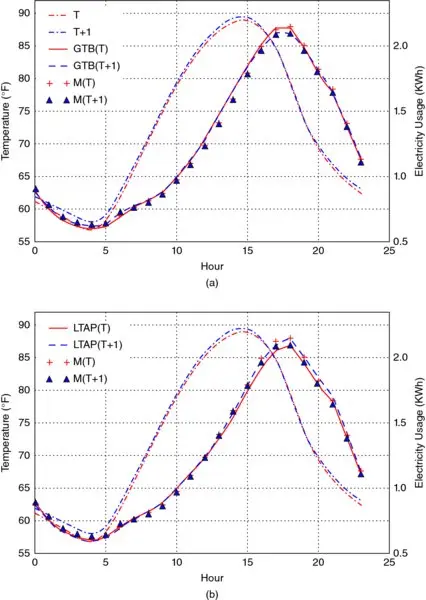
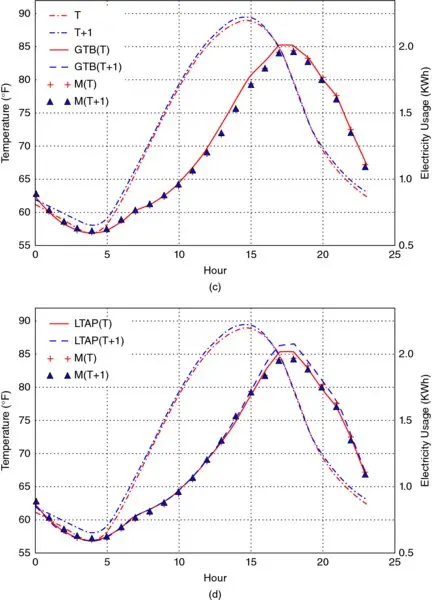
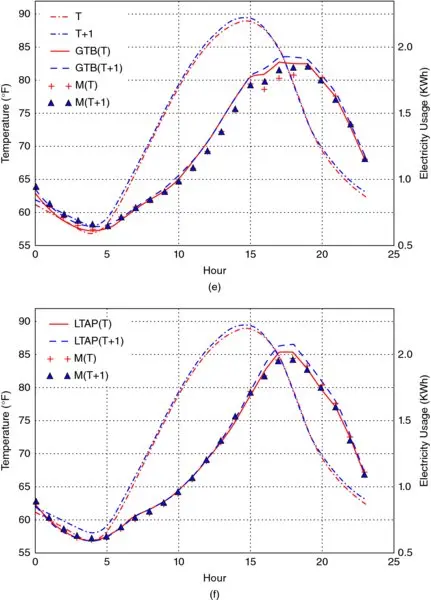
图 22.6 梯度树提升(GTB)似乎过于追随近期用电量,因此在预测基线用电量方面不如新开发的方法 LTAP。(a) 对照组上的 GTB。(b) 对照组上的 LTAP。(c) 被动组上的 GTB。(d) 被动组上的 LTAP。(e) 主动组上的 GTB。(f) 主动组上的 LTAP
22.6.4 2010 年闪电崩盘#
SEC 与 CFTC 调查 2010 年闪电崩盘所花费的漫长时间是 CIFT 工作的最初动机。联邦调查人员需要在数十 TB 的数据中筛选,以寻找崩盘的根本原因。由于 CFTC 公开将数据量归咎为长期延迟的根源,我们从寻找能够轻松处理数十 TB 数据的 HPC 工具开始。由于 HDF5 是最常用的 I/O 库,我们从应用 HDF5 组织大量股票交易数据开始(Bethel 等 [2011])。
让我们快速回顾 2010 年闪电崩盘期间发生了什么。5 月 6 日约下午 2:45(美国东部夏令时),道琼斯工业平均指数下跌了近 10%,许多股票以每股 1 美分的价格成交——这是任何可能交易的最低价格。图 22.7 显示了另一个极端情况的示例:苹果公司(代码 AAPL)的股票以每股 100,000 美元成交——这是交易所允许的最高可能价格。显然,这些都是异常事件,动摇了投资者对我们金融市场的信心和信任。投资者要求知道是什么导致了这些事件。
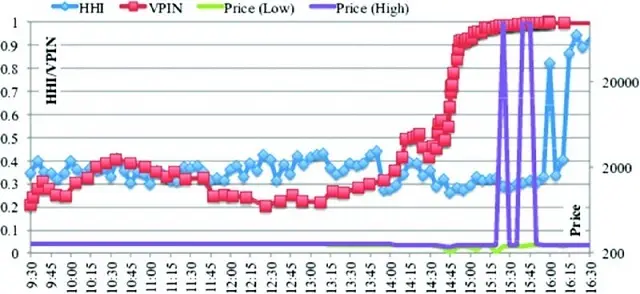
图 22.7 2010 年 5 月 6 日苹果股票价格,以及在交易时段每 5 分钟计算的 HHI 和 VPIN 值
为了使我们的工作与金融业相关,我们着手试验 HDF5 软件,并将其应用于计算早期预警指标这一具体任务。根据一组机构投资者、监管者和学者的建议,我们实现了两套已被证明在闪电崩盘之前具有「早期预警」性质的指标。它们是成交量同步知情交易概率(Volume Synchronized Probability of Informed Trading,VPIN)(Easley、Lopez de Prado 和 O'Hara [2011])和市场碎片化的赫芬达尔-赫希曼指数(HHI)的一个变体(Hirschman [1980])。我们用 C++ 语言实现了这两个算法,同时使用 MPI 进行处理器间通信,以充分利用 HPC 系统。这一选择的理由是:如果这些早期预警指标中任何一个被证明是成功的,高性能实现将使我们能够尽早提取预警信号,从而可能有时间采取纠正措施。我们的努力是证明可以足够快地计算出早期预警信号的第一步。
在我们的工作中,我们实现了程序的两个版本:一个使用组织在 HDF5 文件中的数据,另一个从常用的 ASCII 文本文件中读取数据。图 22.8 显示了处理 S&P 500 所有股票 10 年交易记录所需的时间。由于 10 年交易数据的规模仍然相对较小,我们还将数据复制了 10 次。在单个 CPU 核心上(图 22.8 中标注为「Serial」),使用 ASCII 数据大约需要 3.5 小时,而使用 HDF5 文件只需 603.98 秒。当使用 512 个 CPU 核心时,使用 HDF5 文件该时间降至 2.58 秒,实现了 234 倍的加速。
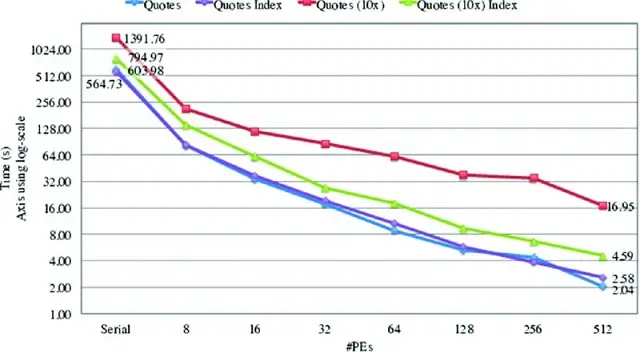
图 22.8 处理存储在 HDF5 文件中的 10 年 S&P 500 报价数据所需的时间——同样的数据以 ASCII 文件存储时要长 21 倍(603.98 秒对约 3.5 小时)
在更大的(复制的)数据集上,HPC 代码计算这些指数的优势更加明显。数据量为 10 倍时,计算机完成任务只需约 2.3 倍的时间——这是一种低于线性的延迟增长。使用更多 CPU 使 HPC 更加可扩展。
图 22.8 还表明,对于大数据集,我们可以进一步利用 HDF5 中可用的索引技术来减少数据访问时间(进而减少总计算时间)。当使用 512 个 CPU 核心时,总运行时间从 16.95 秒降至 4.59 秒,由于这种 HPC 索引技术获得了 3.7 倍的加速。
22.6.5 成交量同步知情交易概率校准#
理解金融市场的波动性需要处理海量数据。我们将数据密集型科学应用中的技术应用于此任务,并通过在一个大规模期货合约集合上计算一个名为成交量同步知情交易概率(VPIN)的早期预警指标来展示其有效性。测试数据包含一百种最活跃交易的期货合约的 67 个月交易数据。平均而言,处理一个合约 67 个月的数据大约需要 1.5 秒。在我们拥有这个 HPC 实现之前,完成同一任务大约需要 18 分钟。我们的 HPC 实现实现了 720 倍的加速。
请注意,上述加速完全基于算法改进获得,并未得益于并行化。HPC 代码可以使用 MPI 在并行机器上运行,从而能够进一步减少计算时间。
我们工作中采用的软件技术包括上述通过 HDF5 实现的更快 I/O 访问,以及用于存储计算 VPIN 所需的柱和桶的更精简的数据结构。更详细的信息可参见 Wu 等 [2013]。
拥有更快的 VPIN 计算程序后,我们还能够更细致地探索参数选择。例如,我们能够识别出将一百多个合约上 VPIN 的误报率从 20% 降至仅 7% 的参数值,见图 22.9。实现这一性能的参数选择是:(1) 用交易的中位数价格(而非分析中通常使用的收盘价)对成交量柱定价;(2) 每天 200 个桶;(3) 每个桶 30 根柱;(4) 计算 VPIN 的支撑窗口 = 1 天,事件持续期 = 0.1 天;(5) 使用 ν = 0.1 的学生 t 分布的批量成交量分类;(6) VPIN 的 CDF 阈值 = 0.99。同样,这些参数是在全部期货合约上提供低误报率,而非个别拟合的结果。
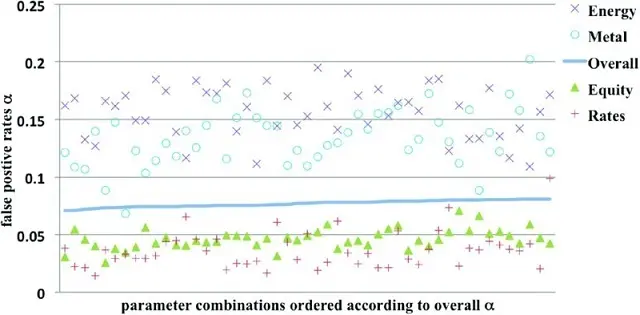
图 22.9 不同类别期货合约的平均误报率(α),按其平均值排序
在不同类别的期货合约上,可以选择不同的参数来实现更低的误报率。在某些情况下,误报率可以显著低于 1%。根据图 22.9,利率和指数期货合约通常具有较低的误报率。而能源和金属等大宗商品期货合约通常具有较高的误报率。
此外,更快的 VPIN 计算程序使我们能够验证 VPIN 所识别的事件是「内在的」——即改变诸如 VPIN 的 CDF 阈值等参数只会略微改变检测到的事件数量。如果事件是随机的,将此阈值从 0.9 改为 0.99 将使检测到的事件数量减少 10 倍。简言之,更快的 VPIN 程序也使我们能够确认 VPIN 的实时有效性。
22.6.6 用非均匀快速傅里叶变换揭示高频事件#
高频交易在所有电子金融市场中无处不在。随着算法取代先前由人类执行的任务,类似于 2010 年闪电崩盘的级联效应可能变得更加可能。在我们的工作(Song 等 [2014])中,我们汇集了多种高性能信号处理工具来增进对这些交易活动的理解。作为说明,我们总结了天然气期货交易价格的傅里叶分析。
通常,傅里叶分析应用于均匀间隔的数据。由于市场活动是爆发式的,我们可能希望按照某个交易活动指标对金融时间序列进行采样。例如,VPIN 按成交量对金融序列进行采样。然而,对按时间顺序的金融序列进行傅里叶分析可能仍然具有指导意义。为此,我们使用非均匀快速傅里叶变换(FFT)方法。
从天然气期货市场的傅里叶分析中,我们看到了市场中高频交易的强有力证据。对应于高频的傅里叶分量 (1) 在近年变得越来越突出,(2) 远比从市场结构所能预期的强得多。此外,大量的交易活动发生在每一分钟的第一秒——这是由以时间加权平均价格(TWAP)为目标的算法触发的交易的典型标志。
对交易数据的傅里叶分析表明,每分钟一次频率处的活动远高于邻近频率(见图 22.10)。注意纵轴是对数刻度。每分钟一次频率处的活动强度比邻近频率强十倍以上。此外,该活动非常精确地定义在每分钟一次,这表明这些交易是由有意构造的自动化事件触发的。我们将其视为 TWAP 算法在该市场具有重要存在的有力证据。
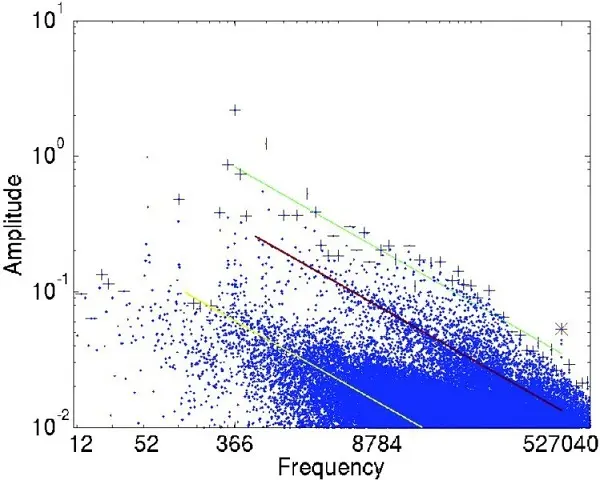
图 22.10 2012 年天然气期货合约交易价格的傅里叶谱。非均匀 FFT 识别出每天一次(频率 = 366)、每天两次(频率 = 732)和每分钟一次(频率 = 527040 = 366×24×60)的强活动存在。
我们预期频率分析会显示强烈的日周期。在图 22.10 中,我们预期频率 365 的振幅会较大。然而,我们看到最高振幅对应的是频率 366。这可以用 2012 年是闰年来解释。这验证了非均匀 FFT 正在捕捉预期的信号。第二和第三高的振幅对应的频率是 732 和 52,分别是每天两次和每周一次,这些也不令人意外。
我们还将非均匀 FFT 应用于交易量,并发现了算法交易的进一步证据。此外,这些信号表明近年来算法交易的存在更强。显然,非均匀 FFT 算法对于分析高度不规则的时间序列是有用的。
22.7 总结与参与呼吁#
目前,构建大规模计算平台有两种主要方式:HPC 方法和云方法。大多数科学计算工作使用 HPC 方法,而大多数商业计算需求通过云方法得到满足。传统观点认为 HPC 方法占据了一个无关紧要的小众领域。这并不正确。HPC 系统对科学研究的进展至关重要。它们在包括希格斯玻色子和引力波在内的激动人心的新科学发现中发挥了重要作用。它们催生了新的研究学科(如行为经济学)以及通过互联网开展商业的新方式。超大规模 HPC 系统的有用性促成了 2015 年的国家战略计算倡议3。
目前已有努力通过加速 HPC 工具在商业应用中的采用来使其更加有用。HPC4Manufacturing4 倡议正在率先将这种知识转移到美国制造业,并已引起相当大的关注。现在是时候更加协同一致地推动 HPC 来满足其他关键的商业需求了。
近年来,我们将 CIFT 发展为一大类可以从 HPC 工具和技术中受益的商业应用。在诸如如何应对电力变压器中的电压波动和市场波动事件即将来临的早期预警信号等决策中,HPC 软件工具可以帮助决策者足够早地确定信号、对预测提供充分的信心,并在灾难性事件到来之前预见到后果。这些应用具有复杂的计算需求,并且往往对响应时间也有严格要求。HPC 工具比基于云的工具更适合满足这些需求。
在我们的工作中,我们已证明 HPC I/O 库 HDF5 可用于将数据访问速度提升 21 倍,HPC 技术可将闪电崩盘早期预警指标 VPIN 的计算加速 720 倍。我们还开发了额外的算法,使我们能够预测未来数年的每日峰值用电量。我们预计将 HPC 工具和技术应用于其他应用可以获得类似显著的成果。
除了上述性能优势之外,若干已发表的研究(Yelick 等 [2011],Holzman 等 [2017])表明 HPC 系统还具有显著的价格优势。根据工作负载对 CPU、存储和网络的需求,使用云系统可能比使用 HPC 系统贵 50%,在某些情况下甚至贵达 7 倍。对于本书所述的复杂分析任务——它们持续需要摄入数据进行分析——我们预计成本优势仍将很大。
CIFT 正在扩展将 HPC 技术转移到私营公司的努力,使它们也能享受到大规模研究设施所享受的价格和性能优势。我们早期的合作者已提供资金为我们启动一台专用 HPC 系统。这一资源应当使有兴趣的各方在 HPC 系统上试验其应用变得更加容易。我们对不同形式的合作持开放态度。关于 CIFT 的更多信息,请访问 CIFT 的网页 http://crd.lbl.gov/cift/。
22.8 致谢#
CIFT 项目是 David Leinweber 博士的创意。Horst Simon 博士于 2010 年将其带到 LBNL。E. W. Bethel 博士和 D. Bailey 博士领导该项目达四年之久。
CIFT 项目收到了若干捐助者的慷慨馈赠。本工作部分由美国能源部科学办公室高级科学计算研究办公室在合同号 DE-AC02-05CH11231 下资助。本研究还使用了在同一合同下支持的国家能源研究科学计算中心的资源。
参考文献#
- Aad, G., 等 (2016): "Measurements of the Higgs boson production and decay rates and coupling strengths using pp collision data at $\sqrt{s}=7$ and 8 TeV in the ATLAS experiment." The European Physical Journal C, Vol. 76, No. 1, p. 6.
- Abbott, B.P. 等 (2016): "Observation of gravitational waves from a binary black hole merger." Physical Review Letters, Vol. 116, No. 6, p. 061102.
- Armbrust, M., 等 (2010): "A view of cloud computing." Communications of the ACM, Vol. 53, No. 4, pp. 50--58.
- Asanovic, K. 等 (2006): "The landscape of parallel computing research: A view from Berkeley." Technical Report UCB/EECS-2006-183, EECS Department, University of California, Berkeley.
- Ayachit, U. 等 "Performance analysis, design considerations, and applications of extreme-scale in situ infrastructures." Proceedings of the International Conference for High Performance Computing, Networking, Storage and Analysis. IEEE Press.
- Bethel, E. W. 等 (2011): "Federal market information technology in the post Flash Crash era: Roles for supercomputing." Proceedings of WHPCF'2011. ACM. pp. 23--30.
- Bloom, J. S. 等 (2012): "Automating discovery and classification of transients and variable stars in the synoptic survey era." Publications of the Astronomical Society of the Pacific, Vol. 124, No. 921, p. 1175.
- Camerer, C.F. 和 G. Loewenstein (2011): "Behavioral economics: Past, present, future." In Advances in Behavioral Economics, pp. 1--52.
- Chen, L. 等 (2015): "Profiling and understanding virtualization overhead in cloud." Parallel Processing (ICPP), 2015 44th International Conference. IEEE.
- Choi, J.Y. 等 (2013): ICEE: "Wide-area in transit data processing framework for near real-time scientific applications." 4th SC Workshop on Petascale (Big) Data Analytics: Challenges and Opportunities in Conjunction with SC13.
- Dong, Y. 等 (2012): "High performance network virtualization with SR-IOV." Journal of Parallel and Distributed Computing, Vol. 72, No. 11, pp. 1471--1480.
- Easley, D., M. Lopez de Prado, 和 M. O'Hara (2011): "The microstructure of the 'Flash Crash': Flow toxicity, liquidity crashes and the probability of informed trading." Journal of Portfolio Management, Vol. 37, No. 2, pp. 118--128.
- Folk, M. 等 (2011): "An overview of the HDF5 technology suite and its applications." Proceedings of the EDBT/ICDT 2011 Workshop on Array Databases. ACM.
- Fox, G. 等 (2015): "Big Data, simulations and HPC convergence, iBig Data benchmarking": 6th International Workshop, WBDB 2015, Toronto, ON, Canada, June 16--17, 2015; and 7th International Workshop, WBDB 2015, New Delhi, India, December 14--15, 2015, Revised Selected Papers, T. Rabl, 等, 编. 2016, Springer International Publishing: Cham. pp. 3--17. DOI: 10.1007/978-3-319-49748-8_1.
- Ghemawat, S., H. Gobioff, 和 S.-T. Leung (2003): "The Google file system," SOSP '03: Proceedings of the nineteenth ACM symposium on operating systems principles. ACM. pp. 29--43.
- Gordon, A. 等 (2012): "ELI: Bare-metal performance for I/O virtualization." SIGARCH Comput. Archit. News, Vol. 40, No. 1, pp. 411--422.
- Gropp, W., E. Lusk, 和 A. Skjellum (1999): Using MPI: Portable Parallel Programming with the Message-Passing Interface. MIT Press.
- Hey, T., S. Tansley, 和 K.M. Tolle (2009): The Fourth Paradigm: Data-Intensive Scientific Discovery. Vol. 1. Microsoft research Redmond, WA.
- Hirschman, A. O. (1980): National Power and the Structure of Foreign Trade. Vol. 105. University of California Press.
- Holzman, B. 等 (2017): "HEPCloud, a new paradigm for HEP facilities: CMS Amazon Web Services investigation." Computing and Software for Big Science, Vol. 1, No. 1, p. 1.
- Jackson, K. R., 等 (2010): "Performance analysis of high performance computing applications on the Amazon Web Services Cloud." Cloud Computing Technology and Science (CloudCom). 2010 Second International Conference. IEEE.
- Kim, T. 等 (2015): "Extracting baseline electricity usage using gradient tree boosting." IEEE International Conference on Smart City/SocialCom/SustainCom (SmartCity). IEEE.
- Kumar, V. 等 (1994): Introduction to Parallel Computing: Design and Analysis of Algorithms. Benjamin/Cummings Publishing Company.
- Liu, Q. 等 (2014): "Hello ADIOS: The challenges and lessons of developing leadership class I/O frameworks." Concurrency and Computation: Practice and Experience, Volume 26, No. 7, pp. 1453--1473.
- National Academies of Sciences, Engineering and Medicine (2016): Future Directions for NSF Advanced Computing Infrastructure to Support U.S. Science and Engineering in 2017--2020. National Academies Press.
- Nicholas, M. L. 等 (2009): "The Palomar transient factory: System overview, performance, and first results." Publications of the Astronomical Society of the Pacific, Vol. 121, No. 886, p. 1395.
- Qiu, J. 等 (2016): "A survey of machine learning for big data processing." EURASIP Journal on Advances in Signal Processing, Vol. 2016, No. 1, p. 67. DOI: 10.1186/s13634-016-0355-x.
- Rudin, C. 和 K. L. Wagstaff (2014): "Machine learning for science and society." Machine Learning, Vol. 95, No. 1, pp. 1--9.
- Shoshani, A. 和 D. Rotem (2010): "Scientific data management: Challenges, technology, and deployment." Chapman & Hall/CRC Computational Science Series. CRC Press.
- Snir, M. 等 (1998): MPI: The Complete Reference. Volume 1, The MPI-1 Core. MIT Press.
- Song, J. H. 等 (2014): "Exploring irregular time series through non-uniform fast Fourier transform." Proceedings of the 7th Workshop on High Performance Computational Finance, IEEE Press.
- Todd, A. 等 (2014): "Insights from Smart Meters: The potential for peak hour savings from behavior-based programs." Lawrence Berkeley National Laboratory. Available at https://www4.eere.energy.gov/seeaction/system/files/documents/smart_meters.pdf.
- Wu, K. 等 (2013): "A big data approach to analyzing market volatility." Algorithmic Finance. Vol. 2, No. 3, pp. 241--267.
- Wu, L. 等 (2016): "Towards real-time detection and tracking of spatio-temporal features: Blob-filaments in fusion plasma." IEEE Transactions on Big Data, Vol. 2, No. 3, pp. 262--275.
- Yan, J. 等 (2009): "How much can behavioral targeting help online advertising?" Proceedings of the 18th international conference on world wide web. ACM. pp. 261--270.
- Yelick, K., 等 (2011): "The Magellan report on cloud computing for science." U.S. Department of Energy, Office of Science.
- Zeff, R.L. 和 B. Aronson (1999): Advertising on the Internet. John Wiley & Sons.
注释#
NERSC 是由美国能源部资助的国家用户设施,位于 LBNL。关于 NERSC 的更多信息可在 http://nersc.gov/ 找到。 ↩︎
HDF Group 的网站是 <https://<www.hdfgroup.org/>>。 ↩︎
国家战略计算倡议计划可在线获取:https://www.whitehouse.gov/sites/whitehouse.gov/files/images/NSCI%20Strategic%20Plan.pdf。维基百科上关于此主题的页面(https://en.wikipedia.org/wiki/National_Strategic_Computing_Initiative)也有一些指向更多信息的实用链接。 ↩︎
关于 HPC4Manufacturing 的信息可在线获取:https://hpc4mfg.llnl.gov/。 ↩︎