熵特征#
18.1 动机#
价格序列传达了供需力量的信息。在完美市场中,价格是不可预测的,因为每个观测传达了关于产品或服务的所有已知信息。当市场不完美时,价格以部分信息形成,由于某些代理人比其他人了解更多,他们可以利用这种信息不对称。估计价格序列的信息含量,并形成 ML 算法可以学习可能结果的特征将是有帮助的。例如,ML 算法可能发现当价格携带少量信息时动量下注更有利可图,而当价格携带大量信息时均值回归下注更有利可图。在本章中,我们将探索确定价格序列中包含的信息量的方法。
18.2 香农熵#
在本节中,我们将回顾信息论中的一些概念,这些概念在本章其余部分将有用。读者可以在 MacKay [2003] 中找到完整阐述。信息论之父 Claude Shannon 将熵定义为数据平稳源产生的(长消息上的)平均信息量。它是以唯一可解码方式描述消息所需的每字符最小比特数。在数学上,Shannon [1948] 将离散随机变量 X(可能值为 x ∈ A)的熵定义为
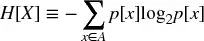
其中 0 ≤ H[X] ≤ log2||A||,其中:p[x] 是 x 的概率;H[X] = 0 ⇔ ∃x|p[x] = 1;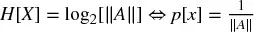 对所有 x;||A|| 是集合 A 的大小。这可以解释为 X 中信息内容的概率加权平均,信息比特以
 衡量。将信息衡量为
 的原理来自低概率结果比高概率结果揭示更多信息的观察。换言之,当意外事件发生时我们学到东西。类似地,冗余定义为
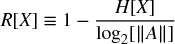
其中 0 ≤ R[X] ≤ 1。Kolmogorov [1965] 形式化了冗余与马尔可夫信息源复杂性之间的联系。两个变量之间的互信息定义为从联合概率密度到边际概率密度乘积的 Kullback-Leibler 散度。
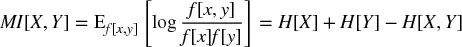
互信息(MI)始终非负、对称,当且仅当 X 和 Y 独立时为零。对于正态分布变量,互信息与熟悉的 Pearson 相关 ρ 密切相关。
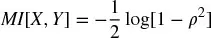
因此,互信息是变量之间关联的自然度量,无论其本质是线性还是非线性(Hausser 和 Strimmer [2009])。标准化的信息变异是从互信息导出的度量。对于几种熵估计器,见:
- R: http://cran.r-project.org/web/packages/entropy/entropy.pdf
- Python: https://code.google.com/archive/p/pyentropy/
18.3 插入式(最大似然)估计量#
在本节中,我们将遵循 Gao 等 [2008] 中关于熵的最大似然估计器的阐述。命名法一开始可能看起来有点特殊(没有双关意),但一旦熟悉就会发现它很方便。给定一个数据序列 x^n1(从位置 1 到位置 n 的值串),我们可以形成该序列中所有长度为 w < n 的词的字典 A^w^。考虑长度为 w 的任意词 y^w1 ∈ A^w^。我们记  为词 y^w
1 在 x^n1 中的经验概率,这意味着  是 y^w
1 在 x^n1 中出现的频率。假设数据由平稳且遍历的过程生成,大数定律保证对于固定的 w 和大的 n,经验分布  将接近真实分布 p
w。在这些情况下,熵率(即每比特的平均熵)的自然估计器为
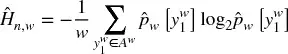
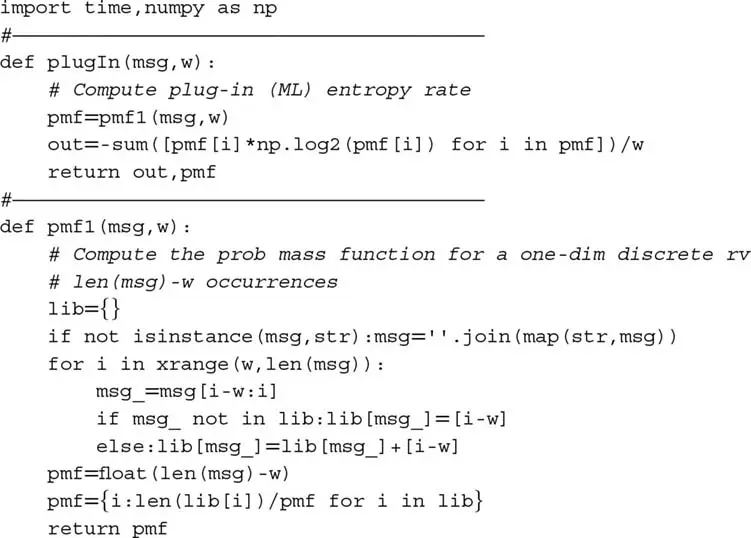
由于经验分布也是真实分布的最大似然估计,这也常被称为最大似然熵估计器。值 w 应足够大以使  可接受地接近真实熵 H。n 的值需要远大于 w,以使 w 阶经验分布接近真实分布。代码片段 18.1 实现了插入式熵估计器。
代码片段 18.1 插入式熵估计器
18.4 Lempel-Ziv 估计量#
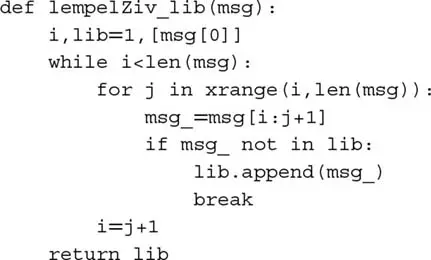
熵可以解释为复杂性的度量。复杂序列比规律(可预测)序列包含更多信息。Lempel-Ziv(LZ)算法高效地将消息分解为非冗余子串(Ziv 和 Lempel [1978])。我们可以根据 Lempel-Ziv 字典中的项目数相对于消息长度来估计消息的压缩率。直觉是复杂消息具有高熵,将需要相对于待传输字符串长度更大的字典。代码片段 18.2 展示了 LZ 压缩算法的实现。
代码片段 18.2 使用 LZ 算法构建的库
Kontoyiannis [1998] 试图更有效地利用消息中可用的信息。以下是对 Gao 等 [2008] 中阐述的忠实总结。我们将复现该论文中的步骤,同时补充实现其思想的代码片段。让我们定义 L^ni 为 1 加上在 i 之前的 n 个比特中找到的最长匹配长度,
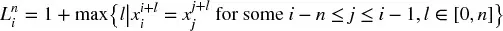
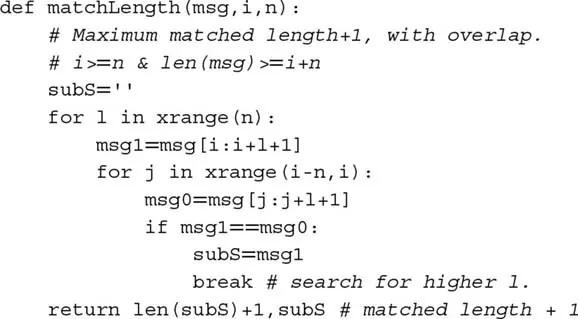
代码片段 18.3 实现了确定最长匹配长度的算法。几点值得提及的注意事项:
- 滑动窗口的值 n 是常数,而扩展窗口 n = i。
- 计算 L^n
i需要数据 x^i+n−1~~i−n~。换言之,索引 i 必须在窗口的中心。这对于保证两个匹配字符串长度相同很重要。如果它们长度不同,l 的范围将有限,其最大值将被低估。 - 两个子串之间允许一些重叠,但显然两者不能都从 i 开始。
代码片段 18.3 计算最长匹配长度的函数
Ornstein 和 Weiss [1993] 形式化地建立了
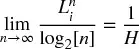
Kontoyiannis 使用该结果估计香农熵率。他估计平均  ,并使用该平均的倒数来估计 H。一般直觉是,随着可用历史增加,我们期望高熵消息产生相对较短的非冗余子串。相比之下,低熵消息在我们解析消息时将产生相对较长的非冗余子串。给定数据实现 x^∞
−∞、窗口长度 n ≥ 1 和匹配数 k ≥ 1,滑动窗口 LZ 估计器 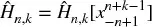 定义为
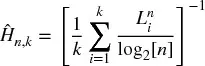
类似地,递增窗口 LZ 估计器 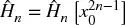 定义为
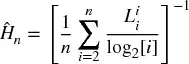
计算  时窗口大小 n 为常数,因此 L^n
i。然而,计算  时窗口大小随 i 增加,因此 L^i
i,其中  。在这种扩展窗口情况下,消息长度 N 应为偶数以确保所有比特都被解析(回忆 x
i 在中心,因此对于奇数长度消息,最后一个比特不会被读取)。
上述表达式在以下假设下推导:平稳性、遍历性、过程取有限多个值、过程满足 Doeblin 条件。直觉上,该条件要求在有限步 r 之后,无论之前发生了什么,任何事情都以正概率可能发生。如果我们考虑上述估计器的修改版本,这个 Doeblin 条件可以完全避免:
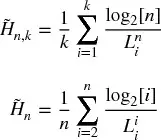
估计  时的一个实际问题是如何确定窗口大小 n。Gao 等 [2008] 认为 k + n = N 应大约等于消息长度。考虑到 L^n
i 的偏差为  阶,L^n
i 的方差为  阶,偏差/方差的权衡在大约
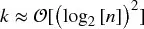 处平衡。即 n 可以选择使 N ≈ n + (log
2[n])²。例如,对于 N = 2⁸,平衡偏差/方差的窗口大小为 n ≈ 198,此时 k ≈ 58。
Kontoyiannis [1998] 证明了  在 n 趋于无穷时以概率 1 收敛到香农熵率。代码片段 18.4 实现了 Gao 等 [2008] 中讨论的思想,通过在两个相同大小的子串之间寻找最大冗余来改进 Kontoyiannis [1997]。
代码片段 18.4 实现 Gao 等 [2008] 中讨论的算法
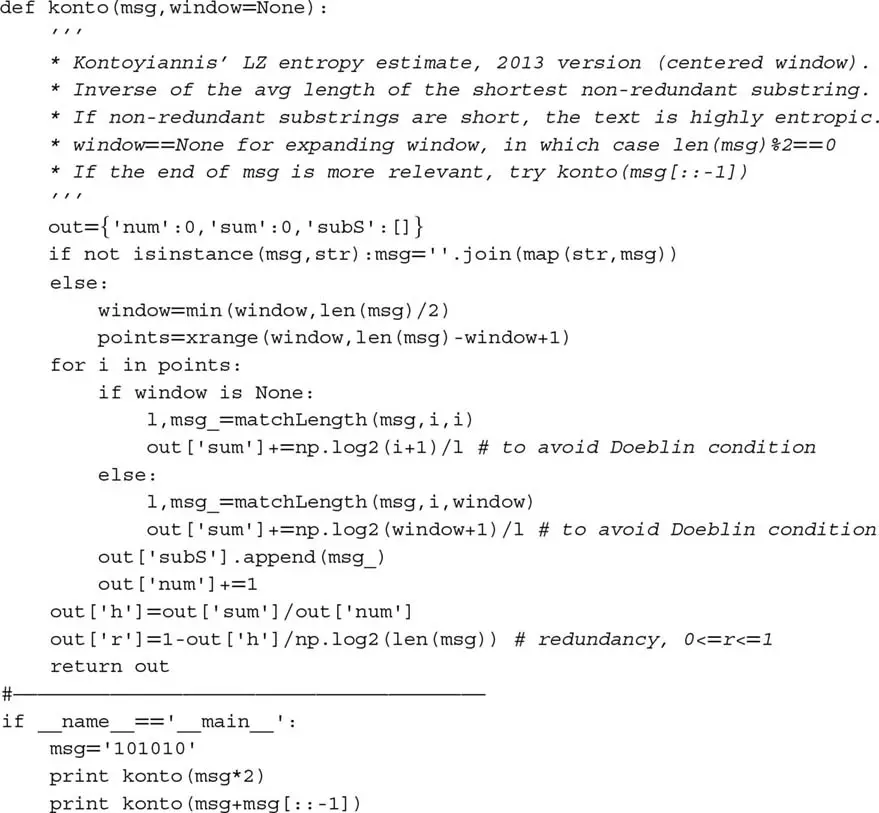
该方法的一个警示是熵率在极限中定义。用 Kontoyiannis 的话说,「我们固定一个大整数 N 作为数据库的大小。」Kontoyiannis 论文使用的定理证明了渐近收敛;然而,没有任何地方声称单调性。当消息短时,一种解决方案可能是将同一消息重复多次。
第二个警示是,由于匹配窗口必须对称(字典和待匹配子串长度相同),只有消息长度对应偶数时最后一个比特才被考虑用于匹配。一种解决方案是删除奇数长度消息的第一个比特。
第三个警示是,当后面跟着不规则序列时,一些最终比特将被忽略。这也是对称匹配窗口的结果。例如,「10000111」的熵率等于「10000110」的熵率,意味着由于第六和第七比特不可匹配的「11」,最终比特无关紧要。当消息的结尾特别相关时,一个好的解决方案可能是分析反转消息的熵。这不仅确保最终比特(即反转后的初始比特)被使用,而且实际上它们将用于潜在匹配每个比特。按照前面的例子,「11100001」的熵率为 0.96,而「01100001」的熵率为 0.84。
18.5 编码方案#
估计熵需要对消息进行编码。在本节中,我们将回顾文献中使用的一些基于收益的编码方案。虽然以下未讨论,但建议从分数阶(而非整数)差分序列(第 4 章)编码信息,因为它们仍然包含一些记忆。
18.5.1 二进制编码#
熵率估计需要连续变量的离散化,以便每个值可以从有限字母表中分配一个代码。例如,收益流 rt 可以根据符号编码,rt > 0 为 1,rt < 0 为 0,去除 rt = 0 的情况。当收益序列从价格条(即包含在两个对称水平障碍之间波动的价格的条,以起始价格为中心)采样时,二进制编码自然出现,因为 |rt| 近似恒定。
当 |rt| 可以采用广泛的结果范围时,二进制编码丢弃了潜在有用的信息。当使用受 tick 数据非均匀性质导致的异方差性影响的日内时间条时尤其如此。部分解决这种异方差性的一种方法是按从属随机过程采样价格。这方面的例子是交易条和成交量条,它们包含固定数量的交易或固定成交量的交易(见第 2 章)。通过在这种非时间顺序的、市场驱动的时钟中操作,我们在高活动期间更频繁地采样,在低活动期间更少采样,从而规范化 |rt| 的分布并减少对大字母表的需求。
18.5.2 分位数编码#
除非使用价格条,否则可能需要两个以上的代码。一种方法是根据 rt 所属的分位数分配代码。分位数边界使用样本内期间(训练集)确定。整个样本内每个字母将分配相同数量的观测,样本外每个字母的观测数接近相同。使用该方法时,某些代码跨越 rt 范围的更大比例。这种均匀(样本内)或接近均匀(样本外)的代码分布往往平均增加熵读数。
18.5.3 Sigma 编码#
作为替代方法,我们不是固定代码数,而是让价格流确定实际的字典。假设我们固定一个离散化步长 σ。然后,我们将值 0 分配给 rt ∈ [min{r}, min{r} + σ),1 分配给 rt ∈ [min{r} + σ, min{r} + 2σ),以此类推,直到每个观测都被编码,总共有 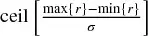 个代码,其中 ceil[·] 是向上取整函数。与分位数编码不同,现在每个代码覆盖 r
t 范围的相同比例。由于代码不是均匀分布的,熵读数平均将小于分位数编码;然而,「罕见」代码的出现将导致熵读数的飙升。
18.6 高斯过程的熵#
IID 正态随机过程的熵(见 Norwich [2003])可以推导为
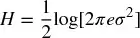
对于标准正态,H ≈ 1.42。该结果至少有两个用途。第一,它允许我们对熵估计器的性能进行基准测试。我们可以从标准正态分布中抽取样本,找到估计器、消息长度和编码的什么组合给我们足够接近理论推导值 H 的熵估计  。例如,图 18.1 绘制了使用 Kontoyiannis 方法在长度 100 的消息上、10、7、5 和 2 字母编码下的熵估计自助法分布。对于至少 10 个字母的字母表,代码片段 18.4 中的算法给出正确答案。当字母表太小时,信息被丢弃,熵被低估。
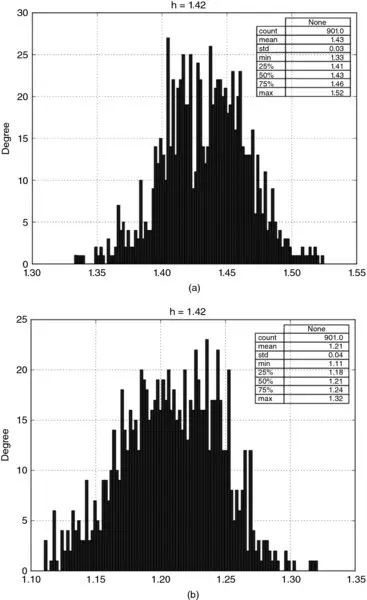
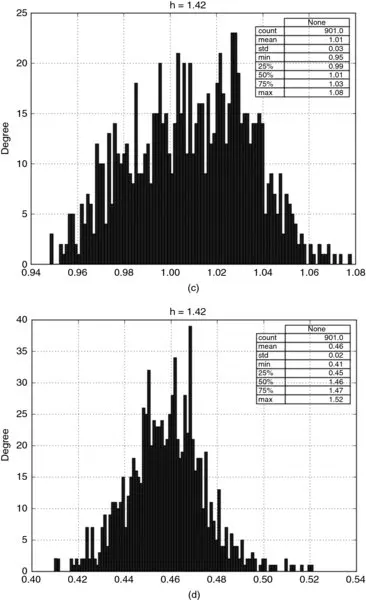
图 18.1 长度 100 消息上 10(上)、7(下)字母编码的熵估计分布。长度 100 消息上 5(上)、2(下)字母编码的熵估计分布。
第二,我们可以使用上述方程将熵与波动率联系起来,注意  。这给了我们一个熵隐含的波动率估计,前提是收益确实来自正态分布。
18.7 熵与广义均值#
这是思考熵的一种有趣方式。考虑一组实数 x = {xi}i=1,...,n 和权重 p = {pi}i=1,...,n,使得 0 ≤ pi ≤ 1,∀i 且  。x 在权重 p 下、幂 q ≠ 0 的广义加权均值定义为
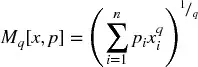
对于 q < 0,我们必须要求 xi > 0,∀i。这是广义均值的原因是其他均值可以作为特例获得:
- 最小值:
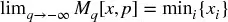
- 调和均值:
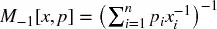
- 几何均值:
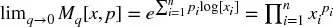
- 算术均值:
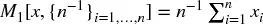
- 加权均值:
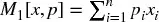
- 二次均值:
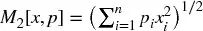
- 最大值:
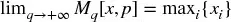
在信息论的上下文中,一个有趣的特例是 x = {pi}i=1,...,n,因此
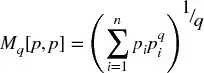
让我们定义量 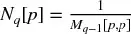 ,对于某 q ≠ 1。同样,对于 N
q[p] 中的 q < 1,我们必须有 pi > 0,∀i。如果对于 k ∈ [1, n] 个不同索引  且其他地方 p
i = 0,则权重均匀分布在 k 个不同项目上,对于 q > 1,Nq[p] = k。换言之,Nq[p] 给出了 p 中项目的有效数量或多样性,根据 q 设置的某种加权方案。
使用 Jensen 不等式,我们可以证明  ,因此
 。较小的 q 值对分区元素分配更均匀的权重,相对更多权重给不太常见的元素,
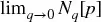 就是非零 p
i 的总数。
香农熵为 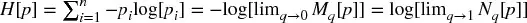 。这表明熵可以解释为列表 p 中有效数量的对数,其中 q → 1。图 18.2 说明了随机生成的 p 数组族的广义均值对数有效数量如何在 q 趋近 1 时收敛到香农熵。还注意到随着 q 变大,它们的行为如何稳定。
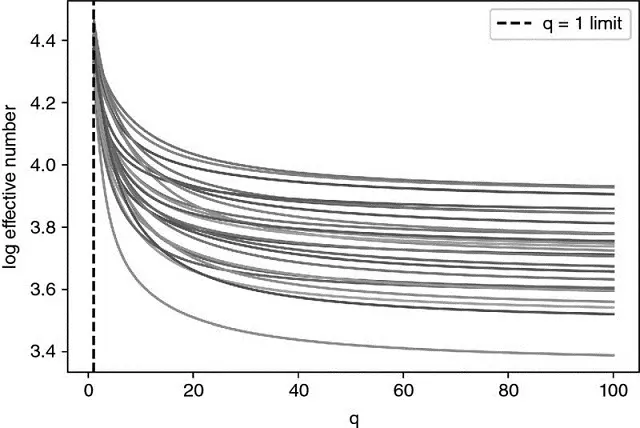
图 18.2 随机生成 p 数组族的广义均值对数有效数量
直觉上,熵将信息衡量为随机变量中包含的多样性水平。这种直觉通过广义均值的概念形式化。其含义是香农熵是多样性度量的特例(因此与波动率的联系)。我们现在可以定义和计算熵以外的替代多样性度量,其中 q ≠ 1。
18.8 熵的几个金融应用#
在本节中,我们将介绍熵在金融市场建模中的一些应用。
18.8.1 市场效率#
当套利机制利用了完整的机会集时,价格瞬时反映全部可用信息,变得不可预测(即鞅),没有可辨别的模式。相反,当套利不完美时,价格包含不完整的信息量,从而产生可预测的模式。当字符串包含冗余信息时出现模式,这使其能够压缩。字符串的熵率确定其最优压缩率。熵越高,冗余越低,信息内容越大。因此,价格字符串的熵告诉我们在给定时间点的市场效率程度。「解压的」市场是有效市场,因为价格信息是非冗余的。「压缩的」市场是无效市场,因为价格信息是冗余的。泡沫在压缩(低熵)市场中形成。
18.8.2 最大熵生成#
在一系列论文中,Fiedor [2014a, 2014b, 2014c] 提出使用 Kontoyiannis [1997] 估计价格序列中存在的熵量。他认为,在可能的未来结果中,最大化熵的结果可能是最有利可图的,因为它是最不被频率统计模型预测到的。它是最有可能触发止损的黑天鹅场景,从而产生将加强和加剧运动的反馈机制,导致收益时间序列符号的运行。
18.8.3 投资组合集中度#
考虑一个在收益上计算的 N×N 协方差矩阵 V。第一,我们对矩阵进行特征值分解,VW = WΛ。第二,我们获得因子载荷向量为 fω = W'ω,其中 ω 是配置向量, 。^1^ 第三,我们推导每个主成分贡献的风险部分(Bailey 和 López de Prado [2012])为
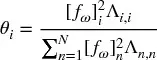
其中  ,θ
i ∈ [0, 1],∀i = 1, ..., N。第四,Meucci [2009] 提出了以下受熵启发的投资组合集中度定义,
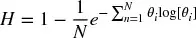
乍一看,投资组合集中度的这个定义可能听起来令人惊讶,因为 θi 不是概率。这种集中度概念与熵之间的联系来自广义均值,我们在第 18.7 节中讨论过。
18.8.4 市场微观结构#
Easley 等 [1996, 1997] 表明,当好新闻/坏新闻的赔率相等时,知情交易概率(PIN)可以推导为
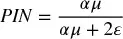
其中 μ 是知情交易者的到达率,ϵ 是非知情交易者的到达率,α 是信息事件的概率。PIN 可以解释为知情交易者相对于整体订单流的订单比例。
在大小为 V 的成交量条内,我们可以根据某种算法(如 tick 规则或 Lee-Ready 算法)将 tick 分类为买入或卖出。令 V^B^τ 为成交量条 τ 中买入 tick 的成交量之和,V^S^τ 为成交量条 τ 中卖出 tick 的成交量之和。Easley 等 [2012a, 2012b] 注意到 E[|V^B^τ − V^S^τ|] ≈ αμ 且预期总成交量为 E[V^B^τ + V^S^τ] = αμ + 2ϵ。通过使用成交量时钟(Easley 等 [2012c]),我们可以外生地设定 E[V^B^τ + V^S^τ] = αμ + 2ϵ = V 的值。这意味着在成交量时钟下,PIN 简化为
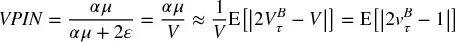
其中  。注意 2v^B^
τ − 1 代表订单流不平衡 OIτ,它是一个有界实值变量,OIτ ∈ [−1, 1]。因此,VPIN 理论提供了知情交易概率(PIN)与成交量时钟下订单流不平衡持续性之间的正式联系。该微观结构理论的更多细节见第 19 章。
持续的订单流不平衡是逆向选择的必要非充分条件。做市商要向知情交易者提供流动性,该订单流不平衡 |OIτ| 也必须是相对不可预测的。换言之,当做市商对订单流不平衡的预测准确时,即使 |OIτ| ≫ 0,他们也不会被逆向选择。为了确定逆向选择的概率,我们必须确定订单流不平衡有多不可预测。我们可以通过应用信息论来确定这一点。
考虑一个长的符号序列。当该序列包含很少的冗余模式时,它包含一定程度的复杂性,使其难以描述和预测。Kolmogorov [1965] 形式化了冗余与复杂性之间的联系。在信息论中,无损压缩是用尽可能少的比特完美描述序列的任务。序列包含的冗余越多,可以实现的压缩率越高。熵表征了源的冗余,因此表征了其 Kolmogorov 复杂性和可预测性。我们可以利用序列冗余与其不可预测性(做市商)之间的联系来推导逆向选择的概率。
这里我们将讨论一种特定程序,该程序将逆向选择概率推导为订单流不平衡中根深蒂固的复杂性的函数。第一,给定以 τ = 1, ..., N 索引的成交量条序列,每条大小为 V,我们确定分类为买入的成交量部分 v^B^τ ∈ [0, 1]。第二,我们计算 {v^B^τ} 上的 q 分位数,定义一组 K 的 q 个不相交子集,K = {K1, ..., Kq}。第三,我们产生从每个 v^B^τ 到不相交子集之一的映射 f: v^B^τ → {1, ..., q},其中 f[v^B^τ] = i ⇔ v^τB ∈ Ki,∀i ∈ [1, q]。第四,我们通过将每个值 v^B^τ 分配给它所属子集 K 的索引 f[v^B^τ] 来量化 {v^B^τ}。这将订单不平衡集 {v^B^τ} 转换为量化消息 X = {f[v^B^1], f[v^B^2], ..., f[v^B^N]}。第五,我们使用 Kontoyiannis 的 Lempel-Ziv 算法估计熵 H[X]。第六,我们推导累积分布函数 F[H[X]],并使用 {F[H[Xτ]]}τ=1,...,N 的时间序列作为预测逆向选择的特征。
练习题#
在 E-mini S&P 500 期货上形成美元条:
- 使用二进制方法量化收益序列。
- 使用 10 个字母的分位数编码量化收益序列。
- 使用 sigma 编码量化收益序列,其中 σ 是所有条收益的标准差。
- 使用插入式方法计算三个编码序列的熵。
- 使用 Kontoyiannis 方法(窗口大小 100)计算三个编码序列的熵。
使用练习 1 的条:
- 计算收益序列 {r
t}。 - 如下编码序列:r
t× rt−1< 0 为 0,rt× rt−1≥ 0 为 1。 - 将序列划分为 1000 个等大小的非重叠子集(你可能需要在开始时丢弃一些观测)。
- 使用插入式方法计算 1000 个编码子集中每个的熵。
- 使用 Kontoyiannis 方法(窗口大小 100)计算 1000 个编码子集中每个的熵。
- 计算 2.d 和 2.e 结果之间的相关性。
- 计算收益序列 {r
从标准正态分布中抽取 1000 个观测:
- 该过程的真实熵是多少?
- 根据 8 个分位数标记观测。
- 使用插入式方法估计熵。
- 使用 Kontoyiannis 方法估计熵:
- 使用窗口大小 10。
- 使用窗口大小 100。
使用练习 3 的抽取 {x
t}t=1,...,1000:- 计算 y
t= ρyt−1+ xt,其中 ρ = .5,y0= 0。 - 根据 8 个分位数标记 {y
t} 观测。 - 使用插入式方法估计熵。
- 使用 Kontoyiannis 方法估计熵:
- 使用窗口大小 10。
- 使用窗口大小 100。
- 计算 y
假设一个 10 个持仓、等美元配置的投资组合。
- 第 i 个主成分贡献的总风险部分为
 ,i = 1, ..., 10。投资组合的熵是多少?
- 第 i 个主成分贡献的总风险部分为
 ,i = 1, ..., 10。投资组合的熵是多少?
- 第 i 个主成分贡献的总风险部分为
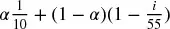 ,i = 1, ..., 10,α ∈ [0, 1]。绘制投资组合熵作为 α 的函数。
- 第 i 个主成分贡献的总风险部分为
参考文献#
- Bailey, D. and M. López de Prado (2012): "Balanced baskets: A new approach to trading and hedging risks." Journal of Investment Strategies, Vol. 1, No. 4, pp. 21--62.
- Easley D., M. Kiefer, M. O'Hara, and J. Paperman (1996): "Liquidity, information, and infrequently traded stocks." Journal of Finance, Vol. 51, No. 4, pp. 1405--1436.
- Easley D., M. Kiefer and, M. O'Hara (1997): "The information content of the trading process." Journal of Empirical Finance, Vol. 4, No. 2, pp. 159--185.
- Easley, D., M. López de Prado, and M. O'Hara (2012a): "Flow toxicity and liquidity in a high frequency world." Review of Financial Studies, Vol. 25, No. 5, pp. 1547--1549.
- Easley, D., M. López de Prado, and M. O'Hara (2012b): "The volume clock." Journal of Portfolio Management, Vol. 39, No. 1, pp. 19--29.
- Gao, Y., I. Kontoyiannis and E. Bienestock (2008): "Estimating the entropy of binary time series." arXiv. Available at https://arxiv.org/abs/0802.4363v1.
- Fiedor, Pawel (2014a): "Mutual information rate-based networks in financial markets." arXiv. Available at https://arxiv.org/abs/1401.2548.
- Fiedor, Pawel (2014b): "Information-theoretic approach to lead-lag effect on financial markets." arXiv. Available at https://arxiv.org/abs/1402.3820.
- Fiedor, Pawel (2014c): "Causal non-linear financial networks." arXiv. Available at https://arxiv.org/abs/1407.5020.
- Hausser, J. and K. Strimmer (2009): "Entropy inference and the James-Stein estimator." Journal of Machine Learning Research, Vol. 10, pp. 1469--1484.
- Kolmogorov, A. (1965): "Three approaches to the quantitative definition of information." Problems in Information Transmission, Vol. 1, No. 1, pp. 1--7.
- Kontoyiannis, I. (1997): "The complexity and entropy of literary styles." NSF Technical Report #97.
- Kontoyiannis (1998): "Asymptotically optimal lossy Lempel-Ziv coding." ISIT, Cambridge, MA.
- MacKay, D. (2003): Information Theory, Inference, and Learning Algorithms, 1st ed. Cambridge University Press.
- Meucci, A. (2009): "Managing diversification." Risk Magazine, Vol. 22, pp. 74--79.
- Norwich, K. (2003): Information, Sensation and Perception, 1st ed. Academic Press.
- Ornstein, D.S. and B. Weiss (1993): "Entropy and data compression schemes." IEEE Transactions on Information Theory, Vol. 39, pp. 78--83.
- Shannon, C. (1948): "A mathematical theory of communication." Bell System Technical Journal, Vol. 27, No. 3, pp. 379--423.
- Ziv, J. and A. Lempel (1978): "Compression of individual sequences via variable-rate coding." IEEE Transactions on Information Theory, Vol. 24, No. 5, pp. 530--536.
参考书目#
- Easley, D., R. Engle, M. O'Hara, and L. Wu (2008): "Time-varying arrival rates of informed and uninformed traders." Journal of Financial Econometrics, Vol. 6, No. 2, pp. 171--207.
- Easley, D., M. López de Prado, and M. O'Hara (2011): "The microstructure of the flash crash." Journal of Portfolio Management, Vol. 37, No. 2, pp. 118--128.
- Easley, D., M. López de Prado, and M. O'Hara (2012c): "Optimal execution horizon." Mathematical Finance, Vol. 25, No. 3, pp. 640--672.
- Gnedenko, B. and I. Yelnik (2016): "Minimum entropy as a measure of effective dimensionality." Working paper. Available at https://ssrn.com/abstract=2767549.
注释#
^1^ 或者,如果协方差矩阵是在价格变化上计算的,我们可以使用持仓向量。