机器学习资产配置#
16.1 动机#
本章介绍层次风险平价(Hierarchical Risk Parity, HRP)方法。^1^ HRP 投资组合解决了二次优化器(特别是 Markowitz 的临界线算法 CLA)的三个主要问题:不稳定性、集中性和表现不佳。HRP 应用现代数学(图论和机器学习技术),基于协方差矩阵中包含的信息构建分散化投资组合。然而,与二次优化器不同,HRP 不要求协方差矩阵的可逆性。事实上,HRP 可以在病态退化甚至奇异协方差矩阵上计算投资组合,这对二次优化器来说是不可能的壮举。蒙特卡洛实验表明,HRP 的样本外方差低于 CLA,即使最小方差是 CLA 的优化目标。与传统风险平价方法相比,HRP 在样本外产生风险更低的投资组合。历史分析也表明 HRP 的表现优于标准方法(Kolanovic 等 [2017]、Raffinot [2017])。HRP 的一个实际应用是确定多个机器学习(ML)策略间的配置。
16.2 凸投资组合优化的问题#
投资组合构建也许是最常见的金融问题。每天,投资经理必须构建整合其对风险和收益的观点和预测的投资组合。这是 24 岁的 Harry Markowitz 在六十多年前试图回答的最原始问题。他的不朽洞见是认识到不同风险水平对应不同的风险调整收益最优投资组合,因此有了「有效前沿」的概念(Markowitz [1952])。一个含义是,将所有资产分配给期望收益最高的投资很少是最优的。相反,我们应该考虑替代投资之间的相关性,以构建分散化的投资组合。
在 1954 年获得博士学位之前,Markowitz 离开学术界加入 RAND Corporation,在那里他开发了临界线算法(CLA)。CLA 是一种专门为不等式约束投资组合优化问题设计的二次优化程序。该算法的显著之处在于它保证在已知迭代次数后找到精确解,并巧妙地规避了 Karush-Kuhn-Tucker 条件(Kuhn 和 Tucker [1951])。该算法的描述和开源实现见 Bailey 和 López de Prado [2013]。令人惊讶的是,大多数金融从业者似乎仍然不知道 CLA,因为他们经常依赖不保证正确解或停止时间的通用二次规划方法。
尽管 Markowitz 的理论非常出色,许多实际问题使 CLA 的解有些不可靠。一个主要警示是,预测收益的微小偏差会导致 CLA 产生非常不同的投资组合(Michaud [1998])。鉴于收益很少能以足够的精度预测,许多作者选择完全放弃它们而专注于协方差矩阵。这导致了基于风险的资产配置方法,其中「风险平价」是一个突出的例子(Jurczenko [2015])。放弃收益预测改善了但不能防止不稳定问题。原因是二次规划方法需要正定协方差矩阵(所有特征值必须为正)的逆。当协方差矩阵在数值上病态条件化(即条件数高)时,该逆容易产生大误差(Bailey 和 López de Prado [2012])。
16.3 Markowitz 的诅咒#
协方差矩阵、相关矩阵(或正规矩阵,因此可对角化)的条件数是其最大和最小(按模)特征值之比的绝对值。图 16.1 绘制了几个相关矩阵的排序特征值,其中条件数是每条线第一个和最后一个值的比率。对角相关矩阵的条件数最低,它是自己的逆。随着我们添加相关(多重共线性)投资,条件数增长。在某个点,条件数如此之高,以至于数值误差使逆矩阵太不稳定:任何条目的微小变化都会导致非常不同的逆。这就是 Markowitz 的诅咒:投资越相关,分散化的需求越大,然而我们越可能得到不稳定的解。分散化的好处往往被估计误差所抵消甚至超过。
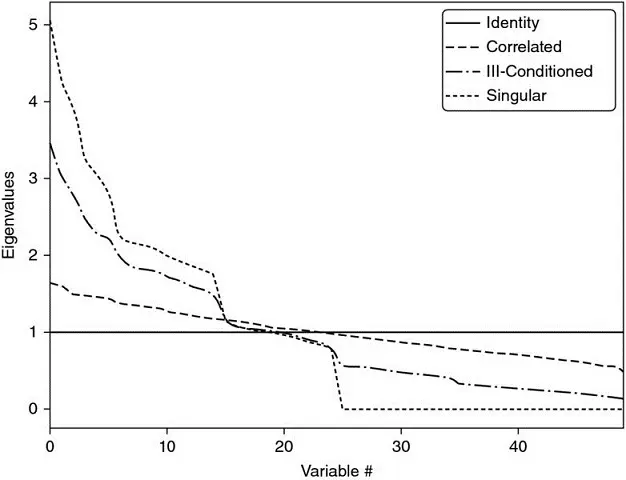
图 16.1 Markowitz 诅咒的可视化
对角相关矩阵的条件数最低。随着我们添加相关投资,最大特征值更大,最小特征值更低。条件数快速上升,导致不稳定的相关矩阵逆。在某个点,分散化的好处被估计误差所抵消。
增加协方差矩阵的大小只会使情况更糟,因为每个协方差系数以更少的自由度估计。一般来说,我们至少需要  个独立同分布(IID)观测来估计一个大小为 N 的非奇异协方差矩阵。例如,估计一个大小为 50 的可逆协方差矩阵至少需要 5 年的日度 IID 数据。大多数投资者知道,在任何合理的置信水平下,相关结构不会在如此长的期间内保持不变。这些挑战的严重程度可以由以下事实概括:即使是朴素(等权重)投资组合也被证明在样本外击败均值-方差和基于风险的优化(De Miguel 等 [2009])。
16.4 从几何到层次关系#
这些不稳定性担忧近年来受到大量关注,如 Kolm 等 [2014] 仔细记录的那样。大多数替代方案试图通过引入额外约束(Clarke 等 [2002])、引入贝叶斯先验(Black 和 Litterman [1992])或改善协方差矩阵逆的数值稳定性(Ledoit 和 Wolf [2003])来实现稳健性。
到目前为止讨论的所有方法虽然发表于近年,但都源自(非常)经典的数学领域:几何、线性代数和微积分。相关矩阵是一个线性代数对象,衡量收益序列形成的向量空间中任意两个向量之间角度的余弦(见 Calkin 和 López de Prado [2014a, 2015b])。二次优化器不稳定的一个原因是,向量空间被建模为完全(全连接)图,其中每个节点都是替代另一个的潜在候选。在算法上,求矩阵逆意味着评估完全图上的偏相关。图 16.2(a) 可视化了 50×50 协方差矩阵隐含的关系,即 50 个节点和 1225 条边。这种复杂结构放大了小的估计误差,导致错误的解。直觉上,放弃不必要的边是可取的。
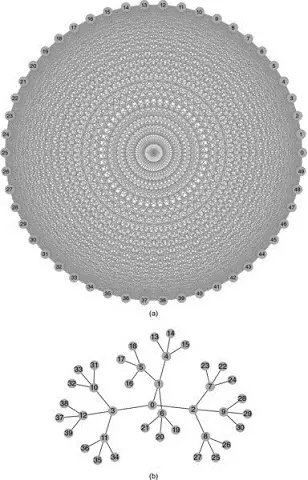
图 16.2 完全图(上)和树图(下)结构
相关矩阵可以表示为完全图,缺乏层次概念:每个投资都可与另一个替代。相比之下,树结构纳入了层次关系。
让我们考虑一下这种拓扑结构的实际影响。假设投资者希望构建一个分散化的证券投资组合,包括数百只股票、债券、对冲基金、房地产、私募配售等。一些投资看起来更接近彼此的替代品,另一些则看起来互补。例如,股票可以按流动性、规模、行业和地区分组,其中给定组内的股票竞争配置。在决定对像 J.P. Morgan 这样的大型美国上市金融股的配置时,我们会考虑增加或减少对另一家大型美国上市银行(如 Goldman Sachs)的配置,而不是瑞士的小型社区银行或加勒比海的房地产持有。然而,对于相关矩阵,所有投资都是彼此的潜在替代品。换言之,相关矩阵缺乏层次的概念。这种层次结构的缺乏允许权重以非预期的方式自由变化,这是 CLA 不稳定的根本原因。图 16.2(b) 可视化了一种称为树的层次结构。树结构引入了两个理想特征:(1) 它只有 N−1 条边连接 N 个节点,因此权重只在各个层次级别的同级之间再平衡;(2) 权重自上而下分布,与许多资产经理构建投资组合的方式一致(例如,从资产类别到部门到单个证券)。由于这些原因,层次结构更好地设计为不仅提供稳定而且直观的结果。
在本章中,我们将研究一种使用现代数学(图论和机器学习)解决 CLA 缺陷的新投资组合构建方法。该层次风险平价方法使用协方差矩阵中包含的信息,而不要求其可逆性或正定性。HRP 甚至可以基于奇异协方差矩阵计算投资组合。该算法分三个阶段操作:树聚类、准对角化和递归二分。
16.4.1 树聚类#
考虑一个 T×N 的观测矩阵 X,如 N 个变量在 T 个期间的收益序列。我们希望将这 N 个列向量组合成聚类的层次结构,以便配置可以通过树图向下游流动。
第一,我们计算一个 N×N 的相关矩阵,条目为 ρ = {ρi,j}i,j=1,...,N,其中 ρi,j = ρ[Xi, Xj]。我们定义距离度量 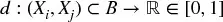 ,
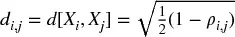 ,其中 B 是 {i, ..., N} 中项目的笛卡尔积。这允许我们计算一个 N×N 的距离矩阵 D = {d
i,j}i,j=1,...,N。矩阵 D 是一个真正的度量空间(证明见附录 16.A.1),即 d[x,y] ≥ 0(非负性)、d[x,y] = 0 ⇔ X = Y(重合性)、d[x,y] = d[Y,X](对称性)和 d[X,Z] ≤ d[x,y] + d[Y,Z](次可加性)。见示例 16.1。
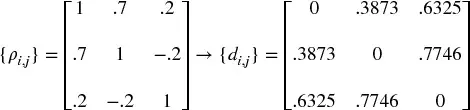
示例 16.1 将相关矩阵 ρ 编码为距离矩阵 D
第二,我们计算 D 的任意两个列向量之间的欧几里得距离,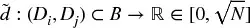 、
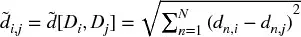 。注意距离度量 d
i,j 和  之间的区别。d
i,j 定义在 X 的列向量上,而  定义在 D 的列向量上(距离的距离)。因此,
 是在整个度量空间 D 上定义的距离,因为每个
 是整个相关矩阵(而非特定互相关对)的函数。见示例 16.2。
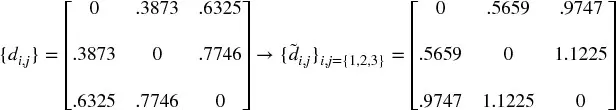
示例 16.2 相关距离的欧几里得距离
第三,我们将 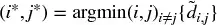 最小的列对 (i*, j*) 聚类在一起,并将此聚类记为 u[1]。见示例 16.3。
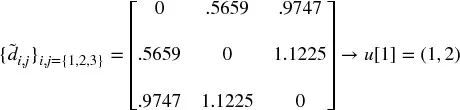
示例 16.3 聚类项目
第四,我们需要定义新形成的聚类 u[1] 与单个(未聚类)项目之间的距离,以便更新  。在层次聚类分析中,这被称为「链接准则」。例如,我们可以将
 的项目 i 与新聚类 u[1] 之间的距离定义为
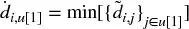 (最近点算法)。见示例 16.4。
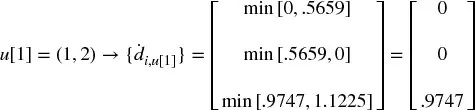
示例 16.4 用新聚类 u 更新矩阵 
第五,矩阵  通过追加
 并删除聚类的列和行 j ∈ u[1] 来更新。见示例 16.5。
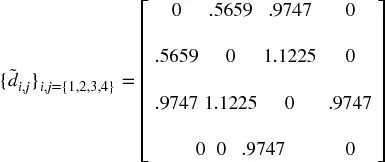
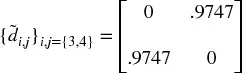
示例 16.5 用新聚类 u 更新矩阵 
第六,递归应用步骤 3、4 和 5 允许我们向矩阵 D 追加 N−1 个这样的聚类,此时最终聚类包含所有原始项目,聚类算法停止。见示例 16.6。
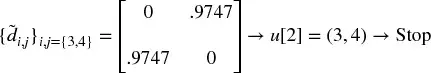
示例 16.6 递归搜索剩余聚类
图 16.3 显示了本例每次迭代形成的聚类,以及触发每个聚类的距离  (第三步)。该程序可以应用于各种距离度量 d
i,j、 和
 ,超越本章说明的那些。替代度量见 Rokach 和 Maimon [2005]、Brualdi [2010] 中关于 Fiedler 向量和 Stewart 谱聚类方法的讨论,以及 scipy 库中的算法。^2^ 代码片段 16.1 提供了使用 scipy 功能进行树聚类的示例。
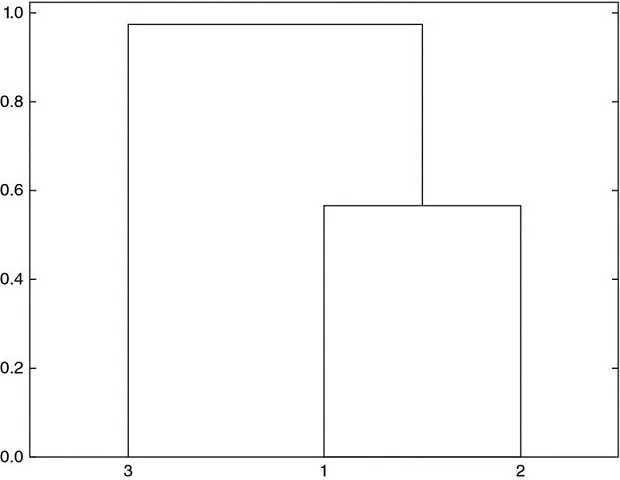
图 16.3 聚类形成序列
从我们的数值示例导出的树结构,此处绘制为树状图。y 轴衡量两个合并叶之间的距离。
代码片段 16.1 使用 SCIPY 功能进行树聚类
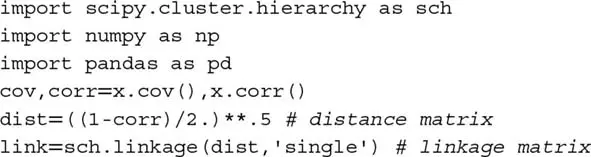
该阶段允许我们将链接矩阵定义为 (N−1)×4 矩阵,结构为 Y = {(ym,1, ym,2, ym,3, ym,4)}m=1,...,N−1(即每个聚类一个四元组)。项 (ym,1, ym,2) 报告成分。项 ym,3 报告 ym,1 和 ym,2 之间的距离,即 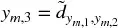 。项 y
m,4 ≤ N 报告聚类 m 中包含的原始项目数。
16.4.2 准对角化#
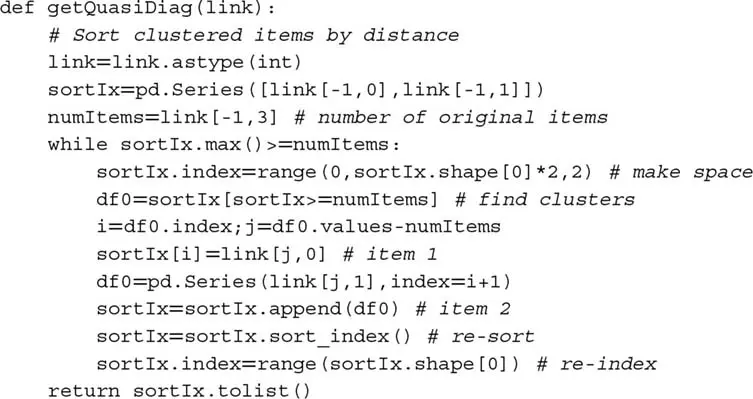
该阶段重新组织协方差矩阵的行和列,使最大值沿对角线排列。协方差矩阵的这种准对角化(不要求基变换)呈现了一个有用的属性:相似的投资被放在一起,不相似的投资被放在远处(示例见图 16.5 和 16.6)。算法如下工作:我们知道链接矩阵的每一行将两个分支合并为一个。我们递归地用其成分替换 (yN−1,1, yN−1,2) 中的聚类,直到没有聚类剩余。这些替换保持了聚类的顺序。输出是原始(未聚类)项目的排序列表。该逻辑在代码片段 16.2 中实现。
代码片段 16.2 准对角化
16.4.3 递归二分#
阶段 2 交付了一个准对角矩阵。反方差配置对于对角协方差矩阵是最优的(证明见附录 16.A.2)。我们可以以两种不同方式利用这些事实:(1) 自下而上,将连续子集的方差定义为反方差配置的方差;(2) 自上而下,按相邻子集聚合方差的反比例拆分配置。以下算法形式化了该思想:
- 算法初始化为:
- 设置项目列表:L = {L
0},其中 L0= {n}n=1,...,N - 为所有项目分配单位权重:w
n= 1,∀n = 1, ..., N
- 设置项目列表:L = {L
- 如果 |L
i| = 1,∀Li∈ L,则停止。 - 对于每个 |L
i| > 1 的 Li∈ L:- 将 L
i二分为两个子集,Li^(1)^ ∪ Li^(2)^ = Li,其中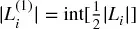 ,且顺序保持
- 定义 L
i^(j)^(j = 1, 2)的方差为二次型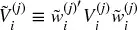 ,其中 V
i^(j)^ 是 Li^(j)^ 二分成分之间的协方差矩阵,且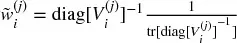 ,其中 diag[·] 和 tr[·] 是对角和迹算子
- 计算拆分因子:
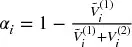 ,使 0 ≤ α
i≤ 1 - 将 L
i^(1)^ 中 ∀n 的配置 wn按 αi因子重新缩放 - 将 L
i^(2)^ 中 ∀n 的配置 wn按 (1 − αi) 因子重新缩放
- 将 L
- 循环到步骤 2
步骤 3b 自下而上利用准对角化,因为它使用反方差权重  定义分区 L
i^(j)^ 的方差。步骤 3c 自上而下利用准对角化,因为它按聚类方差的反比例拆分权重。该算法保证 0 ≤ wi ≤ 1,∀i = 1, ..., N,且  ,因为在每次迭代中我们拆分从更高层次级别接收的权重。约束可以在此阶段轻松引入,通过根据用户偏好替换步骤 3c、3d 和 3e 中的方程。阶段 3 在代码片段 16.3 中实现。
代码片段 16.3 递归二分
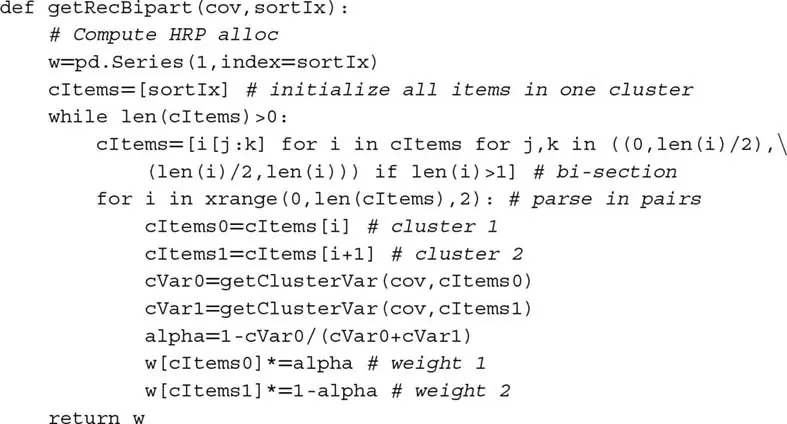
这结束了 HRP 算法的首次描述,它在最佳情况下确定性对数时间 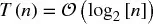 和最坏情况下确定性线性时间
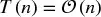 内解决配置问题。接下来,我们将把学到的知识付诸实践,并评估该方法的样本外精度。
16.5 数值示例#
我们首先模拟一个观测矩阵 X,阶为 (10000×10)。相关矩阵在图 16.4 中可视化为热图。图 16.5 显示了所得聚类的树状图(阶段 1)。图 16.6 显示了根据识别的聚类重新组织为块的同一相关矩阵(阶段 2)。附录 16.A.3 提供了用于生成此数值示例的代码。
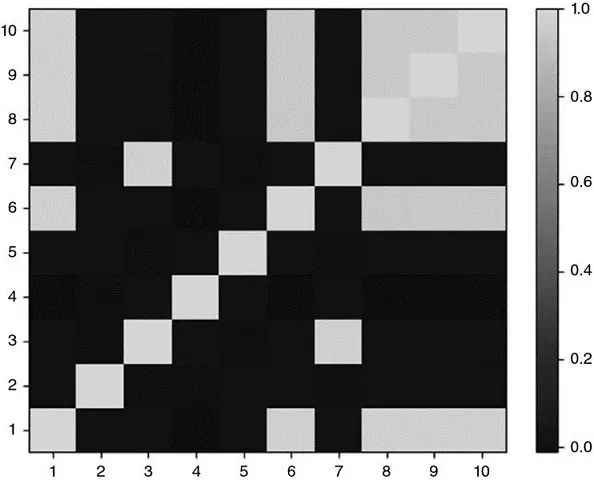
图 16.4 原始协方差矩阵热图
此相关矩阵使用代码片段 16.4 的 generateData 函数计算。最后五列与前五个序列部分相关。
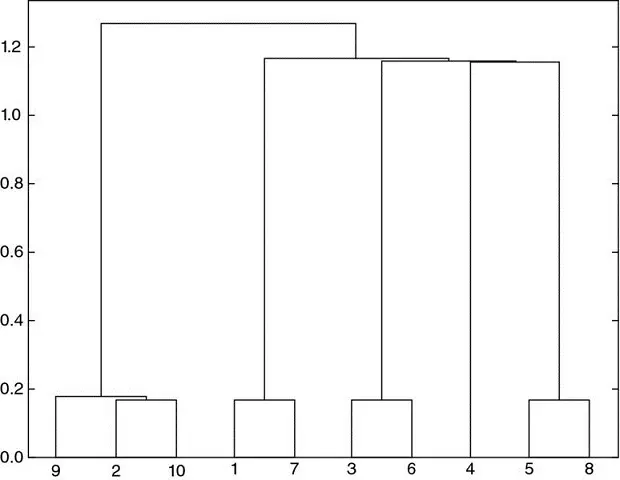
图 16.5 聚类形成的树状图
聚类程序正确识别了序列 9 和 10 是序列 2 的扰动,因此 (9, 2, 10) 被聚类在一起。类似地,7 是 1 的扰动,6 是 3 的扰动,8 是 5 的扰动。唯一没有被扰动的原始项目是 4,这是聚类算法没有找到相似性的唯一项目。
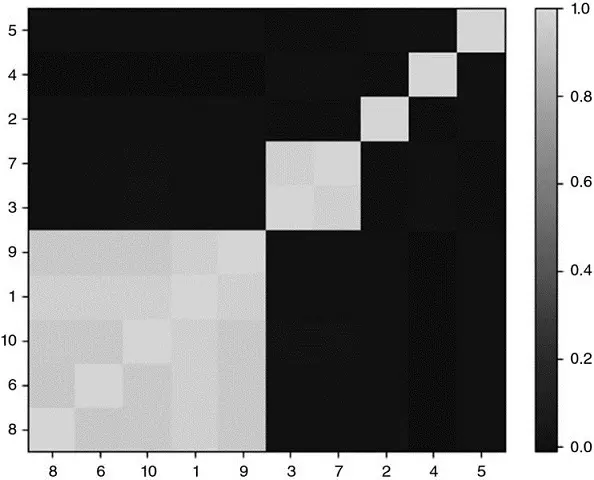
图 16.6 聚类协方差矩阵
阶段 2 准对角化相关矩阵,使最大值沿对角线排列。然而,与 PCA 或类似程序不同,HRP 不要求基变换。HRP 稳健地解决配置问题,同时使用原始投资。
在此随机数据上,我们计算 HRP 的配置(阶段 3),并将其与两种竞争方法的配置进行比较:(1) 二次优化,以 CLA 的最小方差投资组合为代表(有效前沿中唯一不依赖收益均值的市场组合);(2) 传统风险平价,以反方差投资组合(IVP)为例。CLA 的全面实现见 Bailey 和 López de Prado [2013],IVP 的推导见附录 16.A.2。我们应用标准约束 0 ≤ wi ≤ 1(非负性),∀i = 1, ..., N,且  (满仓投资)。顺便说一句,本例中协方差矩阵的条件数仅为 150.9324,不算特别高,因此对 CLA 不利。
从表 16.1 的配置中,我们可以看到几个风格化特征:第一,CLA 将 92.66% 的配置集中在前五大持仓上,而 HRP 仅集中 62.57%。第二,CLA 对 3 个投资分配零权重(如果没有 0 ≤ wi 约束,配置将为负)。第三,HRP 似乎在 CLA 的集中解和传统风险平价的 IVP 配置之间找到了折衷。读者可以使用附录 16.A.3 中的代码验证这些发现通常适用于替代的随机协方差矩阵。
表 16.1 三种配置的比较
| 权重 # | CLA | HRP | IVP |
|---|---|---|---|
| 1 | 14.44% | 7.00% | 10.36% |
| 2 | 19.93% | 7.59% | 10.28% |
| 3 | 19.73% | 10.84% | 10.36% |
| 4 | 19.87% | 19.03% | 10.25% |
| 5 | 18.68% | 9.72% | 10.31% |
| 6 | 0.00% | 10.19% | 9.74% |
| 7 | 5.86% | 6.62% | 9.80% |
| 8 | 1.49% | 9.10% | 9.65% |
| 9 | 0.00% | 7.12% | 9.64% |
| 10 | 0.00% | 12.79% | 9.61% |
三种方法的特征性结果:CLA 将权重集中在少数投资上,因此暴露于特质性冲击。IVP 将权重均匀分布在所有投资上,忽略相关结构。这使其容易受到系统性冲击。HRP 在分散到所有投资和分散到聚类之间找到折衷,这使其对两种冲击都更具韧性。
驱动 CLA 极端集中的是其最小化投资组合风险的目标。然而,两个投资组合的标准差非常相似(σHRP = 0.4640,σCLA = 0.4486)。因此 CLA 为了微小的风险降低而丢弃了一半的投资宇宙。现实当然是 CLA 的投资组合具有欺骗性的分散化,因为影响前五大配置的任何困境情况对 CLA 的负面影响将远大于 HRP 的投资组合。
16.6 样本外蒙特卡洛模拟#
在我们的数值示例中,CLA 的投资组合样本内风险低于 HRP。然而,样本内方差最小的投资组合不一定是样本外方差最小的。我们挑选一个 HRP 优于 CLA 和 IVP 的特定历史数据集太容易了(见 Bailey 和 López de Prado [2014],并回忆我们在第 11 章中对选择偏差的讨论)。相反,在本节中,我们遵循第 13 章中解释的回测范式,通过蒙特卡洛评估 HRP 相对于 CLA 最小方差和传统风险平价 IVP 配置的样本外表现。这也将帮助我们理解什么特征使一种方法优于其他方法,无论轶事性的反例。
第一,我们生成 10 个随机高斯收益序列(520 个观测,相当于 2 年的日度历史),均值为 0,标准差为 10%。真实价格频繁跳跃(Merton [1976]),收益不是横截面独立的,因此我们必须向生成的数据添加随机冲击和随机相关结构。第二,我们回顾 260 个观测(一年日度历史)计算 HRP、CLA 和 IVP 投资组合。这些投资组合每 22 个观测(相当于月度频率)重新估计和再平衡。第三,我们计算与这三个投资组合关联的样本外收益。该程序重复 10000 次。
所有投资组合的样本外平均收益基本为 0,如预期。关键差异来自样本外投资组合收益的方差:σ²CLA = 0.1157、σ²IVP = 0.0928、σ²HRP = 0.0671。虽然 CLA 的目标是提供最低方差(即其优化程序的目标),但它的表现在样本外恰好方差最高,比 HRP 高 72.47%。这一实验发现与 De Miguel 等 [2009] 的历史证据一致。换言之,HRP 将 CLA 策略的样本外夏普比率提高约 31.3%,这是一个相当显著的提升。假设协方差矩阵为对角给 IVP 带来了一些稳定性;然而,其方差仍比 HRP 高 38.24%。这种样本外的方差降低对风险平价投资者至关重要,因为他们使用了大量杠杆。样本内与样本外表现的更广泛讨论见 Bailey 等 [2014]。
HRP 优于 Markowitz 的 CLA 和传统风险平价 IVP 的数学证明有些复杂,超出了本章范围。用直觉术语,我们可以如下理解上述经验结果:影响特定投资的冲击惩罚 CLA 的集中。涉及多个相关投资的冲击惩罚 IVP 对相关结构的忽视。HRP 通过在分散到所有投资和分散到多个层次级别的投资聚类之间找到折衷,为共同冲击和特质性冲击提供了更好的保护。图 16.7 绘制了 10000 次运行中第一次的配置时间序列。
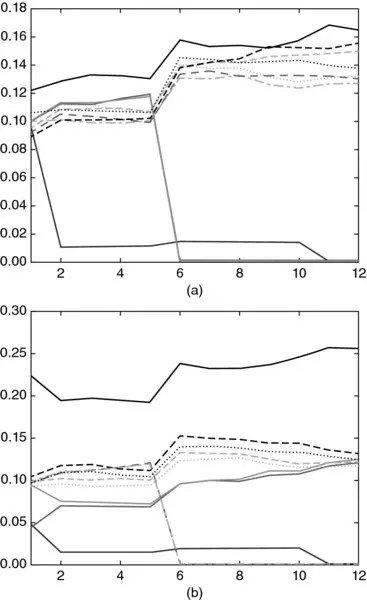
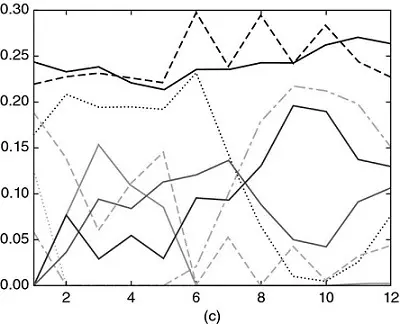
图 16.7 (a) IVP 配置时间序列。在第一次和第二次再平衡之间,一个投资受到特质性冲击,增加了其方差。IVP 的响应是减少对该投资的配置,并将该前敞口分散到所有其他投资。在第五次和第六次再平衡之间,两个投资受到共同冲击。IVP 的响应相同。结果,七个未受影响投资之间的配置随时间增长,无论其相关性如何。
(b) HRP 配置时间序列。HRP 对特质性冲击的响应是减少受影响投资的配置,并使用该减少的金额增加对未受影响的相关投资的配置。作为对共同冲击的响应,HRP 减少受影响投资的配置并增加对不相关(方差较低)投资的配置。
(c) CLA 配置时间序列。CLA 配置对特质性和共同冲击的反应不稳定。如果我们考虑了再平衡成本,CLA 的表现将非常负面。
附录 16.A.4 提供了实现上述研究的 Python 代码。读者可以尝试不同的参数配置并得出类似结论。特别是,HRP 的样本外优势在更大的投资宇宙中、添加更多冲击时、考虑更强相关结构时或考虑再平衡成本时变得更加显著。每次 CLA 再平衡都会产生交易成本,随着时间推移可能累积成禁止性损失。
16.7 进一步研究#
本章介绍的方法灵活、可扩展,并允许相同思想的多种变体。使用提供的代码,读者可以研究和评估什么 HRP 配置最适合其特定问题。例如,在阶段 1 他们可以应用 di,j、 和
 的替代定义,或不同的聚类算法(如双聚类);在阶段 3,他们可以使用不同的
 和 α 函数,或替代的配置约束。阶段 3 也可以使用阶段 1 的聚类自上而下拆分配置,而不是进行递归二分。
将预测收益、Ledoit-Wolf 收缩和 Black-Litterman 风格的观点纳入此层次方法相对简单。事实上,好奇的读者可能已经意识到,HRP 在其核心本质上是一个避免矩阵求逆的稳健程序,HRP 背后的相同思想可以用来替代许多以其不稳定输出著称的计量经济回归方法(如 VAR 或 VECM)。图 16.8 显示了固定收益证券的大型相关矩阵 (a) 聚类前和 (b) 聚类后,有超过 210 万个条目。传统优化或计量经济方法无法识别金融大数据的层次结构,数值不稳定性击败了分析的好处,导致不可靠和有害的结果。
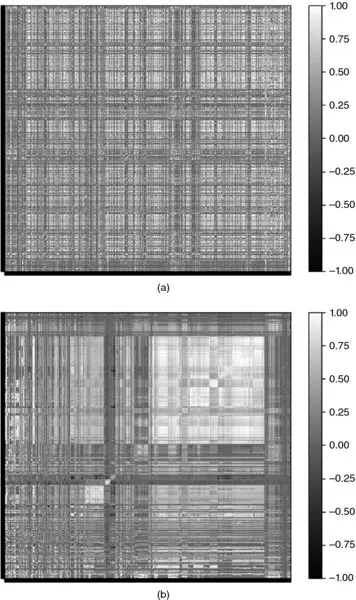
图 16.8 聚类前后的相关矩阵
本章描述的方法可以应用于优化以外的问题。例如,大型固定收益宇宙的 PCA 分析遭受我们为 CLA 描述的相同缺陷。几十年甚至几个世纪前开发的小数据技术(因子模型、回归分析、计量经济学)无法识别金融大数据的层次本质。
Kolanovic 等 [2017] 对 HRP 进行了长期研究,得出结论:「HRP 提供了卓越的风险调整收益。虽然 HRP 和 MV 投资组合都提供最高收益,但 HRP 投资组合比 MV 投资组合更好地匹配波动率目标。我们还进行了模拟研究以确认我们发现的稳健性,其中 HRP 始终提供优于 MV 和其他基于风险的策略的表现 [...] HRP 投资组合真正分散化,具有更多不相关敞口和更少极端权重及风险配置。」
Raffinot [2017] 得出结论:「经验结果表明,基于层次聚类的投资组合是稳健的、真正分散化的,并实现了比常用投资组合优化技术统计上更好的风险调整表现。」
16.8 结论#
精确的解析解可能比近似的 ML 解表现差得多。虽然数学上正确,但二次优化器(特别是 Markowitz 的 CLA)由于不稳定性、集中性和表现不佳而已知提供通常不可靠的解。这些问题的根本原因是二次优化器需要协方差矩阵的逆。Markowitz 的诅咒是:投资越相关,分散化投资组合的需求越大,然而该投资组合的估计误差也越大。
在本章中,我们揭示了二次优化器不稳定的一个主要来源:大小为 N 的矩阵与一个有  条边的完全图关联。由于如此多的边连接图的节点,权重被允许以完全自由的方式再平衡。这种层次结构的缺乏意味着小的估计误差将导致完全不同的解。HRP 用树结构替换协方差结构,实现了三个目标:(1) 与传统风险平价方法不同,它完全利用协方差矩阵中包含的信息;(2) 恢复了权重的稳定性;(3) 解在构造上是直观的。该算法在确定性对数(最佳情况)或线性(最坏情况)时间内收敛。
HRP 稳健、可视化且灵活,允许用户引入约束或操作树结构而不损害算法的搜索。这些性质源自 HRP 不要求协方差可逆的事实。事实上,HRP 可以在病态退化甚至奇异协方差矩阵上计算投资组合。
本章专注于投资组合构建应用;然而,读者会发现在不确定性下做决策的其他实际用途,特别是在接近奇异协方差矩阵的情况下:投资组合经理的资本配置、算法策略间的配置、机器学习信号的 bagging 和 boosting、随机森林的预测、不稳定计量经济模型(VAR、VECM)的替代等。
当然,像 CLA 这样的二次优化器在样本内产生最小方差投资组合(即其目标函数)。蒙特卡洛实验表明 HRP 在样本外提供比 CLA 或传统风险平价方法(IVP)更低的方差。自 Bridgewater 在 1990 年代开创风险平价以来,一些最大的资产管理公司推出了遵循此方法的基金,合计资产超过 5000 亿美元。鉴于其大量使用杠杆,这些基金应受益于采用更稳定的风险平价配置方法,从而实现卓越的风险调整收益和更低的再平衡成本。
附录#
16.A.1 基于相关的度量
考虑两个大小为 T 的实值向量 X、Y 和相关变量 ρ[x,y],唯一要求是 σ[x,y] = ρ[x,y]σ[X]σ[Y],其中 σ[x,y] 是两个向量之间的协方差,σ[·] 是标准差。注意 Pearson 相关不是唯一满足这些要求的相关。
让我们证明 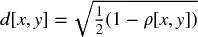 是一个真正的度量。第一,两个向量之间的欧几里得距离为
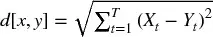 。第二,我们将这些向量 z 标准化为
 、
 。因此,0 ≤ ρ[x,y] = ρ[x,y]。第三,我们推导欧几里得距离 d[x,y] 为,
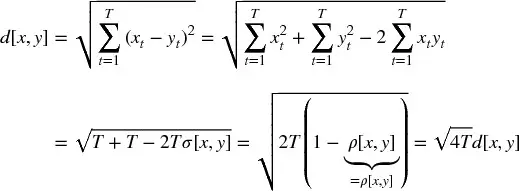
换言之,距离 d[x,y] 是向量 {X, Y} 在 z 标准化后欧几里得距离的线性倍数,因此它继承了欧几里得距离的真正度量属性。
类似地,我们可以证明 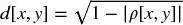 下降到
 /2
 商上的真正度量。为此,我们重新定义
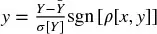 ,其中 sgn[·] 是符号算子,使 0 ≤ ρ[x,y] = |ρ[x,y]|。则
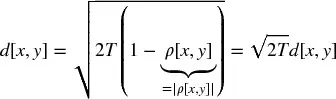
16.A.2 反方差配置
阶段 3(见第 16.4.3 节)按子集方差的反比例拆分权重。我们现在证明当协方差矩阵为对角时,该配置是最优的。考虑标准的二次优化问题,大小为 N,
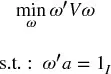
解为  。对于特征向量 a = 1
N,解是最小方差投资组合。如果 V 是对角的,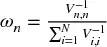 。在 N = 2 的特殊情况下,
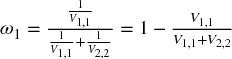 ,这就是阶段 3 如何在子集的两个二分之间拆分权重。
16.A.3 复现数值示例
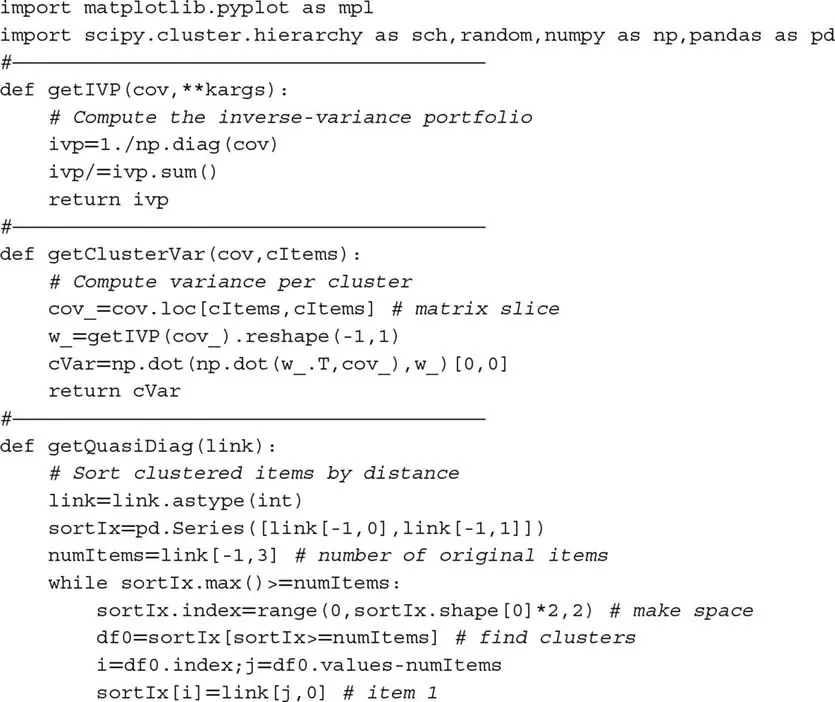
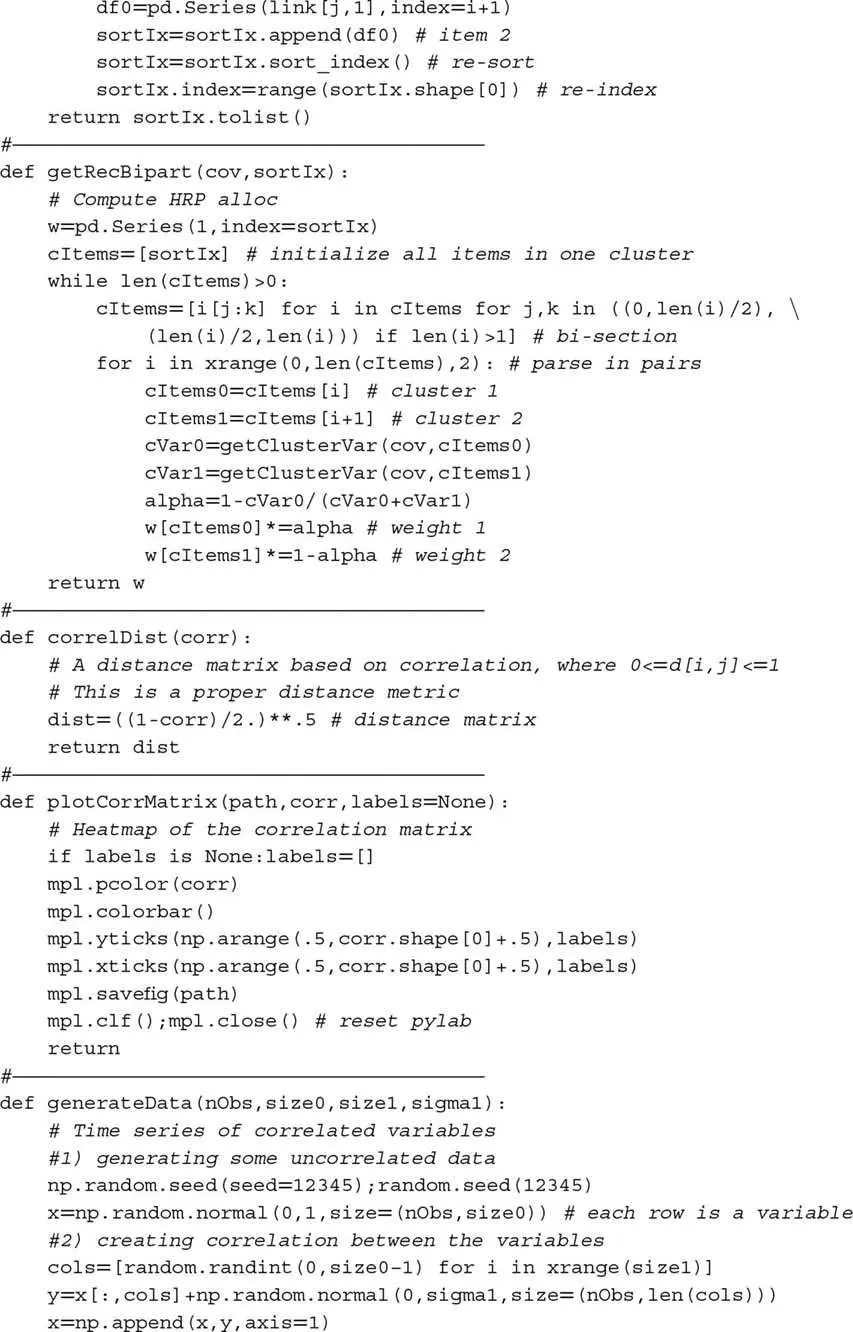
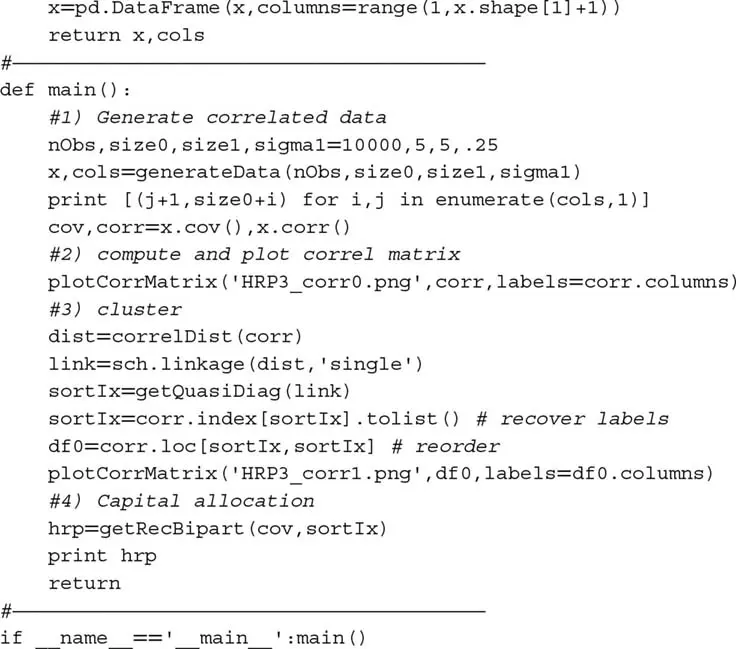
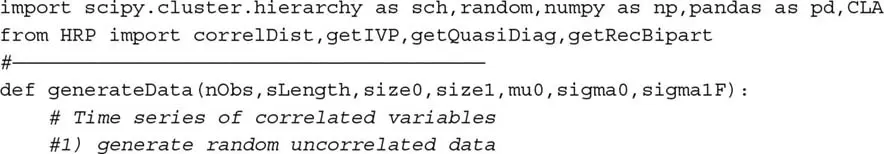
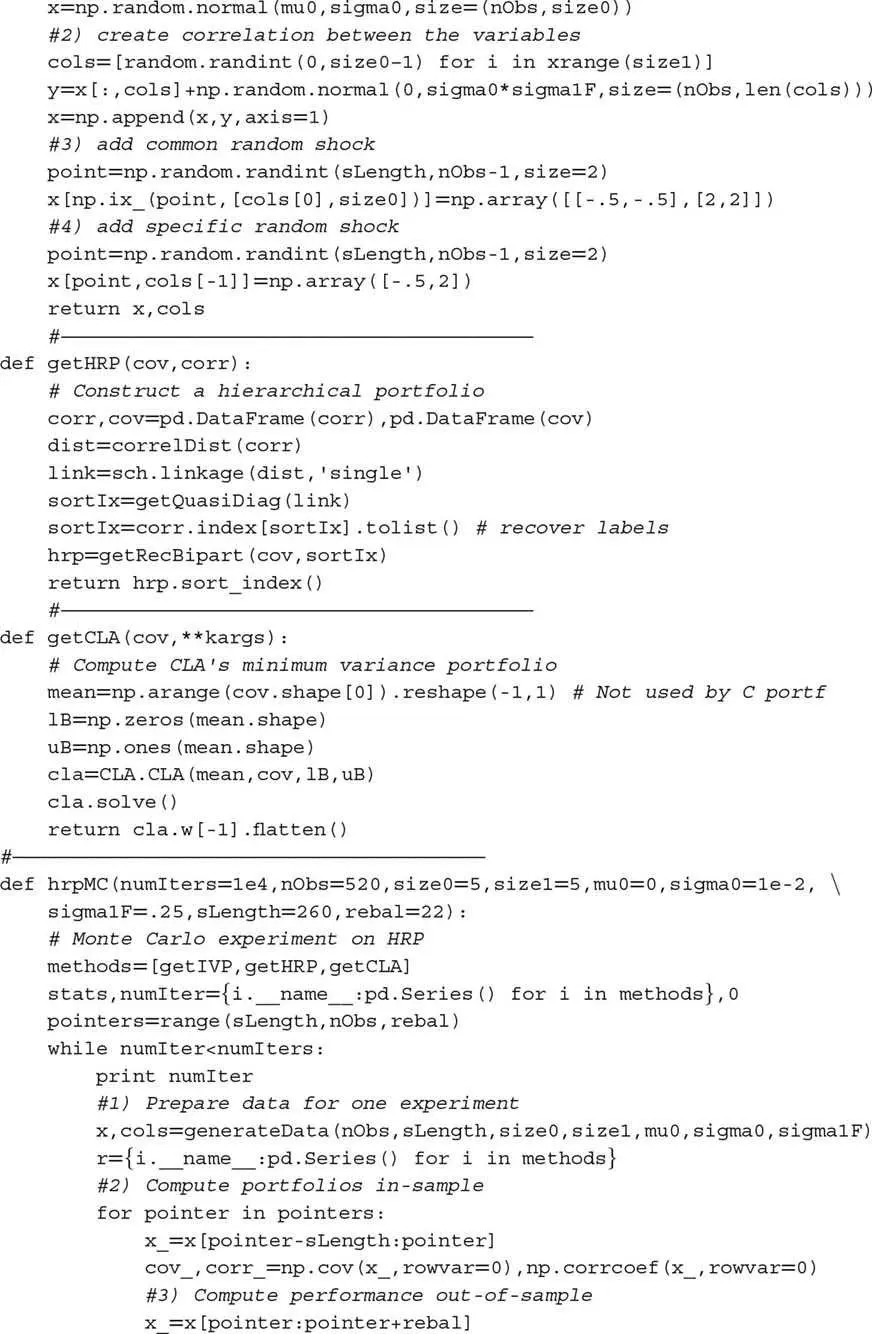
代码片段 16.4 可用于复现我们的结果并模拟额外的数值示例。函数 generateData 产生一个时间序列矩阵,其中 size0 个向量不相关,size1 个向量相关。读者可以更改 generateData 中的 np.random.seed 来运行替代示例并获得 HRP 如何工作的直觉。Scipy 的 linkage 函数可用于执行阶段 1(第 16.4.1 节),函数 getQuasiDiag 执行阶段 2(第 16.4.2 节),函数 getRecBipart 执行阶段 3(第 16.4.3 节)。
代码片段 16.4 HRP 算法的完整实现
16.A.4 复现蒙特卡洛实验
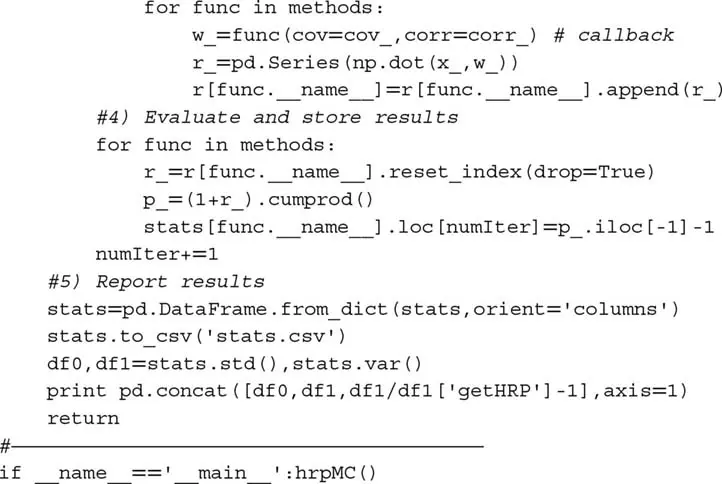
代码片段 16.5 实现了三种配置方法的蒙特卡洛实验:HRP、CLA 和 IVP。所有库都是标准的,除了 HRP(在附录 16.A.3 中提供)和 CLA(可在 Bailey 和 López de Prado [2013] 中找到)。子程序 generateData 模拟相关数据,有两种随机冲击:多种投资共有的和特定于单一投资的。每种类型有两个冲击,一正一负。实验变量设为 hrpMC 的参数。它们是任意选择的,用户可以尝试替代组合。
代码片段 16.5 HRP 样本外表现的蒙特卡洛实验
练习题#
给定 N 个投资策略的 PnL 序列:
- 将它们对齐到下注的平均频率(例如,周度交易的策略使用周度观测)。提示:这种数据对齐有时称为「下采样」。
- 计算其收益的协方差 V。
- 识别 N 个策略间的层次聚类。
- 绘制 N 个策略的聚类相关矩阵。
使用练习 1 的聚类协方差矩阵 V:
- 计算 HRP 配置。
- 计算 CLA 配置。
- 计算 IVP 配置。
使用练习 1 的协方差矩阵 V:
- 执行谱分解:VW = WΛ。
- 从 U[0, 1] 分布中抽取 N 个随机数形成数组 ϵ。
- 形成 N×N 矩阵
 ,其中
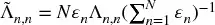 ,n = 1, ..., N。
- 计算
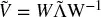 。
- 重复练习 2,这次使用
 作为协方差矩阵。哪种配置方法受谱方差重新缩放的影响最大?
你将如何修改 HRP 算法以产生加总为 0 的配置,其中 |w
n| ≤ 1,∀n = 1, ..., N?你能想到一种将期望收益纳入 HRP 配置的简单方法吗?
参考文献#
- Bailey, D. and M. López de Prado (2012): "Balanced baskets: A new approach to trading and hedging risks." Journal of Investment Strategies, Vol. 1, No. 4, pp. 21--62.
- Bailey, D. and M. López de Prado (2013): "An open-source implementation of the critical-line algorithm for portfolio optimization." Algorithms, Vol. 6, No. 1, pp. 169--196.
- Bailey, D., J. Borwein, M. López de Prado, and J. Zhu (2014): "Pseudo-mathematics and financial charlatanism." Notices of the American Mathematical Society, Vol. 61, No. 5, pp. 458--471.
- Bailey, D. and M. López de Prado (2014): "The deflated Sharpe ratio." Journal of Portfolio Management, Vol. 40, No. 5, pp. 94--107.
- Black, F. and R. Litterman (1992): "Global portfolio optimization." Financial Analysts Journal, Vol. 48, pp. 28--43.
- Brualdi, R. (2010): "The mutually beneficial relationship of graphs and matrices." CBMS Regional Conference Series in Mathematics, Nr. 115.
- Calkin, N. and M. López de Prado (2014): "Stochastic flow diagrams." Algorithmic Finance, Vol. 3, No. 1, pp. 21--42.
- Calkin, N. and M. López de Prado (2014): "The topology of macro financial flows." Algorithmic Finance, Vol. 3, No. 1, pp. 43--85.
- Clarke, R., H. De Silva, and S. Thorley (2002): "Portfolio constraints and the fundamental law of active management." Financial Analysts Journal, Vol. 58, pp. 48--66.
- De Miguel, V., L. Garlappi, and R. Uppal (2009): "Optimal versus naive diversification." Review of Financial Studies, Vol. 22, pp. 1915--1953.
- Jurczenko, E. (2015): Risk-Based and Factor Investing, 1st ed. Elsevier Science.
- Kolanovic, M., A. Lau, T. Lee, and R. Krishnamachari (2017): "Cross asset portfolios of tradable risk premia indices." J.P. Morgan, April 26.
- Kolm, P., R. Tutuncu and F. Fabozzi (2014): "60 years of portfolio optimization." European Journal of Operational Research, Vol. 234, No. 2, pp. 356--371.
- Kuhn, H. W. and A. W. Tucker (1951): "Nonlinear programming." Proceedings of 2nd Berkeley Symposium. Berkeley, pp. 481--492.
- Markowitz, H. (1952): "Portfolio selection." Journal of Finance, Vol. 7, pp. 77--91.
- Merton, R. (1976): "Option pricing when underlying stock returns are discontinuous." Journal of Financial Economics, Vol. 3, pp. 125--144.
- Michaud, R. (1998): Efficient Asset Allocation, 1st ed. Harvard Business School Press.
- Ledoit, O. and M. Wolf (2003): "Improved estimation of the covariance matrix of stock returns." Journal of Empirical Finance, Vol. 10, No. 5, pp. 603--621.
- Raffinot, T. (2017): "Hierarchical clustering based asset allocation." Journal of Portfolio Management, forthcoming.
- Rokach, L. and O. Maimon (2005): "Clustering methods," in Data Mining and Knowledge Discovery Handbook. Springer, pp. 321--352.
注释#
^1^ 本章的简短版本发表在 Journal of Portfolio Management, Vol. 42, No. 4, pp. 59--69, 2016 年夏季。
^2^ 更多度量见: