合成数据回测#
13.1 动机#
在本章中,我们将研究一种替代回测方法,它使用历史来生成具有从观测数据估计的统计特征的合成数据集。这将允许我们在大量未见过的合成测试集上回测策略,从而降低策略被拟合到特定数据点集的可能性。^1^ 这是一个非常广泛的主题,为了达到一定深度,我们将专注于交易规则的回测。
13.2 交易规则#
投资策略可以定义为假定市场低效存在的算法。一些策略依赖计量经济学模型来预测价格,使用 GDP 或通胀等宏观经济变量;其他策略使用基本面和会计信息来为证券定价,或在衍生品定价中寻找套利类机会等。例如,假设金融中介机构倾向于在美国国债拍卖前两天卖出旧券,以筹集购买新「票据」所需的现金。人们可以通过在拍卖前三天卖出旧券来从该知识中获利。但如何做?每个投资策略都需要一种实施战术,通常称为「交易规则」。
有数十种对冲基金风格,每种运行数十种独特的投资策略。虽然策略在性质上可能非常异构,但战术相对同质。交易规则提供了进入和退出头寸必须遵循的算法。例如,当策略信号达到某个值时将进入头寸。退出头寸的条件通常通过止盈和止损阈值定义。这些进入和退出规则依赖于通常通过历史模拟校准的参数。这种做法导致了回测过拟合的问题,因为这些参数针对样本内的特定观测,以至于投资策略如此依附于过去,以至于对未来不再适用。
一个重要的澄清是,我们感兴趣的是最大化表现的退出走廊条件。换言之,头寸已经存在,问题是如何最优地退出它。这是执行交易员经常面临的困境,不应与确定投资证券的进入和退出阈值混淆。该替代问题的研究见例如 Bertram [2009]。
Bailey 等 [2014, 2017] 讨论了回测过拟合问题,并提供了确定模拟表现可能在多大程度上因过拟合而膨胀的方法。虽然评估回测过拟合的概率是丢弃多余投资策略的有用工具,但最好能避免过拟合的风险,至少在校准交易规则的上下文中。在理论上,这可以通过直接从生成数据的随机过程推导交易规则的最优参数来实现,而非进行历史模拟。这是我们在本章采取的方法。使用整个历史样本,我们将表征生成观测收益流的随机过程,并在不需要历史模拟的情况下推导交易规则参数的最优值。
13.3 问题#
假设投资策略 S 投资 i = 1, ..., I 个机会或下注。在每个机会 i 处,S 持有 mi 个单位的证券 X,其中 mi ∈ (−∞, ∞)。进入该机会的交易以价值 miPi,0 定价,其中 Pi,0 是 mi 个证券交易的平均单价。当其他市场参与者交易证券 X 时,我们可以在 t 次观测交易后将机会 i 的价值盯市为 miPi,t。这表示如果机会 i 在 t 次交易后以市场观测价格清算时的价值。相应地,我们可以将机会 i 在 t 次交易后的盯市盈亏计算为 πi,t = mi(Pi,t − Pi,0)。
标准交易规则提供了在 t = Ti 时退出机会 i 的逻辑。这在以下两个条件之一得到验证时发生:
 ,其中
 是止盈阈值。
 ,其中
 是止损阈值。
这些阈值等价于我们在元标签(第 3 章)上下文中讨论的水平障碍。因为  ,两个退出条件中只有一个能触发机会 i 的退出。假设机会 i 可以在 T
i 时退出,其最终盈亏为  。在每个机会开始时,目标是实现期望利润
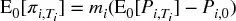 ,其中
 是预测价格,P
i,0 是机会 i 的进入水平。
定义 1(交易规则): 策略 S 的交易规则由参数集
定义。
校准(通过暴力搜索)交易规则的一种方式是:
- 定义 R 的替代值集合,Ω := {R}。
- 在替代值 R ∈ Ω 下历史模拟(回测)S 的表现。
- 选择最优的 R*。
更正式地:
(13.1)
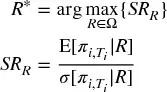
其中 E[·] 和 σ[·] 分别是  在交易规则 R 下、i = 1, ..., I 上的期望值和标准差。换言之,方程 (13.1) 在替代交易规则 R 的空间上最大化 S 在 I 个机会上的夏普比率(夏普比率的定义和分析见 Bailey 和 López de Prado [2012])。因为我们有两个变量在大小为 I 的样本上最大化 SR
R,很容易过拟合 R。一个简单的过拟合发生在一对  针对少数异常值时。Bailey 等 [2017] 提供了回测过拟合的严格定义,可以应用于我们对交易规则的研究,如下。
定义 2(过拟合交易规则): R* 是过拟合的,如果
,其中 j = I+1, ..., J,Me
Ω[·] 是中位数。
直觉上,样本内(IS,i ∈ [1, I])最优交易规则 R* 过拟合,当它被期望在样本外(OOS,j ∈ [I+1, J])表现不如替代交易规则 R ∈ Ω 的中位数。这本质上是我们在第 11 章中用来推导 PBO 的相同定义。Bailey 等 [2014] 认为不过拟合回测很难,特别是当有能够针对 IS 特定观测的自由变量,或 Ω 中元素数量很大时。交易规则引入了这样的自由变量,因为 R* 可以独立于 S 确定。结果是回测从 IS 的随机噪声中获利,使 R* 不适合 OOS 机会。那些作者表明,当 Δπi,t 表现出序列依赖性时,过拟合导致 OOS 负面表现。虽然 PBO 提供了评估回测过拟合程度的有用方法,但首先避免这个问题会更方便。^2^ 为此我们专设以下各节。
13.4 我们的框架#
到目前为止,我们还没有表征观测 πi,t 从中抽取的随机过程。我们感兴趣的是为过拟合最具破坏性的场景找到最优交易规则(OTR),例如 πi,t 表现出序列相关时。特别地,假设价格上的离散 Ornstein-Uhlenbeck(O-U)过程
(13.2)
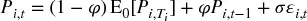
使得随机冲击 IID 分布 ϵi,t ~ N(0, 1)。该过程的种子值为 Pi,0,机会 i 的目标水平为  ,φ 确定 P
i,0 向  收敛的速度。因为 π
i,t = mi(Pi,t − Pi,0),方程 (13.2) 意味着机会 i 的表现由过程
(13.3) 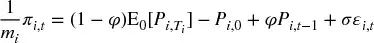
表征。根据 Bailey 和 López de Prado [2013] 中命题 4 的证明,可以证明方程 (13.2) 中指定的过程的分布是参数为
(13.4) 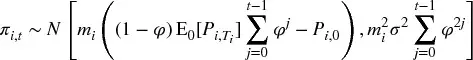
的高斯分布,其平稳性的充分必要条件是 φ ∈ (−1, 1)。给定输入参数集 {σ, φ} 和与机会 i 关联的初始条件 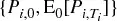 ,是否存在 OTR
 ?类似地,如果策略 S 预测利润目标
 ,我们能否在给定输入值 {σ, φ} 的情况下计算最优止损
 ?如果这些问题的答案是肯定的,就不需要回测来确定 R*,从而避免了过拟合交易规则的问题。在下一节中,我们将展示如何通过实验回答这些问题。
13.5 最优交易规则的数值确定#
在上一节中,我们使用 O-U 规范来表征生成策略 S 收益的随机过程。在本节中,我们将介绍一种数值推导一般规范(特别是 O-U 规范)的 OTR 的程序。
13.5.1 算法#
该算法由五个顺序步骤组成。
步骤 1:我们通过将方程 (13.2) 线性化来估计输入参数 {σ, φ}:
(13.5)
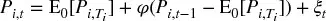
然后我们可以通过排列机会来形成向量 X 和 Y:
(13.6) 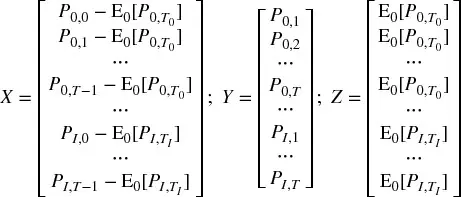
对方程 (13.5) 应用 OLS,我们可以估计原始 O-U 参数为,
(13.7) 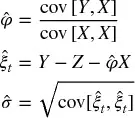
其中 cov[·, ·] 是协方差算子。
- 步骤 2:我们构建止损和止盈对
 的网格。例如,
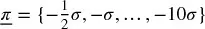 和
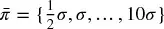 的笛卡尔积给我们 20×20 个节点,每个构成一个替代交易规则 R ∈ Ω。
- 步骤 3:我们应用估计
 为 π
i,t生成大量路径(例如 100000 条)。作为种子值,我们使用与机会 i 关联的观测初始条件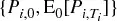 。由于头寸不能无限期持有,我们可以施加最大持有期(例如 100 个观测),届时即使
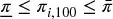 也要退出头寸。该最大持有期等价于三重障碍法(第 3 章)的垂直障碍。^3^
- 步骤 4:我们将步骤 3 生成的 100000 条路径应用于步骤 2 生成的 20×20 网格
 的每个节点。对于每个节点,我们应用止损和止盈逻辑,得到 100000 个
 值。同样,对于每个节点我们计算与该交易规则关联的夏普比率,如方程 (13.1)。夏普比率估计量的置信区间研究见 Bailey 和 López de Prado [2012]。该结果可以三种不同方式使用:步骤 5a、步骤 5b 和步骤 5c。
- 步骤 5a:我们确定在给定输入参数
 和观测初始条件
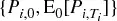 下,交易规则网格中最优的对
 。
- 步骤 5b:如果策略 S 为特定机会 i 提供利润目标
 ,我们可以将该信息与步骤 4 的结果结合,确定最优止损
 。
- 步骤 5c:如果交易员有基金管理对机会 i 施加的最大止损
 ,我们可以将该信息与步骤 4 的结果结合,在止损范围
 内确定最优止盈
 。
Bailey 和 López de Prado [2013] 证明方程 (13.2) 中过程的半衰期为  ,要求 φ ∈ (0, 1)。从该结果,我们可以确定与特定半衰期 τ 关联的 φ 值为
 。
13.5.2 实现#
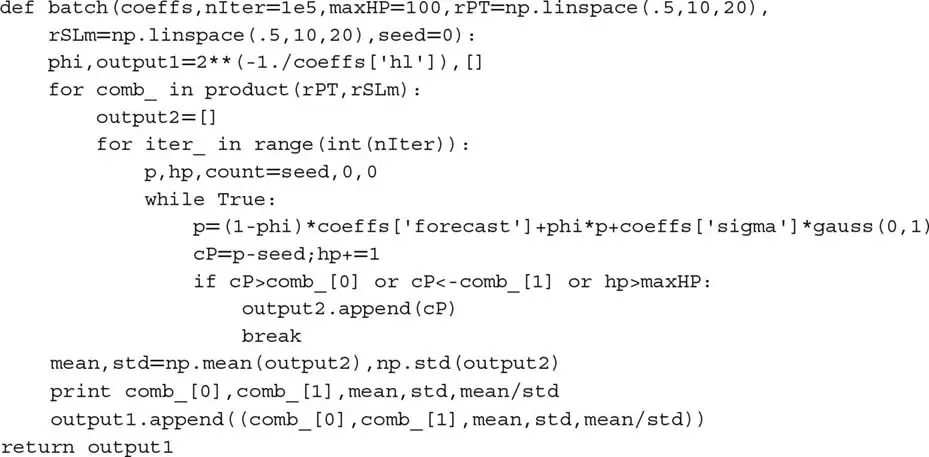
代码片段 13.1 提供了本章进行的实验的 Python 实现。函数 main 产生参数  的笛卡尔积,表征方程 (13.5) 的随机过程。不失一般性,在所有模拟中我们使用 σ = 1。然后,对于每对
 ,函数
batch 计算与各种交易规则关联的夏普比率。
代码片段 13.1 确定最优交易规则的 Python 代码
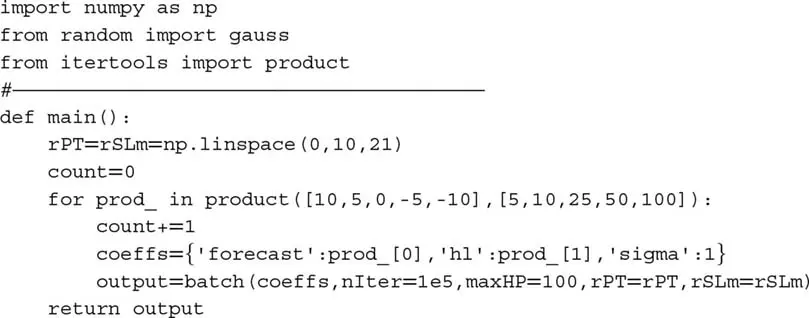
代码片段 13.2 在给定参数对  的情况下,计算 20×20 夏普比率网格,每个交易规则
 对应一个。有一个垂直障碍,因为最大持有期设为 100(
maxHP = 100)。我们固定 Pi,0 = 0,因为驱动收敛的是方程 (13.5) 中的距离 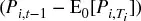 ,而非特定的绝对价格水平。一旦三个障碍中第一个被触及,退出价格被存储,下一次迭代开始。所有迭代完成(1E5)后,可以为该对
 计算夏普比率,算法移动到下一对。当所有交易规则对都处理完毕后,结果报告回
main。该算法可以并行化,类似于我们在第 3 章中对三重障碍法所做的。我们将该任务留作练习。
代码片段 13.2 确定最优交易规则的 Python 代码
13.6 实验结果#
表 13.1 列出了本研究中分析的组合。虽然这些输入参数的不同值会产生不同的数值结果,但所应用的组合允许我们分析最一般的情况。「Forecast」列指  ;「Half-Life」列指 τ;「Sigma」列指 σ;「maxHP」代表最大持有期。
表 13.1 模拟中使用的输入参数组合
| 图 | Forecast | Half-Life | Sigma | maxHP |
|---|---|---|---|---|
| 13.1 | 0 | 5 | 1 | 100 |
| 13.2 | 0 | 10 | 1 | 100 |
| 13.3 | 0 | 25 | 1 | 100 |
| 13.4 | 0 | 50 | 1 | 100 |
| 13.5 | 0 | 100 | 1 | 100 |
| 13.6 | 5 | 5 | 1 | 100 |
| 13.7 | 5 | 10 | 1 | 100 |
| 13.8 | 5 | 25 | 1 | 100 |
| 13.9 | 5 | 50 | 1 | 100 |
| 13.10 | 5 | 100 | 1 | 100 |
| 13.11 | 10 | 5 | 1 | 100 |
| 13.12 | 10 | 10 | 1 | 100 |
| 13.13 | 10 | 25 | 1 | 100 |
| 13.14 | 10 | 50 | 1 | 100 |
| 13.15 | 10 | 100 | 1 | 100 |
| 13.16 | −5 | 5 | 1 | 100 |
| 13.17 | −5 | 10 | 1 | 100 |
| 13.18 | −5 | 25 | 1 | 100 |
| 13.19 | −5 | 50 | 1 | 100 |
| 13.20 | −5 | 100 | 1 | 100 |
| 13.21 | −10 | 5 | 1 | 100 |
| 13.22 | −10 | 10 | 1 | 100 |
| 13.23 | −10 | 25 | 1 | 100 |
| 13.24 | −10 | 50 | 1 | 100 |
| 13.25 | −10 | 100 | 1 | 100 |
在以下图中,我们绘制了各种止盈和止损退出条件组合产生的非年化夏普比率。为简便起见,我们在 y 轴(止损)省略了负号。夏普比率以灰度表示(较浅表示表现更好;较深表示表现更差),格式称为热图。表现 ( ) 按持有单位(m
i = 1)计算,因为 mi 的其他值只是重新缩放表现,对夏普比率没有影响。交易成本可以轻松添加,但出于教育目的,最好不加绘制结果,以便你能欣赏函数的对称性。
13.6.1 零长期均衡的情况#
零长期均衡的情况与做市商的业务一致,他们在价格偏离当前水平会随时间自我修正的假设下提供流动性。τ 越小,自回归系数 ( ) 越小。小的自回归系数结合零期望利润的效果是,大多数对
 产生零表现。
图 13.1 显示了参数组合 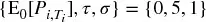 的热图。半衰期如此之小,以至于表现只有在小幅止盈与大幅止损组合的狭窄范围内才能最大化。换言之,最优交易规则是持有库存足够长的时间直到出现小幅利润,即使以经历一些 5 倍或 7 倍的未实现亏损为代价。夏普比率很高,达到约 3.2 的水平。这实际上是许多做市商在实践中所做的,与 Easley 等 [2011] 描述的「非对称收益困境」一致。在这种情况下最差的交易规则是结合短止损和大止盈阈值,做市商在实践中避免的情况。表现在网格的对角线(止盈和止损对称处)最接近中性。使用三重障碍法(第 3 章)标记观测时应记住这个结果。
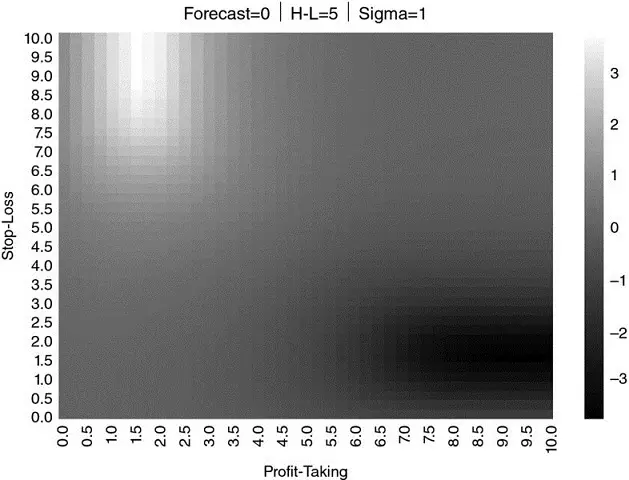
图 13.1 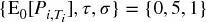 的热图
图 13.2 显示,如果我们将 τ 从 5 增加到 10,最高和最低表现的区域在对  的网格上扩展,而夏普比率下降。这是因为随着半衰期增加,自回归系数的大小也增加(回忆
 ),从而使过程更接近随机游走。
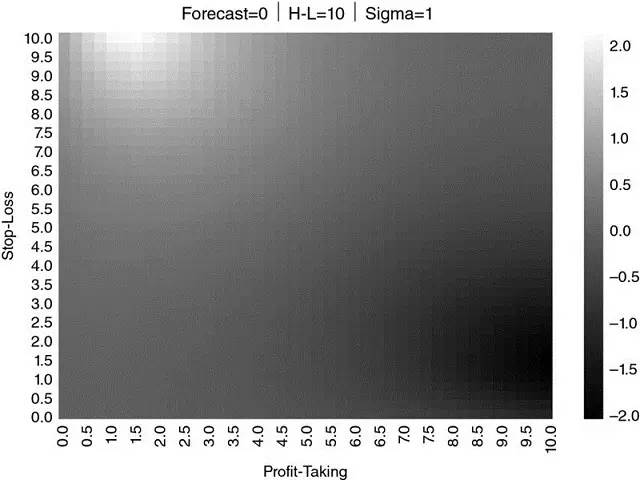
图 13.2 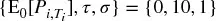 的热图
在图 13.3 中,τ = 25,再次扩展了最高和最低表现的区域,同时降低了夏普比率。图 13.4(τ = 50)和图 13.5(τ = 100)延续了该趋势。最终,随着 φ → 1,没有可以最大化表现的可识别区域。
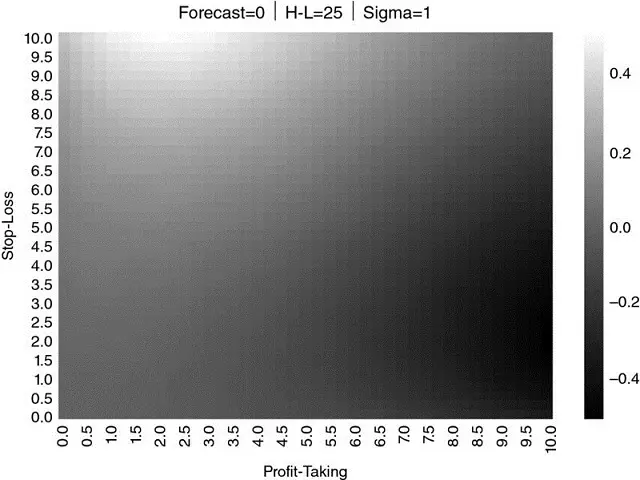
图 13.3 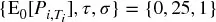 的热图
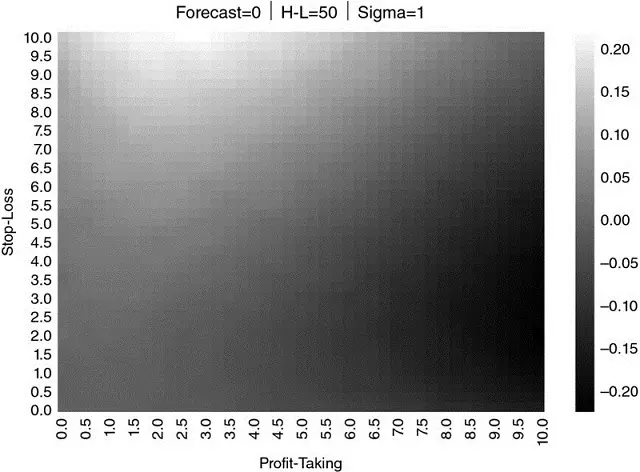
图 13.4 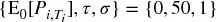 的热图
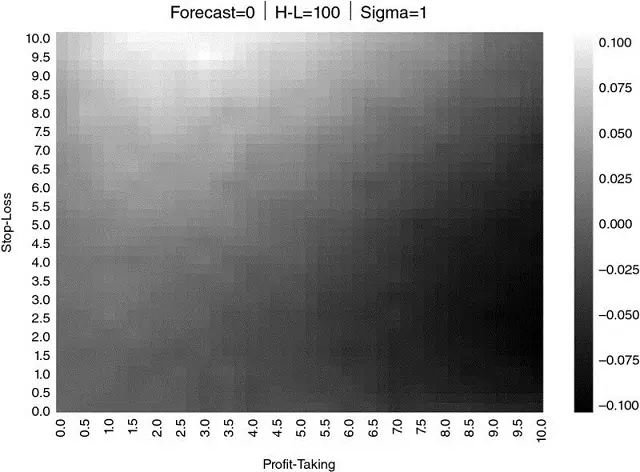
图 13.5 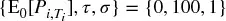 的热图
通过历史模拟在随机游走上校准交易规则将导致回测过拟合,因为会选择碰巧最大化夏普比率的某个随机止盈和止损组合。这就是为什么合成数据回测如此重要:避免因为过去发生了某个统计偶然(单一随机路径)而选择策略。我们的程序通过认识到表现没有一致的模式来防止过拟合,表明没有最优交易规则。
13.6.2 正长期均衡的情况#
正长期均衡的情况与持仓者(如对冲基金或资产管理公司)的业务一致。图 13.6 显示了参数组合 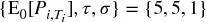 的结果。由于头寸倾向于赚钱,最优止盈高于之前的情况,集中在 6 左右,止损在 4 到 10 之间。最优交易规则的区域呈特征性的矩形形状,是宽止损范围与窄止盈范围组合的结果。表现在所有实验中最高,夏普比率约为 12。
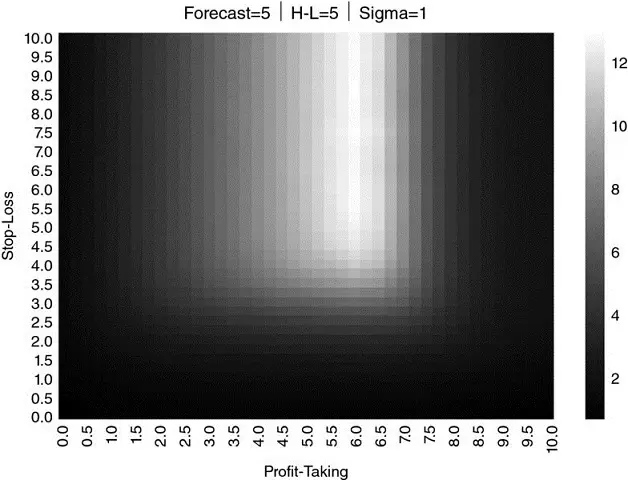
图 13.6 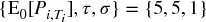 的热图
在图 13.7 中,我们将半衰期从 τ = 5 增加到 τ = 10。现在最优表现在止盈集中在 5 左右时实现,止损在 7 到 10 之间。最优止盈的范围更宽,而最优止损的范围收窄,使之前的矩形区域更接近正方形。同样,更大的半衰期使过程更接近随机游走,因此表现现在相对低于之前,夏普比率约为 9。
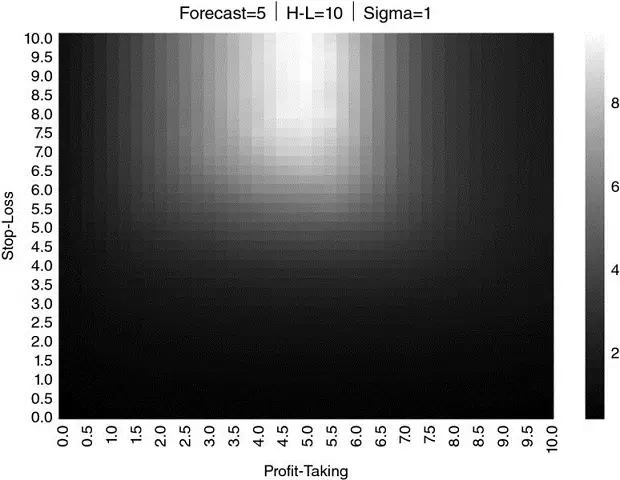
图 13.7 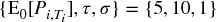 的热图
在图 13.8 中,我们设 τ = 25。最优止盈现在集中在 3 左右,而最优止损在 9 到 10 之间。之前最优表现的正方形区域已让位于小幅止盈与大止损阈值的半圆形。我们再次看到表现恶化,夏普比率为 2.7。
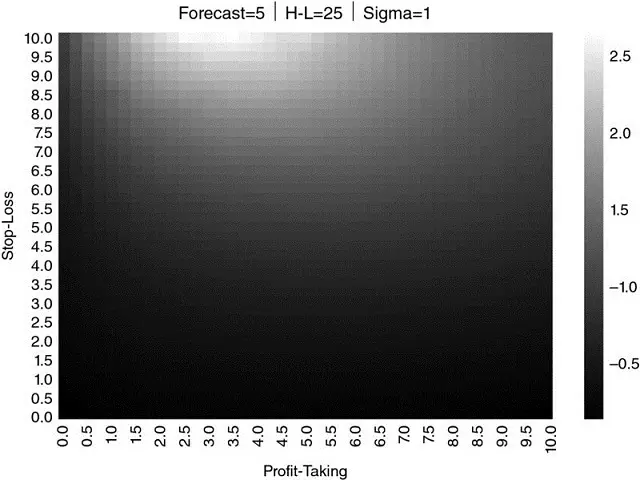
图 13.8 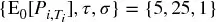 的热图
在图 13.9 中,半衰期提高到 τ = 50。结果,最优表现的区域扩展,夏普比率继续降至 0.8。这与我们在零长期均衡情况下观察到的效果相同(第 13.6.1 节),不同之处在于因为现在  ,没有对称的最差表现区域。
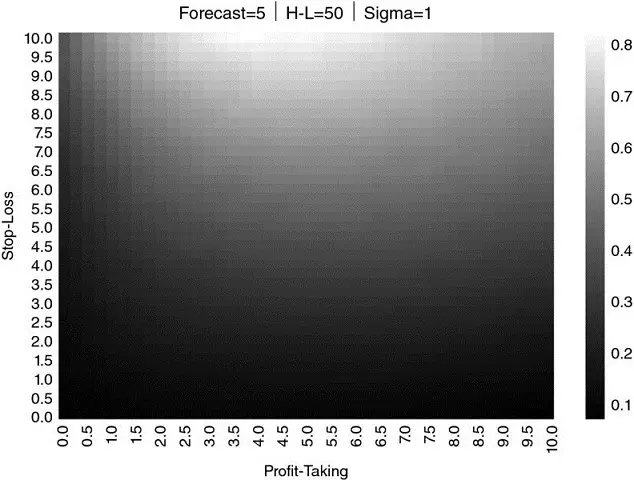
图 13.9 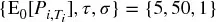 的热图
在图 13.10 中,我们看到 τ = 100 导致上述趋势的自然结论。过程现在如此接近随机游走,最大夏普比率仅为 0.32。
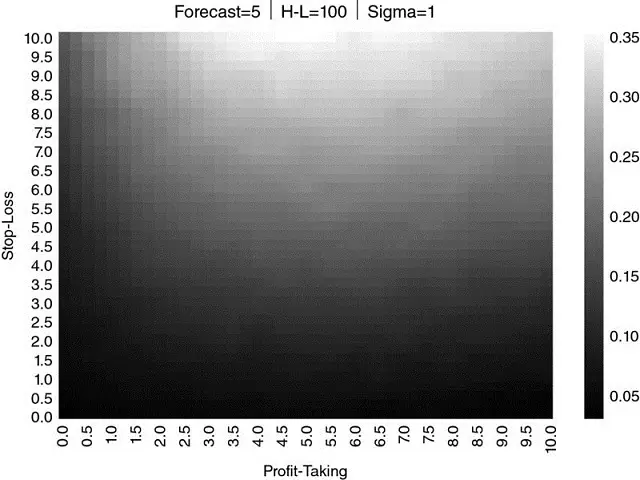
图 13.10 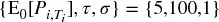 的热图
我们可以在图 13.11 到 13.15 中观察到类似的模式,其中 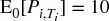 ,τ 分别从 5 递增到 10、25、50 和 100。
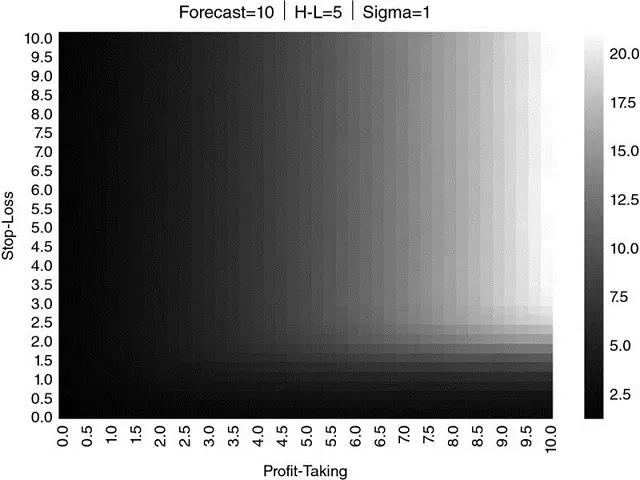
图 13.11 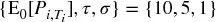 的热图
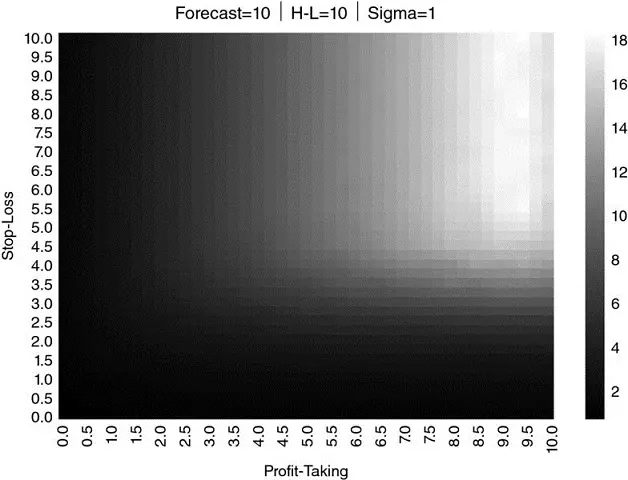
图 13.12 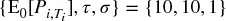 的热图
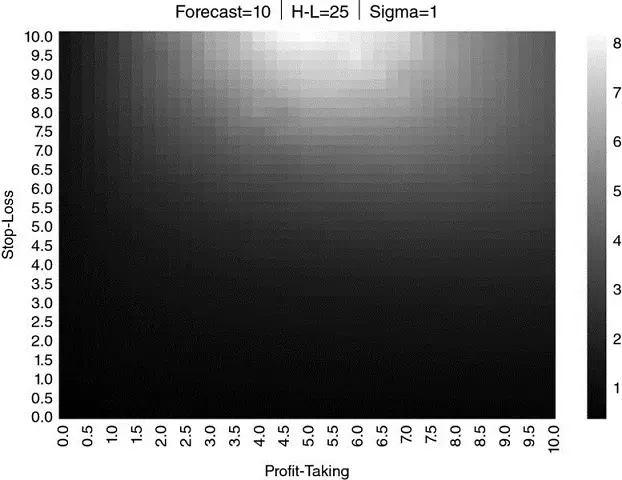
图 13.13 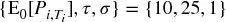 的热图
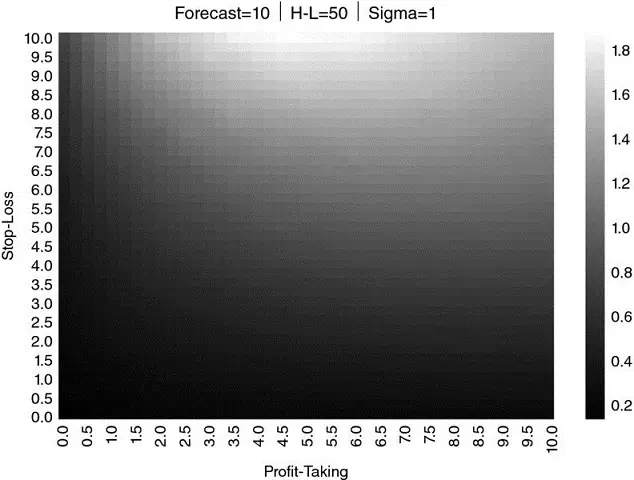
图 13.14 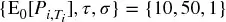 的热图
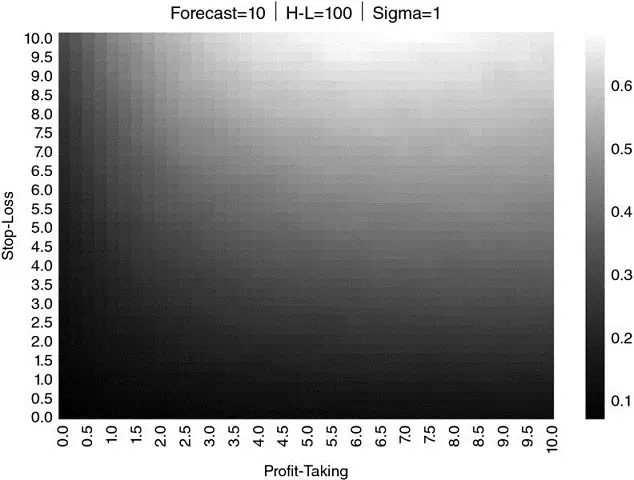
图 13.15 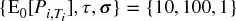 的热图
13.6.3 负长期均衡的情况#
理性的市场参与者不会在假设损失是期望结果的情况下开始头寸。然而,如果交易员认识到损失是预先存在头寸的期望结果,她仍然需要一个策略来止损退出该头寸,同时最小化此类损失。
我们通过应用参数 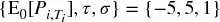 得到了图 13.16。如果我们将图 13.16 与图 13.6 比较,看起来好像一个是另一个的旋转互补。图 13.6 类似于图 13.16 的旋转照相底片。原因是图 13.6 中的利润在图 13.16 中转化为损失,图 13.6 中的损失在图 13.16 中转化为利润。一个情况是另一个的镜像,就像赌徒的损失是庄家的收益一样。
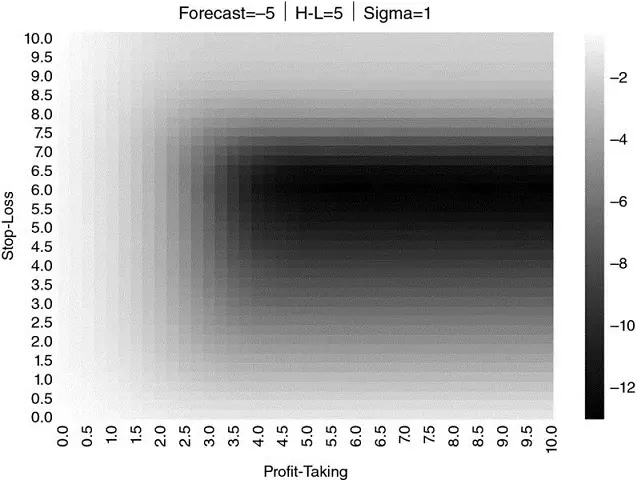
图 13.16 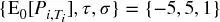 的热图
如预期,夏普比率为负,最差表现区域集中在止损 6 左右,止盈阈值在 4 到 10 之间。现在矩形形状不对应最佳表现区域,而是最差表现区域,夏普比率约为 −12。
在图 13.17 中,τ = 10,现在与随机游走的接近对我们有利。最差表现的区域扩展,矩形区域变为正方形。表现变得不那么负面,夏普比率约为 −9。
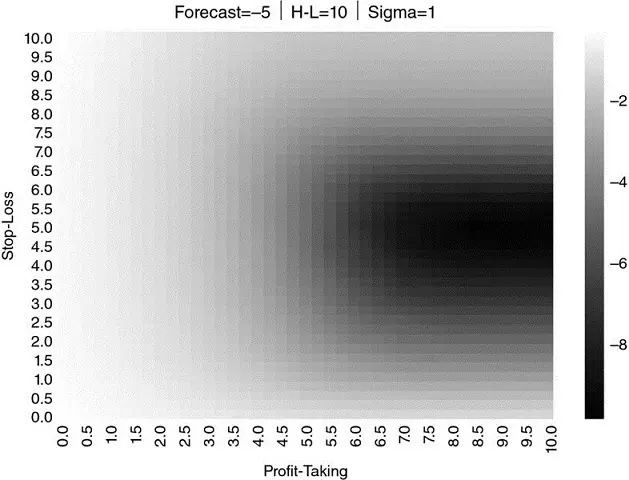
图 13.17 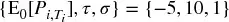 的热图
这个熟悉的趋势可以在图 13.18、13.19 和 13.20 中看到,随着 τ 提高到 25、50 和 100。同样,随着过程接近随机游走,表现趋于平坦,优化交易规则变成回测过拟合练习。
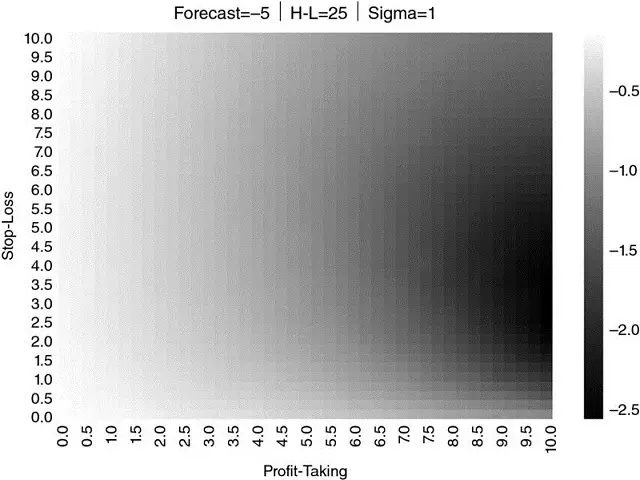
图 13.18 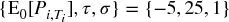 的热图
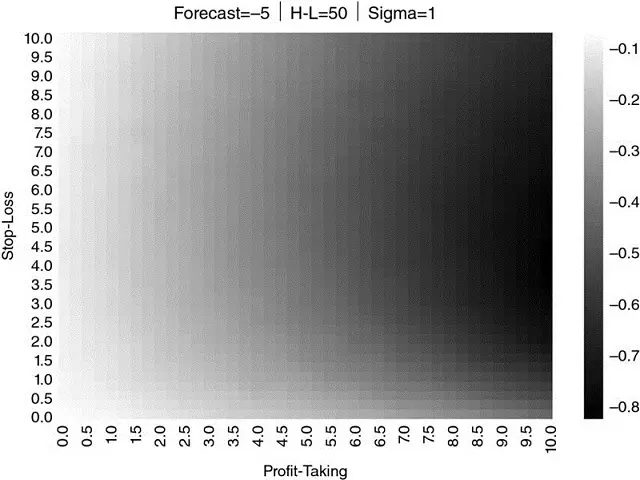
图 13.19 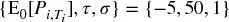 的热图
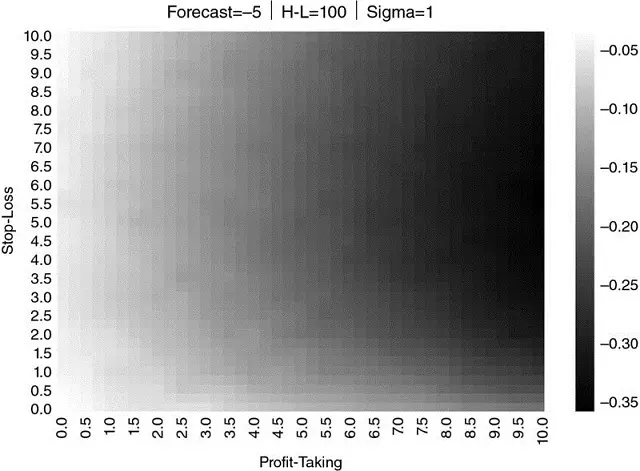
图 13.20 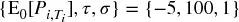 的热图
图 13.21 到 13.25 对 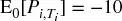 和递增的 τ(从 5 到 10、25、50 和 100)重复了相同的过程。相同的模式——正长期均衡情况的旋转互补——出现。
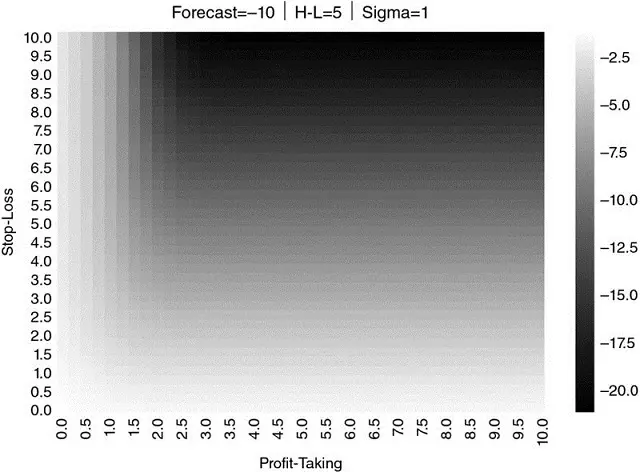
图 13.21 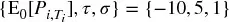 的热图
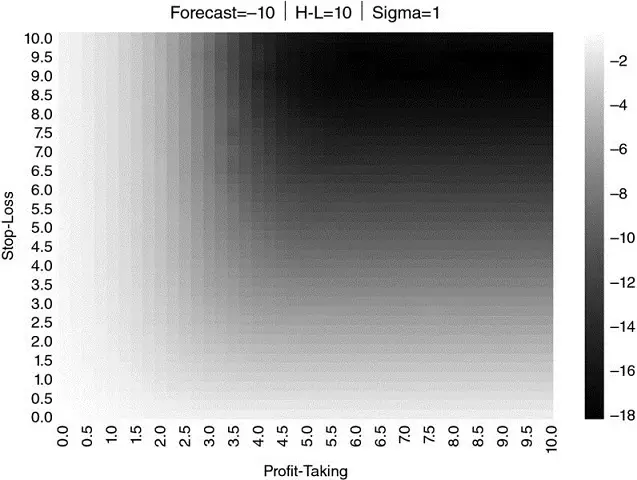
图 13.22 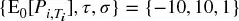 的热图
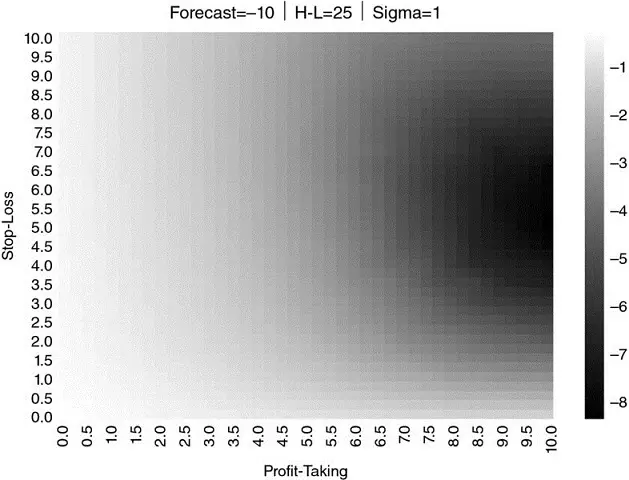
图 13.23 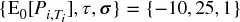 的热图
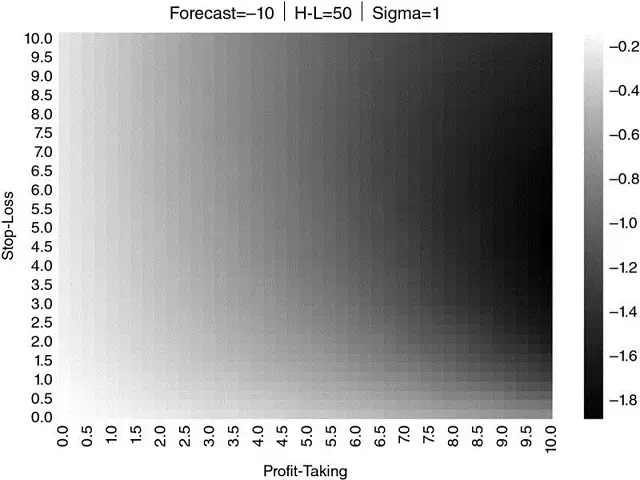
图 13.24 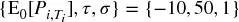 的热图
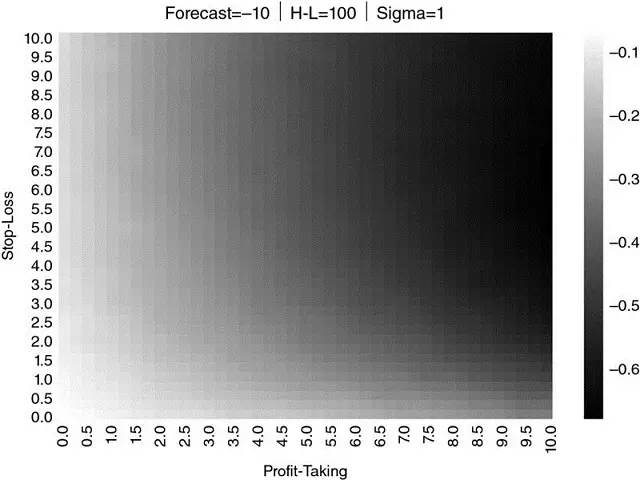
图 13.25 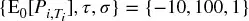 的热图
13.7 结论#
在本章中,我们展示了如何通过实验确定与遵循离散 O-U 过程的价格关联的最优交易策略。由于此类交易策略的推导不是历史模拟的结果,我们的程序避免了将回测过拟合到单一路径的风险。相反,最优交易规则是从驱动价格的底层随机过程的特征中推导的。同样的方法可以应用于 O-U 以外的过程,我们专注于这一特定过程仅出于教育目的。
虽然我们在本章中没有推导最优交易策略问题的闭式解,但我们的实验结果似乎支持以下 OTR 猜想:
猜想: 给定由离散 O-U 过程表征的金融工具价格,存在唯一的最优交易规则(以止盈和止损组合的形式),使该规则的夏普比率最大化。
鉴于这些最优交易规则可以在几秒钟内数值推导,获得闭式解的实际动机不大。正如在数学研究中越来越常见的那样,猜想的实验分析可以帮助我们在没有证明的情况下实现目标。证明上述猜想可能需要数年甚至数十年,然而迄今为止进行的所有实验都在经验上证实了它。让我这样说:该猜想错误的概率相对于你因忽视猜想而过拟合交易规则的概率可以忽略。因此,理性的做法是假设猜想正确,并通过合成数据确定 OTR。在最坏的情况下,交易规则将是次优的,但仍然几乎肯定会优于过拟合的交易规则。
练习题#
假设你是一名执行交易员。客户打电话给你,下达一个覆盖她在价格 100 处进入的空头头寸的订单。她给你两个退出条件:止盈 90 和止损 105。
- 假设客户认为价格遵循 O-U 过程,这些水平合理吗?对于什么参数?
- 你能想到这些水平有意义的替代随机过程吗?
将 E-mini S&P 500 期货美元条的时间序列拟合到 O-U 过程。给定这些参数:
- 为各种止盈和止损水平生成夏普比率热图。
- OTR 是什么?
在以下美元条时间序列上重复练习 2:
- 10 年期美国国债期货
- WTI 原油期货
- 结果是否显著不同?这是否证明了按产品专业化执行交易员的合理性?
在将时间序列分为两部分后重复练习 2:
- 第一个时间序列在 2009/3/15 结束。
- 第二个时间序列从 2009/3/16 开始。
- OTR 是否显著不同?
你估计推导全球 100 种最流动性期货的 OTR 需要多长时间?考虑到练习 4 的结果,你认为多久需要重新校准 OTR?预计算这些数据有意义吗?
使用第 20 章描述的
mpEngine模块并行化代码片段 13.1 和 13.2。
参考文献#
- Bailey, D. and M. López de Prado (2012): "The Sharpe ratio efficient frontier." Journal of Risk, Vol. 15, No. 2, pp. 3--44. Available at http://ssrn.com/abstract=1821643.
- Bailey, D. and M. López de Prado (2013): "Drawdown-based stop-outs and the triple penance rule." Journal of Risk, Vol. 18, No. 2, pp. 61--93. Available at http://ssrn.com/abstract=2201302.
- Bailey, D., J. Borwein, M. López de Prado, and J. Zhu (2014): "Pseudo-mathematics and financial charlatanism: The effects of backtest overfitting on out-of-sample performance." Notices of the American Mathematical Society, 61(5), pp. 458--471. Available at http://ssrn.com/abstract=2308659.
- Bailey, D., J. Borwein, M. López de Prado, and J. Zhu (2017): "The probability of backtest overfitting." Journal of Computational Finance, Vol. 20, No. 4, pp. 39--70. Available at http://ssrn.com/abstract=2326253.
- Bertram, W. (2009): "Analytic solutions for optimal statistical arbitrage trading." Working paper. Available at http://ssrn.com/abstract=1505073.
- Easley, D., M. Lopez de Prado, and M. O'Hara (2011): "The exchange of flow-toxicity." Journal of Trading, Vol. 6, No. 2, pp. 8--13. Available at http://ssrn.com/abstract=1748633.
注释#
^1^ 我要感谢 Peter Carr 教授(纽约大学)对本章的贡献。
^2^ 策略可能仍然是回测过拟合的结果,但至少交易规则不会对这个问题做出贡献。
^3^ 交易规则 R 可以表征为三个障碍的函数,而非仅水平障碍。该变化对程序没有影响,只会给网格增加一个维度(20×20×20)。在本章中我们不考虑该设置,因为它会使方法的可视化不够直观。