交叉验证回测#
12.1 动机#
回测使用过去的观测来评估投资策略的样本外表现。这些过去的观测可以用于两种方式:(1) 狭义上,模拟投资策略的历史表现,就好像它过去运行过一样;(2) 广义上,模拟过去未发生的情景。第一种(狭义)方法也称为走步法(walk-forward),如此流行,以至于事实上「回测」已成为事实上的「历史模拟」的同义词。第二种(广义)方法远不那么为人所知,在本章中,我们将介绍一些执行它的新方法。每种方法都有其优缺点,都应给予仔细考虑。
12.2 走步法#
文献中最常见的回测方法是走步法(Walk-Forward, WF)。WF 是对策略过去表现的模拟。每个策略决策都基于先于该决策的观测。正如我们在第 11 章中所见,执行无瑕疵的 WF 模拟是一项艰巨的任务,需要对数据源、市场微观结构、风险管理、绩效衡量标准(如 GIPS)、多重检验方法、实验数学等有深入了解。遗憾的是,没有进行回测的通用配方。为了准确和有代表性,每个回测都必须定制化以评估特定策略的假设。
WF 有两个关键优势:(1) WF 有清晰的历史解释。其表现可以与纸面交易核对。(2) 历史是一个过滤;因此,使用尾随数据保证测试集是样本外的(无泄露),只要净化被正确实现(见第 7 章第 7.4.1 节)。在 WF 回测中发现泄露是一个常见错误,其中 t1.index 落在训练集内,但 t1.values 落在测试集内(见第 3 章)。WF 回测中不需要禁运,因为训练集总是先于测试集。
12.2.1 走步法的缺陷#
WF 有三个主要缺点:第一,只测试了一个情景(历史路径),这很容易过拟合(Bailey 等 [2014])。第二,WF 不一定代表未来表现,因为结果可能被数据点的特定序列所偏移。WF 方法的支持者通常认为预测过去会导致过于乐观的表现估计。然而,在反向观测序列上拟合一个表现优异的模型,往往会导致 WF 回测表现不佳。事实是,过拟合走步前向回测和过拟合走步后向回测一样容易,改变观测序列产生不一致结果的事实就是过拟合的证据。如果 WF 支持者是对的,我们应该观察到走步后向回测系统性地优于其走步前向对应物。情况并非如此,因此支持 WF 的主要论据相当薄弱。
为了使第二个缺点更清楚,假设一个股票策略使用 WF 在 S&P 500 数据上回测,从 2007 年 1 月 1 日开始。直到 2009 年 3 月 15 日,反弹和抛售的混合将训练策略成为市场中性的,对每个头寸的信心很低。之后,长期反弹将主导数据集,到 2017 年 1 月 1 日,买入预测将占优于卖出预测。如果我们反向播放信息(从 2017 年 1 月 1 日到 2007 年 1 月 1 日,先长期反弹再急剧抛售),表现将非常不同。通过利用特定序列,WF 选择的策略可能让我们为灾难做好准备。
WF 的第三个缺点是初始决策在总样本的较小部分上做出。即使设置了预热期,大部分信息也只被一小部分决策使用。考虑一个具有预热期的策略,使用 T 中的 t0 个观测。该策略一半的决策  在平均数据点数上做出,
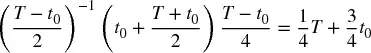
这只是观测的  部分。虽然通过增加预热期可以缓解这个问题,但这样做也减少了回测的长度。
12.3 交叉验证法#
投资者经常问,如果策略遭受像 2008 年危机那样不可预见的压力情景,它会表现如何。或互联网泡沫、缩减恐慌、2015-2016 年中国恐慌等。一种回答方式是将观测分为两个集合,一个包含我们希望测试的期间(测试集),另一个包含其余(训练集)。例如,分类器在 2009 年 1 月 1 日至 2017 年 1 月 1 日期间训练,然后在 2008 年 1 月 1 日至 2008 年 12 月 31 日期间测试。我们为 2008 年获得的表现不是历史准确的,因为分类器是在 2008 年之后才可用的数据上训练的。但历史准确性不是测试的目标。测试的目标是让一个不了解 2008 年的策略承受像 2008 年那样的压力情景。
通过交叉验证(CV)回测的目标不是推导历史准确的性能,而是从多个样本外情景中推断未来性能。对于回测的每个期间,我们模拟一个知道除该期间外一切的分类器的性能。
优势
- 测试不是特定(历史)情景的结果。事实上,CV 测试 k 种替代情景,其中只有一种对应历史序列。
- 每个决策都在相等大小的集合上做出。这使得各期间的结果在用于做出这些决策的信息量方面具有可比性。
- 每个观测是一个且仅一个测试集的一部分。没有预热子集,从而实现了尽可能长的样本外模拟。
劣势
- 与 WF 一样,模拟了单条回测路径(尽管不是历史路径)。每个观测产生一个且仅一个预测。
- CV 没有清晰的历史解释。输出不模拟策略过去会如何表现,而是模拟它未来在各种压力情景下可能如何表现(这本身就是一个有用的结果)。
- 因为训练集不尾随测试集,泄露是可能的。必须极其小心地避免将测试信息泄露到训练集中。关于净化和禁运如何帮助防止 CV 上下文中的信息泄露,见第 7 章的讨论。
12.4 组合净化交叉验证法#
在本节中,我将介绍一种新方法,解决 WF 和 CV 方法的主要缺点,即这些方案测试单一路径。我称之为「组合净化交叉验证」(Combinatorial Purged Cross-Validation, CPCV)方法。给定研究者目标的回测路径数 φ,CPCV 生成产生这些路径所需的精确训练/测试集组合数,同时净化包含泄露信息的训练观测。
12.4.1 组合划分#
考虑 T 个观测在无打乱的情况下划分为 N 组,其中组 n = 1, ..., N−1 的大小为 ⌊T/N⌋,第 N 组的大小为 T − ⌊T/N⌋(N−1),⌊·⌋ 是取整函数。对于大小为 k 组的测试集,可能的训练/测试划分数为
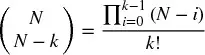
由于每个组合涉及 k 个测试组,测试组的总数为  。由于我们计算了所有可能的组合,这些测试组均匀分布在所有 N 组中(每组属于相同数量的训练集和测试集)。其含义是,从 N 组上的 k 大小测试集,我们可以回测总共 φ[N, k] 条路径,
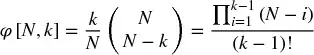
图 12.1 说明了 N = 6 和 k = 2 的训练/测试划分组成。有  个划分,索引为 S1, ..., S15。对于每个划分,图用叉号 (×) 标记包含在测试集中的组,未标记的组构成训练集。每组构成 φ[6, 2] = 5 个测试集的一部分,因此该训练/测试划分方案允许我们计算 5 条回测路径。
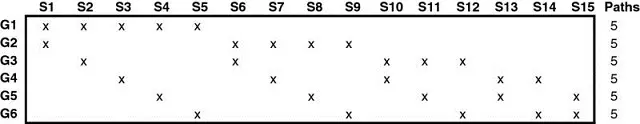
图 12.1 φ[6, 2] = 5 生成的路径
图 12.2 显示了每个测试组到一条回测路径的分配。例如,路径 1 是结合来自 (G1, S1)、(G2, S1)、(G3, S2)、(G4, S3)、(G5, S4) 和 (G6, S5) 的预测的结果。路径 2 是结合来自 (G1, S2)、(G2, S6)、(G3, S6)、(G4, S7)、(G5, S8) 和 (G6, S9) 的预测的结果,以此类推。
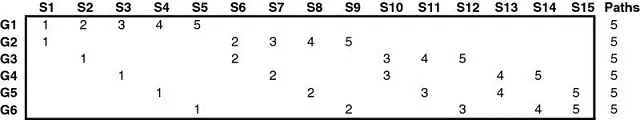
图 12.2 测试组到 5 条路径的分配
这些路径通过对每个组合的数据部分 θ = 1 − k/N 训练分类器来生成。虽然在 θ < 1/2 的部分上训练在理论上是可能的,但在实践中我们假设 k ≤ N/2。训练集中的数据部分 θ 随 N → T 增加但随 k → N/2 减少。路径数 φ[N, k] 随 N → T 和 k → N/2 增加。在极限情况下,通过设置 N = T 和 k = N/2 = T/2 实现最大路径数,代价是每个组合只在一半数据上训练分类器(θ = 1/2)。
12.4.2 组合净化交叉验证回测算法#
在第 7 章中,我们在 CV 的上下文中引入了净化和禁运的概念。我们现在将这些概念用于通过 CV 进行回测。CPCV 回测算法进行如下:
- 将 T 个观测在无打乱的情况下划分为 N 组,其中组 n = 1, ..., N−1 的大小为 ⌊T/N⌋,第 N 组的大小为 T − ⌊T/N⌋(N−1)。
- 计算所有可能的训练/测试划分,其中每个划分 N−k 组构成训练集,k 组构成测试集。
- 对于任何一对标签 (y
i, yj),其中 yi属于训练集,yj属于测试集,如果 yi跨越用于确定标签 yj的期间,则应用PurgedKFold类净化 yi。如果某些测试样本先于某些训练样本,该类还将应用禁运。 - 在
 个训练集上拟合分类器,并在各自的
 个测试集上产生预测。
- 计算 φ[N, k] 条回测路径。你可以从每条路径计算一个夏普比率,从而推导策略夏普比率的经验分布(而非像 WF 或 CV 那样的单一夏普比率)。
12.4.3 几个示例#
对于 k = 1,我们将获得 φ[N, 1] = 1 条路径,此时 CPCV 退化为 CV。因此,CPCV 可以理解为 CV 对 k > 1 的推广。
对于 k = 2,我们将获得 φ[N, 2] = N−1 条路径。这是一个特别有趣的情况,因为在对数据的大部分 θ = 1 − 2/N 训练分类器的同时,我们可以生成几乎与组数 N−1 一样多的回测路径。一个简单的经验法则是将数据划分为 N = φ+1 组(其中 φ 是我们目标的路径数),然后形成  个组合。在极限情况下,我们可以为每个观测分配一组,N = T,生成 φ[T, 2] = T−1 条路径,同时对每个组合的数据部分 θ = 1 − 2/T 训练分类器。
如果需要更多路径,我们可以增加 k → N/2,但如前所述,这将以使用更小的数据集部分进行训练为代价。在实践中,k = 2 通常足以通过设置 N = φ+1 ≤ T 生成所需的 φ 条路径。
12.5 组合净化交叉验证如何解决回测过拟合#
给定一个 IID 随机变量样本 xi ~ Z,i = 1, ..., I,其中 Z 是标准正态分布,该样本的期望最大值可以近似为
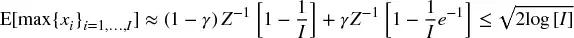
其中 Z^−1^[·] 是 Z 的 CDF 的逆,γ ≈ 0.5772156649··· 是 Euler-Mascheroni 常数,I ≫ 1(证明见 Bailey 等 [2014])。现在假设研究者在表现得像鞅的工具上回测 I 个策略,夏普比率为 {yi}i=1,...,I,E[yi] = 0,σ²[yi] > 0,且  。即使真实夏普比率为零,我们也期望找到一个夏普比率为
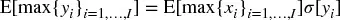
WF 回测表现出高方差 σ[yi] ≫ 0,原因至少有一个:大部分决策基于数据集的一小部分。少数观测将对夏普比率有很大权重。使用预热期将减少回测长度,这可能使方差更高。WF 的高方差导致错误发现,因为研究者会选择具有最大估计夏普比率的回测,即使真实夏普比率为零。这就是为什么在 WF 回测的上下文中控制试验次数 (I) 至关重要。没有这些信息,就无法确定族错误率(FWER)、错误发现率(FDR)、回测过拟合概率(PBO,见第 11 章)或类似的模型评估统计量。
CV 回测(第 12.3 节)通过在相等且大数据集部分上训练每个分类器来解决该方差来源。虽然 CV 比 WF 导致更少的错误发现,但两种方法仍然从策略 i 的单一路径 yi 估计夏普比率,该估计可能高度波动。相比之下,CPCV 从大量路径 j = 1, ..., φ 推导夏普比率分布,均值 E[{yi,j}j=1,...,φ] = μi,方差 σ²[{yi,j}j=1,...,φ] = σ²i。CPCV 路径样本均值的方差为
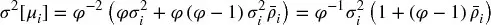
其中 σ²i 是策略 i 跨路径夏普比率的方差, 是 {y
i,j}j=1,...,φ 之间的平均非对角相关性。CPCV 比 CV 和 WF 导致更少的错误发现,因为  意味着样本均值的方差低于样本的方差,
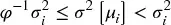
路径越不相关  ,CPCV 的方差越低,在极限情况下 CPCV 将以零方差报告真实夏普比率 E[y
i],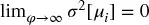 。不会有选择偏差,因为从 i = 1, ..., I 中选择的策略将是具有最高真实夏普比率的那个。
当然,我们知道零方差是不可实现的,因为 φ 有上界  。尽管如此,对于足够多的路径 φ,CPCV 可以使回测的方差小到使错误发现的概率可以忽略。
在第 11 章中,我们认为回测过拟合可能是所有数学金融中最重要的开放问题。让我们看看 CPCV 如何在实践中帮助解决这个问题。假设研究者向期刊提交一个策略,由从大量未公开试验中选择的过拟合 WF 回测支持。期刊可以要求研究者使用 CPCV 对给定的 N 和 k 重复他的实验。因为研究者事先不知道要回测的路径的数量和特征,他的过拟合努力将很容易被击败。论文将被拒绝或撤回。希望 CPCV 将被用来减少期刊和其他地方发表的错误发现数量。
练习题#
假设你在期货合约上开发动量策略,其中预测基于 AR(1) 过程。你使用 WF 方法回测该策略,夏普比率为 1.5。然后你在反向序列上重复回测,达到夏普比率 −1.5。如果有的话,忽略第二个结果的数学依据是什么?
你在期货合约上开发均值回归策略。你的 WF 回测达到夏普比率 1.5。你增加预热期的长度,夏普比率降至 0.7。你继续只展示夏普比率更高的结果,认为预热期更短的策略更现实。这是选择偏差吗?
你的策略在 WF 回测中达到夏普比率 1.5,但在 CV 回测中夏普比率为 0.7。你继续只展示夏普比率更高的结果,认为 WF 回测历史准确,而 CV 回测是情景模拟或推断练习。这是选择偏差吗?
你的策略随时间产生 100000 个预测。你希望通过生成 1000 条路径来推导夏普比率的 CPCV 分布。什么参数组合 (N, k) 能让你实现这一目标?
你发现一个策略在 WF 回测中达到夏普比率 1.5。你写了一篇解释证明该结果的理论的论文,并提交给学术期刊。编辑回复说一位审稿人要求你使用 CPCV 方法(N = 100,k = 2)重复你的回测,包括你的代码和完整数据集。你遵循这些指示,平均夏普比率为 −1,标准差为 0.5。愤怒之下,你不回复,而是撤回投稿,并重新提交给影响因子更高的另一期刊。6 个月后,你的论文被接受。你安慰自己的良心,认为如果发现是错误的,那是期刊的错,因为期刊没有要求 CPCV 测试。你想,「这不可能是道德问题,因为它是被允许的,而且每个人都这样做。」证明你行为的科学或道德论据是什么?
参考文献#
- Bailey, D. and M. López de Prado (2012): "The Sharpe ratio efficient frontier." Journal of Risk, Vol. 15, No. 2 (Winter). Available at https://ssrn.com/abstract=1821643.
- Bailey, D. and M. López de Prado (2014): "The deflated Sharpe ratio: Correcting for selection bias, backtest overfitting and non-normality." Journal of Portfolio Management, Vol. 40, No. 5, pp. 94--107. Available at https://ssrn.com/abstract=2460551.
- Bailey, D., J. Borwein, M. López de Prado, and J. Zhu (2014): "Pseudo-mathematics and financial charlatanism: The effects of backtest overfitting on out-of-sample performance." Notices of the American Mathematical Society, Vol. 61, No. 5, pp. 458--471. Available at http://ssrn.com/abstract=2308659.
- Bailey, D., J. Borwein, M. López de Prado, and J. Zhu (2017): "The probability of backtest overfitting." Journal of Computational Finance, Vol. 20, No. 4, pp. 39--70. Available at https://ssrn.com/abstract=2326253.