回测的危险#
11.1 动机#
回测是量化武器库中最关键但最不被理解的技术之一。一个常见的误解是把回测当作研究工具。研究和回测就像酒驾——不要在回测的影响下做研究。大多数期刊上发表的回测都是有缺陷的,这是对多重检验进行选择偏差的结果(Bailey、Borwein、López de Prado 和 Zhu [2014];Harvey 等 [2016])。可以写一整本书列举人们在回测时犯下的各种错误。我可能是在回测和投资绩效指标方面发表期刊论文最多的学术作者,但即便如此,我也没有毅力把我过去 20 年见过的所有错误汇编成册。本章不是回测的速成课,而是一些连经验丰富的专业人士也会犯的常见错误的简短清单。
11.2 不可能的任务:完美的回测#
在最狭义的定义中,回测是对策略在过去一段时间内运行时表现的模拟。因此,它是一个假设,绝非实验。在像伯克利实验室这样的物理实验室里,我们可以在控制环境变量的同时重复实验,从而推导出精确的因果关系。相比之下,回测不是实验,它不能证明任何事。即使我们能乘时光机回到过去,也不能保证达到那个夏普比率——即使在我们那辆改装过的 DeLorean DMC-12 里也不行(Bailey 和 López de Prado [2012])。随机抽样会有所不同,过去不会重演。
那么回测的意义是什么?它是对若干变量的合理性检查,包括下注规模、换手率、对成本的韧性以及在给定情景下的行为。一个好的回测可以极有帮助,但做好回测极其困难。2014 年,德意志银行由 Yin Luo 带领的量化团队发表了一份题为《量化投资的七宗罪》(Seven Sins of Quantitative Investing)的研究(Luo 等 [2014])。这是一篇图文并茂、通俗易懂的文章,我建议业内每个人仔细阅读。在这篇文章中,该团队提到了那些惯犯:
- 幸存者偏差(Survivorship bias): 使用当前的投资宇宙,因而忽略了沿途有些公司破产、证券退市的事实。
- 前视偏差(Look-ahead bias): 在模拟决策本应做出的时刻使用了尚未公开的信息。务必确认每个数据点的时间戳,考虑发布日期、分发延迟和回填修正。
- 讲故事(Storytelling): 事后编造故事来为某个随机模式辩护。
- 数据挖掘与数据窥探(Data mining and data snooping): 在测试集上训练模型。
- 交易成本(Transaction costs): 模拟交易成本很困难,因为确定该成本的唯一方式是与交易账簿互动(即实际执行交易)。
- 异常值(Outliers): 将策略建立在过去观测到的少数极端结果上,而这些结果可能永远不会再次发生。
- 做空(Shorting): 对现金产品做空需要找到出借方。出借成本和可用数量通常是未知的,取决于关系、库存、相对需求等。
这些只是大多数期刊发表论文经常犯的一些基本错误。其他常见错误包括:用非标准方法计算绩效表现(第 14 章);忽略隐藏风险;只关注收益而忽略其他指标;混淆相关性与因果性;选择不具代表性的时间段;未能预料到意外情况;忽略止损限制或追加保证金通知的存在;忽略融资成本;以及遗忘实际操作层面的问题(Sarfati [2015])。错误还有很多,但说实话,列举下去没有意义,原因就是下一节的标题。
11.3 即使你的回测完美,它可能也是错的#
恭喜!你的回测完美无瑕——每个人都能复现你的结果,你的假设如此保守,以至于连你的老板都无法反对。你为每笔交易支付的成本是任何人可能索要的两倍以上。你在信息被半个地球的人知道数小时后才执行,成交量参与率低得可笑。尽管有所有这些离谱的成本,你的回测仍然赚了很多钱。然而,这个完美的回测很可能是错的。为什么?因为只有专家才能产出完美的回测。成为专家意味着这些年来你已经运行了成千上万次回测。结论是,这不是你产出的第一个回测,所以我们需要考虑这是一种错误发现的可能性——在同一数据集上进行多次检验后不可避免地出现的统计偶发事件。
回测令人抓狂的是,你越擅长它,错误发现出现的可能性越大。初学者落入 Luo 等 [2014] 的七宗罪(还有更多,但谁有心思数呢?)。专业人士可能产出完美无瑕的回测,却仍会落入多重检验、选择偏差或回测过拟合的陷阱(Bailey 和 López de Prado [2014b])。
11.4 回测不是研究工具#
第 8 章讨论了替代效应、联合效应、掩蔽、MDI、MDA、SFI、并行特征、堆叠特征等。即使某些特征非常重要,也不意味着它们可以通过投资策略货币化。反过来,也有大量即使基于无关特征也会看起来有利可图的策略。特征重要性是真正的研究工具,因为它帮助我们理解 ML 算法发现的模式的本质,无论其货币化如何。关键是,特征重要性是在模拟历史绩效之前事先(ex-ante)推导的。
相比之下,回测不是研究工具。它几乎不能让我们洞悉某个策略为什么会赚钱的原因。就像彩票中奖者可能觉得自己做了什么才配得上这份运气一样,总会有某种事后(ex-post)故事(Luo 的第三宗罪)。作者们声称找到了数百个「alpha」和「因子」,而对这些总有某种费解的解释。实际上,他们找到的是上一轮中奖的彩票。中奖者已经兑现,这些号码在下一轮毫无用处。如果你不会为这些彩票多付钱,为什么要在乎那数百个 alpha?那些作者从不告诉我们所有被卖出的彩票,即找到这些「幸运」alpha 所需的数百万次模拟。
回测的目的是丢弃糟糕的模型,而不是改进它们。根据回测结果调整模型是浪费时间……而且很危险。把你的时间和精力投入到把所有组件做对上,正如我们在本书其他地方讨论的:结构化数据、标签、权重、集成、交叉验证、特征重要性、下注规模等。等你回测的时候,已经太晚了。在模型完全确定之前永远不要回测。如果回测失败,从头开始。这样做的话,发现错误发现的概率会大幅降低,但仍不会为零。
11.5 一些通用建议#
回测过拟合可以定义为多次回测上的选择偏差。当策略被开发成在回测中表现良好,通过利用随机的历史模式来获利时,就会发生回测过拟合。由于那些随机模式不太可能在未来再次出现,如此开发的策略将会失败。由于「选择偏差」,每个回测策略都在某种程度上过拟合:大多数人分享的回测只有那些描绘了据称获胜的投资策略的回测。
如何解决回测过拟合可以说是量化金融中最根本的问题。为什么?因为如果这个问题有简单的答案,投资公司就能确定性地实现高绩效,因为他们只会投资于获胜的回测。期刊也能有信心地评估一个策略是否是错误发现。金融可以成为 Popper 和 Lakatos 意义上的真正科学(López de Prado [2017])。让回测过拟合如此难以评估的原因是,错误发现的概率随着在同一数据集上进行的每一次新检验而变化,而该信息要么不为研究者所知,要么未与投资者或评审者分享。虽然没有简单的方法防止过拟合,但一些步骤可以帮助减少其存在:
- 为整个资产类别或投资宇宙开发模型,而非为特定证券(第 8 章)。投资者分散投资,因此他们不会只在证券 Y 上犯错误 X。如果你只在证券 Y 上发现错误 X,无论看起来多有利可图,它很可能是错误发现。
- 应用 bagging(第 6 章)作为既防止过拟合又减少预测误差方差的手段。如果 bagging 恶化了策略的表现,它很可能过拟合了少量观测或异常值。
- 在所有研究完成(第 1 章至第 10 章)之前不要回测。
- 记录在数据集上进行的每次回测,以便在最终选择的结果上估计回测过拟合的概率(见 Bailey、Borwein、López de Prado 和 Zhu [2017a] 及第 14 章),夏普比率可以根据进行的试验次数正确地被压缩(deflated)(Bailey 和 López de Prado [2014b])。
- 模拟情景而非历史(第 12 章)。标准回测是历史模拟,很容易过拟合。历史只是实现的随机路径,它可能完全不同。你的策略应该在广泛的情景下都有利可图,而非仅仅在轶事性的历史路径上。过拟合数千个「如果」情景的结果更难。
- 如果回测未能识别出有利可图的策略,从头开始。抵制重用这些结果的诱惑。遵循回测第二定律。
SNIPPET 11.1 MARCOS 的回测第二定律
「在研究的同时回测就像酒驾。不要在回测的影响下做研究。」
—— Marcos López de Prado,《金融机器学习的进展》(Advances in Financial Machine Learning)[2018]
11.6 策略选择#
在第 7 章中,我们讨论了标签中序列条件的存在如何使标准 K 折交叉验证失效,因为随机采样会将冗余观测溅入训练集和测试集。我们必须找到一种不同的(真正的样本外)验证程序:一种在与用于训练模型的观测最不可能相关/冗余的观测上评估模型的程序。综述参见 Arlot 和 Celisse [2010]。
Scikit-learn 实现了走步法(walk-forward)时间折叠方法。在这种方法下,测试沿时间方向向前移动,目标是防止信息泄露(leakage)。这与历史回测(和交易)的进行方式一致。然而,在存在长程序列依赖的情况下,仅测试训练集末尾之后一个观测可能不足以避免信息泄露。我们将在第 12 章第 12.2 节再次讨论这一点。
走步法的一个缺点是它很容易过拟合。原因是,没有随机采样,只有一条测试路径可以反复重复直到出现假阳性。与标准交叉验证一样,需要某种随机化来避免这种绩效瞄准或回测优化,同时避免与训练集相关的示例泄露到测试集中。接下来,我们将介绍一种用于策略选择的交叉验证方法,它基于对回测过拟合概率(PBO)的估计。回测的交叉验证方法的解释留到第 12 章。
Bailey 等 [2017a] 引入了组合对称交叉验证(CSCV)方法。示意性地,该程序工作如下。
第一,我们收集来自 N 次试验的结果。具体地,每一列 n = 1, ..., N 表示一个与研究者尝试的某个模型配置相关联的、在 t = 1, ..., T 个观测上的盈亏(按市值计价的损益)向量。因此 M 是一个 ( T × N ) 阶的实值矩阵。我们施加的唯一条件是:(1) M 是一个真矩阵,即每一列具有相同的行数,其中观测在所有 N 次试验的每一行上是同步的;(2) 用于选择「最优」策略的绩效评估指标可以在每列的子样本上估计。例如,如果该指标是夏普比率,我们假设 IID 正态分布假设可以在报告表现的各种切片上成立。如果不同模型配置以不同频率交易,观测被聚合(下采样)以匹配共同索引 t = 1, ..., T。
第二,我们将 M 按行划分为偶数 S 个相等维度的不相交子矩阵。每个子矩阵 Ms(s = 1, ..., S)的阶为  。
第三,我们形成 Ms 的所有组合 CS,按大小为  的组取。这给出的组合总数为
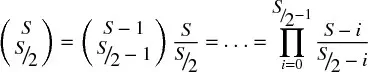
例如,如果 S = 16,我们将形成 12,780 个组合。每个组合 c ∈ CS 由  个子矩阵 M
s 组成。
第四,对于每个组合 c ∈ CS,我们:
- 通过连接构成 c 的
 个子矩阵 M
s来形成训练集 J。J 是一个阶为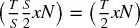 的矩阵。
- 形成测试集,作为 J 在 M 中的补集。换言之,该
 阶矩阵由 M 中不属于 J 的所有行形成。
- 形成一个 N 阶的绩效统计向量 R,其中 R 的第 n 项报告与 J(训练集)第 n 列相关联的绩效。
- 确定元素 n* 使得
 ,∀n = 1, ..., N。换言之,
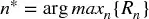 。
- 形成一个 N 阶的绩效统计向量
 ,其中
 的第 n 项报告与
 (测试集)第 n 列相关联的绩效。
- 确定相对排名。我们将此相对排名记为
 ,其中
 。这是与样本内(IS)所选试验相关联的样本外(OOS)绩效的相对排名。如果策略优化程序没有过拟合,我们应该观察到
 系统性地在样本外优于
 ,正如它在样本内优于 R 一样。
- 定义 logit。这呈现了当
 与
 的中位数重合时的值。高的 logit 值意味着样本内与样本外绩效之间的一致性,这表明回测过拟合程度较低。
第五,通过收集所有的 λc(c ∈ CS)来形成概率分布。然后,概率分布函数 f(λ) 被估计为 λ 在所有 CS 上的分布,其中 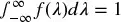 。最后,PBO 被估计为
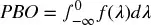 ,即与样本内最优策略在样本外表现不佳相关联的概率。
图 11.1 的 x 轴显示了所选最优策略的样本内夏普比率(SR IS),y 轴显示了同一最优策略的样本外夏普比率(SR OOS)。可以看出,存在强烈且持久的绩效衰减,这是由回测过拟合造成的。应用上述算法,我们可以推导出与此策略选择过程相关联的 PBO,如图 11.2 所示。
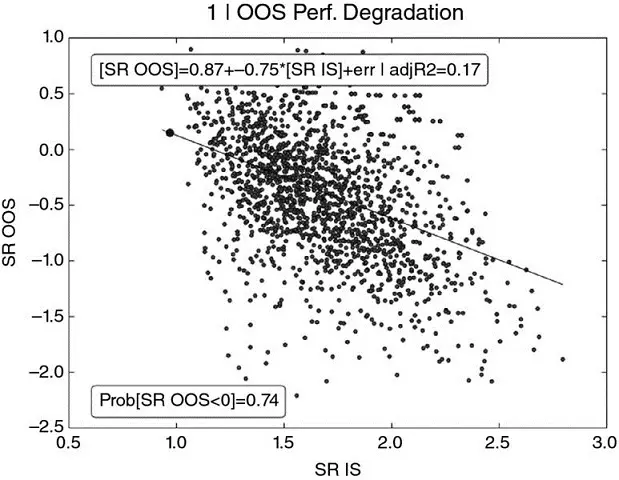
图 11.1 最优策略的样本内夏普比率(SR IS)与样本外夏普比率(SR OOS)
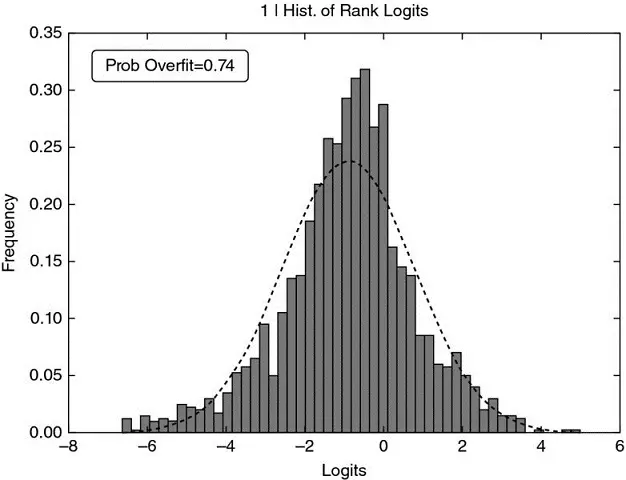
图 11.2 由 logit 分布推导的回测过拟合概率
每个子集中的观测保持了原始时间序列。随机采样在相对不相关的子集上完成,而非在观测上。该方法精度的实验分析参见 Bailey 等 [2017a]。
练习题#
一位分析师拟合了一个 RF 分类器,其中一些特征包含季节调整后的就业数据。他用一月的数据对齐一月的季节调整值,以此类推。他犯了什么「罪」?
一位分析师开发了一个 ML 算法,他用收盘价生成信号,并在收盘时执行。这犯了什么罪?
美国街机厅的总收入与授予的计算机科学博士学位数量之间存在 98.51% 的相关性。由于博士学位数量预计会增长,我们应该投资街机厅公司吗?如果不应该,犯了什么罪?
《华尔街日报》曾报道,回顾 20、50 和 100 年,九月是一年中唯一平均股票回报为负的月份。我们应该在八月底卖出股票吗?如果不应该,犯了什么罪?
我们从 Bloomberg 下载市盈率(P/E),每月对股票排名,卖出最高四分位,买入最低四分位。绩效惊人。犯了什么罪?
参考文献#
- Arlot, S. and A. Celisse (2010): "A survey of cross-validation procedures for model selection." Statistics Surveys, Vol. 4, pp. 40--79.
- Bailey, D., J. Borwein, M. López de Prado, and J. Zhu (2014): "Pseudo-mathematics and financial charlatanism: The effects of backtest overfitting on out-of-sample performance." Notices of the American Mathematical Society, Vol. 61, No. 5 (May), pp. 458--471. Available at https://ssrn.com/abstract=2308659.
- Bailey, D., J. Borwein, M. López de Prado, and J. Zhu (2017a): "The probability of backtest overfitting." Journal of Computational Finance, Vol. 20, No. 4, pp. 39--70. Available at http://ssrn.com/abstract=2326253.
- Bailey, D. and M. López de Prado (2012): "The Sharpe ratio efficient frontier." Journal of Risk, Vol. 15, No. 2 (Winter). Available at https://ssrn.com/abstract=1821643.
- Bailey, D. and M. López de Prado (2014b): "The deflated Sharpe ratio: Correcting for selection bias, backtest overfitting and non-normality." Journal of Portfolio Management, Vol. 40, No. 5, pp. 94--107. Available at https://ssrn.com/abstract=2460551.
- Harvey, C., Y. Liu, and H. Zhu (2016): ". . . and the cross-section of expected returns." Review of Financial Studies, Vol. 29, No. 1, pp. 5--68.
- López de Prado, M. (2017): "Finance as an industrial science." Journal of Portfolio Management, Vol. 43, No. 4, pp. 5--9. Available at http://www.iijournals.com/doi/pdfplus/10.3905/jpm.2017.43.4.005.
- Luo, Y., M. Alvarez, S. Wang, J. Jussa, A. Wang, and G. Rohal (2014): "Seven sins of quantitative investing." White paper, Deutsche Bank Markets Research, September 8.
- Sarfati, O. (2015): "Backtesting: A practitioner's guide to assessing strategies and avoiding pitfalls." Citi Equity Derivatives. CBOE 2015 Risk Management Conference. Available at https://www.cboe.com/rmc/2015/olivier-pdf-Backtesting-Full.pdf.
参考书目#
- Bailey, D., J. Borwein, and M. López de Prado (2016): "Stock portfolio design and backtest overfitting." Journal of Investment Management, Vol. 15, No. 1, pp. 1--13. Available at https://ssrn.com/abstract=2739335.
- Bailey, D., J. Borwein, M. López de Prado, A. Salehipour, and J. Zhu (2016): "Backtest overfitting in financial markets." Automated Trader, Vol. 39. Available at https://ssrn.com/abstract=2731886.
- Bailey, D., J. Borwein, M. López de Prado, and J. Zhu (2017b): "Mathematical appendices to: 'The probability of backtest overfitting.'" Journal of Computational Finance (Risk Journals), Vol. 20, No. 4. Available at https://ssrn.com/abstract=2568435.
- Bailey, D., J. Borwein, A. Salehipour, and M. López de Prado (2017): "Evaluation and ranking of market forecasters." Journal of Investment Management, forthcoming. Available at https://ssrn.com/abstract=2944853.
- Bailey, D., J. Borwein, A. Salehipour, M. López de Prado, and J. Zhu (2015): "Online tools for demonstration of backtest overfitting." Working paper. Available at https://ssrn.com/abstract=2597421.
- Bailey, D., S. Ger, M. López de Prado, A. Sim and, K. Wu (2016): "Statistical overfitting and backtest performance." In Risk-Based and Factor Investing, Quantitative Finance Elsevier. Available at https://ssrn.com/abstract=2507040.
- Bailey, D. and M. López de Prado (2014a): "Stop-outs under serial correlation and 'the triple penance rule.'" Journal of Risk, Vol. 18, No. 2, pp. 61--93. Available at https://ssrn.com/abstract=2201302.
- Bailey, D. and M. López de Prado (2015): "Mathematical appendices to: 'Stop-outs under serial correlation.'" Journal of Risk, Vol. 18, No. 2. Available at https://ssrn.com/abstract=2511599.
- Bailey, D., M. López de Prado, and E. del Pozo (2013): "The strategy approval decision: A Sharpe ratio indifference curve approach." Algorithmic Finance, Vol. 2, No. 1, pp. 99--109. Available at https://ssrn.com/abstract=2003638.
- Carr, P. and M. López de Prado (2014): "Determining optimal trading rules without backtesting." Working paper. Available at https://ssrn.com/abstract=2658641.
- López de Prado, M. (2012a): "Portfolio oversight: An evolutionary approach." Lecture at Cornell University. Available at https://ssrn.com/abstract=2172468.
- López de Prado, M. (2012b): "The sharp razor: Performance evaluation with non-normal returns." Lecture at Cornell University. Available at https://ssrn.com/abstract=2150879.
- López de Prado, M. (2013): "What to look for in a backtest." Lecture at Cornell University. Available at https://ssrn.com/abstract=2308682.
- López de Prado, M. (2014a): "Optimal trading rules without backtesting." Lecture at Cornell University. Available at https://ssrn.com/abstract=2502613.
- López de Prado, M. (2014b): "Deflating the Sharpe ratio." Lecture at Cornell University. Available at https://ssrn.com/abstract=2465675.
- López de Prado, M. (2015a): "Quantitative meta-strategies." Practical Applications, Institutional Investor Journals, Vol. 2, No. 3, pp. 1--3. Available at https://ssrn.com/abstract=2547325.
- López de Prado, M. (2015b): "The Future of empirical finance." Journal of Portfolio Management, Vol. 41, No. 4, pp. 140--144. Available at https://ssrn.com/abstract=2609734.
- López de Prado, M. (2015c): "Backtesting." Lecture at Cornell University. Available at https://ssrn.com/abstract=2606462.
- López de Prado, M. (2015d): "Recent trends in empirical finance." Journal of Portfolio Management, Vol. 41, No. 4, pp. 29--33. Available at https://ssrn.com/abstract=2638760.
- López de Prado, M. (2015e): "Why most empirical discoveries in finance are likely wrong, and what can be done about it." Lecture at University of Pennsylvania. Available at https://ssrn.com/abstract=2599105.
- López de Prado, M. (2015f): "Advances in quantitative meta-strategies." Lecture at Cornell University. Available at https://ssrn.com/abstract=2604812.
- López de Prado, M. (2016): "Building diversified portfolios that outperform out-of-sample." Journal of Portfolio Management, Vol. 42, No. 4, pp. 59--69. Available at https://ssrn.com/abstract=2708678.
- López de Prado, M. and M. Foreman (2014): "A mixture of Gaussians approach to mathematical portfolio oversight: The EF3M algorithm." Quantitative Finance, Vol. 14, No. 5, pp. 913--930. Available at https://ssrn.com/abstract=1931734.
- López de Prado, M. and A. Peijan (2004): "Measuring loss potential of hedge fund strategies." Journal of Alternative Investments, Vol. 7, No. 1, pp. 7--31, Summer 2004. Available at https://ssrn.com/abstract=641702.
- López de Prado, M., R. Vince, and J. Zhu (2015): "Risk adjusted growth portfolio in a finite investment horizon." Lecture at Cornell University. Available at https://ssrn.com/abstract=2624329.