金融中的交叉验证#
7.1 动机#
交叉验证(CV)的目的是确定 ML 算法的泛化误差,以防止过拟合。CV 是标准 ML 技术在应用于金融问题时失败的又一个实例。过拟合将会发生,而 CV 将无法检测到它。事实上,CV 将通过超参数调优助长过拟合。在本章中,我们将学习标准 CV 为什么在金融中失效,以及可以做些什么。
7.2 交叉验证的目标#
ML 的目的之一是学习数据的一般结构,以便我们能在未来的、未见过的特征上做出预测。当我们在用于训练的同一数据集上测试 ML 算法时,不出所料地获得了惊人的结果。当 ML 算法被那样误用时,它们与有损压缩算法没有什么不同:它们能以极高的保真度概括数据,但预测力为零。
CV 将从 IID 过程抽取的观测分为两个集合:训练集和测试集。完整数据集中的每个观测属于且仅属于一个集合。这是为了防止一个集合向另一个集合泄露,因为那将破坏在未见数据上测试的目的。更多细节可在参考文献部分列出的书籍和文章中找到。
有许多替代 CV 方案,其中最流行之一是 k 折 CV。图 7.1 说明了 k 折 CV 执行的 k 次训练/测试划分,其中 k = 5。在该方案中:
- 数据集被划分为 k 个子集。
- 对于 i = 1,...,k
- ML 算法在排除 i 的所有子集上训练。
- 拟合的 ML 算法在 i 上测试。
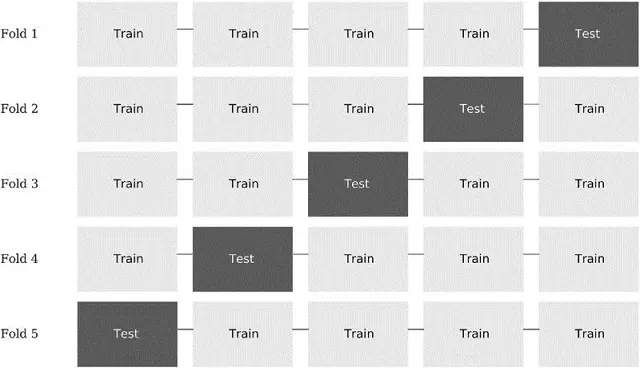
图 7.1 5 折 CV 方案中的训练/测试划分
k 折 CV 的结果是一个 k×1 的交叉验证性能指标数组。例如,在二元分类器中,如果交叉验证精度超过 1/2,则认为模型学到了东西,因为那是我们抛均匀硬币将获得的精度。
在金融中,CV 通常用于两种场景:模型开发(如超参数调优)和回测。回测是一个复杂的主题,我们将在第 10-16 章中充分讨论。在本章中,我们将专注于模型开发的 CV。
7.3 为什么 K 折交叉验证在金融中失效#
到目前为止,你可能读过不少金融论文,它们提供 k 折 CV 证据表明 ML 算法表现良好。遗憾的是,这些结果几乎可以确定是错误的。k 折 CV 在金融中失效的一个原因是,不能假设观测来自 IID 过程。CV 失败的第二个原因是,测试集在模型开发过程中被多次使用,导致多重检验和选择偏差。我们将在第 11-13 章重新审视这第二个失败原因。目前,让我们只关注第一个失败原因。
当训练集包含也出现在测试集中的信息时,就会发生泄露。考虑一个序列相关的特征 X,它与在重叠数据上形成的标签 Y 关联:
- 由于序列相关,X
t≈ Xt+1。 - 由于标签从重叠数据点导出,Y
t≈ Yt+1。
通过将 t 和 t+1 放入不同集合,信息泄露了。当分类器首先在 (Xt, Yt) 上训练,然后被要求基于观测 Xt+1 预测 E[Yt+1|Xt+1] 时,即使 X 是无关特征,该分类器也更可能达到 Yt+1 = E[Yt+1|Xt+1]。
如果 X 是预测性特征,泄露将增强已有价值策略的表现。问题在于无关特征存在时的泄露,因为这会导致错误发现。至少有两种方法可以降低泄露的可能性:
- 从训练集中丢弃任何观测 i,其中 Y
i是用于确定 Yj的信息的函数,且 j 属于测试集。- 例如,Y
i和 Yj不应跨越重叠期间(样本唯一性的讨论见第 4 章)。
- 例如,Y
- 避免过拟合分类器。这样,即使发生一些泄露,分类器也无法从中获利。使用:
考虑 Xi 和 Xj 在重叠信息上形成的情况,其中 i 属于训练集,j 属于测试集。这是信息泄露的情况吗?不一定,只要 Yi 和 Yj 独立。要发生泄露,必须 (Xi, Yi) ≈ (Xj, Yj),而 Xi ≈ Xj 或甚至 Yi ≈ Yj 都不充分。
7.4 解决方案:净化 K 折交叉验证#
减少泄露的一种方法是从训练集中清除所有标签在时间上与测试集中包含的标签重叠的观测。我将此过程称为「净化」(purging)。此外,由于金融特征通常包含表现出序列相关的序列(如 ARMA 过程),我们应该从训练集中消除紧随测试集中观测之后的观测。我将此过程称为「禁运」(embargo)。
7.4.1 净化训练集#
假设一个测试观测,其标签 Yj 基于信息集 Φj 决定。为了防止上一节描述的泄露类型,我们希望从训练集中清除任何标签 Yi 基于信息集 Φi 决定的观测,使得 Φi ∩ Φj = ∅。
特别地,当两个观测 i 和 j 的标签 Yi 和 Yj 并发时(见第 4 章第 4.3 节),即两个标签都取决于至少一次共同随机抽取,我们将确定它们之间存在信息重叠。例如,考虑一个标签 Yj,它是闭区间 t ∈ [tj,0, tj,1] 内观测的函数,Yj = f[[tj,0, tj,1]](对记号有滥用)。例如,在三重障碍标记法(第 3 章)的上下文中,这意味着标签是索引 tj,0 和 tj,1 之间价格条跨越的收益符号,即  。标签 Y
i = f[[ti,0, ti,1]] 与 Yj 重叠,如果满足三个充分条件中的任何一个:
- t
j,0≤ ti,0≤ tj,1 - t
j,0≤ ti,1≤ tj,1 - t
i,0≤ tj,0≤ tj,1≤ ti,1
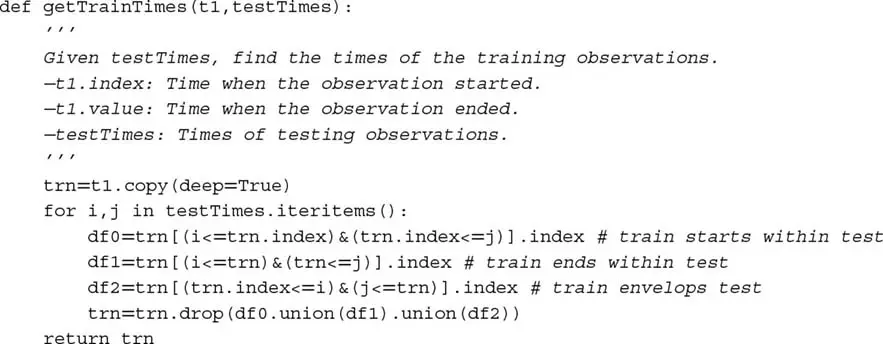
代码片段 7.1 实现了从训练集中净化观测。如果测试集是连续的(即第一个和最后一个测试观测之间没有训练观测),则可以加速净化:对象 testTimes 可以是具有单个项目的 pandas 序列,跨越整个测试集。
代码片段 7.1 净化训练集中的观测
当发生泄露时,仅通过增加 k → T(其中 T 是条数)就能改善性能。原因是测试划分的数量越大,训练集中重叠观测的数量越多。在许多情况下,净化足以防止泄露:随着我们增加 k,性能将改善,因为我们允许模型更频繁地重新校准。但超过某个值 k* 后,性能将不再改善,表明回测没有从泄露中获利。图 7.2 绘制了 k 折 CV 的一个划分。测试集被两个训练集包围,产生了两个必须净化以防止泄露的重叠。
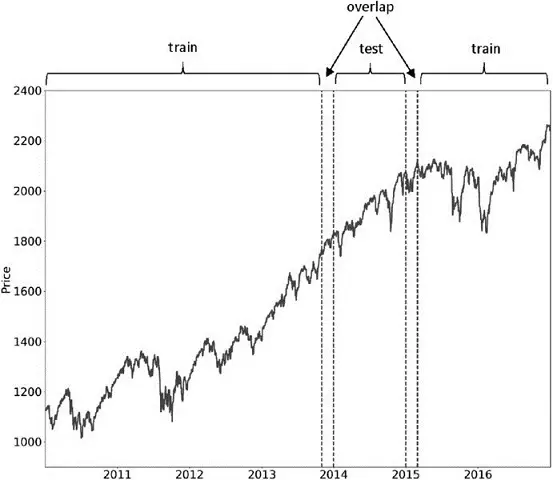
图 7.2 净化训练集中的重叠
7.4.2 禁运#
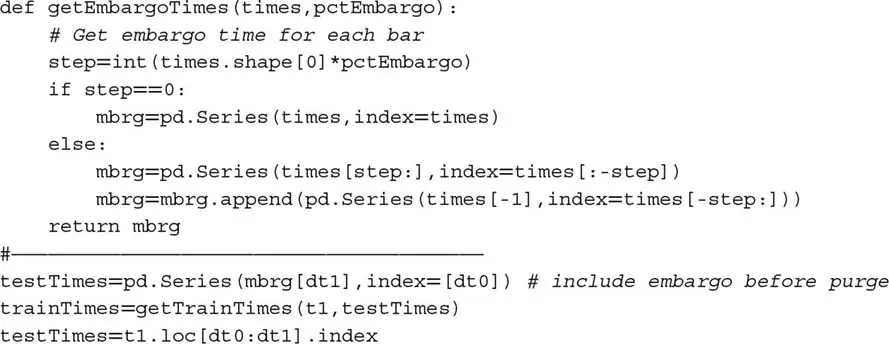
对于净化无法防止所有泄露的情况,我们可以在每个测试集之后对训练观测施加禁运。禁运不需要影响测试集之前的训练观测,因为训练标签 Yi = f[[ti,0, ti,1]](其中 ti,1 < tj,0,训练在测试开始前结束),包含的信息在测试时间 tj,0 时是可用的。换言之,我们只关心紧随测试之后的训练标签 Yi = f[[ti,0, ti,1]],tj,1 ≤ ti,0 ≤ tj,1 + h。我们可以通过在净化前设置 Yj = f[[tj,0, tj,1 + h]] 来实现该禁运期 h。一个较小的值 h ≈ 0.01T 通常足以防止所有泄露,这可以通过测试增加 k → T 时性能是否不会无限改善来确认。图 7.3 说明了紧随测试集之后的训练观测的禁运。代码片段 7.2 实现了禁运逻辑。
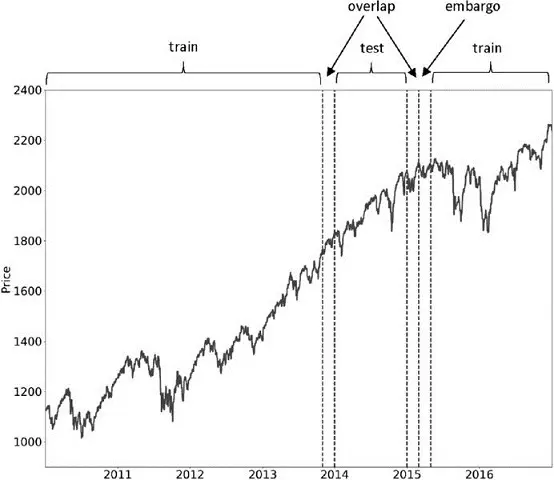
图 7.3 测试后训练观测的禁运
代码片段 7.2 训练观测的禁运
7.4.3 净化 K 折类#
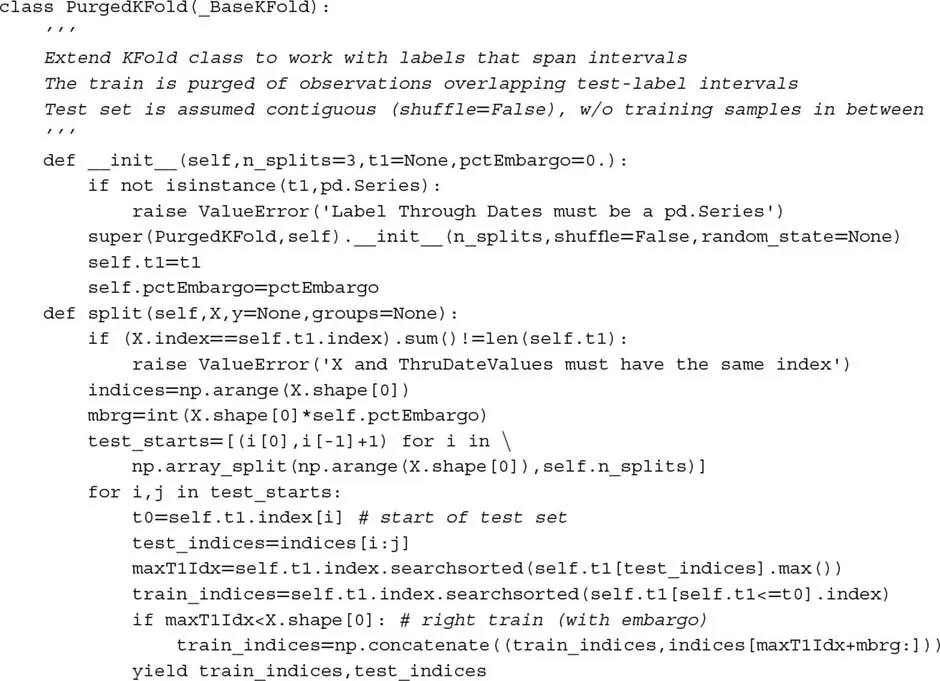
在前面的章节中,我们讨论了当标签重叠时如何产生训练/测试划分。这引入了净化和禁运的概念,特别是在模型开发的上下文中。一般来说,每当我们产生训练/测试划分时——无论是用于超参数拟合、回测还是性能评估——都需要净化和禁运重叠的训练观测。代码片段 7.3 扩展了 scikit-learn 的 KFold 类,以考虑测试信息泄露到训练集的可能性。
代码片段 7.3 观测重叠时的交叉验证类
7.5 Sklearn 交叉验证的缺陷#
你可能认为像交叉验证这样关键的东西会在最流行的 ML 库之一中被完美实现。遗憾的是,情况并非如此,这是你必须始终阅读你运行的所有代码的原因之一,也是开源的有力论据之一。开源代码的众多优势之一是你可以验证一切并根据需要进行调整。代码片段 7.4 解决了两个已知的 sklearn bug:
- 评分函数不知道
classes_,这是 sklearn 依赖 numpy 数组而非 pandas 序列的结果:https://github.com/scikit-learn/scikit-learn/issues/6231 cross_val_score会给出不同结果,因为它将权重传递给 fit 方法,但不传给log_loss方法:https://github.com/scikit-learn/scikit-learn/issues/9144
代码片段 7.4 使用
purgedKFold类
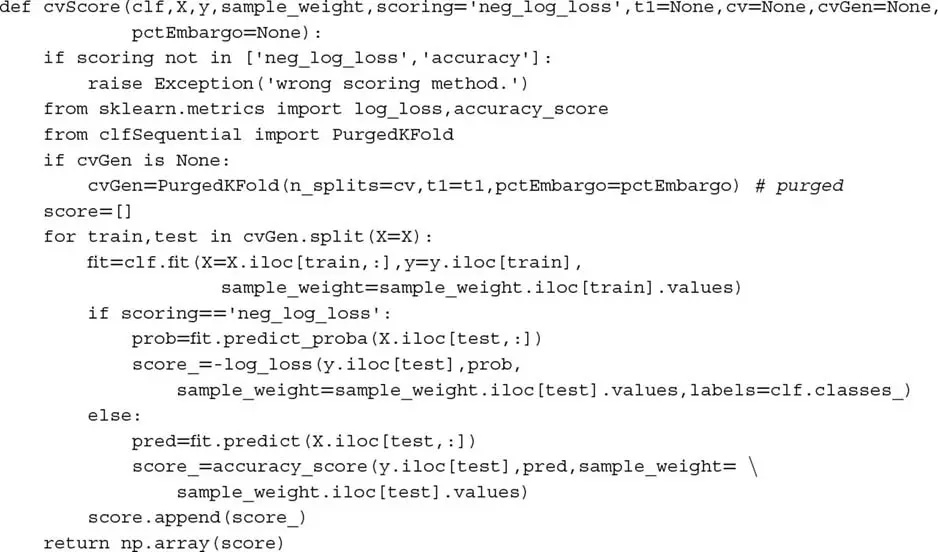
请理解,这些 bug 的修复被商定、实现、测试和发布可能需要很长时间。在此之前,你应该使用代码片段 7.4 中的 cvScore,避免运行 cross_val_score 函数。
练习题#
为什么在金融中,在进行 k 折 CV 之前打乱数据集通常是个坏主意?打乱的目的是什么?为什么打乱会破坏 k 折 CV 在金融数据集中的目的?
取一对矩阵 (X, y),代表观测特征和标签。这可以是第 3 章练习中导出的数据集之一。
- 推导 RF 分类器在 (X, y) 上的 10 折 CV 性能,不打乱。
- 推导 RF 在 (X, y) 上的 10 折 CV 性能,打乱。
- 为什么两个结果如此不同?
- 打乱如何泄露信息?
取你在练习 2 中使用的同一对矩阵 (X, y)。
- 推导 RF 在 (X, y) 上的 10 折净化 CV 性能,1% 禁运。
- 为什么性能更低?
- 为什么这个结果更现实?
在本章中,我们关注了 k 折 CV 在金融应用中失败的一个原因,即测试集的一些信息泄露到训练集中。你能想到 CV 失败的第二个原因吗?
假设你尝试同一投资策略的一千种配置,并对每种进行 CV。一些结果纯粹靠运气就保证看起来不错。如果你只发表那些正面结果,隐藏其余的,你的受众将无法推断这些结果是假阳性——一个统计偶然。这种现象被称为「选择偏差」。
- 你能想象一个防止此问题的程序吗?
- 如果我们将数据集分为三个集合:训练、验证和测试?验证集用于评估训练参数,测试仅在验证阶段选择的一个配置上运行。该程序在什么情况下仍然失败?
- 避免选择偏差的关键是什么?
参考书目#
- Bharat Rao, R., G. Fung, and R. Rosales (2008): "On the dangers of cross-validation: An experimental evaluation." White paper, IKM CKS Siemens Medical Solutions USA. Available at http://people.csail.mit.edu/romer/papers/CrossVal_SDM08.pdf.
- Bishop, C. (1995): Neural Networks for Pattern Recognition, 1st ed. Oxford University Press.
- Breiman, L. and P. Spector (1992): "Submodel selection and evaluation in regression: The X-random case." White paper, Department of Statistics, University of California, Berkeley. Available at http://digitalassets.lib.berkeley.edu/sdtr/ucb/text/197.pdf.
- Hastie, T., R. Tibshirani, and J. Friedman (2009): The Elements of Statistical Learning, 1st ed. Springer.
- James, G., D. Witten, T. Hastie and R. Tibshirani (2013): An Introduction to Statistical Learning, 1st ed. Springer.
- Kohavi, R. (1995): "A study of cross-validation and bootstrap for accuracy estimation and model selection." International Joint Conference on Artificial Intelligence. Available at http://web.cs.iastate.edu/~jtian/cs573/Papers/Kohavi-IJCAI-95.pdf.
- Ripley, B. (1996): Pattern Recognition and Neural Networks, 1st ed. Cambridge University Press.