分数阶差分特征#
5.1 动机#
众所周知,由于套利力量的作用,金融序列表现出低信噪比(López de Prado [2015])。更糟糕的是,整数差分等标准平稳性变换会通过去除记忆进一步降低信号。价格序列有记忆,因为每个值都依赖于之前水平的漫长历史。相比之下,收益等整数差分序列有记忆截断——历史在有限的样本窗口后完全被忽略。一旦平稳性变换抹去了数据中的所有记忆,统计学家就求助于复杂的数学技术来提取残留的信号。毫不奇怪,在记忆被抹除的序列上应用这些复杂技术很可能导致错误发现。在本章中,我们引入一种数据变换方法,在保留尽可能多记忆的同时确保数据的平稳性。
5.2 平稳性与记忆的困境#
在金融中,非平稳时间序列很常见。使这些序列非平稳的是记忆的存在,即先前水平的漫长历史使序列的均值随时间漂移。为了进行推断分析,研究者需要处理不变的过程,如价格收益(或对数价格变化)、收益率变化或波动率变化。这些数据变换使序列平稳,但代价是去除了原始序列中的所有记忆(Alexander [2001],第 11 章)。虽然平稳性是推断目的的必要属性,但在信号处理中,我们很少希望所有记忆都被抹除,因为该记忆是模型预测力的基础。例如,均衡(平稳)模型需要一些记忆来评估价格过程偏离长期预期值的程度,以生成预测。困境在于:收益是平稳的但无记忆,而价格有记忆但非平稳。问题来了:什么是使价格序列平稳同时保留尽可能多记忆的最小差分程度?相应地,我们希望推广收益的概念,考虑平稳序列中并非所有记忆都被抹除的情况。在此框架下,收益只是许多可能的价格变换中的一种(且在大多数情况下是次优的)。
协整方法的部分重要性在于它们能够对具有记忆的序列建模。但为什么零差分的特殊情况会带来最佳结果?零差分与 1 阶差分一样任意。在这两个极端之间(一端是完全差分的序列,另一端是零差分的序列)有一个宽广的区域,可以通过分数阶差分来探索,以开发高预测力的 ML 模型。
监督学习算法通常需要平稳特征。原因是我们需要将一个以前未见过的(未标记的)观测映射到一组标记示例,并从中推断该新观测的标签。如果特征不平稳,我们无法将新观测映射到大量已知示例。但平稳性并不能确保预测力。平稳性是 ML 算法高性能的必要非充分条件。问题是,平稳性和记忆之间存在权衡。我们总是可以通过差分使序列更平稳,但这将以抹除一些记忆为代价,从而破坏 ML 算法的预测目的。在本章中,我们将研究一种解决该困境的方法。
5.3 文献综述#
几乎所有金融时间序列文献都基于通过整数变换使非平稳序列平稳的前提(例如见 Hamilton [1994])。这提出了两个问题:(1) 为什么整数 1 阶差分(如用于计算对数价格收益的那样)是最优的?(2) 过度差分是否是文献如此偏向有效市场假说的一个原因?
分数阶差分的概念应用于预测性时间序列分析至少可以追溯到 Hosking [1981]。在那篇论文中,ARIMA 过程族被推广,允许差分阶数取分数值。这很有用,因为分数差分过程表现出长期持续性和反持续性,从而增强了与标准 ARIMA 方法相比的预测力。在同一篇论文中,Hosking 指出:「除了 Granger (1978) 的一笔带过的引用外,分数差分似乎没有在与时间序列分析的关联中被提及过。」
Hosking 的论文之后,关于这一主题的文献出人意料地稀少,总共只有 8 篇期刊文章,作者仅 9 人:Hosking、Johansen、Nielsen、MacKinnon、Jensen、Jones、Popiel、Cavaliere 和 Taylor。详见参考文献。这些论文大多涉及技术问题,如连续随机过程中分数阶差分的快速计算算法(例如 Jensen 和 Nielsen [2014])。
对随机过程进行差分是一种计算昂贵的操作。在本章中,我们将采取一种实用的、替代的、新颖的方法来恢复平稳性:我们将把差分算子推广到非整数步骤。
5.4 方法#
考虑后移算子 B 应用于实值特征矩阵 {Xt},其中 B^k^ Xt = Xt−k,对于任何整数 k ≥ 0。例如,(1 − B)² = 1 − 2B + B²,其中 B² Xt = Xt−2,所以 (1 − B)² Xt = Xt − 2Xt−1 + Xt−2。注意 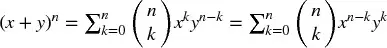 ,对于正整数 n。对于实数 d,
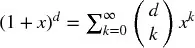 ,即二项式级数。
在分数模型中,指数 d 允许为实数,形式上的二项式级数展开为:
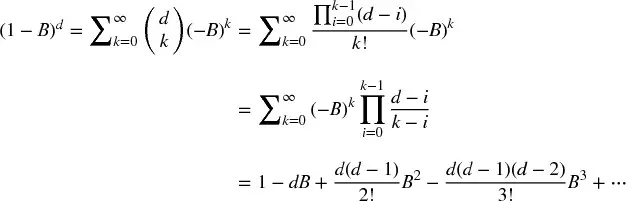
5.4.1 长记忆#
让我们看看一个实数(非整数)正 d 如何保留记忆。这个算术级数由点积构成
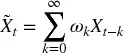
权重为 ω
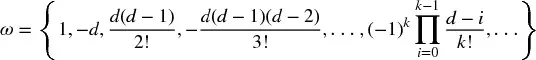
值为 X
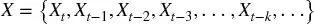
当 d 为正整数时,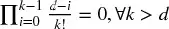 ,超过该点的记忆被取消。例如,d = 1 用于计算收益,其中
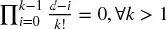 ,ω = {1, −1, 0, 0, ...}。
5.4.2 迭代估计#
观察权重序列 ω,我们可以认识到对于 k = 0, ..., ∞,ω0 = 1,权重可以迭代生成为:
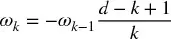
图 5.1 绘制了用于计算分数阶差分序列每个值的权重序列。图例报告了用于生成每个序列的 d 值,x 轴表示 k 的值,y 轴显示 ωk 的值。例如,对于 d = 0,除 ω0 = 1 外所有权重为 0。这是差分序列与原始序列重合的情况。对于 d = 1,除 ω0 = 1 和 ω1 = −1 外所有权重为 0。这是标准的一阶整数差分,用于推导对数价格收益。在这两种情况之间的任何位置,ω0 = 1 之后的所有权重为负且大于 −1。
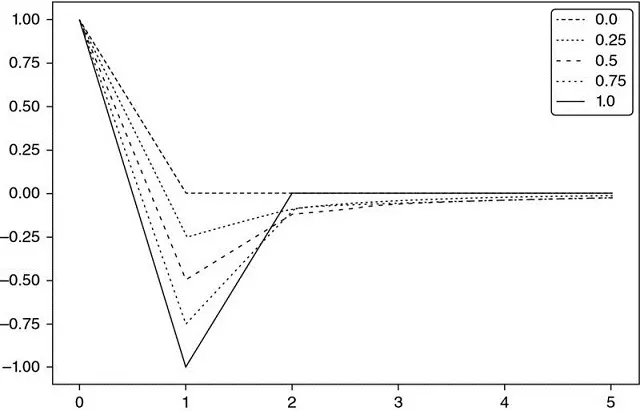
图 5.1 ωk(y 轴)随 k 增大(x 轴)。每条线对应 d ∈ [0,1] 的一个特定值,增量为 0.1。
图 5.2 绘制了 d ∈ [1, 2]、增量为 0.1 的权重序列。对于 d > 1,我们观察到 ω1 < −1 且 ωk > 0,∀k ≥ 2。
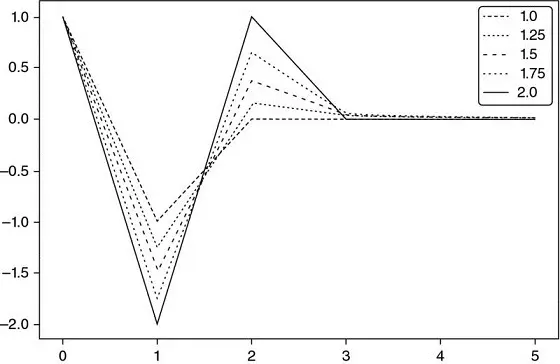
图 5.2 ωk(y 轴)随 k 增大(x 轴)。每条线对应 d ∈ [1,2] 的一个特定值,增量为 0.1。
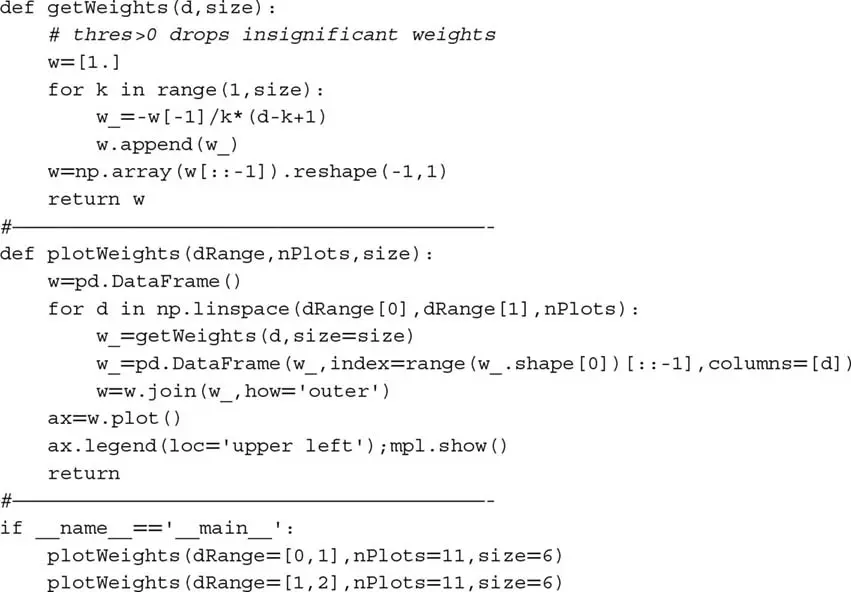
代码片段 5.1 列出了用于生成这些图的代码。
代码片段 5.1 权重函数
5.4.3 收敛#
让我们考虑权重的收敛。从上面的结果可以看出,对于 k > d,如果 ωk−1 ≠ 0,则 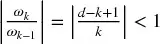 ,否则 ω
k = 0。因此,权重渐近收敛到零,作为单位圆内因子的无限乘积。此外,对于正 d 和 k < d + 1,有  ,这使初始权重符号交替。对于非整数 d,一旦 k ≥ d + 1,ω
k 在 int[d] 为偶数时为负,否则为正。总结,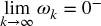 (从左侧收敛到零)当 int[d] 为偶数时,
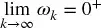 (从右侧收敛到零)当 int[d] 为奇数时。在 d ∈ (0, 1) 的特殊情况下,这意味着 −1 < ω
k < 0,∀k > 0。权重符号的这种交替对于使  平稳是必要的,因为记忆在长期中减弱或被抵消。
5.5 实现#
在本节中,我们将探索分数阶差分的两种替代实现:标准的「扩展窗口」方法,以及我称之为「固定宽度窗口分数阶差分」(Fixed-width window fracdiff, FFD)的新方法。
5.5.1 扩展窗口#
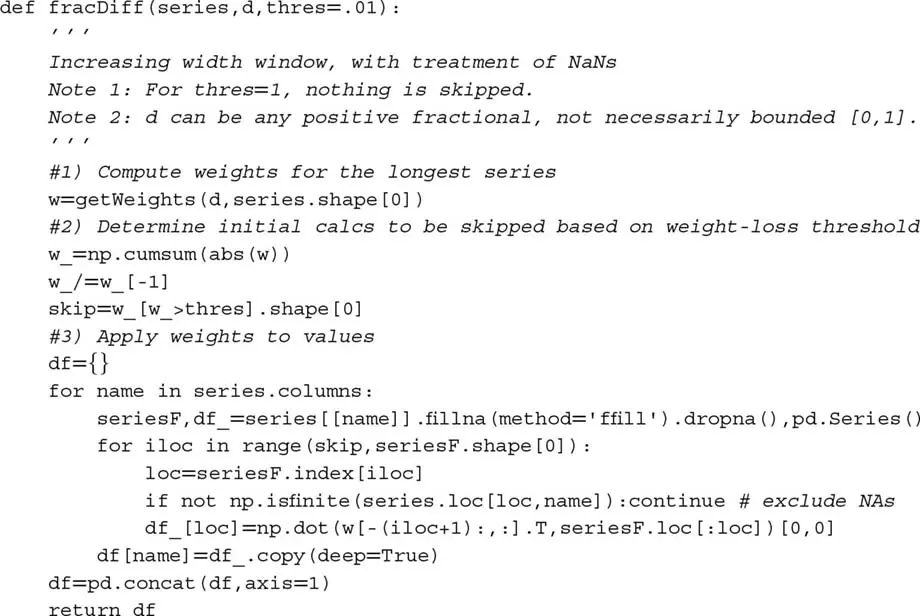
让我们讨论如何在实践中对(有限)时间序列进行分数阶差分。假设一个具有 T 个实观测的时间序列 {Xt},t = 1, ..., T。由于数据限制,分数阶差分值  无法在无限权重序列上计算。例如,最后一个点
 将使用权重 {ω
k},k = 0, ..., T−1,而  将使用权重 {ω
k},k = 0, ..., T−l−1。这意味着初始点与最终点相比将有不同数量的记忆。对于每个 l,我们可以确定相对权重损失 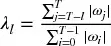 。给定容忍水平 τ ∈ [0, 1],我们可以确定值 l* 使得
 和
 。该值 l* 对应于第一个权重损失超出可接受阈值的结果
 ,λ
t > τ(例如 τ = 0.01)。
从我们之前的讨论中可以清楚看出, 取决于 {ω
k} 的收敛速度,而收敛速度又取决于 d ∈ [0, 1]。对于 d = 1,ωk = 0,∀k > 1,λl = 0,∀l > 1,因此只需丢弃  。随着 d → 0^+^,l* 增大,初始
 的更大部分需要被丢弃以保持权重损失
 。图 5.3 绘制了 E-mini S&P 500 期货规模 1E4 的交易条、向前展期、分数阶差分,参数(d = .4, τ = 1)在上图,参数(d = .4, τ = 1E−2)在下图。
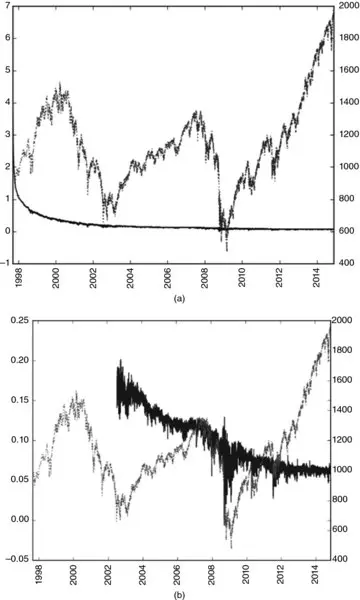
图 5.3 不控制权重损失的分数阶差分(上图)和使用扩展窗口控制权重损失后的分数阶差分(下图)
两个图中的负漂移是由窗口扩展时添加到初始观测的负权重引起的。当我们不控制权重损失时,负漂移是极端的,以至于只有该趋势可见。右图中控制权重损失后,负漂移有所缓和,但仍然很大,因为值 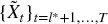 是在扩展窗口上计算的。这个问题可以通过固定宽度窗口来纠正,见代码片段 5.2。
代码片段 5.2 标准分数阶差分(扩展窗口)
5.5.2 固定宽度窗口分数阶差分#
或者,可以使用固定宽度窗口计算分数阶差分,即在权重的模 |ωk| 低于给定阈值 (τ) 后丢弃权重。这等价于找到第一个 l* 使得  和
 ,设置新变量

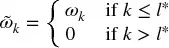
且 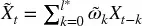 ,对于 t = T − l* + 1, ..., T。图 5.4 绘制了 E-mini S&P 500 期货规模 1E4 的交易条、向前展期、分数阶差分(d = .4, τ = 1E−5)。
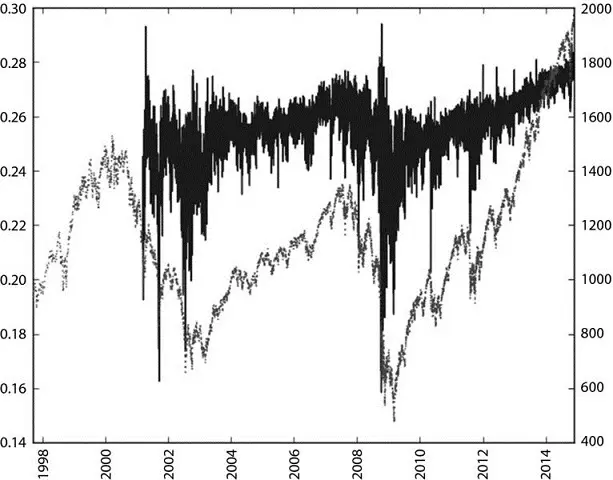
图 5.4 使用固定宽度窗口控制权重损失后的分数阶差分
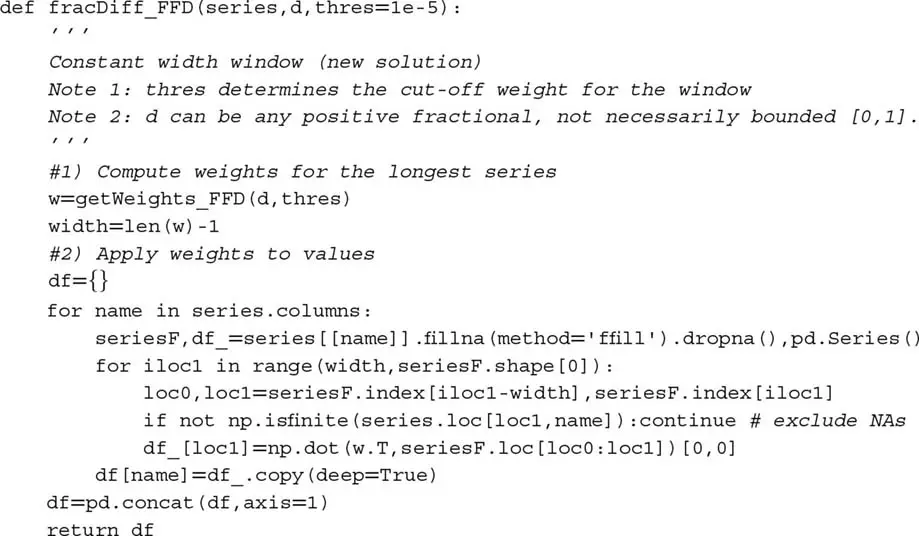
该过程的优势在于,相同的权重向量用于  的所有估计,从而避免了扩展窗口添加权重引起的负漂移。结果是水平和噪声的无漂移混合,如预期的那样。由于记忆带来的偏度和过度峰度,分布不再是高斯的,但它是平稳的。代码片段 5.3 展示了该思想的实现。
代码片段 5.3 新的固定宽度窗口分数阶差分方法
5.6 最大记忆保留下的平稳性#
考虑一个序列 {Xt}t=1,...,T。对该序列应用固定宽度窗口分数阶差分(FFD)方法,我们可以计算使所得分数阶差分序列  平稳的最小系数 d*。该系数 d* 量化了为达到平稳性需要去除的记忆量。如果
 已经平稳,则 d* = 0。如果
 包含单位根,则 d* < 1。如果
 表现出爆炸性行为(如泡沫),则 d* > 1。一个特别值得关注的情况是 0 < d* ≪ 1,当原始序列「轻度非平稳」时。在这种情况下,虽然需要差分,但完整的整数差分会去除过多的记忆(和预测力)。
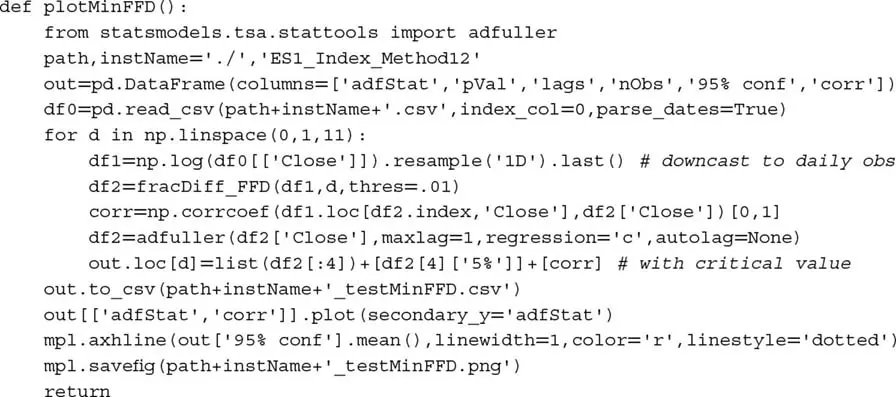
图 5.5 说明了这个概念。在右 y 轴上,它绘制了在 E-mini S&P 500 期货对数价格上计算的 ADF 统计量(使用 ETF 技巧向前展期,见第 2 章),下采样到日频,回溯到合约开始。在 x 轴上,显示用于生成计算 ADF 统计量的序列的 d 值。原始序列的 ADF 统计量为 −0.3387,而收益序列的 ADF 统计量为 −46.9114。在 95% 置信水平下,检验的临界值为 −2.8623。ADF 统计量在 d = 0.35 附近跨越该阈值。左 y 轴绘制了原始序列(d = 0)与各种 d 值下差分序列之间的相关性。在 d = 0.35 时,相关性仍然很高,为 0.995。这证实了本章引入的过程在实现平稳性的同时没有放弃太多记忆方面是成功的。相比之下,原始序列与收益序列之间的相关性仅为 0.03,这表明标准整数差分几乎完全抹去了序列的记忆。
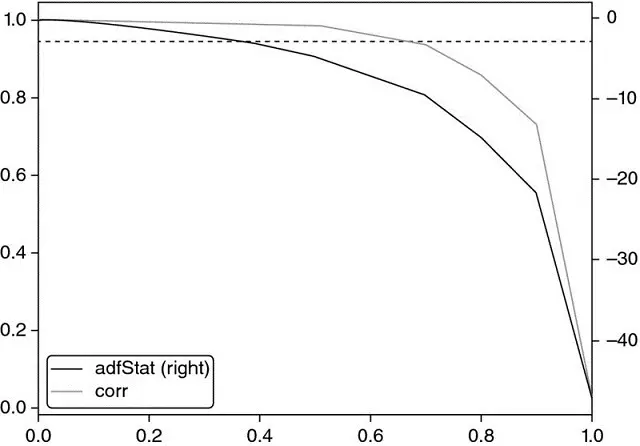
图 5.5 E-mini S&P 500 期货对数价格上 ADF 统计量随 d 变化的函数
几乎所有金融论文都试图通过应用整数差分 d = 1 ≫ 0.35 来恢复平稳性,这意味着大多数研究过度差分了序列,即去除了比满足标准计量经济学假设所需的更多记忆。代码片段 5.4 列出了用于产生这些结果的代码。
代码片段 5.4 寻找通过 ADF 检验的最小 D 值
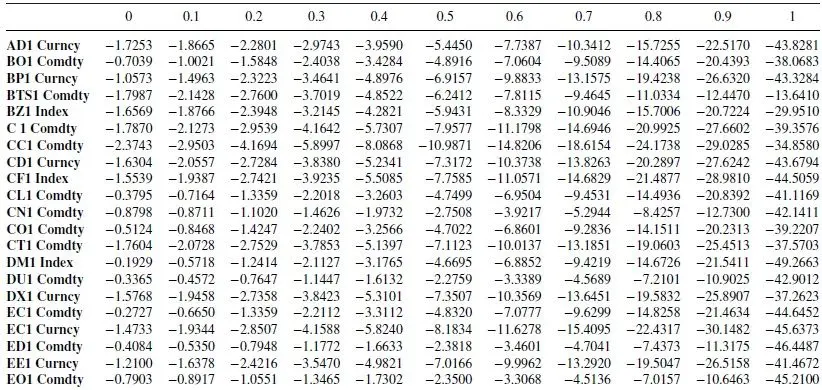
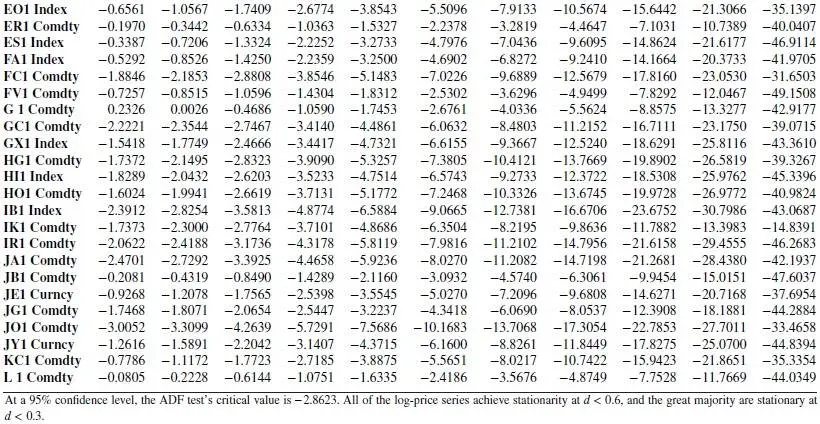
E-mini 期货上的例子绝非例外。表 5.1 显示了对全球 87 种最流动性期货应用 FFD(d) 后各种 d 值的 ADF 统计量。在所有情况下,用于计算收益的标准 d = 1 意味着过度差分。事实上,在所有情况下,平稳性都在 d < 0.6 时达到。在某些情况下,如橙汁(JO1 Comdty)或活牛(LC1 Comdty),完全不需要差分。
表 5.1 一些最流动性期货合约的 FFD(d) ADF 统计量
5.7 结论#
总结,大多数计量经济分析遵循两种范式之一:
- Box-Jenkins:收益是平稳的,但无记忆。
- Engle-Granger:对数价格有记忆,但非平稳。协整是使回归在非平稳序列上工作的技巧,从而保留记忆。然而,协整变量的数量有限,且协整向量以不稳定著称。
相比之下,本章引入的 FFD 方法表明,不需要放弃所有记忆来获得平稳性。而且对于 ML 预测,不需要协整技巧。一旦你熟悉了 FFD,它将允许你在不放弃记忆(或预测力)的情况下实现平稳性。
在实践中,我建议你对特征尝试以下变换:第一,计算时间序列的累积和。这保证了需要某种阶数的差分。第二,对各种 d ∈ [0, 1] 计算 FFD(d) 序列。第三,确定使 FFD(d) 上 ADF 统计量的 p 值降至 5% 以下的最小 d。第四,使用 FFD(d) 序列作为预测特征。
练习题#
从 IID 高斯随机过程生成时间序列。这是一个无记忆、平稳的序列:
- 计算该序列的 ADF 统计量。p 值是多少?
- 计算观测的累积和。这是一个无记忆的非平稳序列。
- 该累积序列的积分阶数是多少?
- 计算该序列的 ADF 统计量。p 值是多少?
- 对序列差分两次。该过度差分序列的 p 值是多少?
生成一个遵循正弦函数的时间序列。这是一个有记忆的平稳序列。
- 计算该序列的 ADF 统计量。p 值是多少?
- 将每个观测移动相同的正值。计算观测的累积和。这是一个有记忆的非平稳序列。
- 计算该序列的 ADF 统计量。p 值是多少?
- 应用扩展窗口分数阶差分,τ = 1E−2。对于什么最小 d 值你得到 p 值低于 5%?
- 应用 FFD,τ = 1E−5。对于什么最小 d 值你得到 p 值低于 5%?
取练习 2.b 的序列:
- 将序列拟合到正弦函数。R 平方是多少?
- 应用 FFD(d=1)。将序列拟合到正弦函数。R 平方是多少?
- 什么 d 值最大化 FFD(d) 上正弦拟合的 R 平方?为什么?
取 E-mini S&P 500 期货的美元条序列。使用代码片段 5.3 的代码,对某个 d ∈ [0, 2],计算
fracDiff_FFD(fracDiff_FFD(series,d),-d)。你得到什么?为什么?取 E-mini S&P 500 期货的美元条序列。
- 形成一个新序列作为对数价格的累积和。
- 应用 FFD,τ = 1E−5。确定对于什么最小 d ∈ [0, 2] 新序列是平稳的。
- 计算分数阶差分序列与原始(未变换)序列的相关性。
- 对原始序列和分数阶差分序列应用 Engle-Granger 协整检验。它们协整吗?为什么?
- 对分数阶差分序列应用 Jarque-Bera 正态性检验。
取练习 5 的分数阶差分序列。
参考文献#
- Alexander, C. (2001): Market Models, 1st edition. John Wiley & Sons.
- Hamilton, J. (1994): Time Series Analysis, 1st ed. Princeton University Press.
- Hosking, J. (1981): "Fractional differencing." Biometrika, Vol. 68, No. 1, pp. 165--176.
- Jensen, A. and M. Nielsen (2014): "A fast fractional difference algorithm." Journal of Time Series Analysis, Vol. 35, No. 5, pp. 428--436.
- López de Prado, M. (2015): "The Future of Empirical Finance." Journal of Portfolio Management, Vol. 41, No. 4, pp. 140--144. Available at https://ssrn.com/abstract=2609734.
参考书目#
- Cavaliere, G., M. Nielsen, and A. Taylor (2017): "Quasi-maximum likelihood estimation and bootstrap inference in fractional time series models with heteroskedasticity of unknown form." Journal of Econometrics, Vol. 198, No. 1, pp. 165--188.
- Johansen, S. and M. Nielsen (2012): "A necessary moment condition for the fractional functional central limit theorem." Econometric Theory, Vol. 28, No. 3, pp. 671--679.
- Johansen, S. and M. Nielsen (2012): "Likelihood inference for a fractionally cointegrated vector autoregressive model." Econometrica, Vol. 80, No. 6, pp. 2267--2732.
- Johansen, S. and M. Nielsen (2016): "The role of initial values in conditional sum-of-squares estimation of nonstationary fractional time series models." Econometric Theory, Vol. 32, No. 5, pp. 1095--1139.
- Jones, M., M. Nielsen and M. Popiel (2015): "A fractionally cointegrated VAR analysis of economic voting and political support." Canadian Journal of Economics, Vol. 47, No. 4, pp. 1078--1130.
- Mackinnon, J. and M. Nielsen, M. (2014): "Numerical distribution functions of fractional unit root and cointegration tests." Journal of Applied Econometrics, Vol. 29, No. 1, pp. 161--171.