金融数据结构#
2.1 动机#
在本章中我们将学习如何处理非结构化的金融数据,并从中导出适合 ML 算法的结构化数据集。一般来说,你不想消费别人已处理过的数据集,因为可能的结果是你发现了别人已经知道或即将发现的东西。理想情况下,你的起点是一批非结构化的原始数据,你将以某种方式处理它,从而导出信息丰富的特征。
2.2 金融数据的基本类型#
金融数据有多种形态。表 2.1 展示了四种基本类型的金融数据,按多样性从左到右递增排列。接下来,我们将讨论它们的不同性质和应用。
表 2.1 金融数据的四种基本类型
| 基本面数据 | 市场数据 | 分析数据 | 另类数据 |
|---|---|---|---|
| - 资产 - 负债 - 销售额 - 成本/利润 - 宏观变量 - ... | - 价格/收益率/隐含波动率 - 成交量 - 股息/利息 - 公开市场操作利率 - 报价/撤单 - 主动方 - ... | - 分析师推荐 - 信用评级 - 盈利预期 - 新闻情绪 - ... | - 卫星/监控图像 - Google 搜索 - Twitter/聊天 - 元数据 - ... |
2.2.1 基本面数据#
基本面数据涵盖可在监管文件和商业分析中找到的信息。它主要是会计数据,按季度报告。这种数据的一个特点是报告时有滞后。你必须确认每个数据点确切的发布时间,以便你的分析只在该信息公开可用之后才使用它。一个常见的初学者错误是假设该数据在报告期末发布。事实从来不是这样。
例如,Bloomberg 发布的基本面数据按报告中包含的最后日期索引,该日期先于发布日期(通常早 1.5 个月)。换言之,Bloomberg 将这些值分配到一个它们尚不为人知的日期。你不会相信每年有多少论文使用了错位的基本面数据,尤其是在因子投资文献中。一旦你正确对齐数据,那些论文中的大量发现都无法复现。
基本面数据的第二个特点是它经常被回填或更正。「回填」(backfilling)意味着为缺失数据分配一个值,即使这些值在当时是未知的。「更正值」(reinstated value)是修正初始错误发布的值。一家公司可能在首次发布很久之后对过去一个季度的结果发布多次更正,数据供应商可能用更正覆盖初始值。问题是,更正值在首次发布日期并不为人所知。一些数据供应商通过为每个变量存储多个发布日期和值来规避这个问题。例如,我们通常对单次季度 GDP 发布有三个值:原始发布值和两次月度修正。然而,非常常见的是,有研究使用最终发布值并将其分配到首次发布的时间,甚至报告期的最后一天。我们将在第 11 章讨论回测错误时重新审视这个错误及其影响。
基本面数据非常规整且低频。由于对市场如此可及,剩余可利用的价值很可能不多。不过,它与其他数据类型结合时可能有用。
2.2.2 市场数据#
市场数据包括在交易所(如 CME)或交易场所(如 MarketAxess)发生的所有交易活动。理想情况下,你的数据提供商给了你原始数据流,包含各种非结构化信息,如允许你完全重构交易簿的 FIX 消息,或 BWIC(竞价需求)的完整响应集合。每个市场参与者在交易记录中都留下特征性的足迹,只要有足够的耐心,你就能找到预判竞争对手下一步行动的方法。例如,TWAP 算法留下非常特别的足迹,掠夺性算法利用它来抢跑其日末交易(通常是对冲)活动(Easley、López de Prado 和 O'Hara [2011])。人工 GUI 交易员通常以整手交易,你可以利用这个事实估计在给定时间点有多少比例的成交量来自他们,然后将其与特定的市场行为关联。
FIX 数据的一个吸引人之处在于它不像基本面数据那样容易处理。它也非常丰富,每天产生超过 10TB 的数据。这使它成为策略研究中更有趣的数据集。
2.2.3 分析数据#
你可以把分析数据看作是基于原始来源(可以是基本面、市场、另类数据,甚至其他分析数据的集合)的衍生数据。分析数据的特征不在于信息的内容,而在于它不是从原始来源直接可得的,且已按特定方式为你处理过。投资银行和研究公司出售来自对公司商业模式、活动、竞争、前景等深入分析的有价值信息。一些专业公司出售从另类数据衍生出的统计数据,例如从新闻报道和社交媒体中提取的情绪。
分析数据的积极方面是信号已从原始来源为你提取。消极方面是分析数据可能昂贵,其生产中使用的方法可能有偏差或不透明,而且你不会是唯一的消费者。
2.2.4 另类数据#
Kolanovic 和 Krishnamachari [2017] 区分了由个人(社交媒体、新闻、网络搜索等)、业务流程(交易、企业数据、政府机构等)和传感器(卫星、地理定位、天气、监控等)产生的另类数据。一些流行的卫星图像或视频流包括监控油轮、隧道交通活动或停车场占用率。
真正表征另类数据的是它是一手信息,即尚未进入其他来源的信息。在 Exxon Mobil 报告盈利增长之前,在其市场价格飙升之前,在分析师撰写关于其最新文件的评论之前——在所有这些之前,就有油轮、钻井平台和管道交通的移动。它们发生在这些活动反映到其他数据类型之前几个月。另类数据的两个问题方面是成本和隐私担忧。所有那些间谍活动都是昂贵的,而且被监视的公司可能会反对,更不用说旁观者了。
另类数据提供了使用真正独特、难以处理的数据集的机会。记住,难以存储、操作和运行的数据总是最有前景的。你会认识到一个数据集可能有用——如果它让你的数据基础设施团队头疼的话。也许你的竞争对手出于物流原因没有尝试使用它,或者中途放弃了,或者处理不当。
2.3 价格条#
为了在非结构化数据上应用 ML 算法,我们需要解析它、从中提取有价值的信息,并将这些提取结果存储为规整的格式。大多数 ML 算法假设提取的数据有表格表示。金融从业者通常将这些表的行称为「条」(bars)。我们可以区分两类条方法:(1) 标准条方法,在文献中很常见;(2) 更高级的、信息驱动的方法,资深从业者使用它们,尽管它们(尚)未出现在期刊文章中。在本节中,我们将讨论如何形成这些条。
2.3.1 标准条#
一些条构建方法在金融行业非常流行,以至于大多数数据供应商的 API 都提供其中几种。这些方法的目的是将以不规则频率到达的观测序列(通常称为「非均匀序列」)转换为来自规律采样的均匀序列。
2.3.1.1 时间条
时间条通过以固定时间间隔(例如每分钟一次)采样信息来获得。收集的信息通常包括:
- 时间戳
- 成交量加权平均价(VWAP)
- 开盘价(即第一个价格)
- 收盘价(即最后一个价格)
- 最高价
- 最低价
- 成交量等
尽管时间条在从业者和学者中也许是最流行的,但应避免使用它们,原因有二。第一,市场不以恒定的时间间隔处理信息。开盘后的一小时比中午前后(或期货的午夜前后)活跃得多。作为生物,人类根据日照周期组织一天是有道理的。但今天的市场由算法操作,它们在松散的人类监督下交易,CPU 处理周期比时间间隔更为相关(Easley、López de Prado 和 O'Hara [2011])。这意味着时间条在低活动期间过采样信息,在高活动期间欠采样信息。第二,时间采样序列通常表现出较差的统计性质,如序列相关、异方差和非正态收益(Easley、López de Prado 和 O'Hara [2012])。GARCH 模型的开发部分是为了处理与不当采样相关的异方差。正如我们接下来将看到的,将条形成为交易活动的从属过程,可以从一开始就避免这个问题。
2.3.1.2 Tick 条
Tick 条背后的想法很简单:每当发生预定义数量的交易(例如 1000 个 tick)时,就提取前面列出的样本变量(时间戳、VWAP、开盘价等)。这使我们能够将采样与信息到达的代理(tick 产生的速度)同步。
Mandelbrot 和 Taylor [1967] 是最早认识到作为交易次数函数的采样表现出理想统计性质的研究者之一:「固定交易次数上的价格变化可能具有高斯分布。固定时间段上的价格变化可能遵循稳定帕累托分布,其方差为无穷大。由于任何时间段内的交易次数是随机的,上述陈述不一定矛盾。」
自 Mandelbrot 和 Taylor 的论文以来,多项研究证实,作为交易活动函数的采样使我们能获得更接近 IID 正态分布的收益(见 Ané 和 Geman [2000])。这很重要,因为许多统计方法依赖于观测来自 IID 高斯过程的假设。直觉上,我们只能从不变的随机变量中进行推断,而 tick 条比时间条允许更好的推断。
在构建 tick 条时,你需要注意异常值。许多交易所在开盘和收盘时进行集合竞价。这意味着在一段时间内,订单簿累积买卖盘而不匹配。当竞价结束时,一笔以清算价进行的大额交易被公布,数量异常大。这笔竞价交易可能相当于数千个 tick,即使它被报告为一个 tick。
2.3.1.3 成交量条
Tick 条的一个问题是,订单碎片化在 tick 数量中引入了一些任意性。例如,假设卖盘上有一个规模为 10 的订单。如果我们买入 10 手,我们的一笔订单将被记录为一个 tick。如果卖盘上 instead 有 10 个规模为 1 的订单,我们的一笔买入将被记录为 10 笔独立的交易。此外,撮合引擎协议出于操作便利,可以将一笔成交进一步拆分为多笔人为的部分成交。
成交量条通过每当交换了预定义数量的证券单位(股票、期货合约等)时采样来规避这个问题。例如,我们可以每当期货合约交换 1000 个单位时采样价格,无论涉及多少 tick。
如今很难想象,但在 20 世纪 60 年代,供应商很少发布成交量数据,因为客户主要关心 tick 价格。在成交量也开始被报告之后,Clark [1973] 认识到,按成交量采样收益比按 tick 条采样获得了更好的统计性质(即更接近 IID 高斯分布)。相较于时间条或 tick 条,偏好成交量条的另一个原因是,几种市场微观结构理论研究价格与成交量之间的交互。作为这些变量之一函数的采样是这些分析的便利手段,我们将在第 19 章中发现。
2.3.1.4 美元条
美元条通过每当交换了预定义市场价值时采样一个观测来形成。当然,对美元的引用意指证券计价的货币,但没有人提到欧元条、英镑条或日元条(虽然金条会是一个有趣的双关语)。
让我用几个例子说明美元条背后的原理。第一,假设我们希望分析一只在一定时期内升值 100% 的股票。在期末卖出价值 1000 美元的该股票,所需交易的股数是期初买入 1000 美元该股票所需的一半。换言之,交易的股数是实际交换价值的函数。因此,以交换的美元价值而非 tick 或成交量来采样条是有意义的,尤其当分析涉及显著价格波动时。这一点可以被经验验证。如果你在给定条大小下计算 E-mini S&P 500 期货的 tick 条和成交量条,每天的条数多年来会剧烈变化。一旦你在恒定条大小下计算多年来的每日美元条数,该变化范围和速度都会减小。图 2.1 绘制了在 tick、成交量和美元采样方法上应用固定条大小时的每日条数的指数加权平均值。
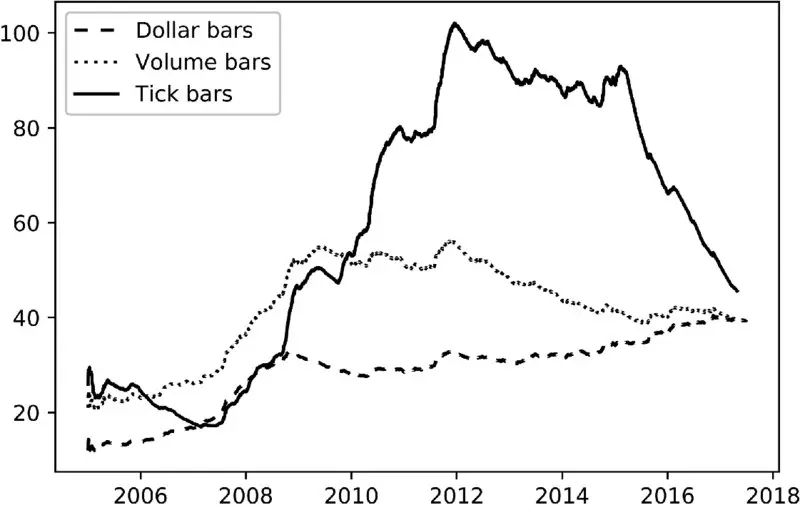
图 2.1 Tick、成交量和美元条的平均每日频率
使美元条比时间条、tick 条或成交量条更有趣的第二个论点是,由于公司行为,流通股数在证券的生命周期内经常多次变化。即使在调整了拆股和反向拆股之后,还有其他行为会影响 tick 数量和成交量,如发行新股或回购现有股票(自 2008 年大衰退以来非常常见的做法)。美元条在这些行为面前往往更稳健。不过,你可能希望采样美元条时条大小不随时间保持恒定。相反,条大小可以根据公司的自由流通市值(对于股票)或已发行债务的流通量(对于固定收益证券)动态调整。
2.3.2 信息驱动条#
信息驱动条的目的是在新信息到达市场时更频繁地采样。在此上下文中,「信息」一词是市场微观结构意义上的。正如我们将在第 19 章中看到的,市场微观结构理论赋予不平衡带符号成交量的持续性以特殊重要性,因为该现象与知情交易者的存在相关联。通过将采样与知情交易者的到达同步,我们可能能够在价格达到新的均衡水平之前做出决策。在本节中,我们将探索如何使用各种信息到达指数来采样条。
2.3.2.1 Tick 不平衡条
考虑一个 tick 序列 {(pt, vt)}t=1,...,T,其中 pt 是与 tick t 相关的价格,vt 是与 tick t 相关的成交量。所谓的 tick 规则定义了一个序列 {bt}t=1,...,T,其中
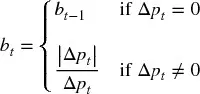
其中 bt ∈ {−1, 1},边界条件 b0 设为匹配紧接前一条的终值 bT。Tick 不平衡条(TIBs)背后的想法是每当 tick 不平衡超过我们的期望时就采样条。我们希望确定 tick 索引 T,使得带符号 tick 的累积(根据 tick 规则带符号)超过给定阈值。接下来,让我们讨论确定 T 的过程。
第一,我们定义时间 T 处的 tick 不平衡为

第二,我们在条开始时计算 θT 的期望值,E0[θT] = E0[T](P[bt=1] − P[bt=−1]),其中 E0[T] 是 tick 条的期望大小,P[bt=1] 是 tick 被分类为买入的无条件概率,P[bt=−1] 是 tick 被分类为卖出的无条件概率。由于 P[bt=1] + P[bt=−1] = 1,则 E0[θT] = E0[T](2P[bt=1] − 1)。在实践中,我们可以将 E0[T] 估计为先前条 T 值的指数加权移动平均,将 (2P[bt=1] − 1) 估计为先前条 bt 值的指数加权移动平均。
第三,我们将 tick 不平衡条(TIB)定义为 T 连续的 tick 子集,满足以下条件:
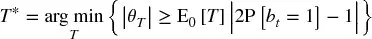
其中期望不平衡的大小由 |2P[bt=1] − 1| 隐含。当 θT 比预期更不平衡时,较低的 T 将满足这些条件。因此,在知情交易(触发单边交易的不对称信息)存在时,TIB 产生得更频繁。事实上,我们可以将 TIB 理解为包含等量信息的交易桶(无论成交量、价格或交易的 tick 如何)。
2.3.2.2 成交量/美元不平衡条
成交量不平衡条(VIBs)和美元不平衡条(DIBs)背后的想法是扩展 tick 不平衡条(TIBs)的概念。我们希望在成交量或美元不平衡偏离我们的期望时采样条。基于我们为 TIBs 讨论的相同 tick 规则和边界条件 b0 概念,我们将定义一个过程来确定下一个样本的索引 T。
第一,我们定义时间 T 处的不平衡为

其中 vt 可以表示交易的证券数量(VIB)或交换的美元金额(DIB)。你对 vt 的选择决定了你是按前者还是后者采样。
第二,我们在条开始时计算 θT 的期望值
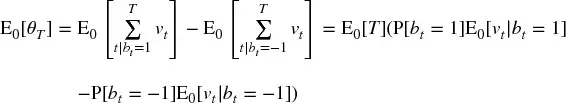
令 v^+^ = P[bt=1]E0[vt|bt=1],v^−^ = P[bt=−1]E0[vt|bt=−1],则
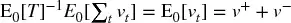 。你可以将 v^+^ 和 v^−^ 视为将 v
t 的初始期望分解为买入贡献的分量和卖出贡献的分量。则
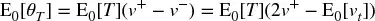
在实践中,我们可以将 E0[T] 估计为先前条 T 值的指数加权移动平均,将 (2v^+^ − E0[vt]) 估计为先前条 btvt 值的指数加权移动平均。
第三,我们将 VIB 或 DIB 定义为 T 连续的 tick 子集,满足以下条件:
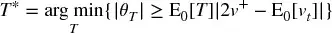
其中期望不平衡的大小由 |2v^+^ − E0[vt]| 隐含。当 θT 比预期更不平衡时,较低的 T 将满足这些条件。这是成交量和美元条基于信息的类似物,与其前身一样,它解决了关于 tick 碎片化和异常值的相同担忧。此外,它还解决了公司行为的问题,因为上述过程不依赖于恒定的条大小。相反,条大小会动态调整。
2.3.2.3 Tick 连续条
TIBs、VIBs 和 DIBs 监控以 tick、成交量和交换的美元价值衡量的订单流不平衡。大型交易者会扫荡订单簿、使用冰山订单或将父订单切成多个子订单,所有这些都在 {bt}t=1,...,T 序列中留下连续运行的痕迹。因此,监控总成交量中的买入序列,并在该序列偏离我们的期望时采样,可能是有用的。
第一,我们定义当前运行的长度为
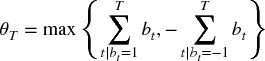
第二,我们在条开始时计算 θT 的期望值
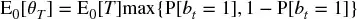
在实践中,我们可以将 E0[T] 估计为先前条 T 值的指数加权移动平均,将 P[bt=1] 估计为先前条买入 tick 比例的指数加权移动平均。
第三,我们将 tick 连续条(TRB)定义为 T 连续的 tick 子集,满足以下条件:
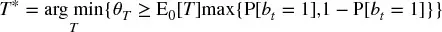
其中来自运行的期望 tick 计数由 max{P[bt=1], 1 − P[bt=−1]} 隐含。当 θT 表现出比预期更多的运行时,较低的 T 将满足这些条件。注意,在这个运行定义中,我们允许序列中断。即,我们不是测量最长序列的长度,而是计算每方的 tick 数量,不对冲它们(无不平衡)。在形成条的上下文中,这被证明是比测量序列长度更有用的定义。
2.3.2.4 成交量/美元连续条
成交量连续条(VRBs)和美元连续条(DRBs)将上述运行定义分别扩展到成交量和交换的美元。直觉是,每当一方交易的成交量或美元超过我们对一条的期望时,我们希望采样条。按照我们惯用的 tick 规则命名法,我们需要确定条中最后一个观测的索引 T。
第一,我们定义与运行关联的成交量或美元为
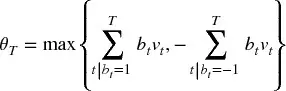
其中 vt 可以表示交易的证券数量(VRB)或交换的美元金额(DRB)。你对 vt 的选择决定了你是按前者还是后者采样。
第二,我们在条开始时计算 θT 的期望值
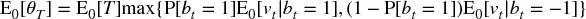
在实践中,我们可以将 E0[T] 估计为先前条 T 值的指数加权移动平均,将 P[bt=1] 估计为先前条买入 tick 比例的指数加权移动平均,将 E0[vt|bt=1] 估计为先前条买入成交量的指数加权移动平均,将 E0[vt|bt=−1] 估计为先前条卖出成交量的指数加权移动平均。
第三,我们将成交量连续条(VRB)定义为 T 连续的 tick 子集,满足以下条件:
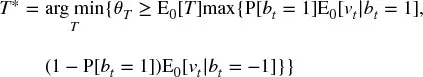
其中来自运行的期望成交量由 max{P[bt=1]E0[vt|bt=1], (1 − P[bt=1])E0[vt|bt=−1]} 隐含。当 θT 表现出比预期更多的运行,或来自运行的成交量大于预期时,较低的 T 将满足这些条件。
2.4 处理多产品序列#
有时我们对建模一组工具的时间序列感兴趣,其中权重需要随时间动态调整。其他时候,我们必须处理支付不规则股息或利息的产品,或受公司行为影响的产品。改变所研究时间序列性质的事件必须被正确处理,否则我们将无意中引入一个结构性突变,误导我们的研究工作(详见第 17 章)。这个问题以多种形式出现:当我们建模权重变化的价差,或必须再投资股息/利息的证券篮子,或必须再平衡的篮子,或指数成分变化,或当我们必须用另一个替换到期/过期合约/证券时等。
期货就是一个典型例子。根据我的经验,人们在处理期货时不必要地挣扎,主要是因为不知道如何处理好展期。基于期货价差或股票/债券篮子的策略也是如此。在下一节中,我将向你展示一种将证券篮子建模为单一现金产品的方法。我称之为「ETF 技巧」(ETF trick),因为目标是将任何复杂的多产品数据集转换为一个类似于总回报 ETF 的单一数据集。这为什么有用?因为你的代码总是可以假设你只交易类现金产品(不过期的现金工具),无论底层序列的复杂性和组成如何。
2.4.1 ETF 技巧#
假设我们希望开发一个交易期货价差的策略。处理价差而非单一工具会产生一些麻烦。第一,价差的特征是一个随时间变化的权重向量。因此,即使价格不变,价差本身也可能收敛。当这种情况发生时,交易该序列的模型将被误导,认为 PnL(盈亏的净盯市价值)是由该权重引起的收敛产生的。第二,价差可能获得负值,因为它们不代表价格。这通常是有问题的,因为大多数模型假设正价格。第三,所有成分的交易时间不会完全对齐,因此价差并不总是可以在最后发布的水平上交易,或以零延迟风险交易。此外,还必须考虑执行成本,如穿越买卖价差。
避免这些问题的一种方法是生成一个反映在价差中投资 1 美元价值的时间序列。序列的变化将反映 PnL 的变化,序列将严格为正(最坏情况下无穷小),且实现 shortfall 将被考虑。这将是要用于建模、生成信号和交易的序列,就好像它是一个 ETF。
假设我们得到了一个条的历史记录,由第 2.3 节解释的任何方法导出。这些条包含以下列:
- o
i,t是工具 i = 1, ..., I 在条 t = 1, ..., T 处的原始开盘价。 - p
i,t是工具 i = 1, ..., I 在条 t = 1, ..., T 处的原始收盘价。 - φ
i,t是工具 i = 1, ..., I 在条 t = 1, ..., T 处一个点的美元价值。这包括外汇汇率。 - v
i,t是工具 i = 1, ..., I 在条 t = 1, ..., T 处的成交量。 - d
i,t是工具 i 在条 t 处支付的持有收益、股息或利息。该变量也可用于收取保证金成本或资金成本。
其中所有工具 i = 1, ..., I 在条 t = 1, ..., T 处都是可交易的。换言之,即使某些工具在整个时间区间 [t−1, t] 内不可交易,至少它们在 t−1 和 t 时刻可交易(市场在这些时刻开放并能够执行订单)。对于以分配向量 ωt 为特征的期货篮子,在条 B ⊆ {1, ..., T} 上再平衡(或展期),1 美元投资值 {Kt} 导出为
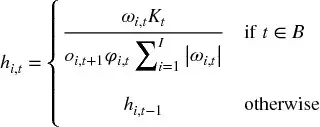
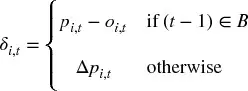
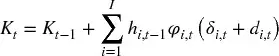
其中 K0 = 1 为初始 AUM。变量 hi,t 表示工具 i 在时间 t 的持仓(证券或合约数量)。变量 δi,t 是工具 i 在 t−1 和 t 之间的市场价值变化。注意,每当 t ∈ B 时,盈亏被再投资,从而防止负价格。股息 di,t 已嵌入 Kt,因此策略无需知道它们。hi,t 中 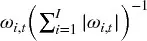 的目的是去杠杆分配。对于期货序列,在展期时间 t 我们可能不知道新合约的 p
i,t,因此我们使用 oi,t+1 作为最接近时间的替代。
令 τi 为交易 1 美元工具 i 相关的交易成本,例如 τi = 1E−4(一个基点)。策略需要为每个观测条 t 知道三个额外变量:
- 再平衡成本: 与分配再平衡相关的可变成本 {c
t} 为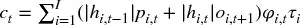 ,∀t ∈ B。我们不将 c
t嵌入 Kt,否则做空价差将在分配再平衡时产生虚假利润。在你的代码中,你可以将 {ct} 视为(负)股息。 - 买卖价差: 买入或卖出该虚拟 ETF 一个单位的成本
 为
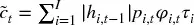 。当一个单位被买入或卖出时,策略必须收取该成本
 ,这相当于穿越该虚拟 ETF 的买卖价差。
- 成交量: 交易的成交量 {v
t} 由篮子中最不活跃的成员决定。令 vi,t为工具 i 在条 t 上的交易量。可交易的篮子单位数为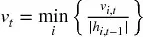 。
交易成本函数不一定是线性的,这些非线性成本可以由策略基于上述信息模拟。多亏了 ETF 技巧,我们可以将期货篮子(或单个期货)建模为好像它是一个单一的不过期现金产品。
2.4.2 PCA 权重#
感兴趣的读者可以在 López de Prado 和 Leinweber [2012] 以及 Bailey 和 López de Prado [2012] 中找到许多计算对冲权重的实用方法。为完整起见,让我们回顾一种推导上一节中使用的向量 {ωt} 的方法。考虑一个以均值向量 μ(大小为 Nx1)和协方差矩阵 V(大小为 NxN)为特征的 IID 多元高斯过程。该随机过程描述了一个不变随机变量,如 N 个工具组合的股票收益、债券收益率变化或期权波动率变化。我们希望计算符合 V 的主成分上特定风险分布的分配向量 ω。
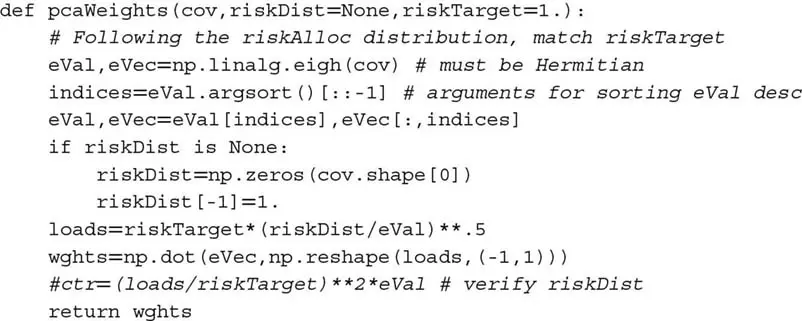
第一,我们进行谱分解,VW = WΛ,其中 W 的列被重新排序以使 Λ 对角线元素按降序排列。第二,给定分配向量 ω,我们可以计算投资组合的风险为 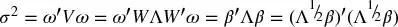 ,其中 β 表示 ω 在正交基上的投影。第三,Λ 是对角矩阵,因此
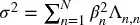 ,归因于第 n 个成分的风险为 R
n = β²n Λn,n σ^−2 = (W'ω)²n Λn,n σ^−2,其中 R'1N = 1,1N 是 N 个 1 的向量。你可以将 {Rn}n=1,...,N 解释为正交成分上的风险分布。
第四,我们希望计算交付用户定义风险分布 R 的向量 ω。从前面的步骤,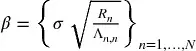 ,这表示新(正交)基中的分配。第五,旧基中的分配由 ω = Wβ 给出。重新缩放 ω 仅仅重新缩放 σ,因此保持风险分布不变。
图 2.2 说明了反方差分配的每个主成分的风险贡献。几乎所有主成分都贡献风险,包括方差最高的那些(成分 1 和 2)。相比之下,对于 PCA 投资组合,只有方差最低的成分贡献风险。
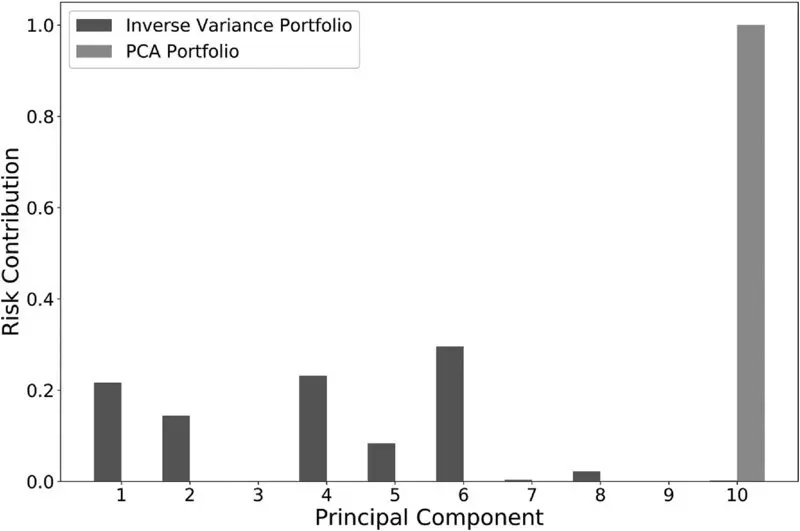
图 2.2 每个主成分的风险贡献
代码片段 2.1 实现了该方法,其中用户定义的风险分布 R 通过参数 riskDist 传递(可选 None)。如果 riskDist 为 None,代码将假设所有风险必须分配给特征值最小的主成分,权重将是重新缩放以匹配 σ(riskTarget)的最后一个特征向量。
代码片段 2.1 从风险分布 R 得到 PCA 权重
2.4.3 单个期货展期#
ETF 技巧可以处理单个期货合约的展期,作为单腿价差的特例。然而,在处理单个期货合约时,一种等效且更直接的方法是形成累积展期间隔的时间序列,并从价格序列中减去该间隔序列。代码片段 2.2 展示了该逻辑的可能实现,使用从 Bloomberg 下载并存储在 HDF5 表中的一系列 tick 条。Bloomberg 字段的含义如下:
FUT_CUR_GEN_TICKER:标识与该价格关联的合约。其值随每次展期而变化。PX_OPEN:与该条关联的开盘价。PX_LAST:与该条关联的收盘价。VWAP:与该条关联的成交量加权平均价。
函数 rollGaps 中的参数 matchEnd 确定期货系列应该向前展期(matchEnd=False)还是向后展期(matchEnd=True)。在向前展期中,展期序列开始时的价格匹配原始序列开始时的价格。在向后展期中,展期序列结束时的价格匹配原始序列结束时的价格。
代码片段 2.2 形成间隔序列,从价格中减去
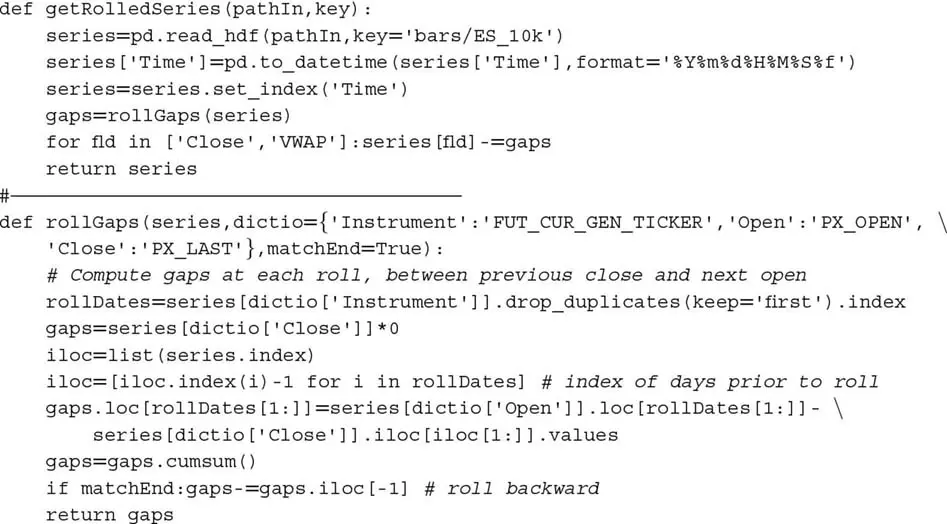
展期价格用于模拟 PnL 和投资组合盯市值价值。然而,原始价格仍应用于头寸规模化和确定资本消耗。记住,展期价格确实可能变为负值,特别是在处于期货升水(contango)时抛售的期货合约中。要看到这一点,在棉花 #2 期货或天然气期货的序列上运行代码片段 2.2。
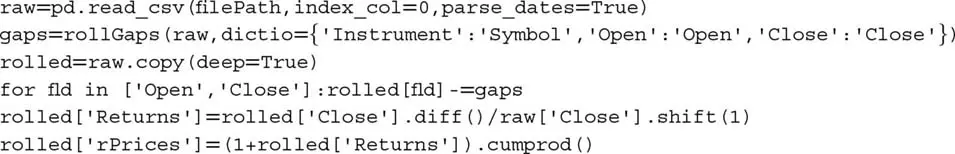
一般来说,我们希望使用非负的展期序列,在这种情况下,我们可以按如下方式导出 1 美元投资的价格序列:(1) 计算展期期货价格的时间序列;(2) 计算收益 (r) 为展期价格变化除以前一个原始价格;(3) 使用这些收益形成价格序列(即 (1+r).cumprod())。代码片段 2.3 说明了该逻辑。
代码片段 2.3 非负展期价格序列
2.5 采样特征#
到目前为止,我们学习了如何从一批非结构化金融数据中产生连续、均匀、结构化的数据集。虽然你可以尝试在这样的数据集上应用 ML 算法,但一般来说这不是一个好主意,原因有二。第一,几种 ML 算法在样本大小方面扩展性不好(如 SVM)。第二,ML 算法在尝试从相关示例中学习时达到最高精度。假设你希望预测下一个 5% 绝对收益是正(5% 反弹)还是负(5% 抛售)。在任何随机时间,这种预测的精度都会很低。然而,如果我们要求分类器在某些催化条件之后预测下一个 5% 绝对收益的符号,我们更有可能找到有助于实现更精确预测的信息特征。在本节中,我们讨论从条中采样以产生具有相关训练示例的特征矩阵的方法。
2.5.1 为减少而采样#
如前所述,从结构化数据集中采样特征的一个原因是为了减少用于拟合 ML 算法的数据量。该操作也称为下采样(downsampling)。这通常通过以恒定步长进行序贯采样(linspace 采样)或使用均匀分布随机采样(均匀采样)来完成。
linspace 采样的主要优点是简单。缺点是步长是任意的,且结果可能因种子条而异。均匀采样通过在整个条集合上均匀地抽取样本来解决这些问题。不过,两种方法都受到批评:样本不一定包含在预测能力或信息内容方面最相关的观测子集。
2.5.2 基于事件的采样#
投资组合经理通常在某个事件发生后下注,如结构性突变(第 17 章)、提取的信号(第 18 章)或微观结构现象(第 19 章)。这些事件可能与某些宏观经济统计数据的发布、波动率的飙升、价差对其均衡水平的显著偏离等相关联。我们可以将一个事件表征为显著的,并让 ML 算法学习在这些情况下是否存在精确的预测函数。也许答案是否定的,在这种情况下我们将重新定义什么构成事件,或用替代特征再试。出于说明目的,让我们讨论一种有用的基于事件的采样方法。
2.5.2.1 CUSUM 滤波器
CUSUM 滤波器是一种质量控制方法,旨在检测被测量量均值偏离目标值的漂移。考虑来自局部平稳过程的 IID 观测 {yt}t=1,...,T。我们定义累积和
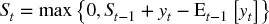
边界条件 S0 = 0。该过程将建议在满足 St ≥ h 的第一个 t 处采取行动,对于某个阈值 h(滤波器大小)。注意,每当 yt ≤ Et−1[yt] − St−1 时,St = 0。这个零下限意味着我们将跳过一些原本会使 St 为负的向下偏离。原因是,滤波器设置用于识别从任何重置水平零开始的一系列上行偏离。特别地,阈值在以下条件下被激活
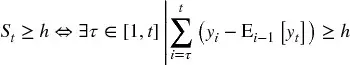
这种上行的概念可以扩展到包括下行,给我们一个对称的 CUSUM 滤波器:
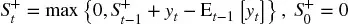
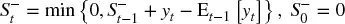
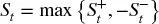
Lam 和 Yam [1997] 提出了一种投资策略,其中当观察到相对于先前高点或低点的绝对收益 h 时,产生交替的买入-卖出信号。那些作者证明,该策略等价于 Fama 和 Blume [1966] 研究的所谓「滤波交易策略」。我们对 CUSUM 滤波器的使用不同:我们将在且仅在 St ≥ h 时采样条 t,此时 St 被重置。代码片段 2.4 展示了对称 CUSUM 滤波器的实现,其中 Et−1[yt] = yt−1。
代码片段 2.4 对称 CUSUM 滤波器
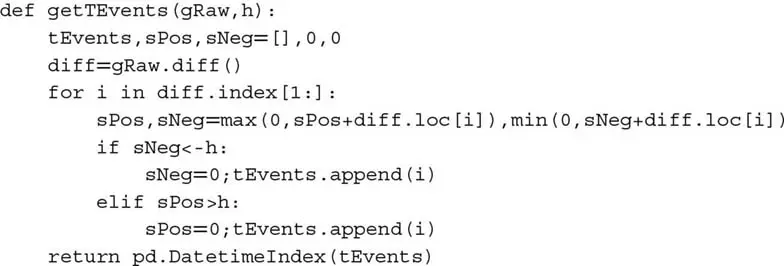
函数 getTEvents 接收两个参数:我们希望滤波的原始时间序列(gRaw)和阈值(h)。使 CUSUM 滤波器吸引人的一个实际方面是,gRaw 在阈值水平附近徘徊不会触发多个事件,而这是布林带等流行市场信号所 suffered 的缺陷。gRaw 需要完整的 h 长度运行才能触发一个事件。图 2.3 说明了 CUSUM 滤波器在价格序列上采样的样本。
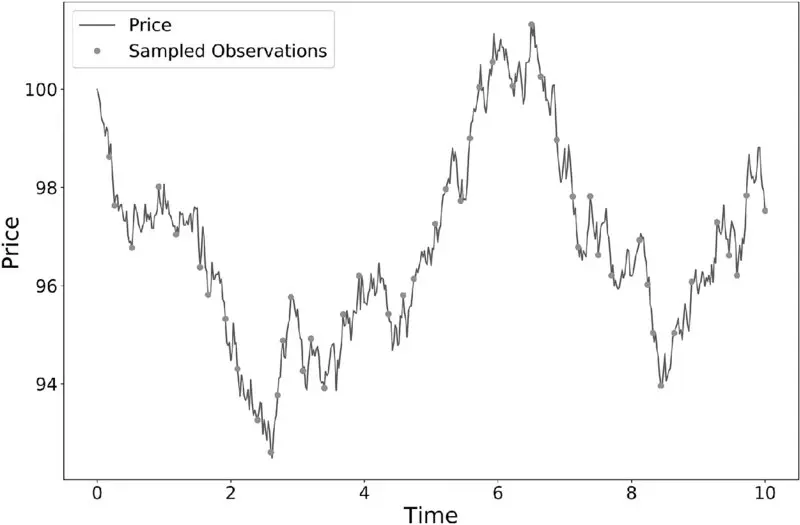
图 2.3 价格序列的 CUSUM 采样
变量 St 可以基于我们将在第 17-19 章中讨论的任何特征,如结构性突变统计量、熵或市场微观结构度量。例如,我们可以声明每当 SADF 充分偏离先前重置水平时为一个事件(将在第 17 章中定义)。一旦我们获得了这个事件驱动的条子集,我们将让 ML 算法确定此类事件的发生是否构成可操作的情报。
练习题#
在一系列 E-mini S&P 500 期货 tick 数据上:
- 形成 tick、成交量和美元条。使用 ETF 技巧处理展期。
- 计算每周 tick、成交量和美元条产生的条数。绘制该条数的时间序列。哪种条类型产生最稳定的每周计数?为什么?
- 计算三种条类型的收益序列相关。哪种条方法的序列相关最低?
- 将条序列划分为月度子集。计算每种条类型的每个子集的收益方差。计算这些方差的方差。哪种方法表现出最小的方差之方差?
- 对三种条类型的收益应用 Jarque-Bera 正态性检验。哪种方法达到最低检验统计量?
在一系列 E-mini S&P 500 期货 tick 数据上,计算美元条和美元不平衡条。哪种条类型表现出更大的序列相关?为什么?
在 E-mini S&P 500 期货和 Eurostoxx 50 期货的美元条序列上:
- 应用第 2.4.2 节计算 ETF 技巧使用的
 向量。(提示:你将在展期日期需要 EUR/USD 的外汇值。)
- 导出 S&P 500/Eurostoxx 50 价差的时间序列。
- 用 ADF 检验确认该序列是平稳的。
- 应用第 2.4.2 节计算 ETF 技巧使用的
形成 E-mini S&P 500 期货美元条:
- 在滚动移动平均周围计算宽度为 5% 的布林带。计算价格从带内穿越到带外的次数。
- 现在使用 CUSUM 滤波器采样这些条,其中 {y
t} 是收益,h = 0.05。你得到多少个样本? - 计算两个采样序列的滚动标准差。哪一个异方差性最小?这些结果的原因是什么?
使用练习 4 中的条:
- 使用 CUSUM 滤波器采样条,其中 {y
t} 是绝对收益,h = 0.05。 - 计算采样条的滚动标准差。
- 将此结果与练习 4 的结果比较。哪种程序交付了异方差性最小的样本?为什么?
- 使用 CUSUM 滤波器采样条,其中 {y
参考文献#
- Ané, T. and H. Geman (2000): "Order flow, transaction clock and normality of asset returns." Journal of Finance, Vol. 55, pp. 2259--2284.
- Bailey, David H., and M. López de Prado (2012): "Balanced baskets: A new approach to trading and hedging risks." Journal of Investment Strategies (Risk Journals), Vol. 1, No. 4 (Fall), pp. 21--62.
- Clark, P. K. (1973): "A subordinated stochastic process model with finite variance for speculative prices." Econometrica, Vol. 41, pp. 135--155.
- Easley, D., M. López de Prado, and M. O'Hara (2011): "The volume clock: Insights into the high frequency paradigm." Journal of Portfolio Management, Vol. 37, No. 2, pp. 118--128.
- Easley, D., M. López de Prado, and M. O'Hara (2012): "Flow toxicity and liquidity in a high frequency world." Review of Financial Studies, Vol. 25, No. 5, pp. 1457--1493.
- Fama, E. and M. Blume (1966): "Filter rules and stock market trading." Journal of Business, Vol. 40, pp. 226--241.
- Kolanovic, M. and R. Krishnamachari (2017): "Big data and AI strategies: Machine learning and alternative data approach to investing." White paper, JP Morgan, Quantitative and Derivatives Strategy. May 18.
- Lam, K. and H. Yam (1997): "CUSUM techniques for technical trading in financial markets." Financial Engineering and the Japanese Markets, Vol. 4, pp. 257--274.
- López de Prado, M. and D. Leinweber (2012): "Advances in cointegration and subset correlation hedging methods." Journal of Investment Strategies (Risk Journals), Vol. 1, No. 2 (Spring), pp. 67--115.
- Mandelbrot, B. and M. Taylor (1967): "On the distribution of stock price differences." Operations Research, Vol. 15, No. 5, pp. 1057--1062.